
论文与实验验证· 科学证据 · Frontier
机器学习设计 HEA05:1.75 GPa 屈服强度下仍保持 25% 均匀延伸
这篇工作的亮点不只是找到一种更强的合金。团队先用材料知识缩小搜索空间,再让主动学习决定下一批实验,最终把稀缺的验证预算用在更有信息量的候选上。
●同行评审论文 + 实验验证
当前边界:室温拉伸性能和变形机制已有较完整验证;长期高温稳定性、疲劳与断裂、规模化加工和成本仍未解决
这项工作推进的是:选择下一次最值得做的昂贵实验
- MODEL理解 / 预测
- DECIDE选择下一步
- INTERACT执行与测量
- UPDATE改变下一轮
HEA05 不是模型预测,而是已经制备和验证的合金
2025 年 6 月,西安交通大学团队在 Nature 报道了 Fe₃₅Ni₂₉Co₂₁Al₁₂Ta₃ 多主元合金,论文中称为 HEA05。研究者真实熔炼、轧制和热处理了合金,并完成室温拉伸与多尺度显微结构表征。[S1]
在 750 °C 时效 1 小时的代表性条件下,HEA05 的屈服强度达到 1,750 ± 50 MPa,抗拉强度为 2,403 ± 46 MPa,均匀延伸率仍有 25 ± 1.5%。断裂前真应力接近 3 GPa,加工硬化率在较大应变范围内持续高于 2 GPa。[S1]
接近 2 GPa 的块体金属通常很难同时保持大幅均匀塑性。有些超高强钢的名义延伸包含 Lüders band 或 Portevin–Le Châtelier band 带来的局部变形;传统沉淀强化高熵或中熵合金的屈服强度又多低于约 1.2 GPa。HEA05 的应力—应变曲线则保持平滑,并且同一成分通过改变加工条件,还能在 1.5 GPa / 31% 到 1.95 GPa / 15% 之间调节强塑性组合。[S1]
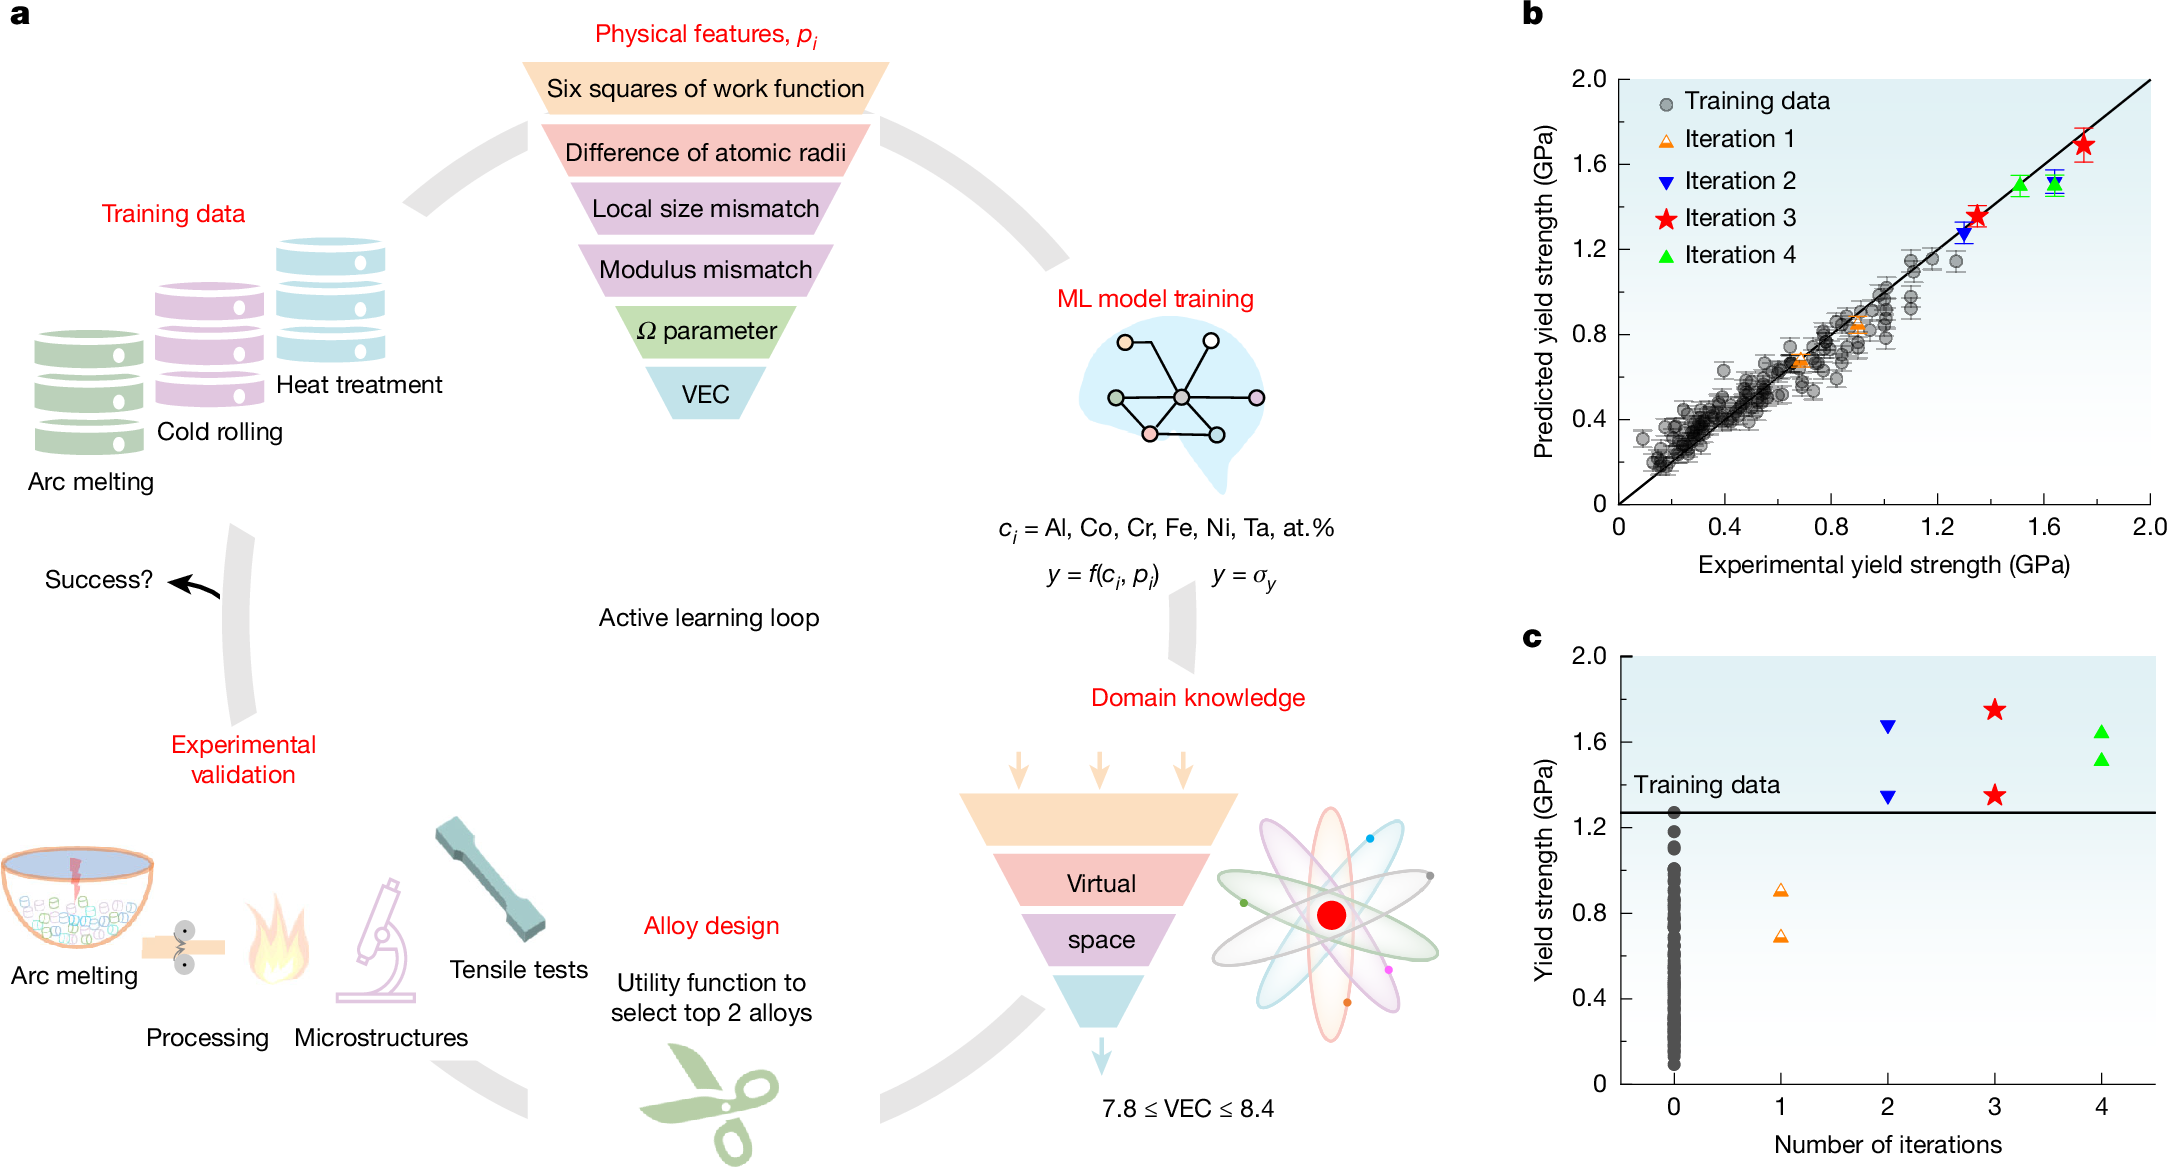
论文 Fig. 1:材料知识先缩小候选空间,主动学习再通过四轮、八次新实验选择合金并回传测量结果。图片来自论文。 [S1]
领域知识先缩小空间,主动学习再决定下一批实验
机器学习没有从整个元素周期表里自动发明合金
论文估计,多组元合金的潜在组合空间约为 10⁴⁹。团队并没有把这片空间直接交给黑箱模型,而是先用材料知识选择 FeNiCo FCC 基体,并加入 Al 和 Ta,希望获得固溶强化、高体积分数的 L1₂ 共格纳米沉淀,以及一定数量但仍可变形的 B2 相。[S1]
主动学习从 140 个 AlCoCrFeNiTa 体系 FCC 高熵合金的数据起步。研究者从 20 个候选物理特征中保留了 6 个,并用 7.8 ≤ VEC ≤ 8.4 等约束过滤虚拟成分。模型每轮推荐两个候选;研究者实际熔炼、加工和测试,再把结果放回训练集。四轮共验证 8 个新合金,其中 6 个提高了屈服强度,HEA05 在第三轮出现。[S1][S2]
这条边界很重要:模型主要帮助搜索化学成分,目标偏向提高屈服强度;它没有端到端预测“1.75 GPa + 25%”,也没有自动给出最终的三相组织。成分选定后,轧制、再结晶和时效仍由研究者设计。更准确的流程是:领域知识缩小空间,模型选择成分,实验返回数据,再通过微观组织工程获得最终性能。[S1]
真正承担强度与塑性的,是 L1₂ + B2 双沉淀结构
代表性 HEA05 以平均晶粒约 7.6 μm 的 FCC 基体为主,其中有两类尺度不同的析出相:约 15 ± 3 nm、体积分数 66.6 ± 2.3% 的共格 L1₂ 纳米沉淀,以及约 350 ± 70 nm、体积分数 15 ± 2% 的非共格 B2 沉淀。[S1]
作者估算,L1₂ 对屈服强度贡献约 859 MPa,B2 贡献约 351 MPa,其余来自晶格摩擦、预存位错和晶界。高体积分数 L1₂ 是最主要的强化来源;Ta 提高 L1₂ 的反相界面能,使位错切过有序沉淀需要付出更多能量。[S1]
B2 的表现更反常。传统 NiAl 型 B2 很硬,也容易脆;HEA05 的多组元 B2 具有更低的化学有序能,Ta 等元素让反相界面能比二元 NiAl 低约 30%。位错因此能进入 B2,并在拉伸过程中继续增殖和储存。B2 不只抬高屈服强度,也参与后续加工硬化。[S1]
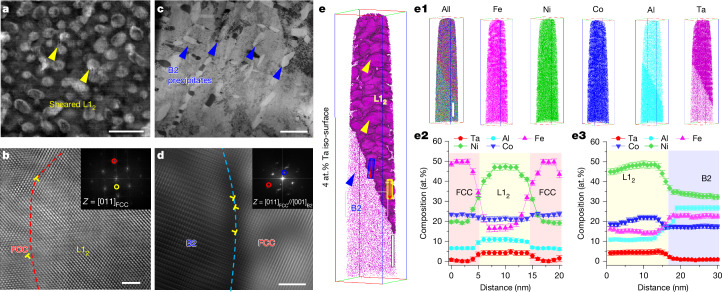
论文 Fig. 2:FCC 基体中的共格 L1₂ 纳米沉淀、非共格 B2 微米沉淀及其成分分布。Sohail et al., Nature (2025), CC BY-NC-ND 4.0;原图未修改。 [S1]
25% 为什么是真正值得注意的均匀延伸
在拉伸中,材料要持续均匀变形,加工硬化必须抵消截面积缩小带来的失稳趋势。HEA05 从 1.75 GPa 屈服继续硬化到 2.40 GPa 抗拉强度,两者相差约 650 MPa,屈强比只有约 0.73;加工硬化曲线没有出现明显的应力锯齿或骤降。[S1]
B2 中的几何必要位错密度从未变形时约 0.8 × 10¹⁴ m⁻²,上升到 20% 应变时的 6.8 × 10¹⁴ m⁻²,甚至高于同一应变下 FCC/L1₂ 区域的约 5.4 × 10¹⁴ m⁻²。不同相之间的不均匀变形还会带来 HDI hardening。材料不是只在一开始很强,而是在进入塑性阶段后仍能持续储存位错。[S1]
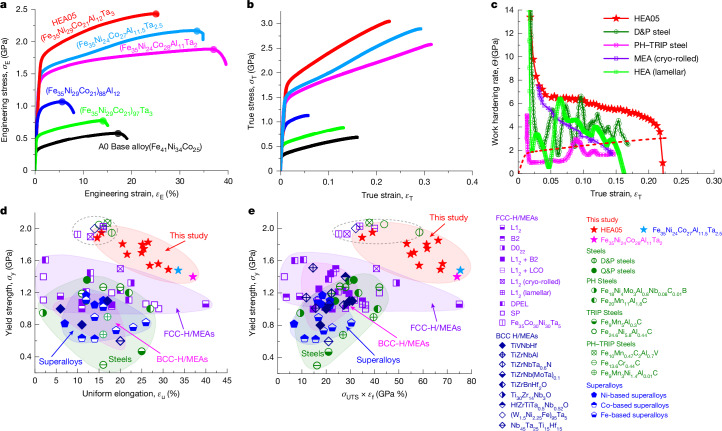
论文 Fig. 3:HEA05 的应力—应变与加工硬化行为,以及它与其他高强合金的强度—延伸率比较。Sohail et al., Nature (2025), CC BY-NC-ND 4.0;原图未修改。 [S1]
140 个样本起步,四轮只做了八次新实验
当每轮只能做两个实验,模型的价值是决定下一次问自然界什么
这是一项 small-data AI4S 工作。140 个样本对现代机器学习很少,但完整的成分—工艺—组织—性能标签在材料科学里本来就昂贵。团队没有用更复杂的模型掩盖数据不足,而是让 VEC、原子尺寸失配、相稳定性和沉淀强化等知识直接参与删减搜索空间。[S1]
当模型能快速生成大量候选,而实验室每轮只能熔炼和测试两个时,生成更多成分已经不是最紧的问题。主动学习在这里更像一种实验预算分配机制:决定哪一个候选最可能提高性能,或者即使失败,也最能减少模型的不确定性。
HEA05 还不是自动驾驶实验室,大量熔炼、加工、表征和判断仍由人完成。但它已经接上了关键的一段闭环:模型提出成分,物理实验返回结果,模型据此选择下一轮。这里真正值得比较的指标,也许不只是 R² 或 RMSE,而是 experiments-to-discovery、time-to-verification 和每次实验带来的信息量。
WHAT CHANGED
- AI4S 层级
- 材料发现 / 主动学习 / 实验选择
- 原有瓶颈
- 多组元合金成分空间巨大,每个真实候选却都要经过熔炼、加工、表征和力学测试
- 这次改变
- 把物理特征、相结构约束和主动学习接成闭环,由模型选择下一批实验成分
- 关键证据
- 140 个已有数据 → 四轮 8 个新实验 → HEA05;1.75 GPa 屈服强度 + 25% 均匀延伸均为实测
- 仍未解决
- 跨合金体系泛化、成分与工艺联合优化、长期服役、规模化制造与 Ta 成本
EVIDENCE IN CONTEXT
- 编辑状态
- 前沿
- 证据场景
- 闭环或机器人实验室
- 证据怎样产生
- 前瞻性 · 实体实验 · 自适应
- 来源与可检查性
- 同行评审 · 公开代码
- 证据上限
- 它证明了主动学习能在一个合金体系的四轮实体实验中分配验证预算,但没有证明跨体系、跨实验室或规模化运行。
- 谁做了什么
- 模型提出候选;研究人员设定空间、制备样品并完成力学与显微验证
室温强塑性已经实测,跨体系泛化与工程化仍未验证
这不是只有计算指标的“AI 设计材料”。
HEA05 已被真实制备并完成重复室温拉伸,组织通过 XRD、TEM、SEM、EBSD、TKD、APT 与同步辐射散射等方法表征。1.75 GPa 和 25% 是实验数据,不是模型输出;训练数据与代码也已公开。[S1][S2]
“机器学习设计”需要窄一些理解。
模型没有直接优化 1.75 GPa 与 25% 两个目标,也没有端到端预测三相组织。专家选择元素体系、物理特征和 VEC 约束,后续加工再决定最终组织。这是 ML-assisted alloy design,不是完全自主发现。[S1]
实验验证仍停在材料发现的早期。
论文验证了室温强塑性与变形机制,但没有建立长期高温稳定性、疲劳寿命、断裂韧性、耐腐蚀、规模化加工和工业认证数据。HEA05 还含 3 at.% Ta;能否降低成本并在大尺寸材料中稳定复制同样的析出结构,仍需继续验证。[S1]
主动学习找到了成分,材料为何有效仍要靠实验解释
领域知识可以直接成为搜索算法的一部分
材料知识负责定义元素体系、物理特征和相结构约束,机器学习负责在剩余空间里选择下一次昂贵实验。对于 small-data science,这种分工比把领域知识和模型对立起来更现实。
主动学习分配的是稀缺的物理标签
模型推理很便宜,熔炼、热处理、表征和拉伸却很贵。主动学习真正回答的是:当这一轮只能做两个实验,下一次最值得向自然界问什么?
找到成分与解释性能仍是两件事
主动学习找到了 HEA05 的成分,但后续实验才解释了 L1₂ 如何强化、B2 为什么没有变脆,以及 B2 怎样在变形后期储存位错。AI4S 里的 prediction 和 scientific understanding 仍然需要分别建立证据。
硬的第二相不一定只能阻挡位错
通过多组元合金化降低 B2 的有序能,一个通常被看作硬而脆的金属间化合物相,也可以参与变形、储存位错并维持加工硬化。这个材料学细节,比“AI 找到 record-setting alloy”更值得记住。
资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。