

精选简报
全部 38 篇 →2026
:时间线 +18 · 评论 +2
- 配上研究者写好的分析步骤,11 个 AI 模型都处理完了一套催化数据,没有这些步骤时一个都不行;它们提出的实验也真的做了10月29日
- 新加坡投入 1.5 亿新元建 MARVEL-AI:A*STAR 牵头,把材料 AI 模型和自动化实验室接在一起,CuspAI 是合作方之一10月27日
- 晶体结构预测在 15 个候选里找回吖啶全部 7 个已解析晶型;试过的机器学习势里,只有针对吖啶微调的那个排对了它们的稳定性顺序10月27日
- 一层小小的外挂修正,不重训基础原子间势模型,就把它的熔点拉回评估值:金从 844 K 修到 1346 K,评估值是 1337 K10月25日
- Flagship 把 Cellarity、Etiome 和 Empress Therapeutics 的平台合并为 AI 药物发现公司 Etcelera,由 Adrian Rawcliffe 执掌10月29日
- Ben Lehner 参与创办的巴塞罗那公司 ALLOX 完成 Asabys 领投的 1050 万美元种子轮,在难成药的靶点上寻找隐藏的调控位点10月29日
- EVENET 用 5 亿个模拟 LHC 对撞事件预训练,在真实 CMS 数据中以 7.6σ 找出已知的 ϒ 介子,高于已发表方法的 6.4σ10月29日
- AI 药物开发公司 Formation Bio 设立 6 亿美元自有基金,计划买入并推进 10 到 15 个临床阶段药物10月28日
- 一场由 Claude 引导的设计做出 20 个能把 IgE 从受体上拽下来的抗体单臂;做过剂量滴定的八个里,三个在同一套检测中清除得比已获批的药更多,而没有一个明确强过母本10月27日
- Biographica 的 CROP-1 根据基因的 DNA 和哪些调控因子在表达,预测作物基因在每种组织和条件下的活性,并设计只针对一种情境的编辑10月27日
- ChronoSyn 学习材料被首次报道的先后顺序,挑出真实材料的能力高于把年份打乱的同一模型10月26日
- Generalist AI 融资 4 亿美元做机器人基础模型,Radical Ventures 领投;之后的 Form D 显示又售出 1.98 亿美元6月4日
- 三位前 DeepMind 研究员创办的 Inherent 走出隐身,种子轮 5000 万美元,由 Index 与 Radical 联合领投5月29日
- Recursive Superintelligence 带着 6.5 亿美元亮相,GV 与 Greycroft 联合领投,估值 46.5 亿美元,目标是能自我改进的 AI5月13日
- Bioptimus 报告其病理模型 H-optimus-1 在两个外部基准上排第一,但在组织分割上 23 个模型中排第 144月17日
- Yann LeCun 的 AMI Labs 种子轮融资 10.3 亿美元做世界模型,据报道估值 35 亿美元3月10日
- AlphaChip 共同创造者创办的 Ricursive Intelligence 完成 3 亿美元 A 轮,Lightspeed 领投,估值 40 亿美元1月26日
- 百图生科的 xTrimoPGLM:千亿参数蛋白语言模型,作者在 Nature Methods 报告它既能读懂也能写出蛋白序列2025年4月3日
- 评论
- Thoughts on the Netflix Analogy7月22日
- Answers and Reasons and Knowing and Thinking4月14日
- 日期为事件发生日。较早条目因关联近期事件或经核查而补录。
Flagship 把 Cellarity、Etiome 和 Empress Therapeutics 的平台合并为 AI 药物发现公司 Etcelera,由 Adrian Rawcliffe 执掌
发生了什么:Flagship Pioneering 把旗下三家公司的平台合在一起,再配上自己的 AI 部门 Pioneering Intelligence;据 BioPharma Dive,三家此前共融资 3.74 亿美元。CEO 是 Adaptimmune 前 CEO Adrian Rawcliffe,Flagship 高级合伙人 Alec Reynolds 任董事长,Noubar Afeyan 是联合创始人。起步项目在血液病(如骨髓纤维化)、代谢(含已有合作的 MASH 项目)和免疫。Cellarity 的镰状细胞病药物 CLY-124 转入另一家公司。
为什么重要:三家各有一类证据:Cellarity 读整个细胞的状态,Etiome 追踪疾病逐阶段的变化,Empress 查清一个分子实际结合什么。Flagship 押的是:三者合并,再加上细胞在基因被关闭或加入化合物后如何反应的数据,能分辨哪些靶点真正导致疾病,从而在试验前判断哪些药会在病人身上起效。Reynolds 把要解决的问题说成约一半进入二期的药物会失败。
证据与边界:没有宣布新融资。新闻稿称其用 1.5 亿个细胞训练的基础模型为业内最大,另有 30 多个预测模型,这些都是公司的描述,没有展示任何结果。

Ben Lehner 参与创办的巴塞罗那公司 ALLOX 完成 Asabys 领投的 1050 万美元种子轮,在难成药的靶点上寻找隐藏的调控位点
发生了什么:ALLOX 完成 1050 万美元(940 万欧元)种子轮,由 Asabys 通过 Sabadell Asabys II 基金领投,西班牙创新署 CDTI(经 Innvierte)和加泰罗尼亚金融局参投。公司出自巴塞罗那基因组调控中心,CEO Júlia Domingo 与 André Faure、Pablo Baeza、Ben Lehner 共同创办。Orbis Medicines 首席商务官 Morten Graugaard 出任独立董事长,Asabys 联合创始人 Clara Campàs 进入董事会。资金用于突变图谱平台、自有 AI 模型、药物发现团队和小分子项目。
为什么重要:很多致病蛋白,比如转录因子和靠抓住其他蛋白起作用的蛋白,没有可供药物结合的口袋。ALLOX 一次测量上千个突变的效果,寻找蛋白上其他仍能改变其功能的位置。Faure、Domingo 和 Lehner 2022 年在 Nature 发表了这一方法:用神经网络拟合这些测量结果,绘出了两个常见人类蛋白结构域上的这类位点。这轮资金用于开发 AI 模型,从公司自己的数据中预测这些位点。
证据与边界:这是一笔融资,不是结果:新闻稿没有给出靶点或新数据,公司网站只提到一款临床前抑制剂 ALX-001,没有公布数据。2022 年的论文在实验室里测绘的是两个小的蛋白结构域;目前没有公开证据显示有药物针对这样找到的位点做出来。
EVENET 用 5 亿个模拟 LHC 对撞事件预训练,在真实 CMS 数据中以 7.6σ 找出已知的 ϒ 介子,高于已发表方法的 6.4σ
发生了什么:台湾大学、上海交大、SLAC 和华盛顿大学等机构的物理学家,用 5 亿个模拟事件预训练了一个处理整次对撞的模型,再微调用于四项分析。在模拟的新重粒子搜寻和奇异希格斯衰变搜寻中,它胜过 XGBoost、TabPFN 和 SPANet,数据越少优势越明显;在模拟中测量顶夸克纠缠时,精度比已发表的基准高 37%。在真实的 2016 年 CMS 数据中,它以 7.6σ 找到已知的 ϒ 介子,已发表方法为 6.4σ。
为什么重要:如今对撞机物理学家每做一项分析,都要单独训练一个模型。EVENET 检验的是一个预训练模型能否服务许多分析:在 NERSC 用 512 块 GPU 做一次大规模预训练,之后每个新问题只需低成本微调。收益最大的是稀有信号搜寻,因为每个新粒子假设往往只有几千个模拟信号事件。预训练数据和四个下游数据集中的三个,都以 MIT 许可公开在 Hugging Face 上。
证据与边界:只有一项测试用了真实对撞数据,找到的是一个已知粒子;其余三项都在模拟事件上完成。作者说,模型还没有把探测器和理论的不确定性传递进去,决定性的检验是用于一项正在进行的 LHC 分析。


 +1
配上研究者写好的分析步骤,11 个 AI 模型都处理完了一套催化数据,没有这些步骤时一个都不行;它们提出的实验也真的做了
发生了什么:加州伯克利新加坡中心、南洋理工大学、新加坡国立大学、莫纳什大学和劳伦斯伯克利国家实验室的 Fanxu Meng、Kedar Hippalgaonkar 等人做了 SKIER:AI 模型调用研究者写好的分析步骤,计算交给普通代码。在课题组已发表的铂上甲醇氧化研究的 49 条记录上,有共享步骤时 11 种 AI 配置都处理完了数据,没有时一个都没有。模型再提出三种机理和区分它们的实验,团队都做了。
为什么重要:越来越多人让 AI 模型解读实验、提出机理,但它们的结论常常很难追溯到背后的测量。SKIER 把工作拆开:每种测量怎么分析由研究者定死,模型负责选择和推理,每个结论都能指回自己的数据。案例里这个回路走完了一次:同位素标记、停留时间和氧交换实验不支持三种机理中的两种,把 C-O 键断裂定在甲酸生成之前。
证据与边界:只有一个反应体系,来自作者自己此前的研究。GPT-5.6-sol 拿到 100% 的那 100 道单选题,由专家设计,论文没说是谁出的。作者也说,低于检测限的中间体和他们没考虑到的路径都没有排除。预印本。
 NU+2
百奥几何完成国寿资本领投的 A+ 轮,A 轮系列累计超 1 亿美元,投向分子模型与虚拟细胞模型
发生了什么:老股东上海生物医药基金与达晨财智追加,国开科创、瑞力投资、国方创投跟投。这家北京公司由 Mila 与蒙特利尔高等商学院的唐建创立,没有披露本轮金额,只说包括 6 月那轮数亿元融资在内的 A 轮系列已超 1 亿美元。资金用于分子模型 GeoFlow、预测细胞对扰动如何反应的 GeoCell、扩建自动化实验室,以及推进自研管线。
为什么重要:这轮钱投的是从「设计一个分子」走到「决定它用在哪」:GeoCell 要回答一个设计适合哪个靶点、哪种病、哪些病人,自动化实验室把结果回传给两个模型。共同领投过 6 月那轮的上海生物医药基金,其合伙人郭秋杉说,公司已把模型能力从分子贯通到细胞。公司唯一给出时间的收入来自合成生物学,而不是药物:公司说生物合成的天然冰片比植物提取便宜 80%,2027 年将产生规模化收入。
证据与边界:1 亿美元是 A 轮系列合计,不是本轮金额。2027 年多条双抗进入 IND、冰片的降本幅度,以及 6 月所称在 20 多个抗体靶点上近 20% 的命中率,都是公司说法,没有展示数据。
AI 药物开发公司 Formation Bio 设立 6 亿美元自有基金,计划买入并推进 10 到 15 个临床阶段药物
发生了什么:这家纽约公司从其他药企买入或授权引进一期、二期药物,由自己推进开发。新设的 Drug Development Accelerator Fund 获研究基金会、捐赠基金、医院和慈善机构承诺出资 6 亿美元;Formation Bio 通过子公司任普通合伙人,也投入自有资金。每个药物单独放在一家公司里。CEO 兼联合创始人 Benjamine Liu、首席商务官 David Steinberg 和首席科学官 Michael Ehlers 在新闻稿中发言。
为什么重要:这是 AI 公司为药物开发筹钱的另一种做法:Formation Bio 按单个药物募资,投资人买的是药,不是平台。Liu 说,这开辟了不必出售母公司的变现途径,长期看还能降低资金成本。要检验的说法是:一个共享的、由 AI 支撑的开发团队,能在买入后 2 到 4 年内,更便宜地把每个药推到临床结果。
证据与边界:这是为药物项目设的基金,不是 Formation Bio 的股权融资。没有点名任何有限合伙人或基金要买的药,新闻稿也没有展示平台缩短过哪个项目的例子。
巴塞尔的 Atlas Bio 完成 Creandum 领投的 1000 万美元种子轮,在 II 期临床之前先用虚拟病人跑试验
发生了什么:Creandum 领投种子轮,其合伙人 Katharina Wilhelm 加入董事会。公司同时公布了此前一轮 250 万美元的种子前轮,由 First Momentum Ventures 和 LEA Partners 领投,合计 1250 万美元。公司由 Simon Romanski(CEO)和 Sebastian Bayer(CTO,曾在 Google 领导语言模型研究)于 2024 年创办。它的模型用约 200 万份人体组织 RNA 读数训练,预测虚拟队列里每个病人对一种疗法的反应。资金用于招聘、验证平台和拓展药企客户。
为什么重要:II 期是多数药物失败的地方,也是研发方弄清一个分子适合哪种疾病、哪些病人的地方。Atlas 想在试验之前回答这个问题:让同一批虚拟病人分别接受几种疗法、对应几种疾病,这是真实试验做不到的比较。两天内这是第二家拿到融资的计算机模拟试验公司,前一家是给心脏器械做虚拟病人的 adsilico;Atlas 面向药物,先做免疫领域。Wilhelm 把临床开发称为 AI 进入药物研发的第二波,第一波是药物设计。
证据与边界:公司网站上的案例,包括一次预测 II 期会失败、随后被试验证实的案例,都是公司自己发布的,方法和队列只在保密协议下给合作方看。一家巴塞尔客户凭它的模拟结果省掉动物实验,是公司的说法,客户没有具名。
BigHat 与 Anthropic 用七轮改好两个抗体先导分子,过程中发现一项热学指标并没有测它名字所说的东西
发生了什么:BigHat Biosciences 与 Anthropic 在 BigHat 的 Milliner 平台上做了两次先导分子优化,共七轮(一个分子四轮,另一个三轮)、约 1010 个设计,Claude 参与其中。他们去读仪器的原始曲线,发现每个分子上都有一项热学指标并没有测它名字所说的东西:纳米抗体上是聚集起始温度。于是给曲线拟合物理模型、换指标、改实验方案。两个先导分子在结合力、耐热性和聚集上都好过起始分子。
为什么重要:闭环实验室优化的是给它的那个数字,所以一个替代得很差的指标,换更好的模型或更多数据都救不回来。这里的改进来自人和模型去读仪器信号、并改动实验,而不是多跑几轮搜索。已发表的闭环工作大多把仪器报出的数值当作正确标签,这次优化没有这样做。
证据与边界:这是两家公司自己的技术报告,未经同行评审,全部测量都在 BigHat 自己的实验室:一个平台上的两个分子。报告写明每个先导分子的数值只有一到两次重复,下一步先做确认实验;新指标也是在产出它的那次优化里选定的。先导分子是抗体片段,不是药,没有动物或人体检验。


Generate:Biomedicines 把 CAR 的胞内信号段缩到 45 个氨基酸,不到临床在用设计的三分之一,并报告功能更强
发生了什么:公司与 AI 智能体经过三轮设计和测量,做出一段 45 个氨基酸的 CAR 胞内信号段,长度不到已获批疗法所用 4-1BB-CD3zeta 段的三分之一。与那一段相比,它提高了细胞表面的受体量和抗原引发的 IFN-gamma 释放,而没有抗原时检测不到释放;用 mRNA 递送后杀伤维持更久,一份 mRNA 剂量可带四个受体,用慢病毒和脂质纳米颗粒递送后在供者血细胞中清除了更多 B 细胞。
为什么重要:把信号段缩短,本来预计会损失功能,因为激活基序越多一直被读作信号越强。这段短的信号段让每单位 mRNA 产出更多受体,团队因此才能把四个受体放进一份剂量;报告还提出短信号段有可能降低在体内制造 CAR T 细胞所需的剂量。它同时是智能体引导设计的一个实例:智能体提出设计,并随测量结果不断修改。
证据与边界:这是公司自己的技术报告,未经同行评审,而且全部在细胞层面:少数几位供者的人血细胞,没有动物实验。报告写明短信号段在活体动物里表现如何、有多少细胞同时带上全部四个受体,都还不知道;没有测耗竭;智能体引导的设计是否强过专家设计、是否需要更少轮数,也还没有在对等基线下检验过。

在多次运行合计之下,Enveda 的文档审核系统提出了人工审核员在 1061 页批记录中找到的全部 11 个问题,另加 7 个他们没提的
发生了什么:Enveda 测试了自建的 CDP:基于 Claude 的药品生产批记录审核系统。测试对象是同一个临床批次计划下的四份已执行批记录,共 1061 页,多为手写。人工审核员提出 11 个需处理的问题:CDP 有 9 个直接对上,另 2 个经裁定算作对上,且都是多次运行合计,不是一次跑完。Claude Opus 4.7 的单次运行还多提 7 条人工没提的意见。拿着 CDP 的意见再审一遍,用时是无辅助的 1/9.4。
为什么重要:每批药放行前都必须做批记录审核;Anthropic 的文章说,Enveda 的生产化学家此前有多达 75% 的时间花在文书上。这是药物研发中受监管的文书那一端,几乎没有人去量它,而这里的尺子是人工审核员在真实记录上查出了什么,不是某个基准上的分数。
证据与边界:这是公司自己的报告,未经同行评审:一个批次计划下的四份记录,对照的是审核员的意见,而四组审核中有两组是外部顾问。CDP 没有一条意见引用记录里不存在的内容,但每次运行都按“重大”级别报错一条,人工审核员也能查阅 CDP 没拿到的上游工序记录。那多出的 7 条是否重要,由 Enveda 判断。用时那个数字,来自事先拿到 CDP 意见的那次审核。

Anthropic 收购一家一人制药公司,开始自己跑药物项目
发生了什么:Anthropic 在自己的 Science 页面上说,公司已收购 Mithril Medicine。这家公司此前在研发两种罕见儿童先天性肌营养不良的疗法,创始人 Cody Tranbarger 已加入 Anthropic,继续这项工作并启动更多项目。同一篇文章还列出与六家机构的研究合作:BigHat Biosciences、Bristol Myers Squibb、Divergence Labs、Enveda、Generate:Biomedicines 和 The Column Group,后者正在组建一家叫 Pleiades 的公司,用 Claude 来跑药物项目。
为什么重要:一个卖模型的公司变成了做药的公司。合作让 Anthropic 自己的科学家进入别人的项目,收购则让它有了自己的项目:风险由它承担,结果也归它。文章还说,Anthropic 打算把这部分工作大幅扩大。
证据与边界:收购没有披露条款。Anthropic 说,如果候选分子继续站得住,它预计最早在 2028 年底会有一个药可以开始人体试验,这是它自己的预期;背后的小鼠结果出自公司自己发布的技术报告,未经同行评审,报告里研究的是两个工具分子的初步实验,不是候选药。Pleiades 目前还没有公开任何项目。
+4一场由 Claude 引导的设计做出 20 个能把 IgE 从受体上拽下来的抗体单臂;做过剂量滴定的八个里,三个在同一套检测中清除得比已获批的药更多,而没有一个明确强过母本
发生了什么:食物过敏唯一获批的生物药 omalizumab 中和游离 IgE,对结合在 FcεRI 上的那部分拿不太掉。在自家研究团队引导下,Claude 执行 22 个阶段,目标是能把它撬下来的双臂抗体。单一浓度下筛了 91 个拆解臂,20 个快过所有阴性对照;其中八个纯化后做剂量滴定,三个在 25 至 400 nM 之间清除得比 omalizumab 更多。57 个锚定臂设计里 3 个结合 IgE,表观亲和力 3.4 至 235 nM。
为什么重要:把结合上去的 IgE 从受体上拉下来需要精确的几何关系,而展示库和免疫途径都无法指定它,所以在这里,从结构出发做设计是要点本身,不是图方便。改到距母本八个替换之远,功能仍然保留;命中来自这场设计试过的每一个改写范围和每一种方法。Divergence 说这两条臂是以周计拿到的,而筛选通常要几个月。
证据与边界:这是 Divergence 自己的报告,未经同行评审,全部是传感芯片上的生物物理测量:没有细胞,没有动物,双臂分子还没做出来。报告写明,剂量滴定里这些变体看起来并未强过母本 sdAb026,最好的那个在多数浓度下与它相当;Anthropic 概述这项工作的文章没有提到母本。锚定臂亲和力可能被亲合效应混淆;方法还需先有已知拆解分子的序列和解出的结构。
DeepMind 把 Genie 4 发给受信任的测试者:一个它定位为机器人与智能体训练环境的世界模型,而发布里没有一个数字
发生了什么:模型把视频与音乐、环境声和可交互对话一起生成,DeepMind 称这是它第一个原生生成音频的实时世界模型;模拟进行中还能用自然语言改天气、移镜头或加一个人。它建立在 Gemini 系列之上,由 Gemini Omni 锚定真实外观与行为,所有输出都将带上 SynthID 水印。
为什么重要:DeepMind 自己给出的用途包括为机器人与智能体开发训练环境,以及在把 AI 系统带到真实世界之前先测试它们。有一段的提示词是「Universal Robots UR5 拿着移液器往实验板里加液,溅出细小电火花」,这是帖子里唯一的实验室场景,而帖子点出的测试者来自创意、新闻、教育、游戏和工程。
证据与边界:发布里没有基准、没有分数,也没有与 Genie 3 的对比:只有片段、说明文字和一次没给结果的内部安全评测。媒体报道的两分钟一致性数字两篇帖子里都没有;没给时长,只说模拟跑得越久,物体恒常性越可能漂移。只开放给受信任的测试者,没有公开访问。

Omabit 获 Bright Ventures 领投的 200 万美元种子轮,用 AI 分析药企自己的临床与基因组数据
发生了什么:这家旧金山公司参加了斯坦福 StartX 2026 夏季营,把药企自己的临床试验、RNA 测序、变异等数据与已发表研究放在一起,按科学家用日常语言提出的问题跑分析并写成报告,先服务于根据已完成试验规划下一项试验的团队。CEO 兼联合创始人 Elena Cassidy、Bright Ventures 创始人 Lenore Champagne Beirne 和科学顾问 Michael Snyder 在新闻稿中发言。资金用于平台开发,以及招聘科学与工程人员。
为什么重要:它押的是:临床开发慢在分析,不在数据。药企手里已有能解释谁对药物有反应的临床和基因组结果,只是散在不同研究和系统里。Omabit 卖的是把它们接起来并做分析,包括用公司自己的数据建预测模型,而不是新数据。
证据与边界:网站称分析从三个月缩短到一天,这是公司的说法,没有展示案例。没有点名任何客户。
Biographica 的 CROP-1 根据基因的 DNA 和哪些调控因子在表达,预测作物基因在每种组织和条件下的活性,并设计只针对一种情境的编辑
发生了什么:伦敦作物 AI 初创公司 Biographica 的 Paride Antinucci、Dominic Hall 等人在 bioRxiv 预印本中,把基因的 DNA 和某种组织或条件下转录因子(开启基因的蛋白)的实测水平一起输入模型。在六种植物的留出数据上,它在不同情境间的每基因相关系数中位数为 0.831,去掉这项输入的同一模型为 0.486,比三个完整微调的基因组基础模型高 57% 到 246%。随后它为大豆和番茄设计了最多改 20 个碱基的编辑。
为什么重要:许多作物基因影响不止一个性状,一个在某种组织或条件下有利的编辑,可能在别处带来不想要的变化。能按情境预测表达的模型,让育种者在编辑任何植物之前,就按目标位置想要的变化和其他位置的变化给候选编辑排序。Biographica 向种子公司提供基因编辑靶点。
证据与边界:这些编辑只是预测,还没有一个在植物中做出来并测量。测试数据来自公开的 PlantExp 数据集,由公司自己的团队评分,预印本也未经同行评审。
新加坡投入 1.5 亿新元建 MARVEL-AI:A*STAR 牵头,把材料 AI 模型和自动化实验室接在一起,CuspAI 是合作方之一
发生了什么:新加坡副总理 Gan Kim Yong 在 SWITCH 2026 上宣布 MARVEL-AI:由 A*STAR 牵头,政府首期投入 1.5 亿新元,AI 模型挑选候选材料、设计实验,自动化实验室负责合成和测试。平台设在 A*STAR 材料研究与工程研究院(IMRE),该院执行院长 Xian Jun Loh 同时领导 MARVEL-AI。公布的合作方包括材料一侧的 ST Engineering、Heraeus Electronics 和 Foxconn Industrial Internet,以及 AI 一侧的 CuspAI 和 Google Cloud。
为什么重要:演讲点明了它要补的缺口:Google 的 GNoME、微软的 MatterGen 这类模型能提出材料,但一种材料还要做出来、测过、能量产,产业才用得上。MARVEL-AI 把模型和实验室放进同一个国家项目,并把设备、测试和研究人员向企业开放,包括初创公司和中小企业。用 AI 设计材料的 CuspAI 将把自己的系统接到平台的自动化实验室上。
证据与边界:这是一项宣布:演讲和报道都没有给出 1.5 亿新元的分配、时间表,也还没有任何材料成果。每天最多 470 个合金样品、是常规通量 400 多倍的数字,是新加坡企业发展局引用的一个现有实验流程,不是 MARVEL-AI 的成果。

晶体结构预测在 15 个候选里找回吖啶全部 7 个已解析晶型;试过的机器学习势里,只有针对吖啶微调的那个排对了它们的稳定性顺序
发生了什么:纽约大学和 Flatiron 研究所的 Adam Lahouari、Jutta Rogal 等人研究了吖啶,一种至少有八种晶型的小分子。熔体实验首次解出了晶型 VIII 的结构。他们的 CrystalMath 方法不计算任何能量,从生成的 341,683 个结构中留下 15 个,其中包含全部 7 个结构已知的晶型,晶型 VIII 也在内。针对吖啶微调的 MACE 势加上完整的自由能计算,复现了实验中随温度升高、稳定性从晶型 II 转到晶型 III 的切换。
为什么重要:同一种分子可以结晶成几种表现不同的晶型,这对药物、有机电子和农化都很重要;领域希望用晶体结构预测加机器学习势,在合成之前就给晶型排好序。这里排序这一步需要微调:四个现成的基础势都把顺序排错了,简化的自由能近似也没算出观察到的相变交叉。研究还在 18 种添加剂下从熔体中生长吖啶,发现效果最强的两种与计算出的缺陷能一致。
证据与边界:只有一种分子。预测的两个最稳定晶型的交叉温度约 290 K,实测约 318 K;有些观察到的相变与自由能曲线不符,晶型 IV 也没有纳入计算。添加剂的关联只建立在 18 种中的两种上。预印本。

评论
Sussillo:近期是 AI 帮神经科学,虚拟大脑或能让脑科学反哺 AI
Neuroscience gave AI its start. What happens now?
主张:在 Google Brain 和 Meta Reality Labs 做了近二十年研究的计算神经科学家 David Sussillo 认为,脑研究近期很难改变 AI 的走向,因为记录只能覆盖极少一部分神经元。眼下是 AI 帮神经科学;要让局面反过来,一条路是用高质量神经数据训练一个基础模型,做出虚拟的小鼠大脑,或者类似的大工程。
为什么读:值得读的是他给出的具体判据:脑数据要对 AI 有用,需要一个能像 AI 模型一样被快速反复试验的全脑模型。没有它或类似的大工程,他预计 AI 公司只会把神经科学家招走。这是一篇访谈,观点多,例子少。
评论
Pisek:AI 编造的参考文献应按科研不端论处,作者负全责
AI-hallucinated citations should be treated as research misconduct
主张:塔尔图大学的 Jan Pisek 举出塔林行政法院的一个判例:原告提交的文件引用了 AI 编造的研究,法院对其罚款,认定使用者要为自己提交的 AI 内容负责。他主张学术界照此办理:每条引用都由作者负责,AI 幻觉引文就是科研不端,arXiv 新设的处罚来得及时。
为什么读:值得读的是它从法院借来的标准:不管内容出自什么工具,提交的人就要为它负责。这是一封短信,主要依据爱沙尼亚的一个判例。
评论
Bravo-Abad:先说清结论依赖哪种数据迁移,再拿它做测试
This week in AI-for-science: 307 papers, one question: what happens when the data move?
主张:Jorge Bravo-Abad 读了一周的 307 篇论文,认为模型最有用的结果,是它在不像训练数据的数据上表现如何。先说清一个结论依赖哪种迁移(新化学体系、新地点、新病人群体、新年份或新干预),再拿这种迁移做测试,并且先于随机划分的分数报告它。
为什么读:值得读的是几条可以照搬的检查:在训练时刻意留出的化学体系上,按不确定性挑的样本并不比随机挑的好;把相关的岩石样本分开后,逻辑回归和深度学习打成平手。模型给实验排序时,也要测一个排名靠后的候选,否则命中无法说明排序本身有用。
利兹大学分拆公司 adsilico 完成 1000 万英镑 A 轮,用 AI 生成的虚拟患者测试心脏瓣膜和支架
发生了什么:PXN Ventures 领投,老股东 Northern Gritstone(出资 500 万英镑)和 Parkwalk 跟投。adsilico 于 2024 年由 CEO Sheena Macpherson 与 Nishant Ravikumar、Zeike Taylor 创办。其 Virtual Chimera 平台用生成式 AI 从匿名影像生成虚拟心脏和血管,再对器械在每个个体里的表现做物理仿真。资金用于心脏模型、神经血管器械,以及把团队从 14 人扩到 34 人。
为什么重要:一项器械试验只招几百名患者,很多体型根本没被测过。adsilico 的做法是把解剖结构的生成模型和物理仿真结合起来,做计算机模拟试验:先在成千上万个虚拟身体上测,再上真人;而在这个领域,什么证据算数由监管机构决定。
证据与边界:公司说已与心脏瓣膜和神经血管器械厂商完成项目,但未点名客户,也没有引用虚拟患者与真实结果对照的验证。PXN 领投出自 Tech.eu;Northern Gritstone 自己的公告列了投资方,但没说谁领投。

Anthropic 递交上市申请,代码 ANT,把科学研究和实验室机器人列为前沿 AI 可能打开的新市场
发生了什么:10 月 26 日递交的 S-1 显示,2026 上半年营收 163 亿美元,2025 全年为 46 亿美元;运营亏损从 21 亿美元收窄到 6.93 亿美元。807 亿美元的净亏损几乎全部是一笔 724 亿美元的非现金重估,对象是可转债、衍生负债和 SAFE。算力承诺包括对谷歌至少 1,145 亿美元、对亚马逊 1,100 亿美元、对微软 449 亿美元,都与用量无关。
为什么重要:从科学的角度看,申报文件写明前沿 AI「可能」扩展到机器人和科学研究,包括药物发现和材料科学,并称 Claude 借助 Model Hardware Standard「现在」已能操作显微镜、液体处理设备和机械臂。它对「强大 AI」的设想还包括持续数周的自主任务,以及「把数十年的科学进展压缩到几年」。但在账目里,公司只有一个分部,生命科学实验室出现在风险因素中。
证据与边界:6 月的数字是未经审计的中期数据。三家云厂商的承诺只是七项已列明安排中的三项,表外另有估计 1,250 亿至 1,500 亿美元的 TPU 算力,承诺总额一栏还空着。前五大客户约占营收四分之一。Founder LLC 新设的股类持有 50.1% 的投票权,长期利益信托则通过自己的股类选出董事会多数。
AM+1设计出的蛋白骨架结合金属光催化剂,再经五个进化出的突变变成有对映选择性的酶,周转数超过 5 万
发生了什么:印第安纳大学 Jared Lewis 的团队与 David Baker 合作,试验了 96 条设计,其中 63 条成功表达;一个名为 DE3 的骨架以 94% 的对映体过量结合铱光催化剂的一种镜像。但刚设计出来时,它在催化上选择性很低。经过突变筛选,对映体比达到 3:97,空气中周转数超过 5 万,蛋白还能回收重复使用三轮。
为什么重要:生成式设计给出的是一个口袋,能容纳自然界没有对应蛋白的辅因子,这正是以往从已有折叠里拿不到的。在这个反应上,对映选择性来自之后的突变筛选;而第二轮设计后来在另一个反应上未经任何进化就做到了 90:10。金属多吡啶光催化剂此前在这两条路上都没能走通。
证据与边界:做下去的只有一个骨架,而测试结合的有五种折叠。口袋是围绕一个钌辅因子设计的,最后只结合铱的类似物,也没有拿到结合辅因子后的结构。底物范围里的另一些反应只有中等选择性。设计和评测出自同一批团队。属于加速预览版。
得州农工大学获 200 万美元,建一座由机器人运转、设计并熔炼和测试新合金的铸造实验室
发生了什么:资金来自 Roku 创始人 Anthony Wood 与 Susan Wood 的慈善机构 WoodNext 基金会,用于在该校材料科学与工程系建设 Aggie AI Foundry。用物理模型和以往合金研究训练的 AI 提出成分,机械臂负责配料、熔炼和测试,温度可达 3000 °C。项目由系主任 Ibrahim Karaman 与 Raymundo Arróyave 牵头,学校说可把合金研发从数月缩短到一周以内。
为什么重要:学校说,现有的自动驾驶实验室处理的是容易合成和加工的材料,而新合金必须在极高温度下熔炼和测试;Arróyave 补充说,还没有任何计算工具能预测一种合金的表现。一座能为金属跑完整个闭环的实验室,检验的是由 AI 主导、机器人执行的发现能否延伸到能源、航空航天和医疗所用的结构材料。
证据与边界:这是建实验室的资助,不是一座已在运转的实验室:没有给出启用时间、通量或任何结果。“学术界首个此类实验室”和“从数月缩短到一周”都是学校自己的说法。
OpenAI 与 Anthropic 各自宣称找到亚指数时间的 3-SAT 算法,推翻指数时间假设;两边都过了 Lean 检查,但都没有外部核验
发生了什么:OpenAI 的手稿标注 10 月 25 日,次日连同 Lean 形式化一起放进公开仓库,给出一个在亚指数时间内计数定宽 CNF 可满足赋值的确定性算法。Anthropic 的 49 页论文标注 10 月 26 日、27 日推上仓库,结论相同,署名 Claude, Anthropic,并称模型是 10 月 16 日找到的。
为什么重要:这个假设撑起了几十年的下界工作:Anthropic 的论文说,Claude 的文献检索找到 800 多篇论文,结果只在它或更强假设下成立。只要有一边成立,这些条件性结论就得重读;而参与组织核验的 Ryan Williams 说,若成立,该让每位计算机科学家把 P=NP 的可能性加重。
证据与边界:两家公司之外,没有人验证过任何一份证明。Lean 检查的是证明能否从形式化陈述推出,而不是这个陈述是否就是论文所说的那件事,这一点 Anthropic 自己写明了,还说截至成稿没有已知的人检查过它的 Lean。OpenAI 形式化的界比手稿更弱,只针对规范编码输入,但仍是亚指数的。Anthropic 说它纯属渐近。

OpenAI 在发布前就安排好了检验的人,而被安排的这一组给同行写信说明:参与不等于认证
发生了什么:OpenAI 发布前先告知三位复杂性学者,请他们组织检验。Russell Impagliazzo、Ramamohan Paturi 与 Ryan Williams 当天写信给同行:「我们的参与不应被视为对该主张的认证。」他另在账号上说,小组没签保密协议、不收钱,OpenAI 答应公开原始材料并资助会议。
为什么重要:机器的结果由谁认证,是这六周争的事;这一次,实验室在发布前先点了检验者的名。那封信就是被点名的人拒绍这个角色,同时守住筹码:Williams 说他们要了原始材料和一场 OpenAI 资助的会议,对方答应了;信里写明,这项工作不该把所有权交给任何公司或少数被选中的人,包括他们自己。
证据与边界:OpenAI 的发布页这里返回 403,其说法未被引用;仓库 history 文件称这三人为独立工作组,没点别人。半岛电视台所报推迟的物理成果无公开材料,OpenAI 721 篇数学手稿目录里也没有量子色动力学论文。保密协议、报酬、材料和会议四点是 Williams 的话,信里没写;信没有日期。
一份声称证明了所有维度局部平滑猜想的论文,连带给出所有维度的 Kakeya 猜想;已发表的结果只到三维
发生了什么:OpenAI 的 59 页论文署名 OpenAI,标注 10 月 25 日,次日放进公开仓库,证明了 Sogge 猜想在空间维数不低于二的每一种情形,Sobolev 损失可取任意小,p=2 时为零。论文由此推出 Bochner-Riesz 猜想、Stein 平方函数的锐界,以及 Kakeya 与 Nikodym 极大猜想。OpenAI 说,它直接发布的是模型的输出。
为什么重要:已发表的结果里,平面的情形来自 Larry Guth、Hong Wang 与 Ruixiang Zhang,三维的 Kakeya 是 Hong Wang 与 Joshua Zahl 去年做的;这篇一次给出所有维度,并引了 OpenAI 九月的两份预印本,表明它取代了那两份。与同一天发布的复杂性结果不同,这里的 Lean 覆盖了头条主张:所有维度的局部平滑界,以及「在每个方向上都含一条单位线段的集合具有满 Hausdorff 维数」。
证据与边界:OpenAI 之外没有人核验过,而 OpenAI 自己的仓库把这批手稿称作原始研究数据,不是打磨好的论文。球面、抛物面与锥的限制估计只在猜想范围的内部成立,所以限制猜想并没有在这里被解决。同一个仓库在 10 月 7 日因为一个符号错误撤回过三份手稿。
POISK 从专利里挖出 89074 条抗体-抗原记录,考察结构预测模型能否挑出真正结合的抗体:最好的模型做到 72%
发生了什么:罗氏 Prescient Design 与大分子研究部的团队用语言模型流水线,从 10110 份美国专利抽出 89074 条抗体-抗原记录,再构建 11247 对:一边是专利声明能结合、且无已解析结构的抗体,另一边是序列相近的诱饵。考察六个结构预测模型能否把两者分开。Protenix-v2 最好:全部配对 72%,最有把握的一半 87%,从 50 个候选里挑中真的那个占 29%。最好的模型只在 62.8% 的情况下碰到已标注的表位残基。
为什么重要:筛选设计抗体的团队,习惯把模型的折叠置信度当作结合的替代指标。这给出了它值多少:远好于随机挑选,但远不足以指定一个候选去合成。而且能把结合的与诱饵分开,并不意味着姿势是对的,所以用这些模型读表位是另一个主张,这些数字并不支持。
证据与边界:这里没有任何实验测量:结合的一方来自专利的声明,不结合的一方是假定不结合的抗体库序列,所以这些准确率是对着构造出来的阴性集算的,不是测出来的亲和力。结构不在模型的训练数据里,专利文本则可能在。预印本本身按 CC BY 发布,并称数据集已公开,但没有说明数据集的许可。未经同行评审,全文未读。

此刻值得关注
证据简报
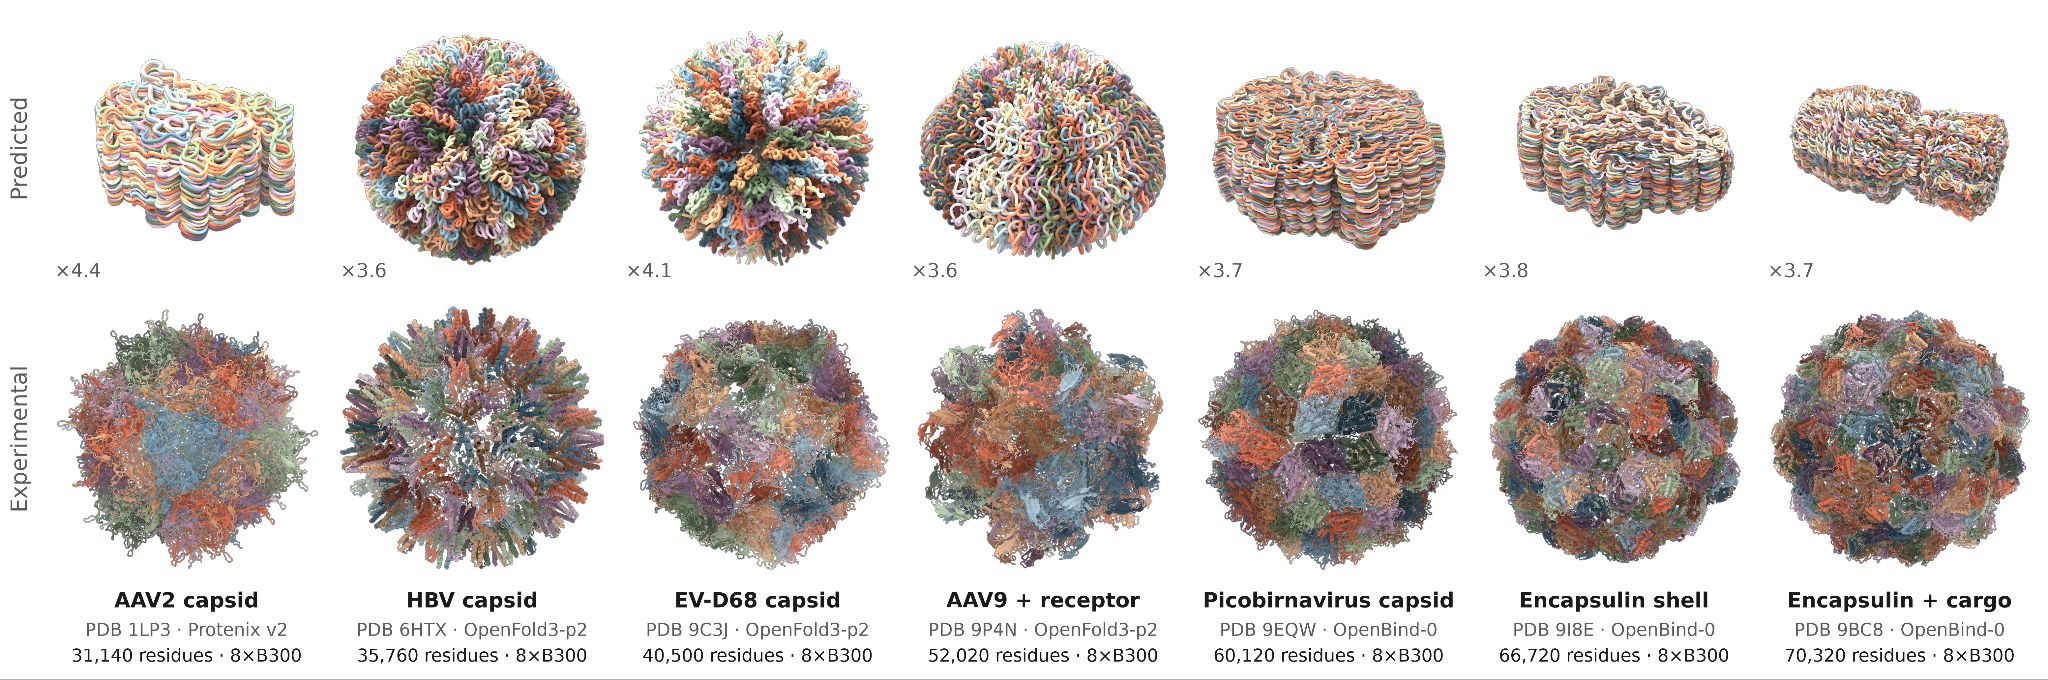
Claude 改的是生物工具本身,而不只是调用它们
一个内部研究模型在不到四周里让 30 多个开源模型平均快约 4 倍,优化包连代码一起开源。
30+ models · 36 open kits
MODEL · BIOLOGY · SEP 20
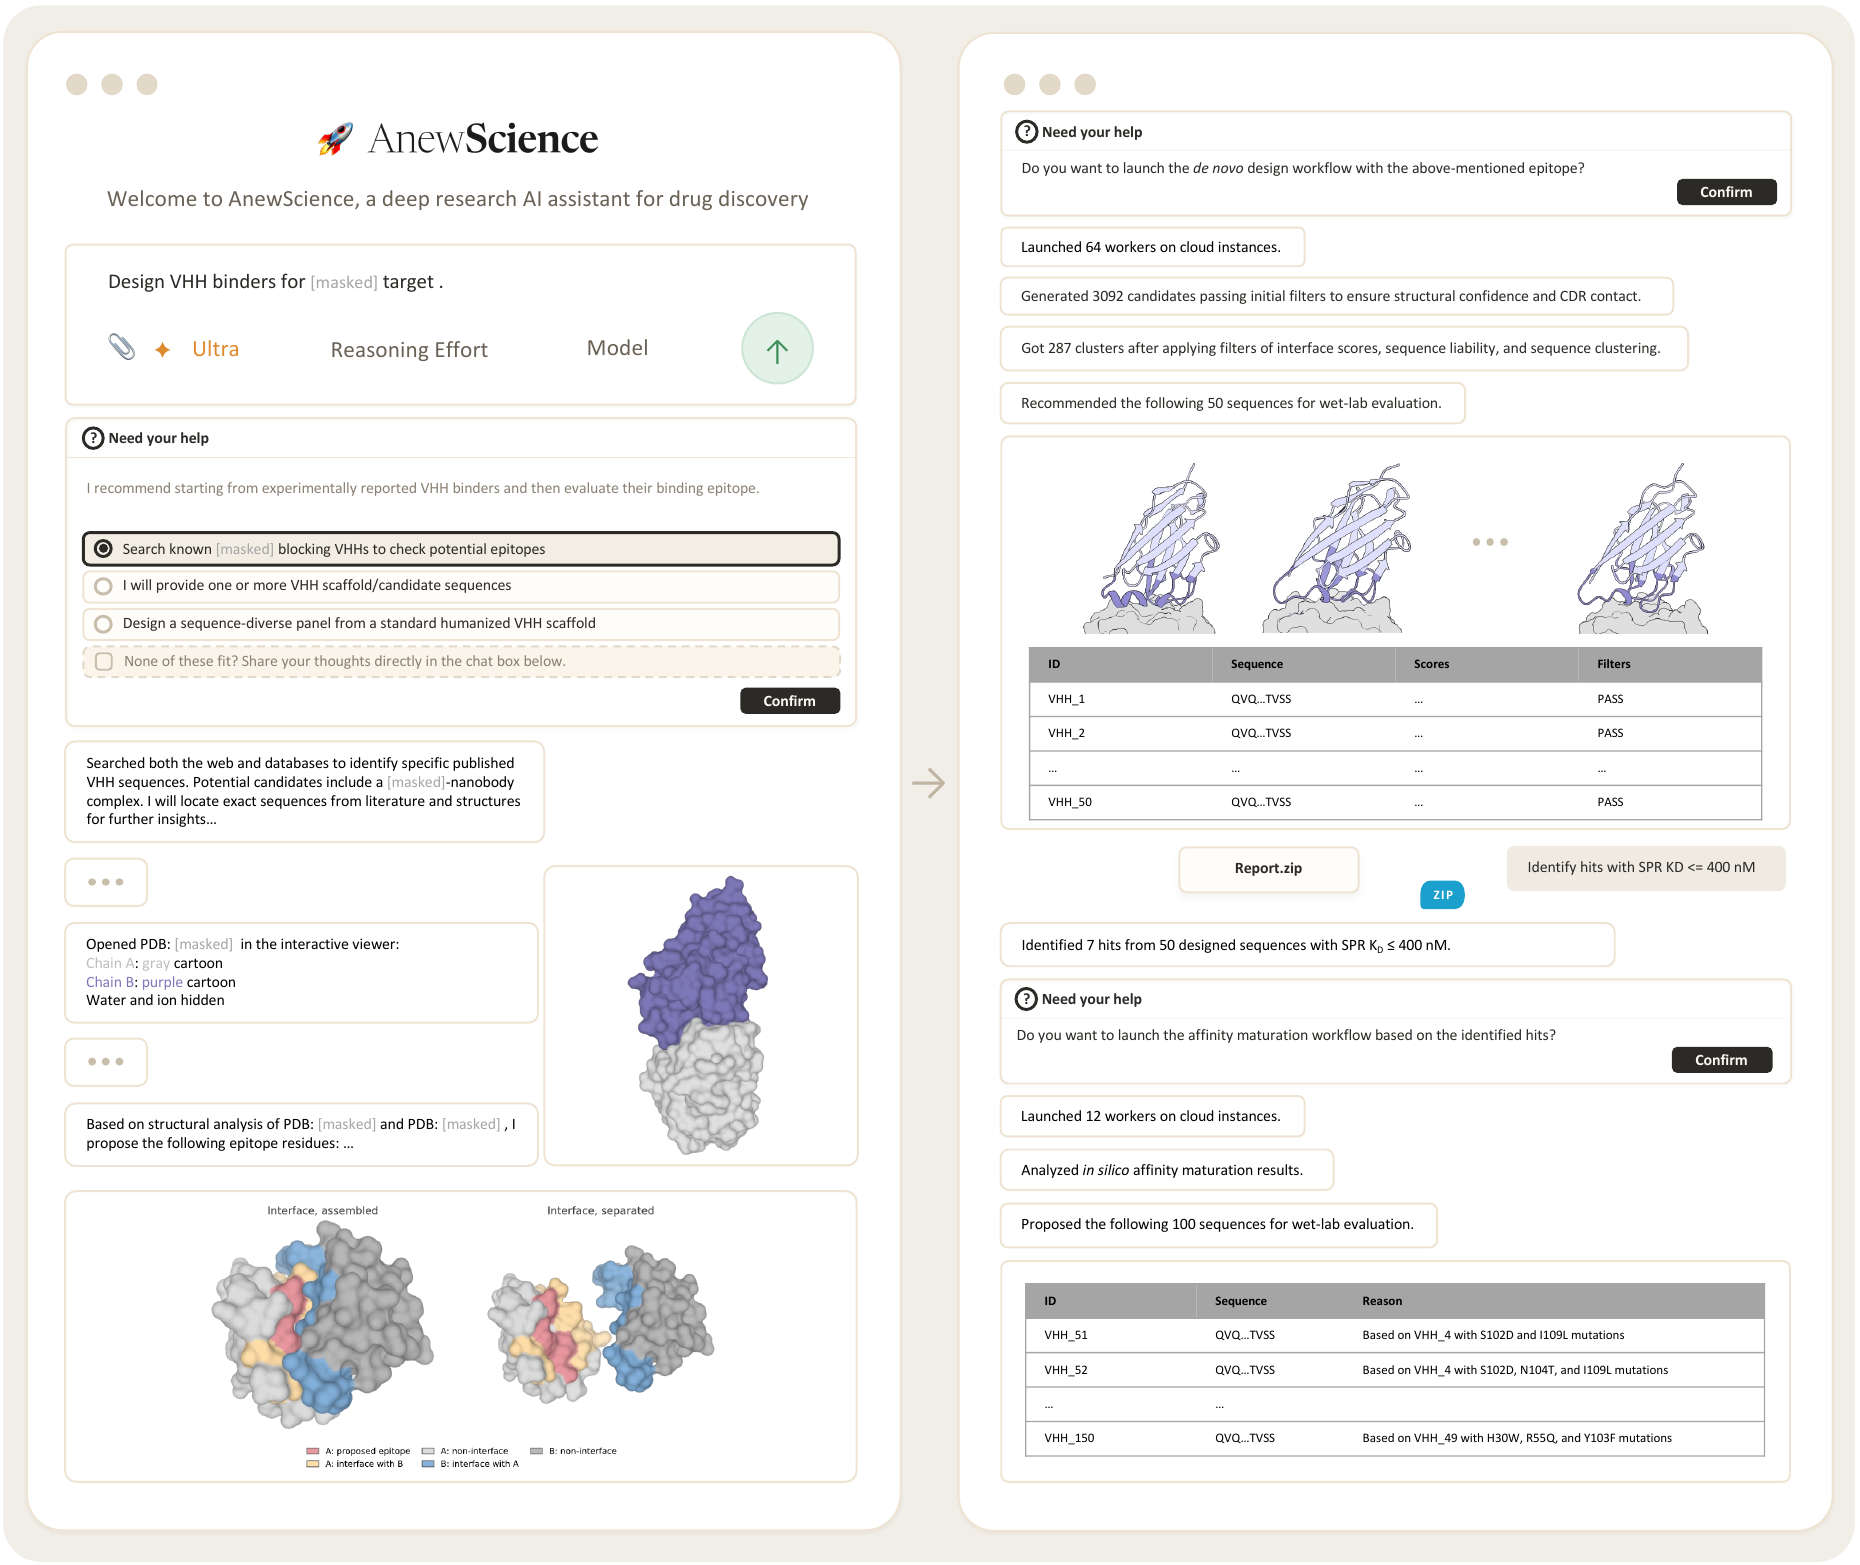
AnewDDE 把抗体设计循环放进一段对话里
首轮 SPR 测量指导了第二轮优化,这条循环在一个内部靶点上跑完了两轮。
16 of 150 clones at 1.8-8.1 nM
INTERACT · ANTIBODIES · SEP 19
Periodic Labs 把实验结果变成模型的训练信号
专家评分被做成可训练的 reward;同一个模型接上实验室上下文与内部工具后,成功率高出 3.8 倍。
2.7% → 55.3% on FrontierXRD
MODEL · MATERIALS · SEP 19
AlphaGenome Atlas 把 90 亿种 DNA 变异做成可查询的地图
把全基因组变异效应提前算好,降低的是推理与搜索成本;预测不会因此变成实验事实。
9 billion variants · ~1 PB
MODEL · GENOMICS · SEP 10
Anthropic MHS 把仪器接入变成共享基础设施
标准降低了智能体连接硬件的软件成本,但物理状态、安全操作与实验语境仍是更难的一层。
58% → 99.3% laser-relock success
INTERACT · INFRASTRUCTURE · AUG 30
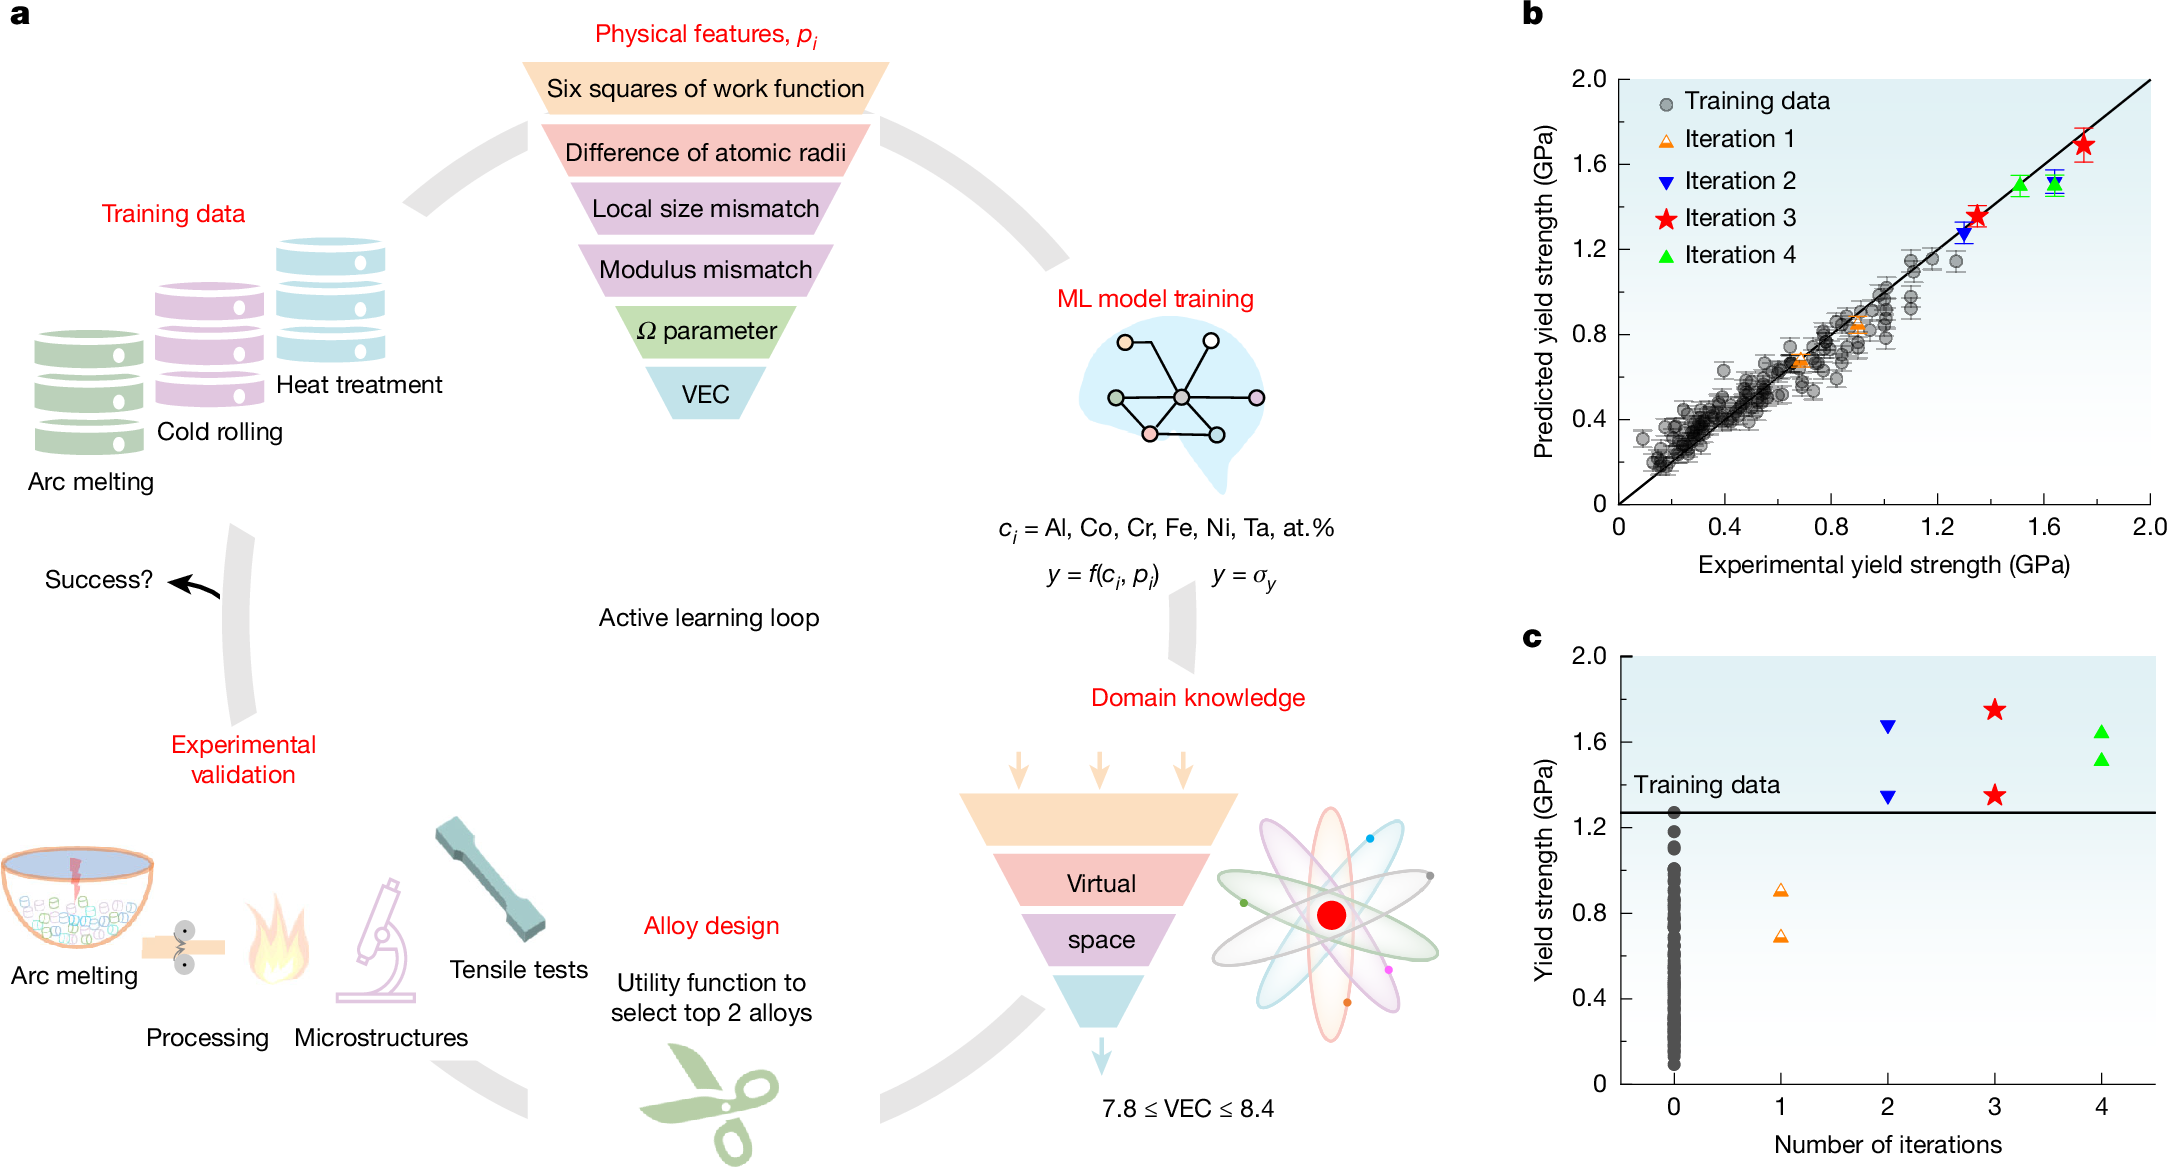
HEA05 把主动学习带进真实合金实验
模型不只离线排序候选,也开始决定下一次稀缺的物理实验应该花在哪里。
4 rounds · 8 new physical experiments
DECIDE · MATERIALS · AUG 23
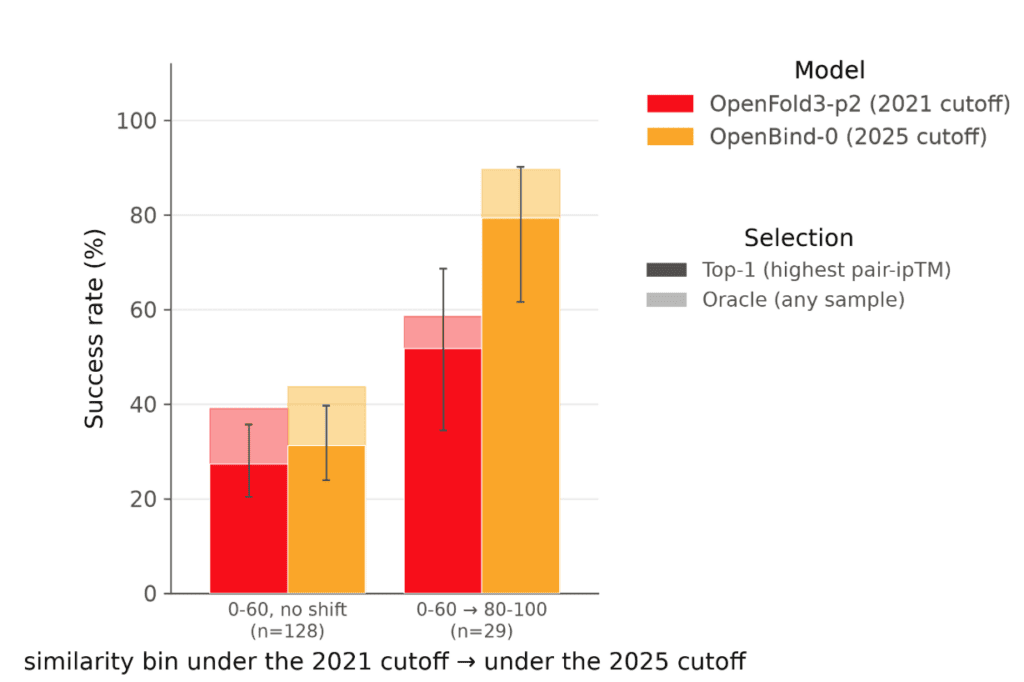
OpenBind-0 说明更多数据不一定带来更好覆盖
科学价值取决于新证据落在哪里,而不只取决于收集了多少。
717 new experimental structures
UPDATE · BIOLOGY · AUG 22
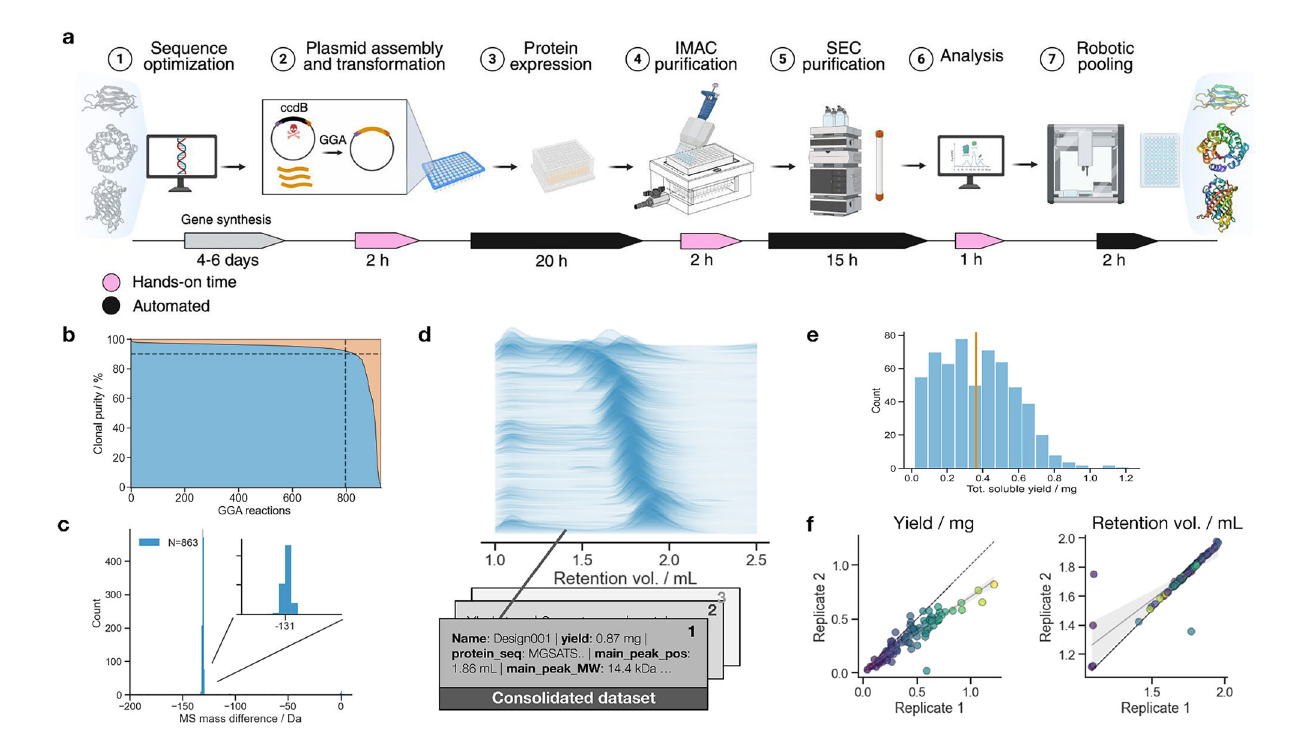
SAPP 与 DMX 让蛋白验证更标准、更并行
蛋白生产与表征开始从定制作业变成可复用的实验基础设施。
~48 hour standardized workflow
INTERACT · BIOLOGY · AUG 21
持续追踪
我正在追踪的问题
AI 能不能从“提出候选”走到“在物理世界里闭环学习”?
Radical AI · Lila Sciences · DP Technology
测量、提取或编码过程中的信息损失,是科学 AI 的硬上限,还是规模可以补上?
MinerU.Chem · OCSR · Smirk · AlphaGenome Atlas
AI Scientist 靠智能取胜,还是靠一种新的实验经济学?
Radical AI · Lila Sciences · FutureHouse
发现变快,真的会让部署变快吗?
Radical AI · Recursion · Isomorphic Labs · Microsoft
实验数据能不能成为比模型更持久的护城河?
Radical AI · Recursion · Lila Sciences
他们说了什么
访谈
人类细胞图谱联合发起人 Sarah Teichmann:单细胞参考图谱的初稿快完成了,药物研发里先用在靶点和安全性上
Teichmann 说,人类细胞图谱用悬浮单细胞数据做的第一版人体参考图谱已接近完成。她认为它在药物研发里最先起作用的地方,是看清靶点在哪些细胞里表达、哪里可能出安全问题;从 AI 预测到实验,她说是在多种实验模型之间来回迭代,不是一次预测、一次验证。
三位数学家读 OpenAI 的 722 篇手稿:准黎曼证明是已知工具的新串法,流体工程什么都没变
三位研究领域被这批结果直接碰到的数学家,各自读了自己领域那一项:Kontorovich 说准黎曼猜想的 Lean 命题早就在 Mathlib 里,所以他对证明正确有十足把握,用的都是解析数论已有的手法;Moitra 说 Unique Games 的证明“不太好读”,看不出新想法在哪;Brunton 说 Navier-Stokes 的结果在一个不符合物理的区间里成立,工程上的流体计算一点没变。
Frankle:企业用 AI 卡在“怎么测”,不在模型够不够聪明
Frankle 说,自 Claude Sonnet 3.5 起,模型对很多复杂的企业任务已经够聪明;卡住的是把任务说清楚,并知道做得对不对。他的结论是,评测的成本要降几个数量级,企业才能放心用。
AI4S 地图
如果第一次接触 AI4S,可以从这几项开始;不需要完整的专业背景,读完能建立起对这个领域的基本判断。
从这里开始
理解数据密集型科学的经典起点之一。Gray 提出,继实验、理论、计算模拟之后,数据密集型探索正在形成新的科研范式。今天很多 AI4S 讨论,都可以放回这个更长的历史里理解。
Hanchen Wang 等人的综述,横跨生物、物理、化学、材料。如果只读一篇,读这篇:它把"AI 用在科研的哪一环"拆得很清楚。
纪录片讲团队与竞赛,诺奖演讲讲技术选择背后的取舍。合起来是理解"什么样的问题适合被 AI 攻克"的一个很好案例:深厚的数据积累(PDB)、相对清晰的实验真值与盲测机制(CASP)、以及与领域结构对齐的架构。
Dagstuhl 研讨会报告,视角比大厂博客中立得多,明确讨论了激励机制、评审制度、数据基础设施这些"非技术瓶颈"。
它提供了理解 AI4S 一条持续争论的重要坐标:该往模型里显式注入多少领域先验(对称性、守恒律、物理约束),又该在多大程度上依赖规模化学习。读完这篇再读下一节,会更容易看懂两种路线之间的张力。
二、方法论基础:AI4S 与通用 AI 分岔的地方
如果用 Transformer 与 scaling laws 概括通用 AI 的一条主线,那么 AI4S 还反复面对另一组无法绕开的结构:对称性、物理约束、逆问题,以及在数据稀缺和分布外条件下如何做归纳。
原子会转动,分子会平移,晶体周期性重复,物理系统守恒某些量,测量带噪声,实验昂贵,很多科学目标压根就在历史数据的分布之外。所以核心问题变成了:
应该强迫模型学会世界的哪些结构,又该允许它自己学会哪些?
讲解与教程
Geometric Deep Learning(Bronstein, Bruna, Cohen, Veličković, 2021):把 CNN、GNN、等变网络统一在群论视角下的"大一统"尝试。分子、晶体、蛋白质本质上都是带对称性的几何对象,这套语言是理解相关模型的前提。有免费书稿、课程录像和讲义。
e3nn 文档与教程:E(3) 等变的工程实现长什么样。做原子尺度建模绕不开。
A Hitchhiker's Guide to Geometric GNNs for 3D Atomic Systems(2023):把 SchNet、DimeNet、NequIP、MACE 的差异讲清楚了,是从"知道有等变网络"到"知道该选哪个"的桥梁。
NequIP(2022):对称性到底能买到什么,这篇给了最干净的答案:E(3) 等变表示带来的数据效率提升是数量级的。它也成为后来一批等变原子势的重要技术祖先之一。
Physics-Informed Neural Networks(Raissi et al., 2019):把 PDE 残差直接写进损失函数。PINN 的工程表现争议很大(见第八节),但它是"把物理放进神经网络"这条思路最著名的代表作。更深的原则超出 PINN 本身:科学模型不必在数据和物理之间二选一。
Fourier Neural Operator:与 PINN 不同的路线:不拟合单个解,而是学习整个解算子。一句话概括这个思路的价值:学的是模拟器,不是模拟结果。 流体、气候、地震的主流方向。
贝叶斯优化与主动学习:在普通机器学习里,数据集在训练前就有了;在科学里,选择该采集哪些数据本身就是问题。 材料发现、催化剂优化、蛋白工程、自驱动实验室里反复出现的探索–利用权衡,都从这里开始。
扩散模型:从图像生成到分子与晶体生成,是 AI4S 过去三年最重要的方法迁移之一。方法本身可读 Lilian Weng 的 What are Diffusion Models?;科学侧的迁移则直接读 RFdiffusion 与 MatterGen 两篇原文最快,它们分别是这套方法在蛋白与晶体上的落点。
课程
- MIT 6.S898 / Deep Learning for Science 与 Stanford CS 279 / Computational Biology:前者偏方法,后者偏生物应用。
- DeepChem 教程:化学/药物方向最好的免费动手材料,从分子表示一路讲到性质预测。
关于 · AI4S.FYI
这个网站如何运作
AI4S.fyi 持续记录 AI 如何进入科学研究:它现在能做什么,有多少证据支持,谁在推动它,以及科研闭环还有哪些环节没有走通。
- 616时间线
- 38证据简报
- 195评论
- 5开放问题
Dekun Sun · 材料科学 × 计算机科学.
评论
Griffin:发现多靠新工具,AI 时代该给造工具和建数据库的人记功
Tools over theories
主张:Google DeepMind 的 Conor Griffin 评介 Alexander Krauss 对 761 项重大发现的研究:几乎每一项都靠一种新近出现的工具或方法才做成。他主张资助者支持造工具的人,以及 AI 所依赖的数据库(例如蛋白质数据库 PDB),并用 AI 改进乃至发明科学仪器。
为什么读:值得读的是它提供了一个可以拿来问任何 AI for Science 计划的问题:它改进的是哪种仪器、方法或数据集,由谁来维护?Griffin 也列出对 Krauss 的四点反驳,第一条是幸存者偏差:造出来的工具大概多数没有带来发现。文章发在 Google DeepMind 政策团队的博客上。