

论文与实验验证· 科学证据 · Frontier
研究者限定合金体系、主动学习挑成分:HEA05 在 1.75 GPa 屈服强度下保持 25% 均匀延伸
西安交通大学的 Sohail 等人不只找到了一种更强的合金。团队先用材料知识缩小搜索空间,再让主动学习挑选下一批实验,把有限的验证预算花在信息量更大的候选上。
●同行评审论文 + 实验验证
当前边界:室温拉伸性能和变形机制已有较完整的表征;长期高温稳定性、疲劳、断裂、规模化加工和成本仍未解决
这项工作推进的是:选择下一次最值得做的昂贵实验
- MODEL理解 / 预测
- DECIDE选择下一步
- INTERACT测试现实
- UPDATE改变下一轮
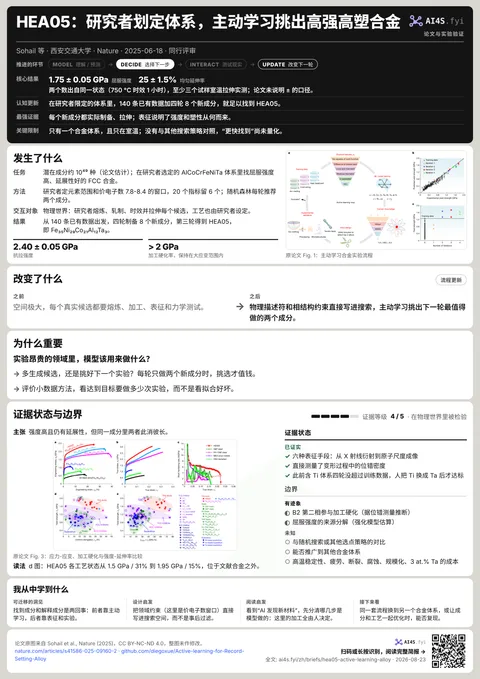
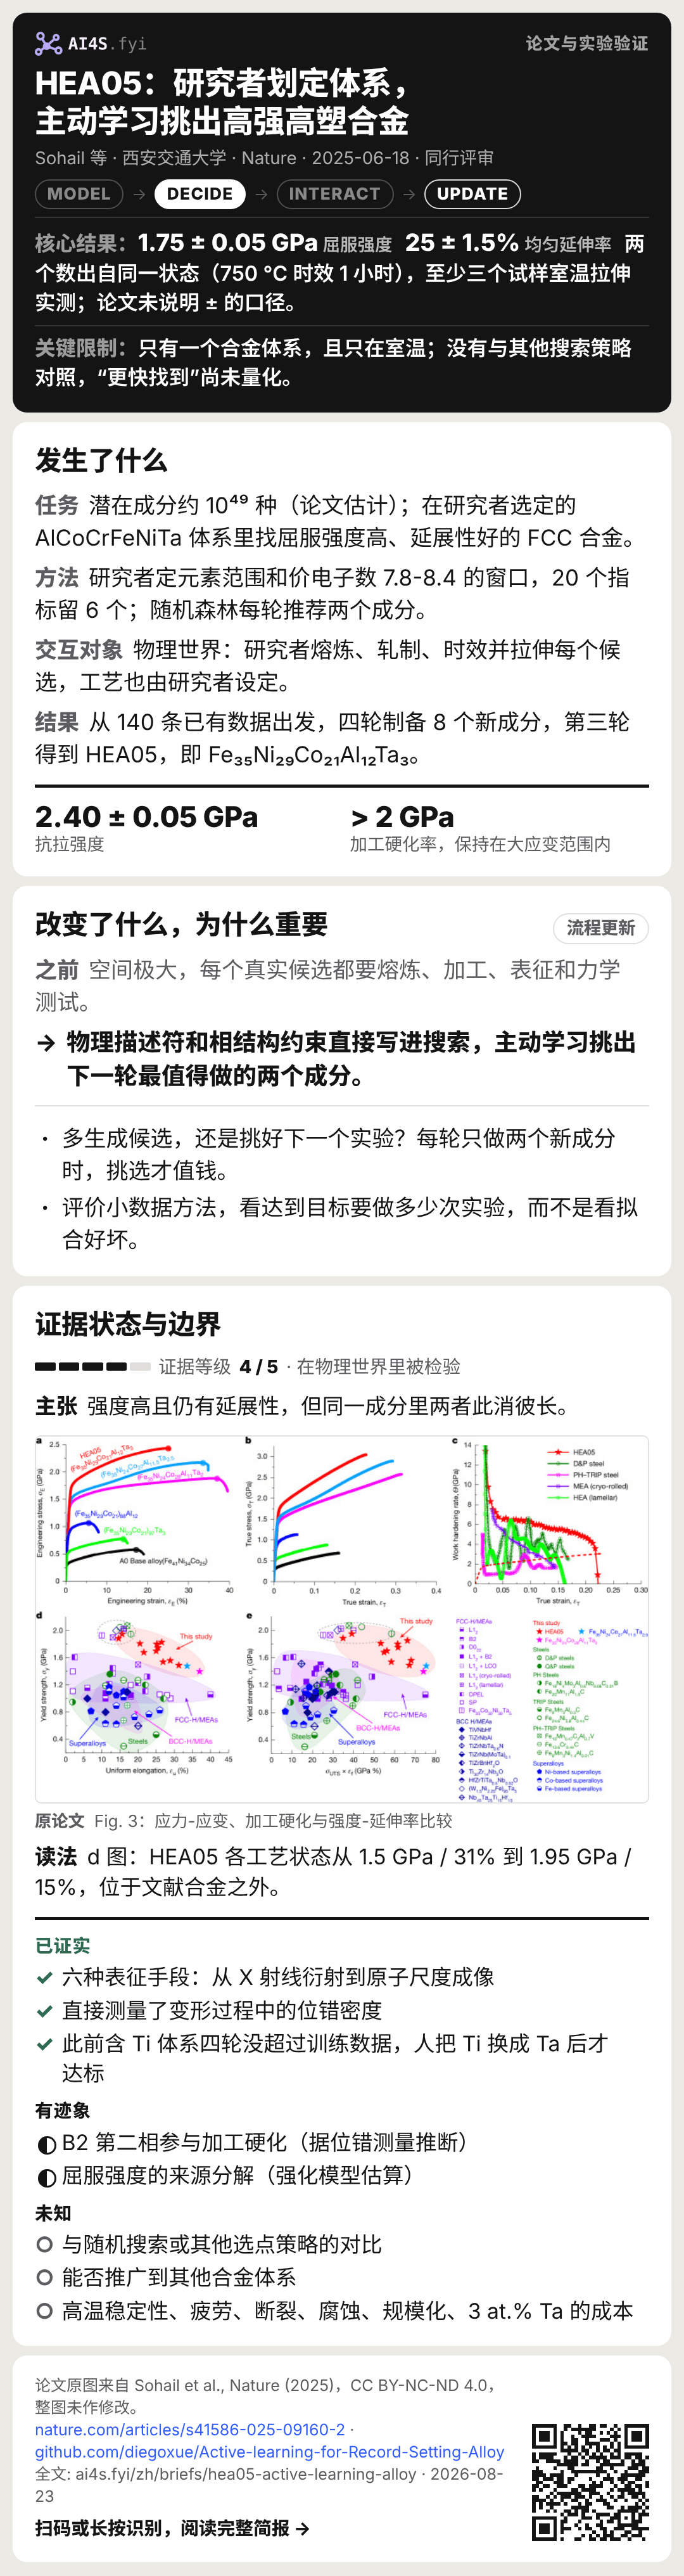
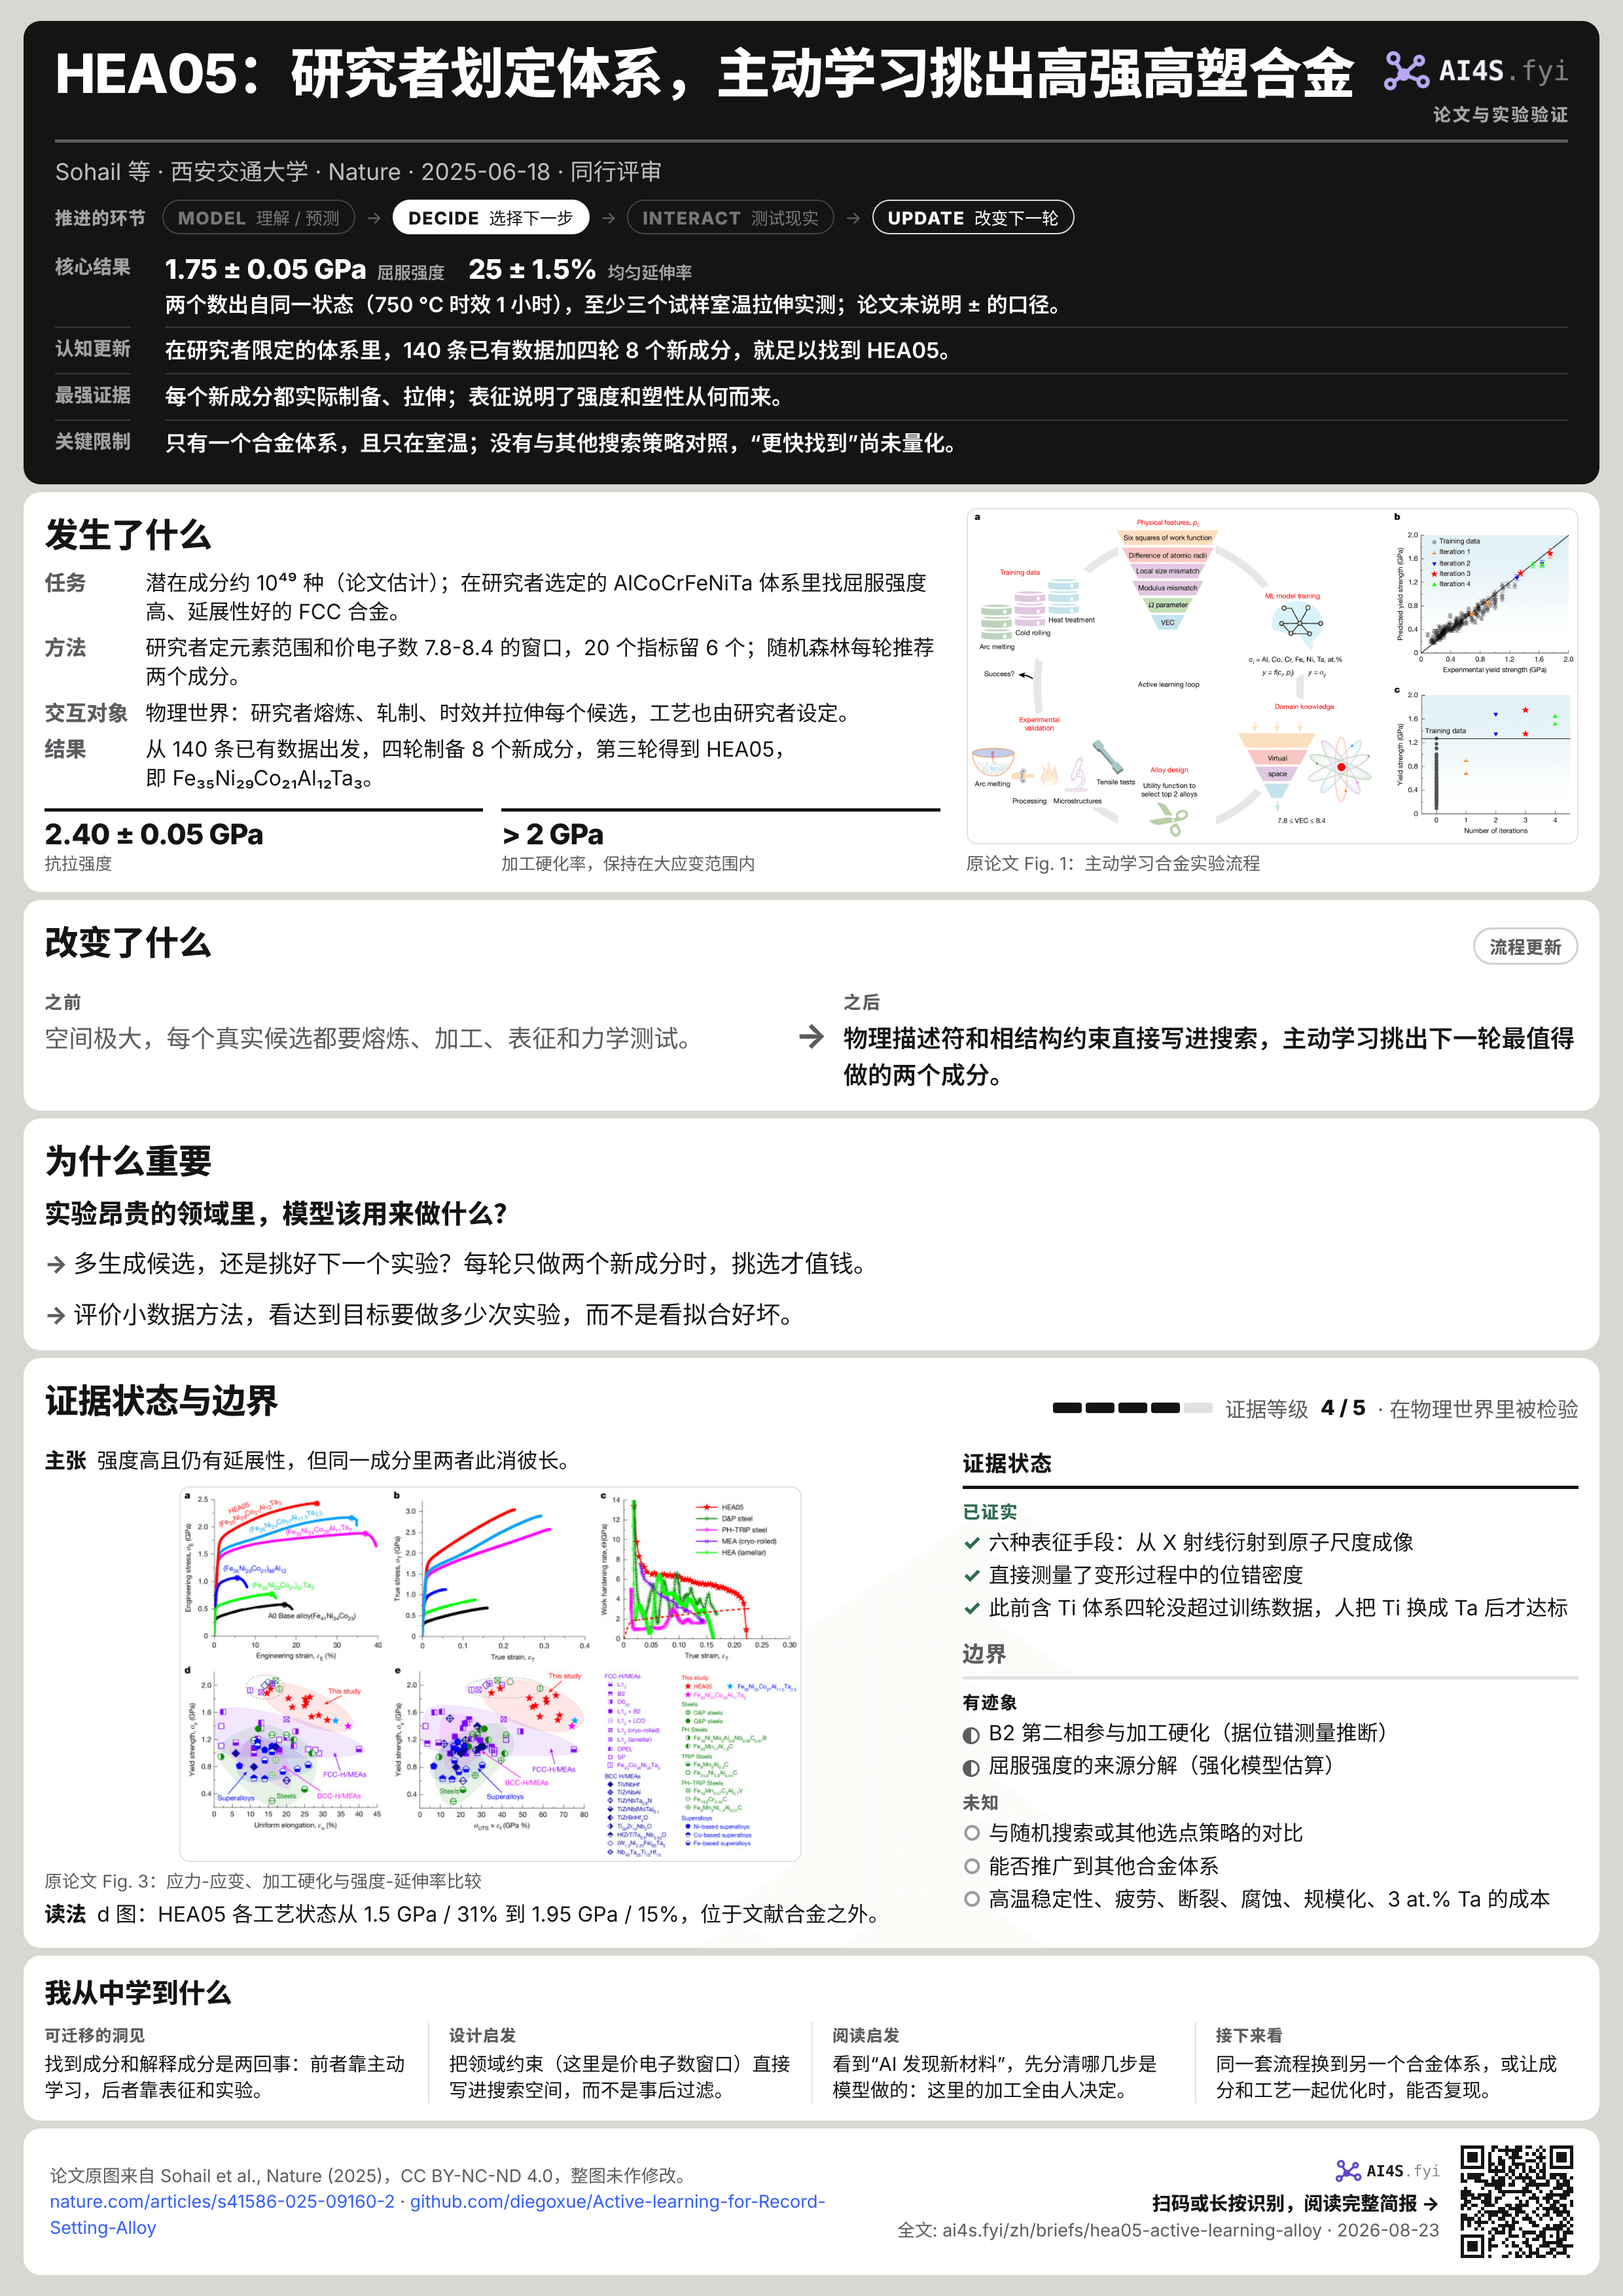
1.75 ± 0.05 GPa屈服强度
25 ± 1.5%均匀延伸率
两个数出自同一状态(750 °C 时效 1 小时),至少三个试样室温拉伸实测;论文未说明 ± 的口径。
- 认知更新
- 在研究者限定的体系里,140 条已有数据加四轮 8 个新成分,就足以找到 HEA05。
- 最强证据
- 每个新成分都实际制备、拉伸;表征说明了强度和塑性从何而来。
- 关键限制
- 只有一个合金体系,且只在室温;没有与其他搜索策略对照,“更快找到”尚未量化。
01发生了什么
- 任务
- 潜在成分约 10⁴⁹ 种(论文估计);在研究者选定的 AlCoCrFeNiTa 体系里找屈服强度高、延展性好的 FCC 合金。
- 方法
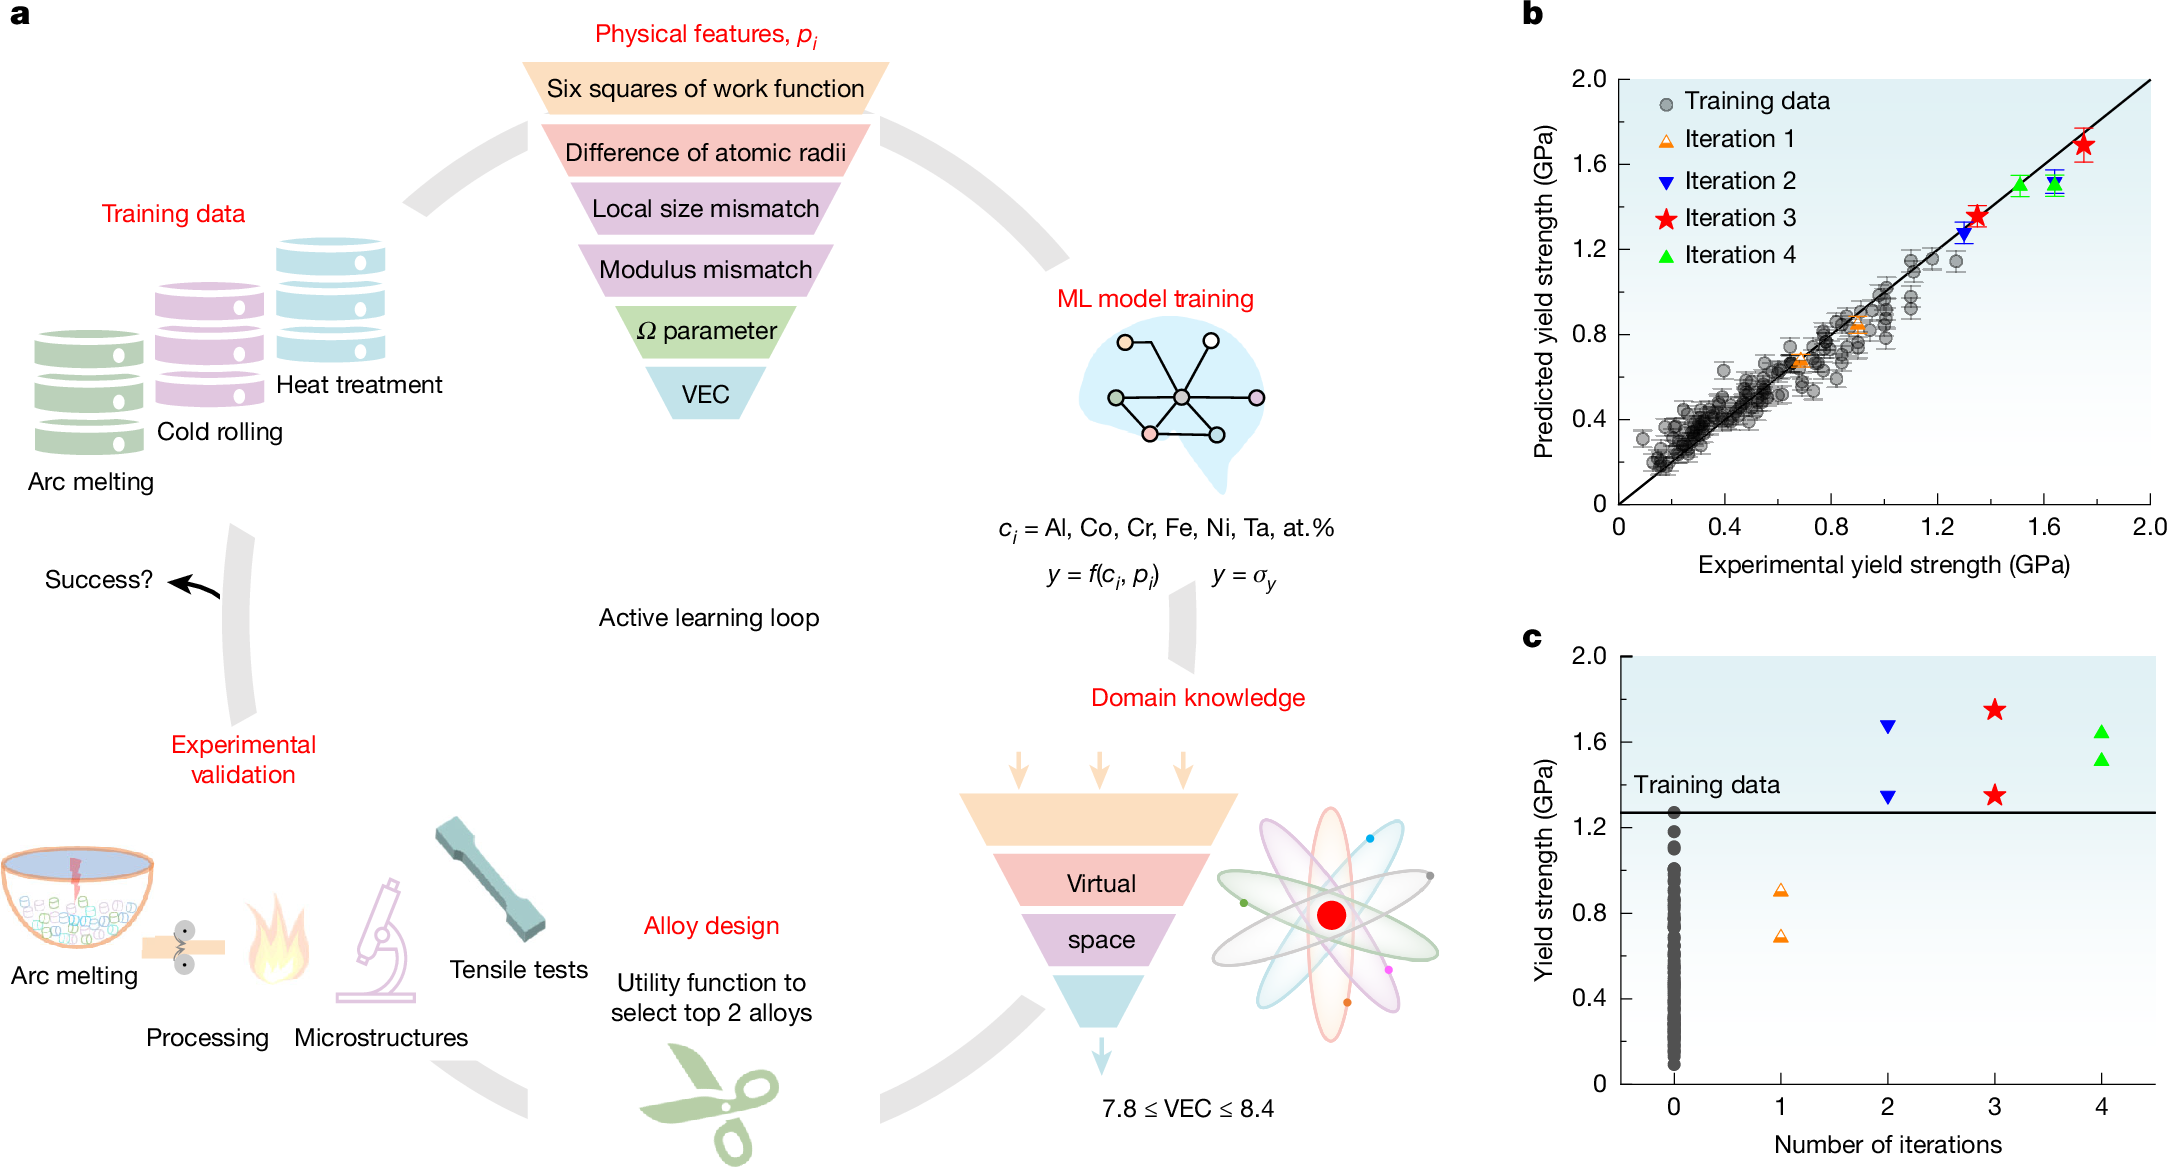
- 研究者定元素范围和价电子数 7.8-8.4 的窗口,20 个指标留 6 个;随机森林每轮推荐两个成分。
- 交互对象
- 物理世界:研究者熔炼、轧制、时效并拉伸每个候选,工艺也由研究者设定。
- 结果
- 从 140 条已有数据出发,四轮制备 8 个新成分,第三轮得到 HEA05,即 Fe₃₅Ni₂₉Co₂₁Al₁₂Ta₃。
2.40 ± 0.05 GPa抗拉强度
> 2 GPa加工硬化率,保持在大应变范围内
2025 年 6 月,西安交通大学团队在 Nature 上报道了多主元合金 Fe₃₅Ni₂₉Co₂₁Al₁₂Ta₃,论文称之为 HEA05。研究者实际熔炼、轧制并热处理了这种合金,随后做了室温拉伸和多尺度显微组织表征。[S1]
经 750 °C、1 小时的代表性时效处理后,HEA05 的屈服强度达到 1,750 ± 50 MPa,抗拉强度 2,403 ± 46 MPa,均匀延伸率仍有 25 ± 1.5%。断裂前真应力接近 3 GPa,加工硬化率在很大的应变范围内都高于 2 GPa。[S1]
块体金属强度接近 2 GPa 时,通常很难再保有大的均匀塑性。一些超高强钢的名义延伸率里含有 Lüders 带或 Portevin–Le Châtelier 带造成的局部变形;传统沉淀强化的高熵、中熵合金,屈服强度又大多低于约 1.2 GPa。HEA05 的应力-应变曲线则很平滑,同一成分只改加工条件,就能在 1.5 GPa / 31% 到 1.95 GPa / 15% 之间调节强塑性组合。[S1]
66.6% + 15%
L1₂ 与 B2 的体积分数[S1]
1.5 / 31% → 1.95 / 15%
同一成分经不同工艺实现的强度(GPa)/ 均匀延伸范围[S1]
02改变了什么
流程更新空间极大,每个真实候选都要熔炼、加工、表征和力学测试。
物理描述符和相结构约束直接写进搜索,主动学习挑出下一轮最值得做的两个成分。
模型并不是从整张周期表里凭空造出合金
论文估计,多组元合金的潜在组合约有 10⁴⁹ 种;这是泛泛的潜在组合数,不是模型实际搜索的空间。团队没有把这片空间直接丢给黑箱模型,而是先凭材料知识选定 FeNiCo FCC 基体,再加入 Al 和 Ta,目标是获得固溶强化、高体积分数的共格 L1₂ 纳米沉淀,以及数量受控、仍能变形的 B2 相。[S1]
主动学习的起点是 140 个 AlCoCrFeNiTa 体系 FCC 高熵合金的文献数据。研究者把各元素限定在给定范围内(如 Al 5–13 at.%、Ta 1–3 at.%),从 20 个候选物理特征中保留 6 个,并用 7.8 ≤ VEC ≤ 8.4 筛选虚拟成分;每轮之后还会调整主元素和成分范围。随机森林代理模型每轮推荐两个候选,一个纯取预测最高,一个兼顾不确定性;研究者实际熔炼、冷轧、再结晶、时效并拉伸后,再把结果放回训练集。四轮共制备并测试 8 个新成分,第一轮两个成分的屈服强度为 900 和 685 MPa,后三轮六个在 1,288–1,750 MPa 之间,HEA05 出自第三轮。重复拉伸、不同热处理和组织表征都是这 8 个成分之外另做的实验。[S1][S2]
补充材料还记下了此前一次没成功的尝试:在含 Ti 的 AlCoCrFeNiTi 体系(200 条文献数据)上迭代四轮,没有得到超过训练数据的合金。研究者判断 Ti 对 L1₂ 的强化不如 Ta,把 Ti 换成 Ta 重新训练,模型才把他们引向高 Al 成分,并在第三轮达到强度目标。换哪种元素,是人做的决定。[S1]
这条边界很重要。模型主要用来搜索化学成分,目标侧重屈服强度;它没有直接预测出“1.75 GPa + 25%”,也没有自主给出最终的三相组织。轧制、再结晶和时效仍由研究者设计。更准确的流程是:领域知识缩小空间,模型挑选成分,实验返回数据,最终性能靠微观组织工程实现。[S1]
性能来自 L1₂ + B2 双沉淀组织
代表性 HEA05 以平均晶粒约 7.6 μm 的 FCC 基体为主,内有两类尺寸不同的析出相:约 15 ± 3 nm、体积分数 66.6 ± 2.3% 的共格 L1₂ 纳米沉淀,以及约 350 ± 70 nm、体积分数 15 ± 2% 的非共格 B2 沉淀。[S1]
作者估算,L1₂ 对屈服强度的贡献约 859 MPa,B2 约 351 MPa,其余来自晶格摩擦、预存位错和晶界。高体积分数的 L1₂ 是最主要的强化来源;Ta 提高了 L1₂ 的反相畴界能,位错要切过有序沉淀就得付出更多能量。[S1]
B2 的表现则不同寻常。传统 NiAl 型 B2 很硬,也往往很脆;HEA05 中的多组元 B2 化学有序能较低,Ta 等元素使其反相畴界能比二元 NiAl 低约 30%。因此位错能够进入 B2,并在拉伸中继续增殖、储存。B2 既抬高了屈服强度,也参与后续的加工硬化。[S1]
真正值得看的是 25% 均匀延伸
拉伸时要持续均匀变形,加工硬化就必须抵消截面缩小带来的失稳。HEA05 从 1.75 GPa 屈服一路硬化到 2.40 GPa 抗拉强度,相差约 650 MPa,屈强比仅约 0.73;加工硬化曲线上没有明显的应力锯齿或骤降。[S1]
B2 中的几何必要位错密度从变形前的约 0.8 × 10¹⁴ m⁻² 升至 20% 应变时的 6.8 × 10¹⁴ m⁻²,甚至高于同一应变下 FCC/L1₂ 区域的约 5.4 × 10¹⁴ m⁻²。各相之间变形不协调,还会带来异质变形诱导(HDI)硬化。这种合金不只是屈服时强,进入塑性阶段后仍在不断储存位错。[S1]
03为什么重要
实验昂贵的领域里,模型该用来做什么?
- 多生成候选,还是挑好下一个实验?每轮只做两个新成分时,挑选才值钱。
- 评价小数据方法,看达到目标要做多少次实验,而不是看拟合好坏。
这是一项小数据 AI4S 工作。140 个样本对现代机器学习来说很少,但在材料科学里,完整的成分-工艺-组织-性能标签本来就昂贵。团队没有拿更复杂的模型掩盖数据不足,而是让 VEC、原子尺寸错配、相稳定性和沉淀强化等知识直接参与缩减搜索空间。[S1]
模型可以很快生成大量候选,实验室每轮却只能熔炼、测试两个,这时多生成成分已经不是最紧的约束。主动学习在这里更像是分配实验预算的机制:挑出最可能提升性能的候选,或者即便失败也最能降低模型不确定性的候选。
HEA05 还算不上自动驾驶实验室,熔炼、加工、表征和判断大多仍靠人。但它已经接上了闭环中关键的一段:模型提出成分,物理实验返回结果,下一轮据此调整。在这里,experiments-to-discovery、time-to-verification 和单次实验带来的信息量,可能比单看 R² 或 RMSE 更重要。
04证据状态与边界
证据等级 4 / 5 · 在物理世界里被检验 · 闭环实验证据状态
已证实
- 六种表征手段:从 X 射线衍射到原子尺度成像
- 直接测量了变形过程中的位错密度
- 此前含 Ti 体系四轮没超过训练数据,人把 Ti 换成 Ta 后才达标
边界
有迹象
- B2 第二相参与加工硬化(据位错测量推断)
- 屈服强度的来源分解(强化模型估算)
未知
- 与随机搜索或其他选点策略的对比
- 能否推广到其他合金体系
- 高温稳定性、疲劳、断裂、腐蚀、规模化、3 at.% Ta 的成本
主张强度高且仍有延展性,但同一成分里两者此消彼长。
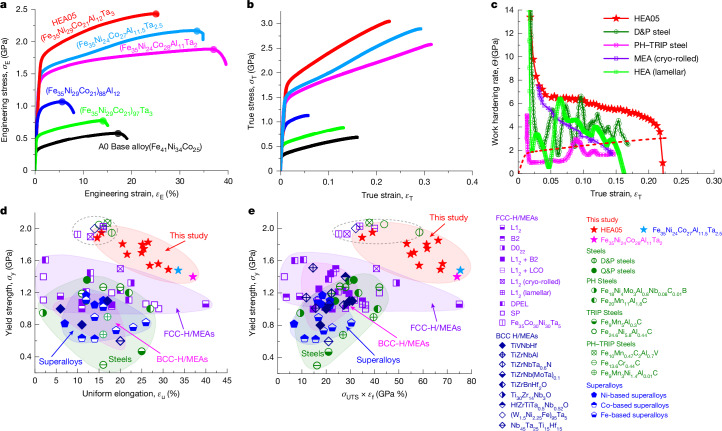
读法d 图:HEA05 各工艺状态从 1.5 GPa / 31% 到 1.95 GPa / 15%,位于文献合金之外。
这不是只靠计算指标撑起来的“AI 设计材料”。
HEA05 经过实际制备和重复室温拉伸(每个状态至少三个试样;论文没有说明 ± 是标准差还是其他离散度),组织用 XRD、TEM、SEM、EBSD、TKD、APT 和同步辐射散射等方法做了表征。1.75 GPa 和 25% 是实测数据,不是模型输出;训练数据和代码也已公开。[S1][S2]
“机器学习设计”应作狭义理解。
模型没有直接优化 1.75 GPa 和 25% 这两个目标,也没有端到端预测三相组织。元素体系、物理特征和 VEC 约束由专家选定,最终组织则取决于后续加工。这是机器学习辅助的合金设计(ML-assisted alloy design),不是完全自主的发现。[S1]
离工程材料还远,验证只走到早期阶段。
论文验证了室温强塑性和变形机制,但没有提供长期高温稳定性、疲劳寿命、断裂韧性、耐腐蚀、规模化加工和工业认证方面的数据。HEA05 还含 3 at.% Ta;如何降低成本、在大尺寸产品中稳定复现同样的析出结构,仍是未解决的问题。[S1]
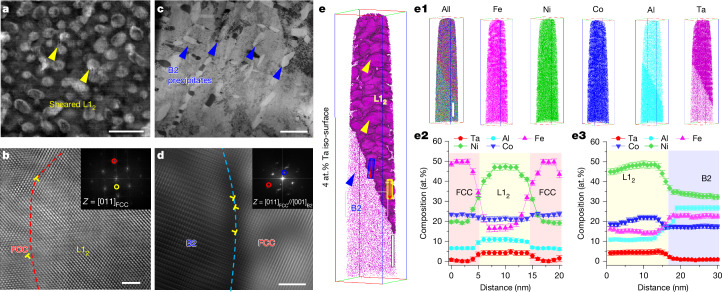
论文 Fig. 2:FCC 基体中的共格 L1₂ 纳米沉淀、非共格 B2 微米沉淀及其成分分布。Sohail et al., Nature (2025), CC BY-NC-ND 4.0;原图未修改。 [S1]
05我从中学到什么
- 可迁移的洞见
- 找到成分和解释成分是两回事:前者靠主动学习,后者靠表征和实验。
- 设计启发
- 把领域约束(这里是价电子数窗口)直接写进搜索空间,而不是事后过滤。
- 阅读启发
- 看到“AI 发现新材料”,先分清哪几步是模型做的:这里的加工全由人决定。
- 接下来看
- 同一套流程换到另一个合金体系,或让成分和工艺一起优化时,能否复现。
领域知识可以直接成为搜索算法的一部分
材料知识界定元素体系、物理特征和相结构约束,机器学习在剩下的空间里挑选下一次昂贵的实验。对小数据科学来说,这种分工比把领域知识和模型对立起来更现实。
主动学习分配的是稀缺的物理标签
模型推理很便宜,熔炼、热处理、表征和拉伸却很贵。主动学习回答的是一个具体问题:这一轮只能做两个实验,下一步最值得向自然提出的问题是什么?
找到成分和解释性能,是两件不同的事
主动学习找到了 HEA05 的成分,但要靠后续实验才说清 L1₂ 怎样强化、B2 为什么没有简单地让材料变脆,以及 B2 如何在变形后期储存位错。在 AI4S 中,预测和科学理解仍需各自拿出证据。
硬的第二相,不一定只是位错的障碍
通过多组元合金化降低 B2 的有序能,通常被看作又硬又脆的金属间化合物相也能参与变形、储存位错并维持加工硬化。这个材料学细节,比“AI 找到破纪录合金”更值得记住。
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。