

研究基础设施与实验自动化· 科学证据 · Frontier
Anthropic 开放 MHS 研究预览:给 AI 智能体一个统一的实验室硬件接口
Anthropic 的 MHS 想为 AI4S 闭环搭一层共享的 Interact:不同 agent 都用同一个接口去发现、控制、协调真实仪器,再把设备状态、测量结果和错误送回上层系统。目前只是研究预览,只向首批合作方开放,规范和驱动尚未公开。
◐官方研究预览 + 真实设备前瞻性演示
当前边界:真实设备上已经跑出多仪器编排、参数调整、自动重试和控制优化,但还证明不了完整的自主科学发现;标准仍是研究预览,结果也主要出自 Anthropic 和首批合作伙伴公布的案例
这项工作推进的是:让 AI agent 通过统一接口操作并协调真实仪器
- MODEL理解 / 预测
- DECIDE选择下一步
- INTERACT测试现实
- UPDATE改变下一轮
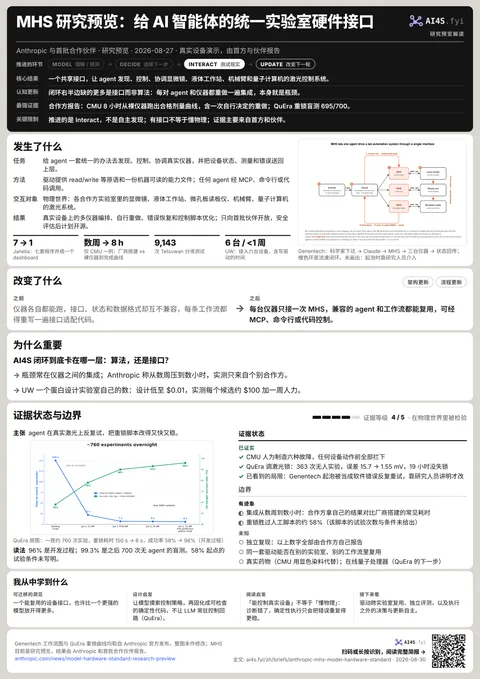
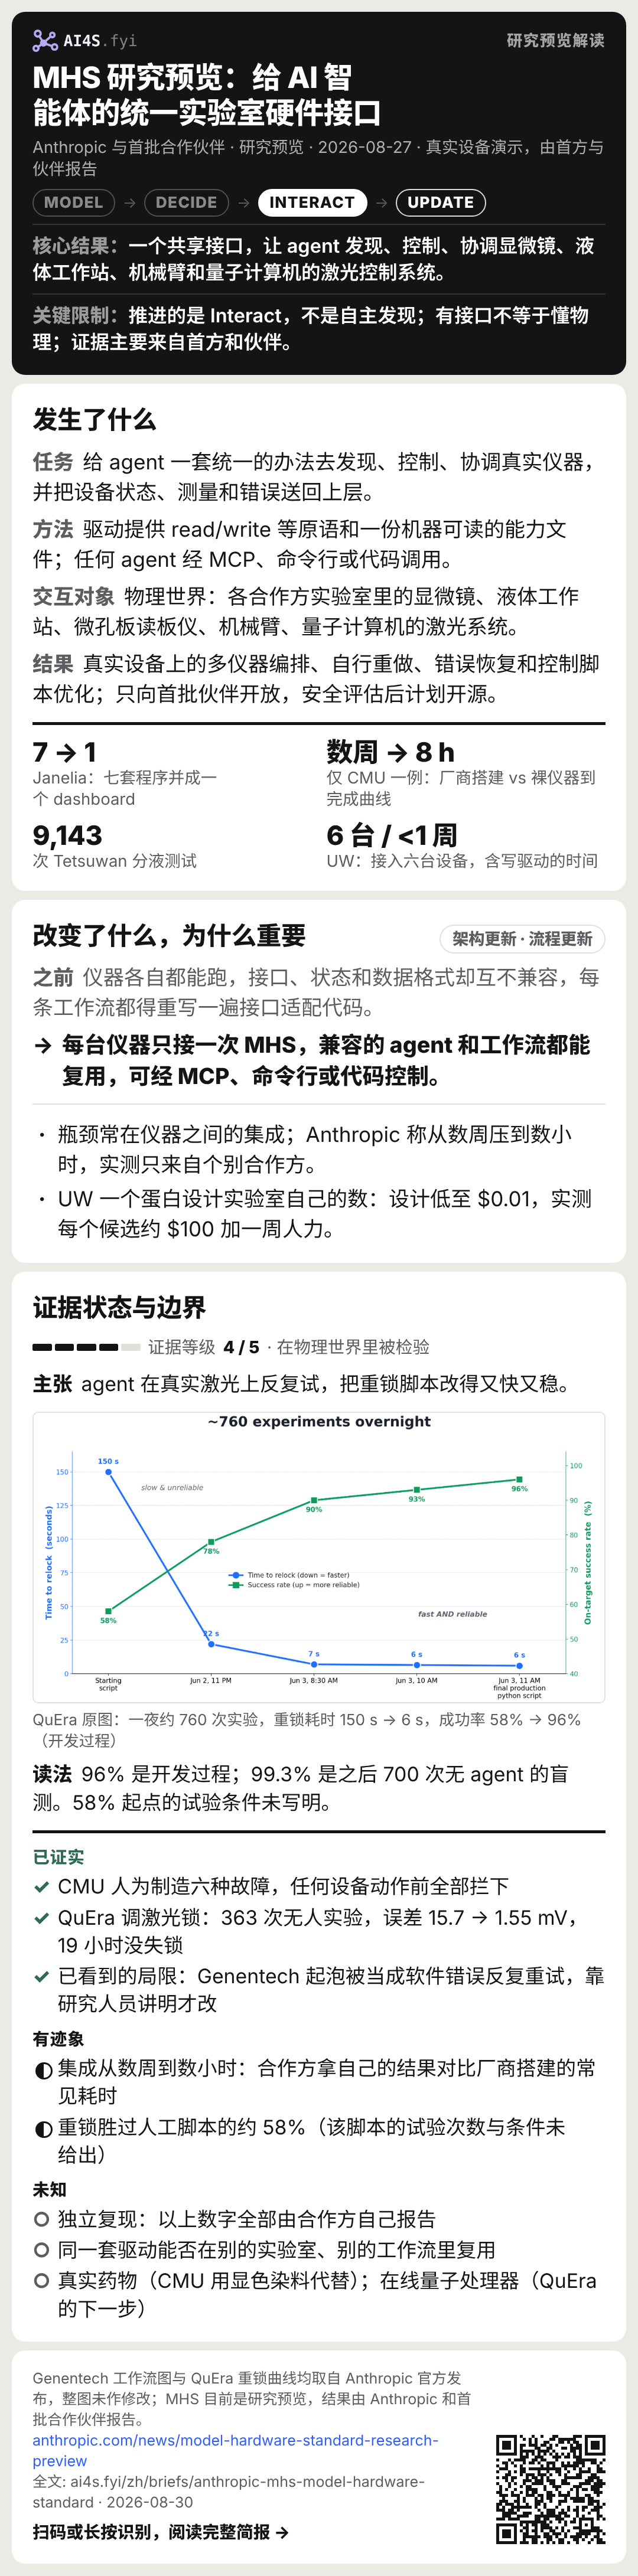
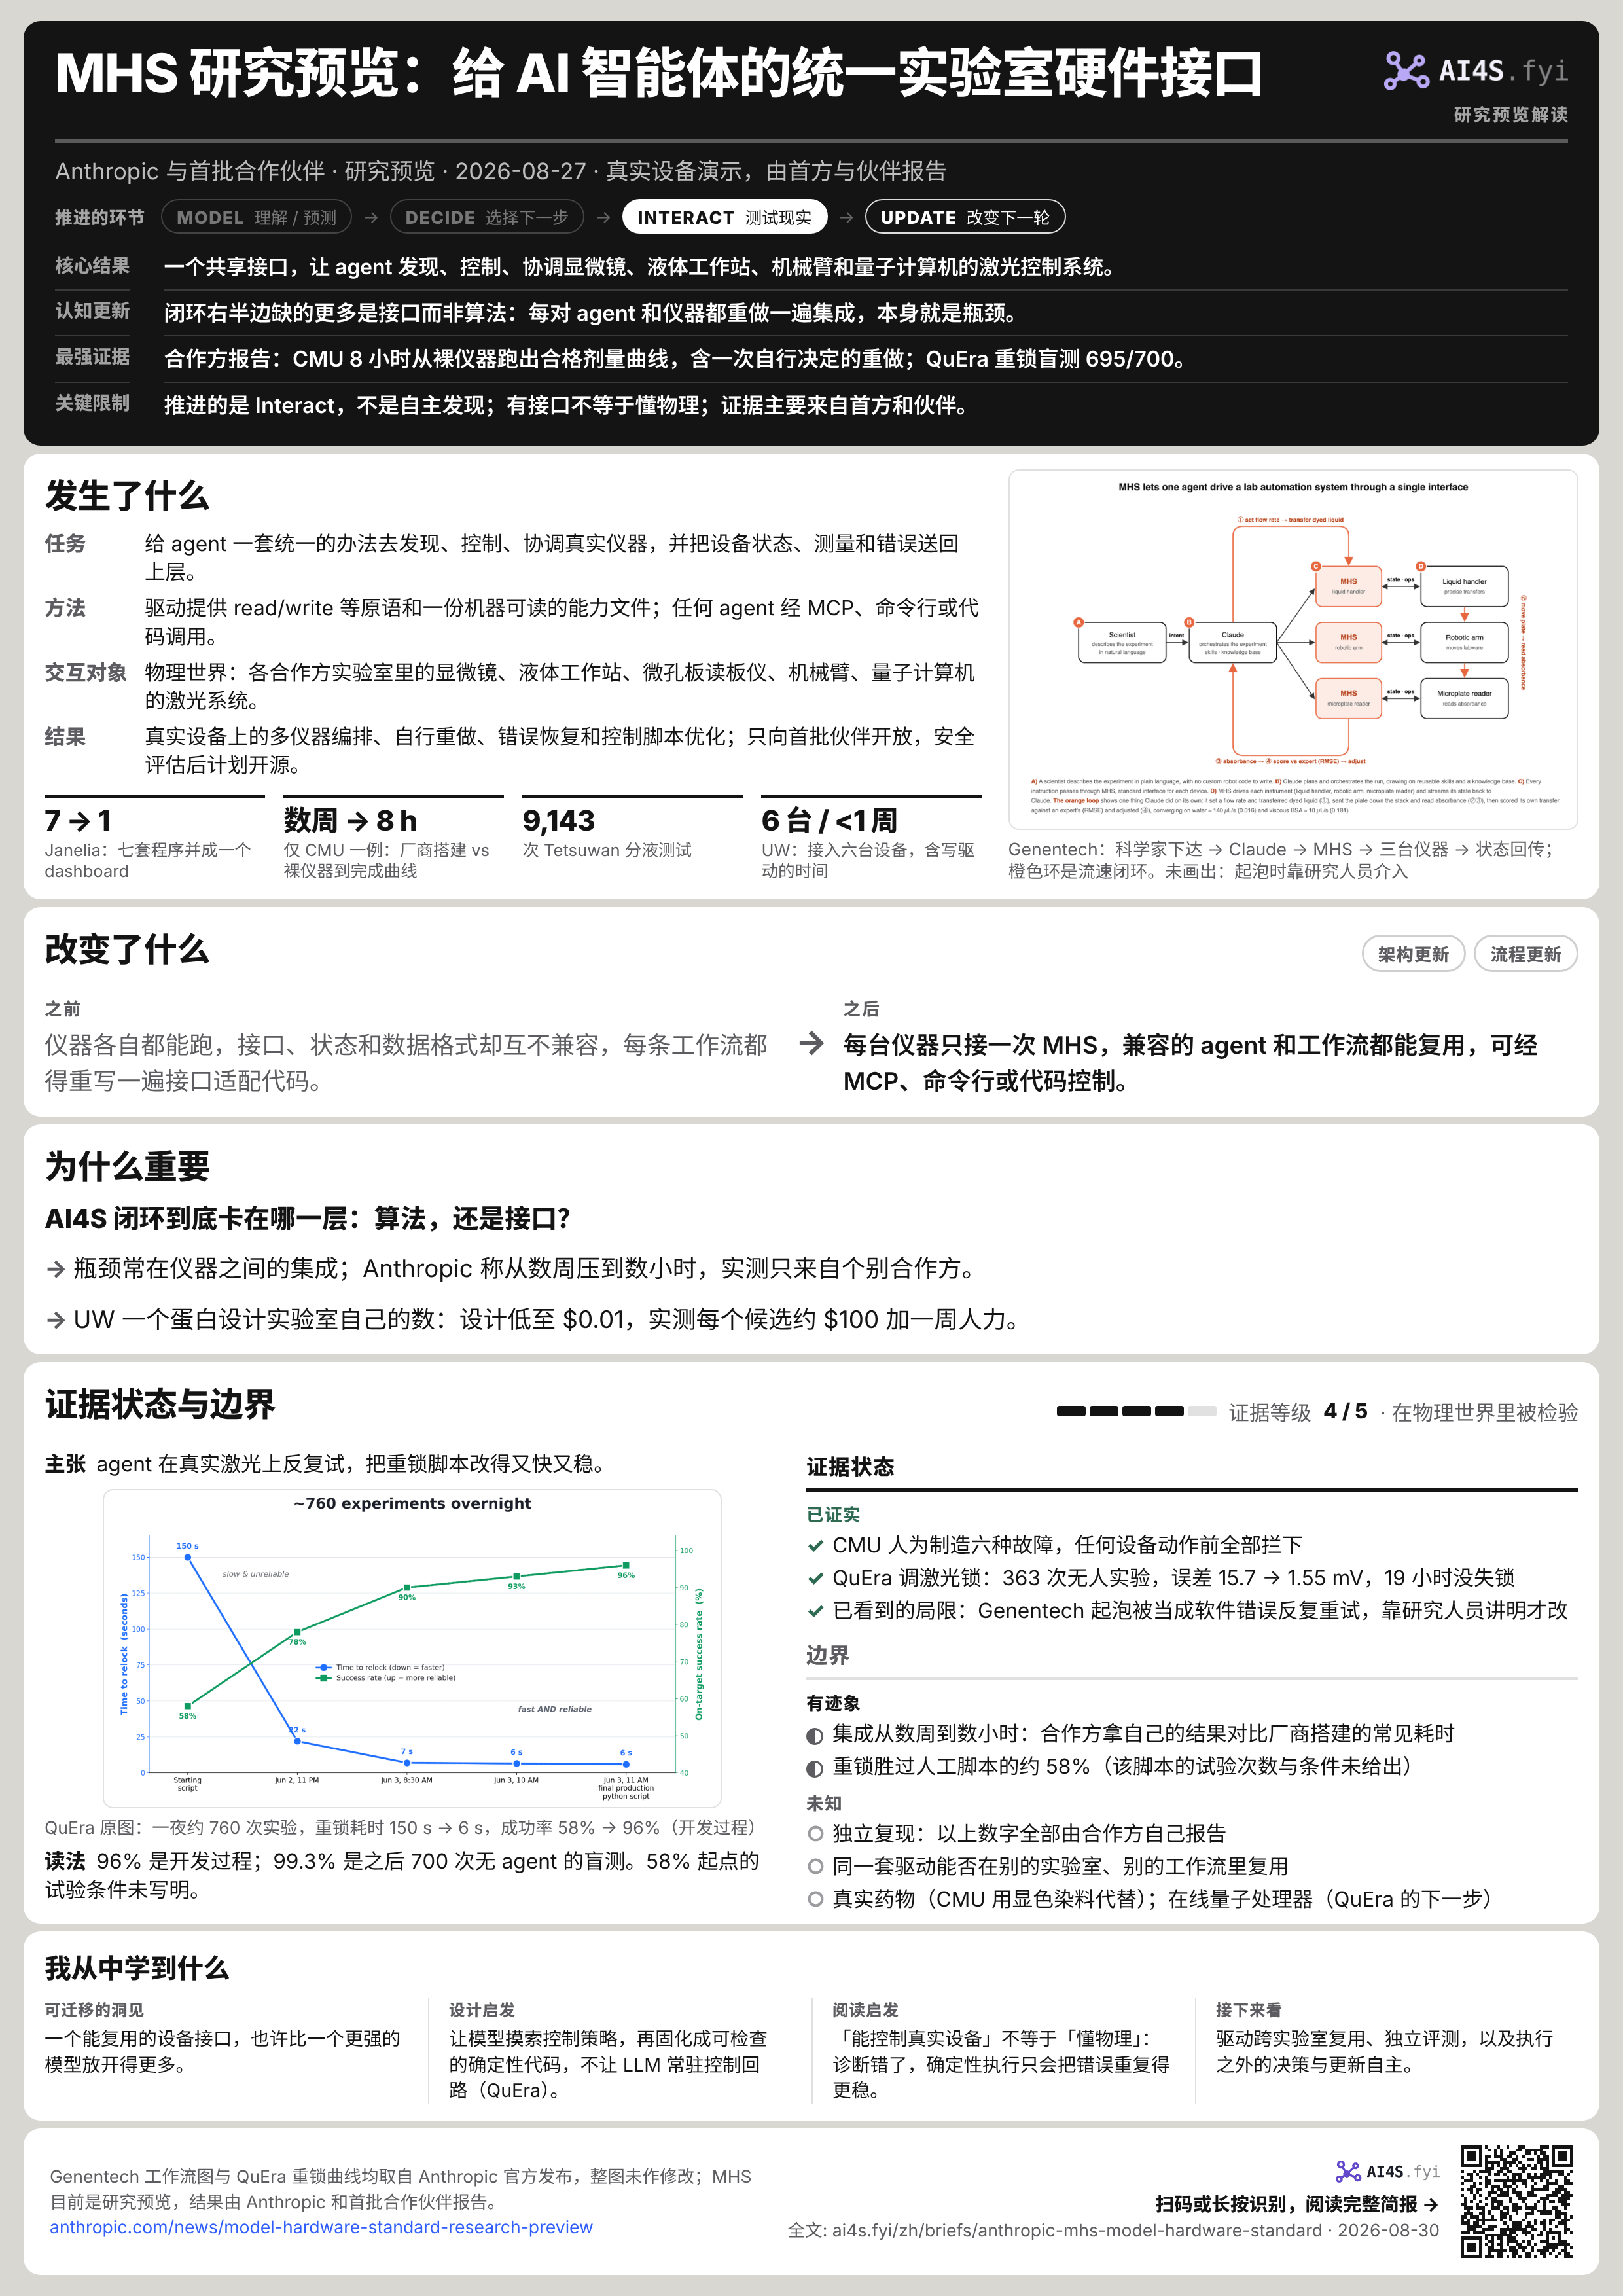
一个共享接口,让 agent 发现、控制、协调显微镜、液体工作站、机械臂和量子计算机的激光控制系统。
- 认知更新
- 闭环右半边缺的更多是接口而非算法:每对 agent 和仪器都重做一遍集成,本身就是瓶颈。
- 最强证据
- 合作方报告:CMU 8 小时从裸仪器跑出合格剂量曲线,含一次自行决定的重做;QuEra 重锁盲测 695/700。
- 关键限制
- 推进的是 Interact,不是自主发现;有接口不等于懂物理;证据主要来自首方和伙伴。
01发生了什么
- 任务
- 给 agent 一套统一的办法去发现、控制、协调真实仪器,并把设备状态、测量和错误送回上层。
- 方法
- 驱动提供 read/write 等原语和一份机器可读的能力文件;任何 agent 经 MCP、命令行或代码调用。
- 交互对象
- 物理世界:各合作方实验室里的显微镜、液体工作站、微孔板读板仪、机械臂、量子计算机的激光系统。
- 结果
- 真实设备上的多仪器编排、自行重做、错误恢复和控制脚本优化;只向首批伙伴开放,安全评估后计划开源。
7 → 1Janelia:七套程序并成一个 dashboard
数周 → 8 h仅 CMU 一例:厂商搭建 vs 裸仪器到完成曲线
9,143次 Tetsuwan 分液测试
6 台 / <1 周UW:接入六台设备,含写驱动的时间
2026 年 8 月 27 日,Anthropic 向首批科研实验室和先进制造企业开放 MHS(Model Hardware Standard,模型硬件标准)的研究预览。这是一套让 AI agent 操作物理设备的共享规范,首批案例覆盖显微镜、液体工作站、微孔板读板仪、机械臂,以及量子计算机里的激光控制系统。规范、驱动和代码目前都没有公开发布。[S1]
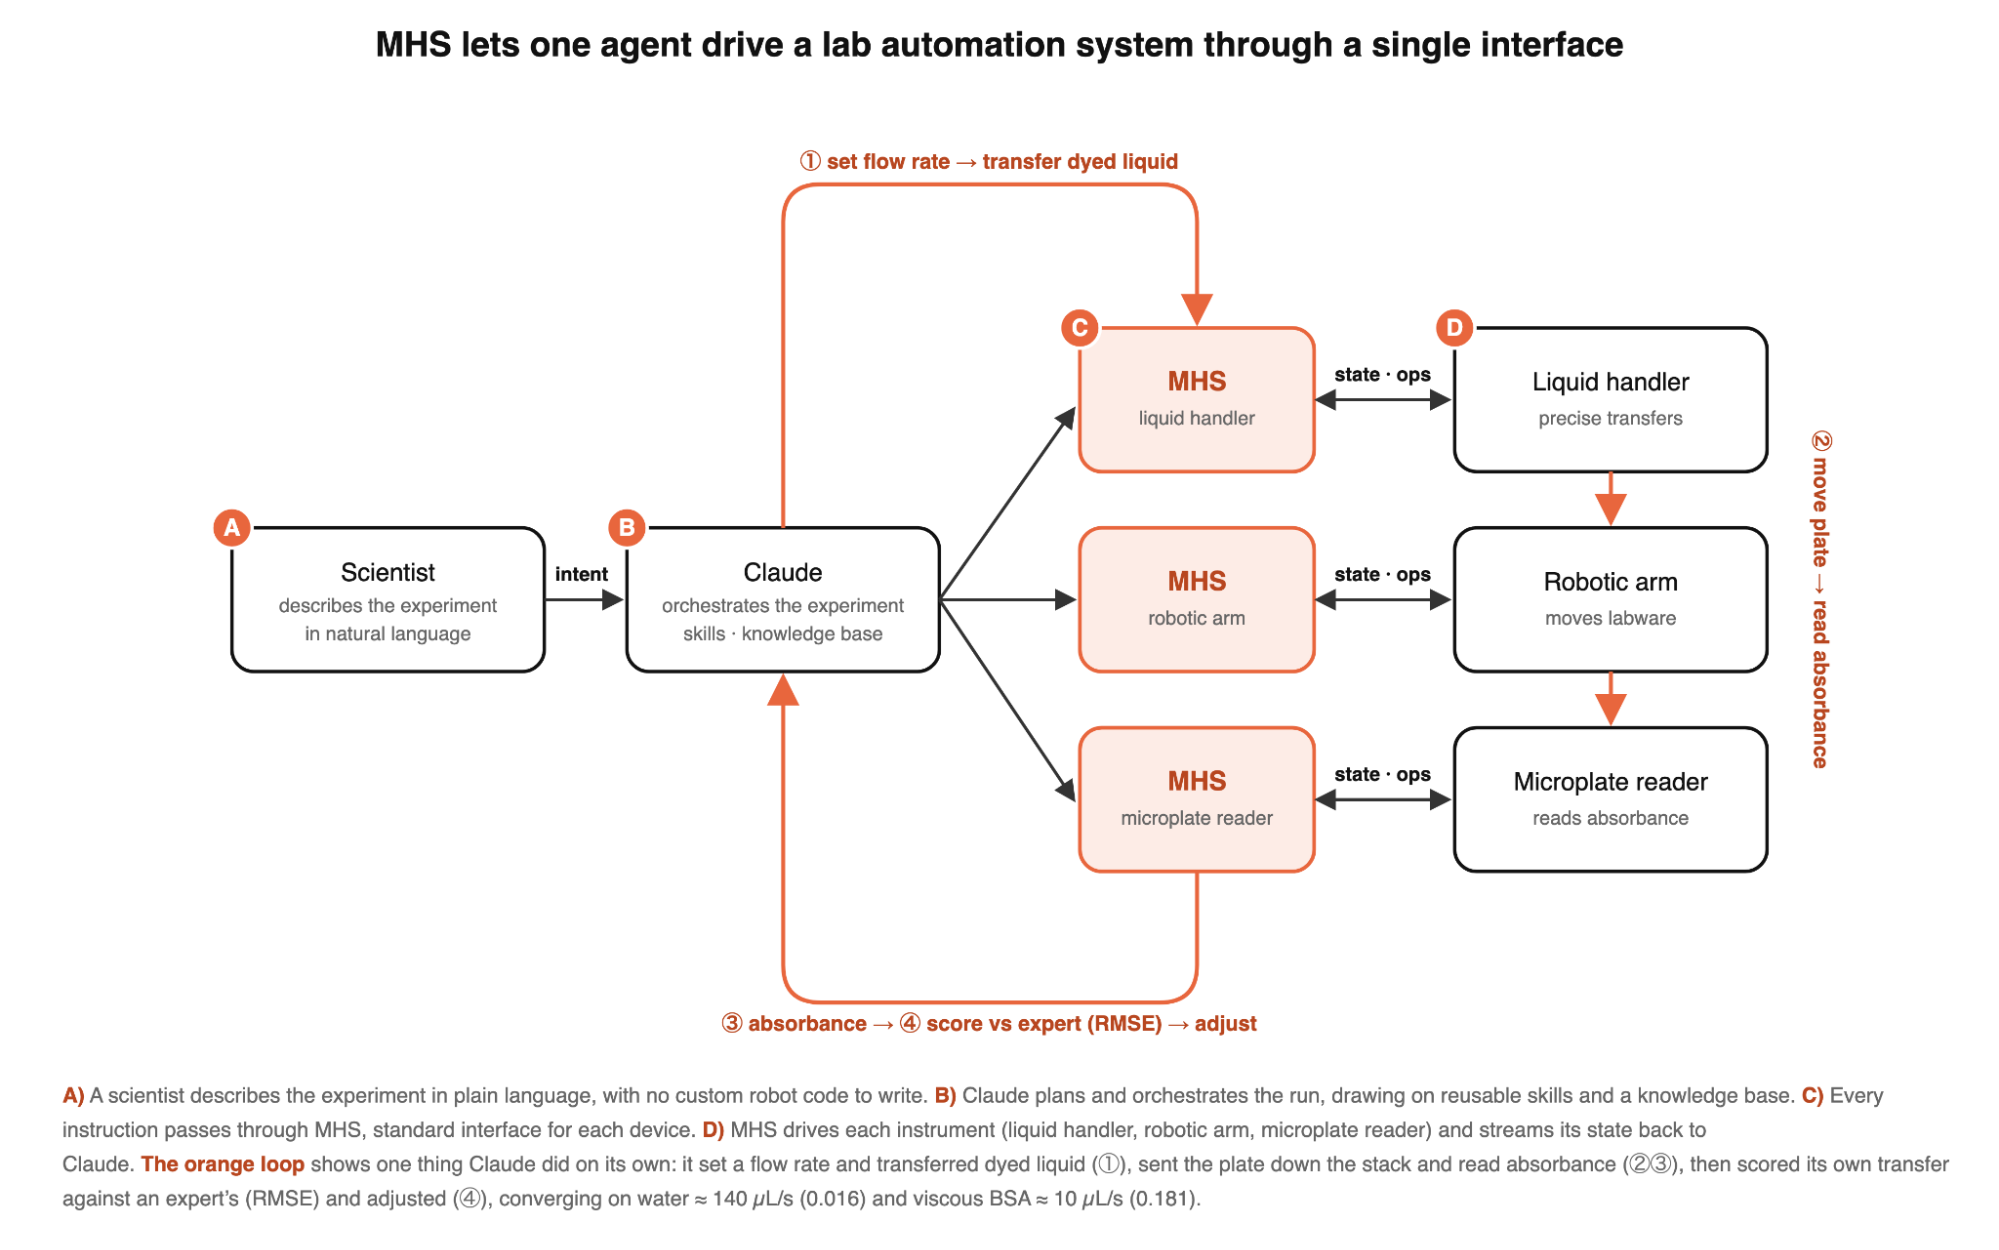
MHS 的基本路径是:scientific agent → MHS interface → device driver → instrument / robot,设备状态、测量结果和错误再沿原路返回。每台设备通过驱动提供相对统一的 read、write 等操作,并生成一份机器可读的 reference file,说明它能测什么、哪些参数可调、当前状态如何、安全限制在哪。[S1]
可以把它看成 MCP 往物理世界延伸了一步:MCP 让模型用相对统一的方式发现和调用软件工具,MHS 把同样的接口思路搬到实验仪器和机器人上。类比也就到此为止:物理设备还得处理实时状态、运动边界、硬件故障和安全联锁。[S1]
Agent 可以用 MCP、命令行或代码来调设备。遇到要低延迟或长时间运行的任务,它可以把摸索出来的操作顺序写成确定性代码交给设备执行,不必让语言模型在每一个时间步都在线推理。[S1]
MHS 不挑模型,也不要求用 Claude;理论上任何兼容该协议的 agent harness 都能接进来。目前它只向首批实验室和制造伙伴开放,Anthropic 计划补完物理安全评估和部署规范之后再开源。[S1]
02改变了什么
架构更新流程更新仪器各自都能跑,接口、状态和数据格式却互不兼容,每条工作流都得重写一遍接口适配代码。
每台仪器只接一次 MHS,兼容的 agent 和工作流都能复用,可经 MCP、命令行或代码控制。
科学闭环里,MHS 推进的是哪一步
它主要推进 Interact 这一段:上层系统定下要做什么之后,MHS 负责把这个决定变成跨仪器的操作,读取状态,再把测量和运行错误送回去。它没有给出新的科学模型,也不提假设、不挑哪个实验最值得做。[S1]
有些案例已经在限定的目标和参数空间里跑出「执行-测量-调整-重做」的小闭环。但要持续地做科学学习,还得有外部模型解释结果、决策模块挑下一个实验、更新模块改动模型或策略,再配上支撑长期运行的安全与异常处理机制。[S1]
更准确的说法是:MHS 压低了 Interact 到 Update 之间的集成成本,让自主闭环更好搭,但这不等于自主科学发现已经做成。
有了统一接口,为什么还要写驱动
把 MHS 说成实验室硬件的 USB,有帮助,但不准确。它不会让驱动消失,也没法让纯手动的仪器凭空变成可编程的。设备还是得有 API、SDK、CLI、COM、文件投递系统或者能被自动操作的 GUI,底层差异仍要靠驱动包起来。[S1]
MHS 统一的是 agent 发现和调用设备的方式,不是把所有设备的内部实现变成一个样子。它把设备能力、实时状态、操作方法和安全限制,翻译成上层系统能发现的接口。
从一次性的接口适配代码到能复用的设备接口
许多仪器本来就能用软件控制,真正麻烦的是厂商软件、编程语言、数据格式和状态表示各不相同。每加一台设备,往往要重写接口适配代码(glue code)、处理协议、同步状态,还要定义出错时怎么停、怎么恢复。Anthropic 和合作伙伴说,这样一次集成通常要数周甚至数月。[S1]
MHS 想把「每个 agent 配每台仪器都做一次性集成」改成「每台仪器接一次,多个兼容的 agent 和工作流都能用」。它首先推进的是互操作性,不是更强的科学推理。
模型负责摸索,代码负责执行
MHS 还演示了一种适合物理系统的分工:模型先摸索设备、看反馈、改控制策略,再把管用的策略写成可检查、可测试的确定性代码。QuEra 的激光案例就是这么做的,最终脚本跑起来不需要 agent 一直在线。[S1]
语言模型负责开放式的摸索和改进,确定性代码负责速度、稳定性和可审计的执行。这比让 LLM 长期蹲在毫秒级控制回路里现实得多。
但这套分工解决的是执行效率和可审计性,补不上对物理的理解。模型能把有效操作固化成代码;可要是它把失败原因判断错了,确定性执行只会把错误重复得更稳。后面的 Genentech 案例正好暴露了这条边界。[S1]
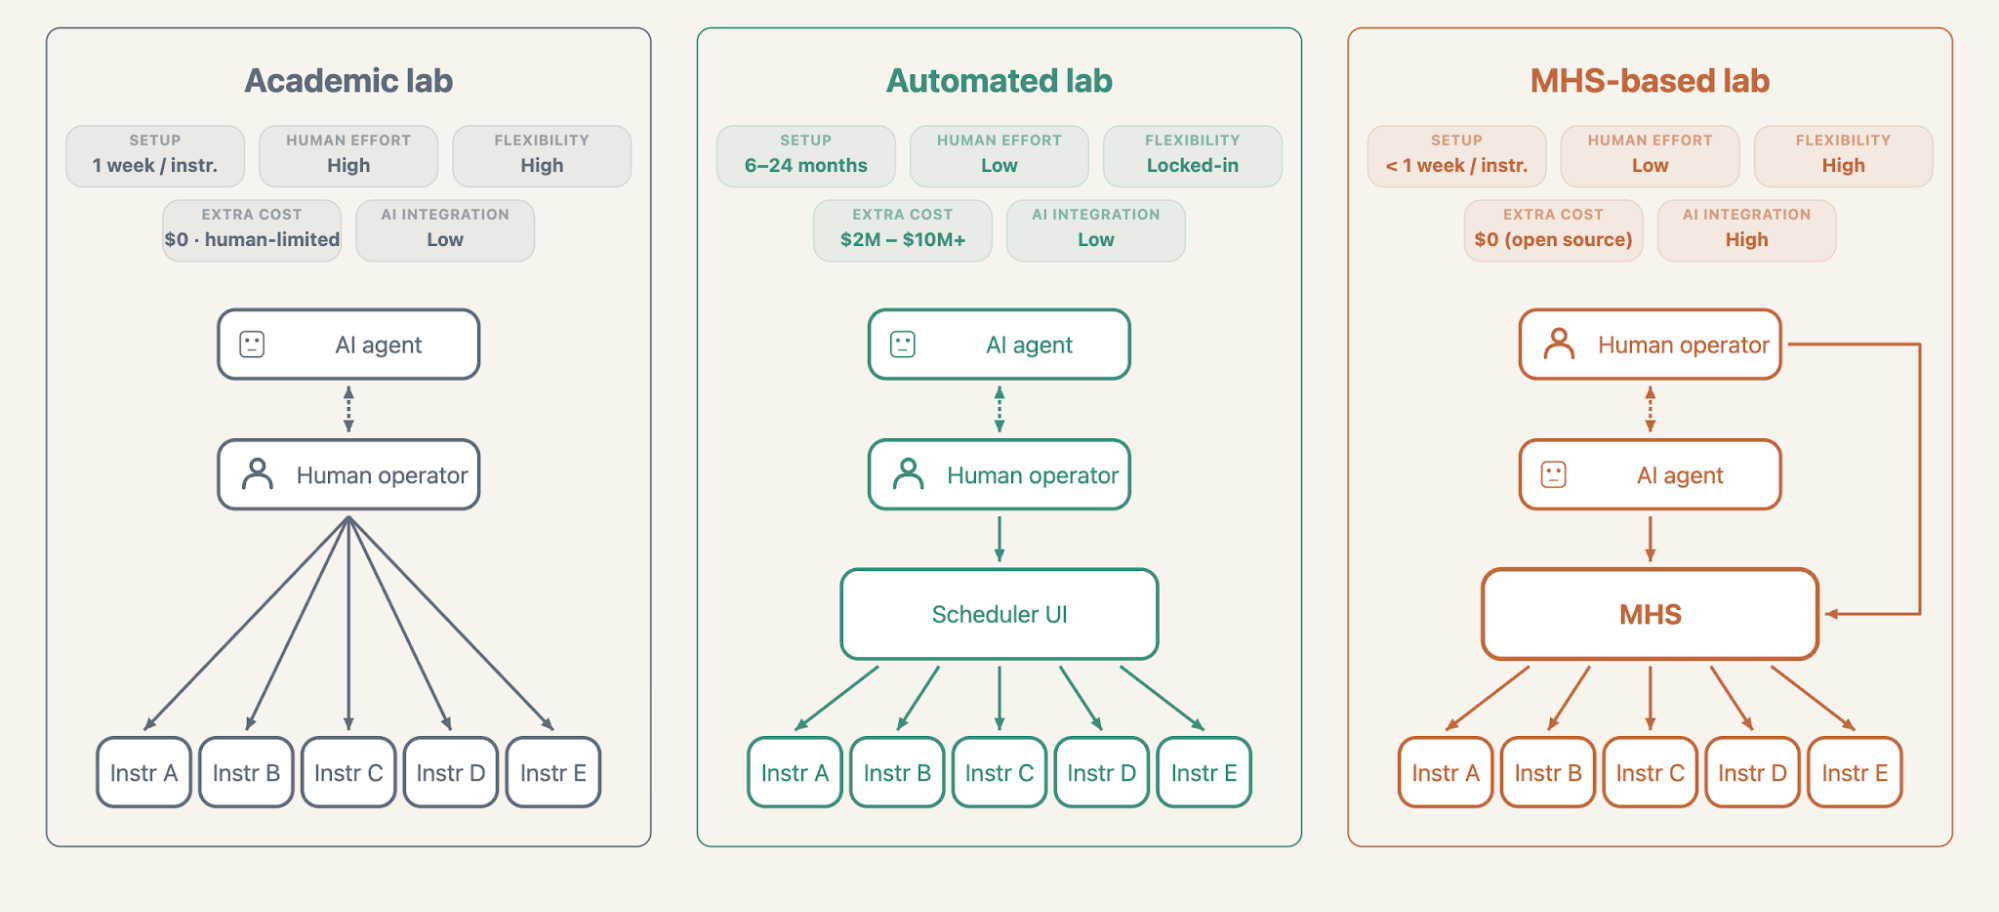
Anthropic / UW Baker 与 Pinglay 实验室 Fig. 1:MHS 把分散的仪器接到统一的调度与监控层上,同时保留研究实验需要的灵活性。图片取自 Anthropic 官方发布。 [S1]
03为什么重要
AI4S 闭环到底卡在哪一层:算法,还是接口?
- 瓶颈常在仪器之间的集成;Anthropic 称从数周压到数小时,实测只来自个别合作方。
- UW 一个蛋白设计实验室自己的数:设计低至 $0.01,实测每个候选约 $100 加一周人力。
真正的瓶颈往往不是单台仪器不能编程,而是几台仪器之间没法共享状态、理清依赖、串成同一条研究流程。要是研究人员还得在各家厂商软件之间手工搬结果,再好的实验计划也很难源源不断地变成新的物理证据。[S1]
传统自动化工作站擅长把固定 protocol 重复跑上千上万遍。研究性实验却常换样本、换设备组合、换条件,下一步还要看刚拿到的结果。MHS 想做的是在确定性的设备和不断变动的研究目标之间放一个可复用的接口,而不是拿 agent 去取代已经成熟的设备控制。
UW Baker / Pinglay 实验室的一笔账把瓶颈说得更具体(这是该实验室博士生在发布里给的 de novo 蛋白设计数字,不是通用成本):设计一个像 PETase 这样的蛋白低至 0.01 美元,一个候选上实验台测一次却要约 100 美元加一周人力,而他们一次要测 1,000 个候选。团队用不到一周接入六台设备(含写驱动的时间),要缩的正是计算候选和实体反馈之间越拉越大的时间与成本差。[S1]
在 design–build–test–learn 这条循环里,MHS 目前覆盖的主要是 Build 和 Test,外加设备协调与数据交接。Design 仍来自科学模型或研究人员,Learn 仍要靠外部模型解释结果、更新策略、决定下一轮。[S1]
Tetsuwan 的案例展示的是更大规模的设备表征:系统跑完 9,143 次分液测试,训练出的精度模型在留出条件下比厂商规格高 12%。可见统一接口不只是往外发指令,也能把真实运行数据送回校准和控制流程。[S1]
发布时宣布支持、试点或集成计划的伙伴包括 AWS(Strands Robots)、Automata(LINQ)、Danaher、Doosan Robotics、MBF Bioscience(ScanImage)、QIAGEN(QIAsymphony Connect)、Tecan(Fluent)、Universal Robots、Hugging Face(LeRobot)和 Raspberry Pi。这说明供给侧愿意围着这个标准试一试接口;但这和「同一套驱动已经能跨实验室、跨项目安全复用」是两回事,后者要真实部署来证明。[S1]
04证据状态与边界
证据等级 4 / 5 · 在物理世界里被检验 · 闭环实验证据状态
已证实
- CMU 人为制造六种故障,任何设备动作前全部拦下
- QuEra 调激光锁:363 次无人实验,误差 15.7 → 1.55 mV,19 小时没失锁
- 已看到的局限:Genentech 起泡被当成软件错误反复重试,靠研究人员讲明才改
边界
有迹象
- 集成从数周到数小时:合作方拿自己的结果对比厂商搭建的常见耗时
- 重锁胜过人工脚本的约 58%(该脚本的试验次数与条件未给出)
未知
- 独立复现:以上数字全部由合作方自己报告
- 同一套驱动能否在别的实验室、别的工作流里复用
- 真实药物(CMU 用显色染料代替);在线量子处理器(QuEra 的下一步)
主张agent 在真实激光上反复试,把重锁脚本改得又快又稳。
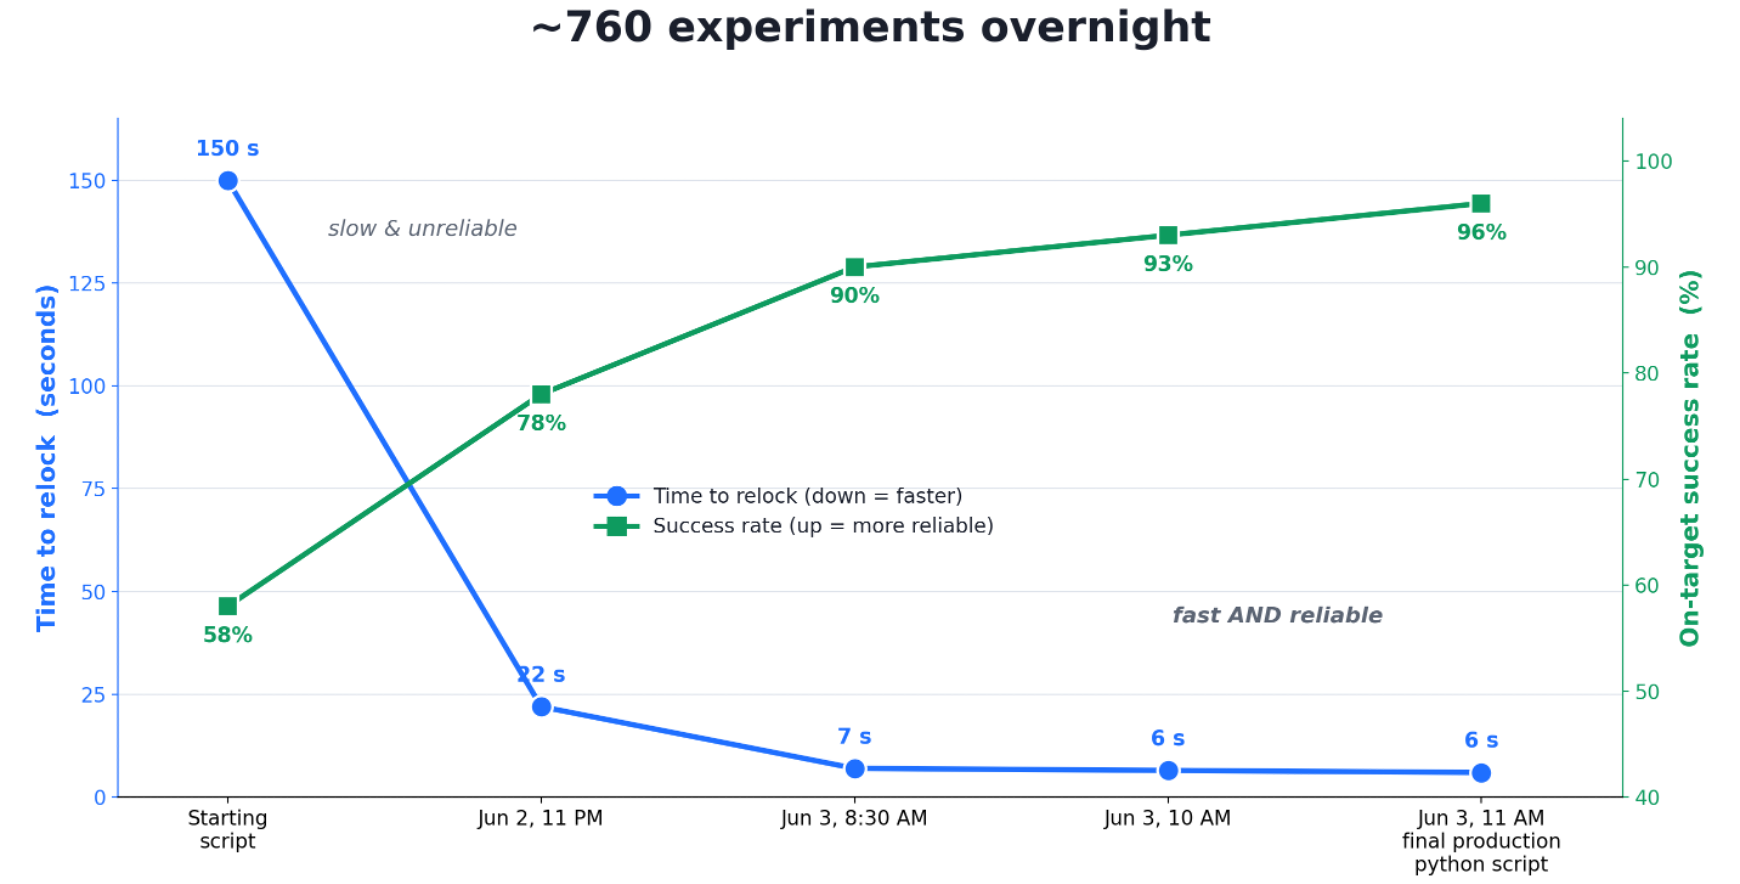
读法96% 是开发过程;99.3% 是之后 700 次无 agent 的盲测。58% 起点的试验条件未写明。
这些不是纯软件仿真。
MHS 已经用在液体工作站、机械臂、微孔板读板仪、显微镜、激光器和量子设备上。CMU 和 QuEra 都包含前瞻性的真实设备运行,证据强于一般的产品演示,也强于只在仿真里跑通的 agent workflow。[S1]
结果仍主要由首方和合作伙伴自己报告。
现有结果都写在 Anthropic 的官方发布里,既不是统一基准下的独立评测,也不是同行评审研究。本页把 CMU 的故障拦截、QuEra 的 700 次盲测与 363 次调参实验,统一当作“合作方报告的实测结果”:它们是在真实设备上测出来的,但都没有外部复现。各家的设备、任务、安全边界和成功指标都不一样,单个案例的数字不能直接搬到别的实验室;「数周到数小时」也是个别合作方拿自己的结果对比厂商搭建的常见耗时,不是适用于所有仪器的降幅。[S1]
CMU 展示的是有边界的闭环执行。
所谓“自行重做”,重做的是整次剂量曲线实验:第一轮最高浓度 200 µg/mL,高浓度段信号饱和,拟合 R² < 0.9,系统判定不合格,自己决定弃掉这块板,把最高浓度降到 100 µg/mL,在新板上重跑;第二轮 R² > 0.98,全程没有人工输入。从未自动化的仪器到完成曲线(含这次重做)共 8 小时,团队对比的是厂商交付自动化方案通常要的数周:这是 CMU 这一例,不是所有仪器接入的通用降幅。这已经越过单纯的自动执行。团队还人为制造了六种故障:孔板缺失、孔板放反、读板机占用、相机断连、设备不可达、急停触发,系统都在机械臂动作之前拦了下来。但实验用的是显色染料而非真实药物,证明的是操作、安全和决策结构,不是自主药物发现。[S1]
UW 展示的是又快又省的实验室集成。
Baker / Pinglay 实验室不到一周就接通了六台分散的设备,这个时间还包含写驱动,并把 dashboard、qPCR 停止建议和多设备流程串到了一起。这有力地说明了集成能有多快、需求有多真,但同一套驱动还没有在别的实验室、别的蛋白工作流里重现过。[S1]
QuEra 展示的是把设备控制调得更好。
Agent 用几百次真实实验把控制策略改好,再用盲测和长时间运行来验证脚本:重锁脚本在 700 次盲测里成功 695 次(99.3%),盲测用的是同一组随机诱发的扰动,没有 agent 参与。此前一个四人团队花了几个月写的人工脚本约为 58%、每次约 150 秒,这也是一夜开发(约 760 次实验,结束时 96%)的起点;发布没有写明这个 58% 基于多少次试验、是否同一组扰动,所以两者不是严格同条件的对比。随后它在 363 次实验、16 小时无人值守中调了 12 个 PID 参数,把专家原有参数 15.7 mV 的残余误差降到 1.55 mV(按它优化的 RMS 指标约降到十分之一);在相位噪声分析仪上,除了约 220 kHz 处的共振,全频段与专家盲调的结果相当;19 小时的运行里它的参数一次也没失锁,专家参数则约每小时失锁 1.6 次。这项任务的目标、状态和成功标准都是现成的,它并没有提出新的量子物理假设。QuEra 的下一步是把重锁系统部署到在线的量子处理器上,这一步还没发生。[S1]
有物理接口,不等于懂物理。
Genentech 的起泡案例里,Claude 一开始把物理问题当成软件错误,在同一个孔里换参数反复重试,气泡反而更多,直到研究人员讲明原因,它才换到干净孔位、减少混合。这是已经观察到的局限,不是尚待确认的问题。接口能告诉你能做什么、设备报了什么,却不会替你解释物理上为什么失败。[S1]
执行上能自主,不等于科学上能自主。
目标、候选空间、成功指标和异常边界,通常还是人来定。MHS 支持相当程度的自动执行和局部参数更新,但科学模型怎么更新、下一轮往哪走,仍要靠外部系统和专家。
纯手动的旧设备还是得改造。
MHS 要求设备留有一个能被软件操作的入口。那些靠手动旋钮、人工上样,或者状态读不出数字信号的设备,仍然需要厂商驱动、加装传感器、上机器人,或者直接改硬件。
05我从中学到什么
- 可迁移的洞见
- 一个能复用的设备接口,也许比一个更强的模型放开得更多。
- 设计启发
- 让模型摸索控制策略,再固化成可检查的确定性代码,不让 LLM 常驻控制回路(QuEra)。
- 阅读启发
- 「能控制真实设备」不等于「懂物理」:诊断错了,确定性执行只会把错误重复得更稳。
- 接下来看
- 驱动跨实验室复用、独立评测,以及执行之外的决策与更新自主。
Interact 这一层一直被低估
模型写出实验计划,不等于实验就能做起来。计划得变成设备指令,设备状态得看得见,测量结果还要以能用的格式回来。MHS 把这一层单独拎出来,当成一个可以标准化的基础设施问题。
瓶颈不只在设备能不能编程
很多设备早就能用软件控制,问题在于它们之间不能共享状态、不能灵活组合。对研究性实验来说,把设备之间、agent 与设备之间的集成成本降下来,也许比再添一台单点自动化设备更要紧。
执行上能自主,不等于决策上能自主
Agent 可以几乎不用人插手就把仪器跑起来,但实验目标、候选空间、成功标准和风险边界通常还是人定的。看到「无人值守运行」,仍要接着问:是谁决定要跑什么,结果又怎样改变了下一步。
模型摸索、代码执行,也许更现实
QuEra 的做法兼顾了两头:模型那边的开放式摸索,和物理控制要求的速度、稳定性与可检查性。模型不必一直待在控制回路里,关键在于它能不能拿出一套更好、又能部署的控制策略。
自动重做还算不上科学上的 Update
调参数可以合成一个控制闭环,但科学闭环还得判断结果意味着什么,并让新证据去改动模型、假设或下一轮实验的选择。MHS 打通的是回传通道,真正的学习仍在上层系统那边。
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。