

论文笔记· 科学证据 · Frontier
AI 已经能快速设计上万种蛋白,实验室怎么跟上?
David Baker 团队这次没有再做一个更强的蛋白质生成模型,而是转向 AI4S 里一个更实在的瓶颈:模型产出候选的速度,早已超过实验室验证它们的速度。
●同行评审论文 + 公开研究材料
当前边界:目前仍是 IPD 内部的一套筛选流程,尚无复杂蛋白、跨实验室复现和自动选择下一轮实验的验证
这项工作推进的是:让蛋白候选更快进入实体生产与标准化测量
- MODEL理解 / 预测
- DECIDE选择下一步
- INTERACT测试现实
- UPDATE改变下一轮
48 hSAPP 一轮生产加标准化表征(DMX 另加约 5 天,DNA 制备不计入)
~6 h这一轮里研究人员在台前的时间
SAPP 把数百个设计的表达、纯化和标准化表征压进一批约 48 小时的流程。
- 认知更新
- 蛋白质设计的瓶颈,已经从生成候选移到把候选做出来、测出来。
- 最强证据
- 三样并看:IPD 已做并表征数万个设计、929 组装 89.3% 达标、cb13 冷冻电镜与设计差 1.9 Å(一个原子宽)。
- 关键限制
- 48 小时只是 SAPP 一轮,DMX 另加约 5 天;仍是 IPD 内部的筛选流程,不是完整闭环。
01发生了什么
- 任务
- 让设计之后的生产和测试,在数百到数千的规模上跟上生成式蛋白质设计。
- 方法
- SAPP:用 ccdB 筛选的 Golden Gate 取代挑克隆,每个样品都按分子大小过柱,再由机器人归一。DMX:把便宜的寡核苷酸池铺成身份明确的克隆。
- 交互对象
- 物理世界:大肠杆菌表达培养物、纯化的蛋白、色谱图,以及活的 RSV 病毒。
- 结果
- 每批返回一块装着纯化蛋白的 96 孔板,外加一份覆盖全部设计的标准化数据文件。
< 5 minSEC 每个样品所需时间
~300 / day单台色谱仪的样品吞吐,也是新的硬件上限
~2 h192 个反应,从线性 DNA 到接种好的表达培养物
2026 年 8 月 20 日,David Baker 团队在 Nature Communications 发表《Accelerating protein design by scaling experimental characterization》。工作主要出自华盛顿大学生物化学系和 Institute for Protein Design,活 RSV 中和实验由卡罗林斯卡学院的合作者完成。论文介绍了 SAPP 和 DMX 这两套相互衔接的实验流程。[S1]
这篇论文要解决的问题
RFdiffusion、ProteinMPNN 几天就能给出上万条候选,传统湿实验却往往要几周才能表达、纯化并测完几十条。设计越快,等着接受现实检验的队列就排得越长。一条在计算机里看着不错的序列,未必能高效表达,也可能溶不下去、结团,或者长不成预期的寡聚状态。[S1]
这些问题终究要回到实验室。大规模的混合池检测(pooled assay)虽然能一次筛很多序列,读出的常常只有结合力、稳定性等少数性质,也说不清每个蛋白单独拿出来是否好做、好纯化、状态是否正确。[S1]
Baker 团队这次没有再造一个更强的设计模型,而是重做了设计之后的生产和测试环节。论文称,SAPP 和 DMX 已经在 IPD 内部用于生产、表征数万种从头设计的蛋白质。它们要让物理世界更快回答一个问题:这些候选里,哪些真做得出来?[S1]
SAPP 把蛋白实验改成成批地做
老流程卡在哪一步
DNA 组装完成后,常规流程还要转化、涂板、挑单菌落、培养、提质粒、测序确认,再把正确的质粒转进表达菌株。这一段要花好几天,挑克隆又很难大规模并行。[S1]
工程上的取舍
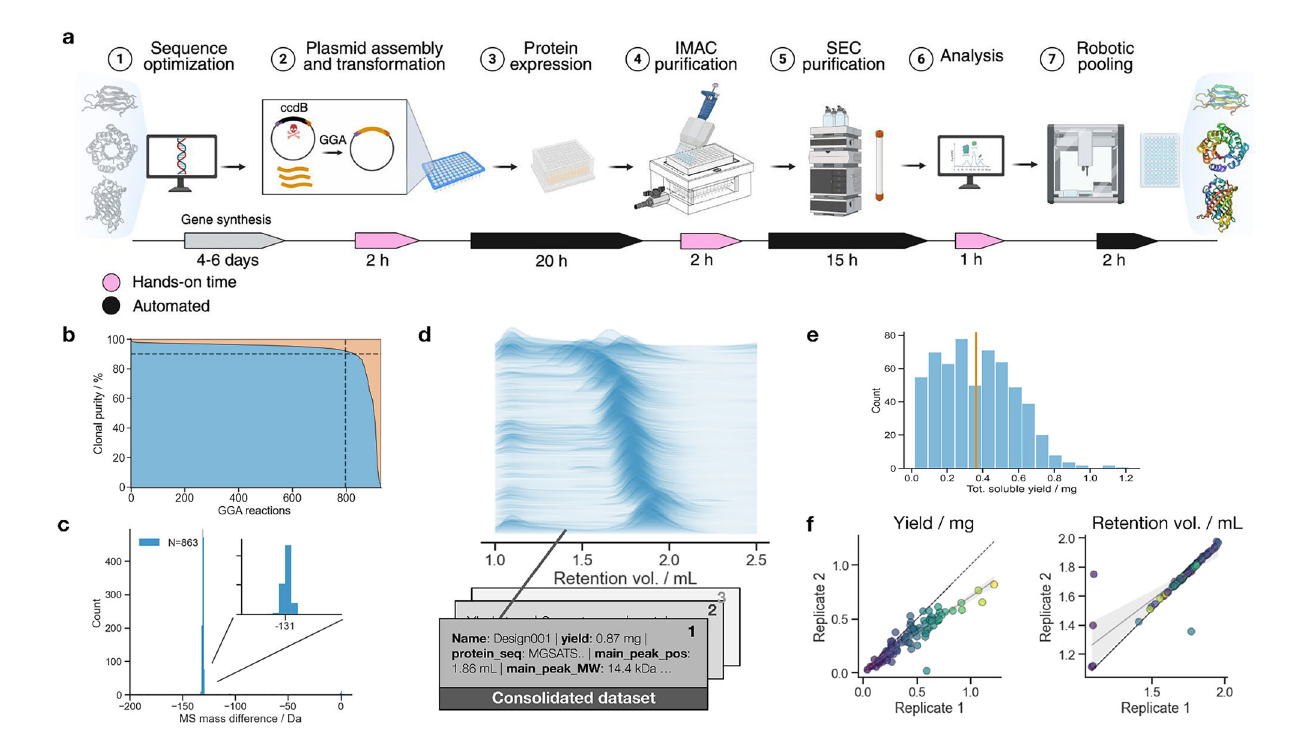
SAPP 采用 Golden Gate 组装,并在受体载体里放了致死基因 ccdB。目标片段插对了就会顶掉 ccdB,没插进去的空载体则被强烈抑制。组装产物因此可以直接进入大肠杆菌表达菌株:192 个反应从线性 DNA 到接种好的表达培养物,大约只要两小时。[S1][S4]
这条捷径靠得住吗
这条捷径并没有消除 DNA 合成和克隆的错误。作者回查 929 个组装反应,其中 89.3% 的主克隆纯度超过 90%;对 863 个纯化蛋白做质谱,约 90% 的分子量落在预期值 ±1 Da 以内。目标构建体通常在混合池里占主导,足以用来筛选,代价是偶尔漏掉真阳性。筛选和最终确认被拆成两步:第一轮容许少量漏检,选出值得继续的蛋白后,再做严格的单克隆和序列确认。[S1]
每个样品都过 SEC,实验就成了数据生产线
传统的 96 孔筛选往往先跑 SDS-PAGE,看哪些蛋白“表达出来了”,再挑少数几个放大培养。但表达出来,离“这是个好蛋白”还很远。SAPP 让每个样品先做亲和纯化,再直接进入体积排阻色谱(SEC)。色谱不只是纯化:每张色谱图还能读出可溶产量、样品是否分散、估算分子量、是否聚集以及寡聚状态。192 个样品过夜约 15 小时跑完,平均每个不到五分钟。[S1]
一套 Python 程序批量分析色谱图,并自动生成液体处理机器人的操作指令,完成组分合并和浓度归一化。产出不只是一块装着纯化蛋白的 96 孔板,还有一份包含全部结果的标准化数据文件。整条 SAPP 流程约 48 小时,研究人员真正站在实验台前的时间约六小时。于是每个设计都以同一格式返回一组可比较、也可直接交给程序处理的实测数据。[S1][S3]
02改变了什么
流程更新瓶颈更新设计几天出上万个候选,湿实验几周才逐个验证几十个。
每个设计都走同一套批处理流程,返回可比、机器可读的数据;下一个瓶颈变成 DNA 成本。
这是全文最清楚的一条系统性观察:瓶颈会移动,不会消失。蛋白表达、纯化和初步表征提速之后,大规模测试的主要成本转到了 DNA 合成上。逐条订完整基因片段很方便,可规模一旦上到几百、几千条,DNA 就会吃掉大部分预算。[S1]
寡核苷酸池便宜得多,但所有序列混在一起。DMX 要解决的正是这种格式错位:便宜的 DNA 是混的,后面的实验却要一孔一个、身份明确的构建体。[S1][S2]
DMX:一孔一条序列,还知道是哪一条
DMX 先把 DNA 库克隆进统一载体,再把菌落挑进 384 孔板。各孔的基因在细菌裂解液中接上组合条形码,之后重新混合,用 Nanopore 长读长测序建立条形码与基因序列的对应关系。分析程序输出挑取清单,液体处理机器人再把确认无误的菌落重排到新板上。[S1][S3]
四组各 24 个条形码,理论上可以区分 24⁴ 即 331,776 个孔。在一个含 1,500 条设计的测试库里,团队分析了 4,608 个菌落,找回 78% 的目标变体,接近该采样深度下约 92% 的理论上限。[S1]
论文估算,与逐条订基因片段相比,500 个设计的项目 DNA 成本约为原来的 1/5,2,000 个设计的项目约为 1/8,代价是多出约五天流程。所以一两百条设计直接上 SAPP 更省事;到了千级规模,先用 DMX 压成本再接 SAPP 才划算。[S1][S2]
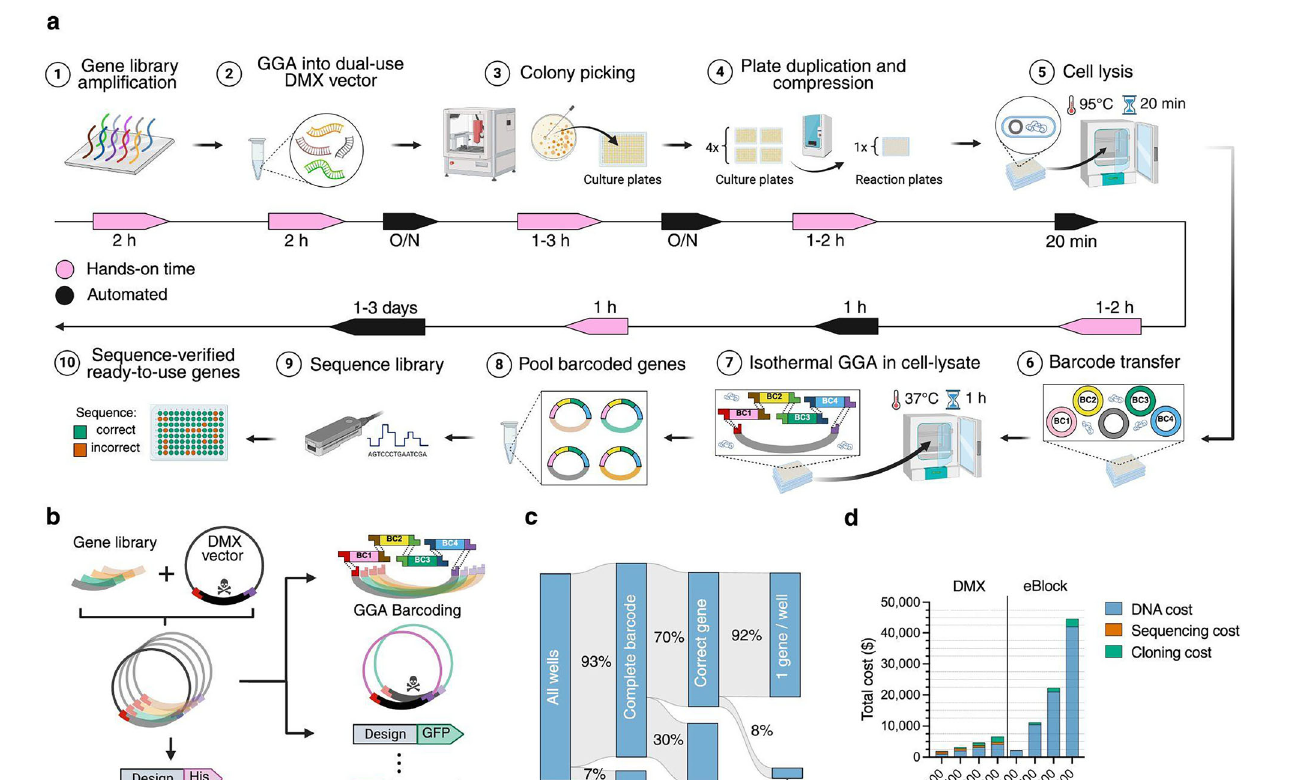
论文 Fig. 4 全图(a–d)。读图重点:顺着 oligo pool → colony picking → combinatorial barcode → Nanopore mapping 一路看下来,就能明白 DMX 如何把混合序列池还原成一孔一个、身份明确的克隆库。Qian et al., Nature Communications (2026),CC BY 4.0。 [S1]
03为什么重要
设计变快之后,实验室该把工程力量投到哪一道瓶颈上?
- 评估一项 AI4S 工作,先问它把设计→生产→测试→学习中的哪一道瓶颈往后推了一步。
- 筛选和确认可以用不同精度:先容忍假阴性换覆盖面,命中之后再严格确认。
04证据状态与边界
证据等级 4 / 5 · 在物理世界里被检验 · 实体验证证据状态
已证实
- IPD 内部已实际做出并表征数万种从头设计的蛋白
- 929 个组装反应中,89.3% 的主克隆纯度超过 90%
- RSV 结合蛋白实际制备,并用活病毒做中和:最好的半数阻断浓度 40 pM,单抗 MPE8 对照 156 pM
- DMX 在 1,500 条设计的库中找回 78% 的目标变体,距约 92% 的理论上限约 14 个百分点
边界
有迹象
- DNA 成本约为基因片段的 1/5 到 1/8(论文估算,非实际账单)
- 跳过单克隆测序会漏掉真阳性,基因越长越明显
未知
- 没有 IPD 那些经验的实验室能否稳定复现
- 复杂蛋白、特殊纯化、其他宿主,以及针对具体功能的检测
主张结合域相同、只换寡聚几何,效力就大幅改变,几何很难事先排序。
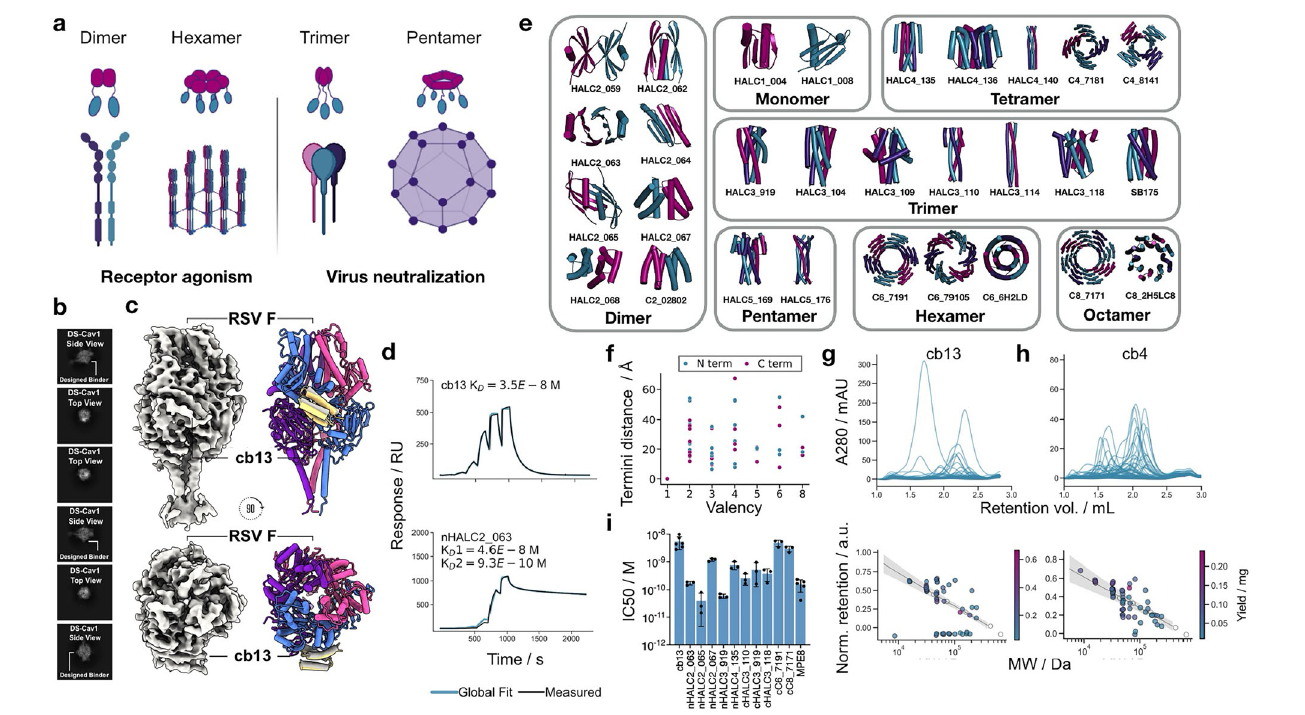
读法i 图:结合域相同的两个二聚体(nHALC2_065 与 067),中和 IC50 相差约 25 倍(40 pM 对 1 nM)。
荧光蛋白的案例先说明 SAPP 能在一周内为 96 个重新设计的构建体返回可比数据。部分变体与野生型的序列一致性只有约 50%–80%,在 95°C 加热一小时后仍保持单体状态和吸收峰;另一些则出现了明显不同的发射光谱。[S1]
更能说明问题的是 RSV。团队先从约 31,000 个针对 RSV F 蛋白 site III 的小型结合蛋白设计中筛出 cb13,亲和力 35 nM;冷冻电镜显示实测复合物与设计模型很接近,结合蛋白主链的 Cα RMSD 为 1.9 Å。随后他们把 cb13 接到 27 种寡聚化骨架上,做出 58 个构建体,再由 SAPP 挑出 19 个表达和组装状态较好的,送去做活病毒中和。[S1][S5]
最好的两个构建体 IC50 达到 40 pM(nHALC2_065)和 59 pM(nHALC3_919),cb13 单体则是 5.4 nM,论文中的单抗 MPE8 对照为 156 pM。更有信息量的是那些失败和分叉:结合域相同的两个二聚体(nHALC2_065 与 nHALC2_067)相差约 25 倍(40 pM 对 1 nM);同一个三聚化骨架,只把结合结构域从 N 端挪到 C 端,效力就差约十倍(59 pM 对 530 pM);C6、C8 这类高价构型也没有自然变强。吞吐量上去以后,研究者不必只验证模型最有把握的几个候选,还能系统比较这些目前很难事先排序的几何结构。[S1]
这是方法论文,不是闭环已经跑通的证明
论文给出了流程、规模数据、案例和公开代码,至于用实验数据反过来改进设计模型、自动挑选下一轮实验,仍是未来的方向。目前能说的是实验基础设施前进了一步,还不能说自主蛋白质发现已经闭环。[S1][S3]
这是筛选,不是最终的金标准验证
跳过单克隆测序会带来假阴性;基因越长,DNA 合成错误造成的多克隆污染越明显。最终命中的蛋白仍需严格的单克隆和序列确认。[S1]
适用范围仍然有限
这套流程主要针对表达量较高的工程蛋白或设计蛋白做了优化。需要复杂表达条件、特殊纯化、其他宿主,或者针对具体应用的功能检测的蛋白,不能直接套用。没有 IPD 那些积累的实验室能否稳定复现,也还有待验证。[S1]
05我从中学到什么
- 可迁移的洞见
- AI4S 的瓶颈会移动,不会消失:设计、验证、DNA 成本、SEC 与功能实验依次浮出水面。
- 设计启发
- 实验室自动化先重做流程:删步骤、统一板格式、把纯化和表征并成一步,然后再上机器人。
- 阅读启发
- 看到“自主蛋白质发现”,先看做到了哪一段:这里生产、测试、数据都有了,自动选下一轮还没有。
- 接下来看
- 标准化数据接回模型之后,下一轮设计的命中率是否真的提高。
AI4S 的瓶颈会移动,不会消失
最值得记住的不是 48 小时,也不是 40 pM,而是一条系统规律:设计变快,湿实验验证就浮出来;SAPP 把验证提速,DNA 成本又浮出来;DMX 压下 DNA 成本,SEC、特定功能实验和更难的表达体系接着冒头。以后看一个 AI4S 模型或公司,可以先问一句:它把设计→生产→测试→学习中的哪一道瓶颈往后推了一步?
筛选和最终验证,不必用同一套精度标准
SAPP 接受少量假阴性,换来更大的候选覆盖面,命中之后再严格确认。筛选和确认用不同精度,是为了不在第一轮就被成本和时间拖垮。
好的实验室自动化,先重做流程再上机器人
SAPP 的数量级提升,主要来自删掉扩展不了的步骤、统一板格式、用自诱导表达减少人工干预,以及把纯化和表征合并。机器人只接手合并组分、浓度归一化这类高度重复的活。实验室自动化不等于到处摆机器人,很多时候流程设计才是第一层杠杆。
吞吐量变了,能问的问题也就变了
在 RSV 的案例里,同一个结合蛋白、同样的价数,只换几何结构就能差 25 倍。一次只能做三五个构建体时,很难系统探索这片空间;一次能做几十上百个,原本只能靠直觉的问题就可以交给实验来回答。
闭环 AI 要的是标准化的实测数据,不只是更快的实验
如果结果还要研究人员逐张看图,各个项目又各用各的格式,实验再快也攒不出可持续使用的数据。SAPP 把每个设计的结果整理成统一结构;只有湿实验能稳定、低成本地交回这类实测数据,设计、生产、测试和学习才接得起来。
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。