

论文与基础设施解读· 科学证据 · Frontier
AlphaGenome Atlas:DeepMind 预先算完 90 亿种单碱基变异,罕见病候选先按影响分数排队
这是 DeepMind 的老打法:先把旗舰模型验证好,再把大规模预测做成可查询的基础设施。但 90 亿条预测省下的是推理和搜索的成本,不等于 90 亿条实验事实。
◆同行评审底层模型 + 官方技术稿 + 定向实验
当前边界:预计算降低的是推理和搜索的门槛;底层模型对缺失细胞类型、远距离调控、环境和临床因果的把握,并不会因此变好
这项工作推进的是:把全基因组变异效应预计算成可搜索、可排序的研究基础设施
- MODEL理解 / 预测
- DECIDE选择下一步
- INTERACT测试现实
- UPDATE改变下一轮
~90 亿预计算的单碱基变异(约 1 PB)
把基因组里每一种可能的单碱基替换的预测分子效应预先算好,做成可查询的资源。
- 认知更新
- 90 亿条预测省下的是推理和搜索成本,既不是 90 亿条实验事实,也没让底层模型变强。
- 最强证据
- 底层的 AlphaGenome 已发表于 Nature;DNM1 病例中,细胞实验支持把该变异定为 Likely Pathogenic。
- 关键限制
- 训练标签拿人群频率做代理,稀有不等于致病;Atlas 整体还没有独立复现,仅供研究使用。
01发生了什么
- 任务
- 让变异效应预测从跑模型变成查库,覆盖 hg38 上编码区和非编码区的每一种单碱基替换。
- 方法
- AlphaGenome(上下文最长 1 Mb、11 类读出)+ 另行训练的 18 特征 AVI 分数 + 逐特征归因 + 序列图案。
- 交互对象
- 代码和算力;唯一碰到实物的是 DNM1 病例的剪接实验(265 个核苷酸,5 种细胞系)。
- 结果
- 非商业研究可用网页或 API 查询;AVI 静态下载许可更宽,其余数据分层开放,商业使用计划走 Google Cloud。
~1 PB数据量,约为 AlphaFold Database 的 30 倍
~27,000每个变异对应的实验特异预测
2,601个基序,定位约 2,530 亿个实例
814例未解决的 GREGoR 病例,AVI 从中排出 DNM1
2026 年 9 月 8 日,Google DeepMind 发布 AlphaGenome Atlas:把人类参考基因组里理论上所有可能的单核苷酸变异(约 90 亿种)对分子功能的影响预先算出来,形成约 1 PB 的数据资源。非商业研究用户既可以在网页上查询、无需写代码,也可以调 API 做批量分析。[S2][S3][S6]
Atlas 的核心不是四个各自独立的模型,而是四层彼此相连的资源。第一层是 AlphaGenome 的分子效应预测。AlphaGenome 是一个已过同行评审的 sequence-to-function 模型,输入最长 100 万碱基对的 DNA 序列,预测基因表达、RNA 剪接、染色质可及性、转录因子结合、组蛋白修饰、染色质接触等 11 类分子读出。这些结果原本要逐个跑模型才拿得到,Atlas 把它们提前算好;平均每个变异对应约 27,000 个实验与生物样本特异的标量预测,去掉 active-allele 预测后约为 15,000 个。[S1][S6]
第二层是 AVI(AlphaGenome Variant Impact)分数。它不是手工凑出来的加权公式,而是另行训练的监督学习模型,用 18 个输入特征:10 个按模态聚合的 AlphaGenome 特征、1 个 AlphaMissense 分数、3 个蛋白终止相关的 VEP 指标、2 个进化保守性分数,外加 2 个 indel 类型指标。训练标签取自 gnomAD 中已观察到的变异,频率高于 0.1% 的算「代理中性」,低于 0.1% 的算「代理有影响」,输出再换算成 PHRED 分数。[S6]
这个训练目标很实用,也画出了一条重要的边界:稀有不等于致病,常见也不等于绝对无害。AVI 学到的是一个把人群频率和多类分子效应连起来的优先级分数,不是对临床致病性下判决。
第三层是 AVI feature attribution。团队用近似 SHAP 的方法,把 AVI 的原始分数拆成各输入特征的正负贡献,让研究者看清一个高分主要是来自剪接、表达、染色质、蛋白质影响,还是进化保守性。要注意,这里的归因解释的是模型为什么给出这个分数,不等于真实的生物因果机制。[S6]
第四层是 motif compendium。团队从 AlphaGenome 的归因信号里找出约 9 亿个候选调控模式,经筛选和聚类得到 2,601 个 motif,并在不同细胞类型和模态中定位了约 2,530 亿个 motif 实例。它把「这个变异可能重要」往前推了一步,接到「它可能破坏了哪一种局部调控语法」。[S6]
发布时 DeepMind 重点展示了两个应用。一个是在 GREGoR 的 814 例未解决病例里,用 AVI 排出一名癫痫性脑病患者 DNM1 基因内的深层内含子变异。AlphaGenome 预测它会在脑相关转录本中生成异常的剪接受体位点,团队随后用覆盖 265 个核苷酸、跨 5 种细胞系的 minigene 实验验证,证据支持作者建议把该变异归为 Likely Pathogenic。[S6]
另一个是在 54,189 名 UK Biobank 参与者的 2,028 项循环蛋白水平分析里,先用 Atlas 特征筛过罕见非编码变异,显著且条件独立的聚合关联发现率提高了 22%;研究者还在 BMI 分析中报告了 19 个候选基因组区域,不过这些仍是等待进一步验证的统计发现。[S2][S3][S6]
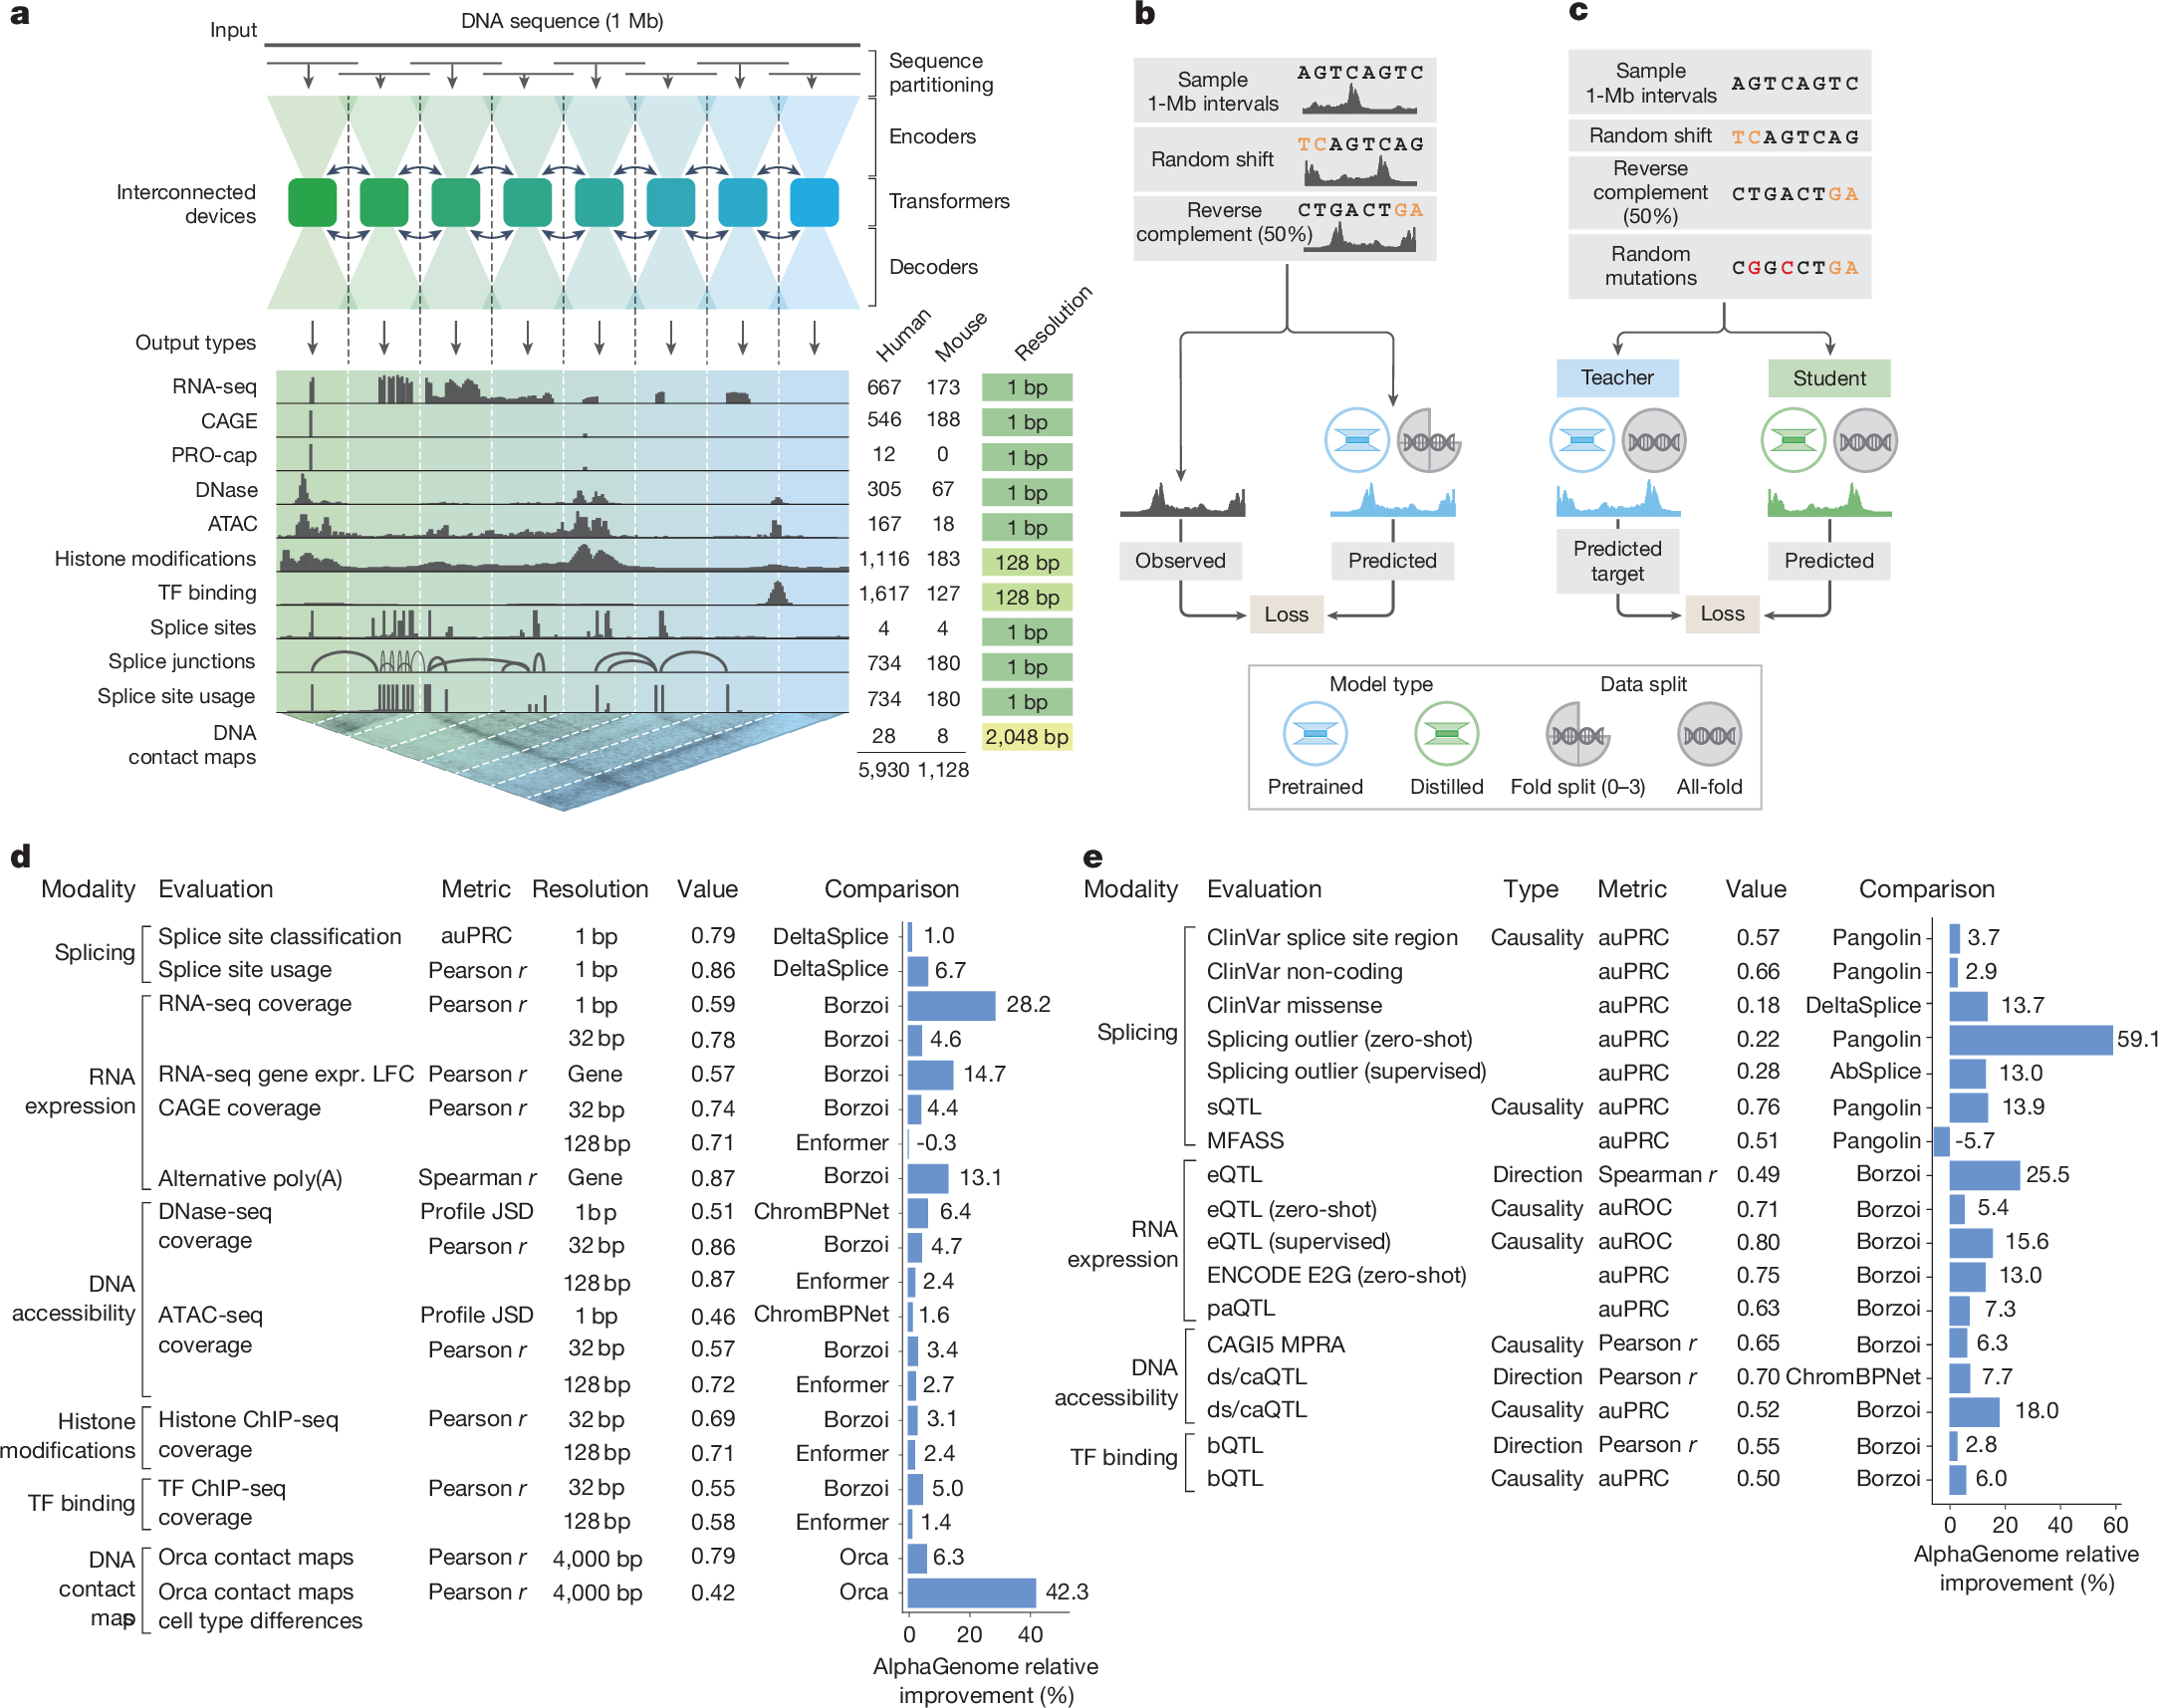
Avsec 等 AlphaGenome 论文 Fig. 1,整图未作修改:Atlas 预先算的正是这个底层模型的预测。CC BY 4.0。 [S1]
02改变了什么
流程更新大规模跑这类模型要有代码和算力,非编码变异也缺统一的解释工具。
分子效应、AVI 分数、特征归因和基序图谱都预先算好,在一处查。
DeepMind 又一次把一次性的模型推理变成可反复调用的基础设施
在 Atlas 之前,想大规模跑 sequence-to-function 模型,研究者得自备代码、算力和一整套数据处理;非编码变异也没有统一的解释工具。
这条路已经走过好几遍:先训练一个旗舰预测模型,再大规模预计算,最后把结果包装成研究者可以直接查询的公共资源。AlphaFold Database 从 2021 年开始提供蛋白质结构预测,后来扩展到 2 亿多条已编目的蛋白质序列;AlphaMissense 在 2023 年预先算了约 7,100 万种可能的人类错义变异;AlphaGenome Atlas 则把预计算铺到全基因组,涵盖编码区和非编码区约 90 亿种可能的单碱基替换。[S3][S4][S7]
把 Atlas 看成「DeepMind 把 AlphaFold Database 的路在基因组上再走一遍」是有用的,但要加两条限定。三者共享的是把模型变成基础设施的路径,科学对象并不相同。AlphaFold Database 主要为已经编目、真实存在的蛋白质序列给出结构预测;AlphaMissense 和 AlphaGenome Atlas 更像反事实地图,穷举大量「这里换成另一个字母会怎样」的可能变化,其中许多在人群里可能从未出现过。
这也不是照抄一遍,而是技术上的接续。AVI 的输入里直接含 AlphaMissense 的输出,于是 Atlas 同时用上了蛋白质层面的错义变异分数和 AlphaGenome 的调控效应预测。上一代资源成了下一代系统的一个特征,而不是推倒重来。[S6]
AlphaFold Database|预先算的是已编目的蛋白质序列,更像一张已知对象的结构地图;主要证据目标是预测结构与实验结构对不对得上。
AlphaMissense|预先算的是人类蛋白质里约 7,100 万种可能的错义变化,更像一张编码区的反事实变异地图;目标是判断这种变化会不会破坏蛋白质功能。
AlphaGenome Atlas|预先算的是 hg38 上约 90 亿种可能的单核苷酸变异,是一张全基因组的反事实效应地图;目标是预测变异对多类分子过程的影响。
谁能访问,按什么许可
访问方式也和 AlphaFold Database 不尽相同。Atlas 的网页和 API 目前面向非商业研究开放;AVI 静态下载用的是更宽松的许可,其他特征和归因数据分属不同访问层级,商业使用计划通过 Google Cloud 提供。所以「能访问」不等于整套 1 PB 数据完全开放,也不意味着可以随意拿去训练别的模型。[S3][S6]
03为什么重要
这样一个大预测资源,该当证据用,还是当搜索用?
- 门槛是真的降了:跑不起 1 Mb 模型的实验室,现在直接查就行。
- DNM1 赢在覆盖,不在局部准确率:AUPRC 0.943 对 SpliceAI 的 0.940,而原有资源在这个位置根本没有结果。
人类基因组里只有约 2% 直接编码蛋白质。剩下的非编码区域既有大量调控元件,也有功能尚不清楚的序列,许多与性状和疾病相关的变异就落在这里。非编码变异通常比编码区的更难解释:它可能只改变某一种细胞里的剪接、表达或染色质状态,也可能只在特定的发育阶段、组织或环境下才起作用。[S3]
这不等于说编码区的变异就好判定。编码区同样有大量 VUS,只是那里的蛋白结构、保守性、功能注释和专用预测工具更齐全。非编码区缺的是同等密度、同样便于检索的功能证据,所以研究者常常测序结果已经拿在手里,却还是没法把某个候选变异接到明确的分子机制上。
DNM1 这个病例展示了 Atlas 最有说服力的用法。AVI 先把一个深层内含子变异从大量候选里提到前面;AlphaGenome 接着给出脑细胞相关的异常剪接机制;研究团队再用文献、患者表型和 minigene 实验把证据链补齐。要注意的是,在这段局部剪接实验上,AlphaGenome / AVI 的 AUPRC 为 0.943,SpliceAI 和 Pangolin 分别是 0.940 和 0.939。它的主要优势不在局部准确率大幅领先,而在于 Atlas 已经提前覆盖了这个位置:原有的 SpliceAI 预计算资源在 DNM1 exon 10a 附近根本没有结果。[S6]
这恰好说明,Atlas 的直接价值更接近搜索基础设施:它未必让某一条预测更准,却让更多研究者更快找到值得细看的候选,还能看清分数是被哪些分子模态推上去的。对那些反复跑不起 1 Mb 序列模型的实验室,这种预计算实实在在降低了门槛。
AlphaFold Database 是一个可参照的先例。据 DeepMind 报告,五年后它已被 190 多个国家的 300 多万名研究者使用,其中 100 多万人来自中低收入国家;可见把昂贵模型变成能直接访问的公共资源,本身就可能让科研能力分布得更广。但这只能说明基础设施有可能被广泛采用,不能据此推断 AlphaGenome Atlas 会以同样的速度带来疾病发现、临床诊断或药物成果。[S8]
04证据状态与边界
证据等级 2 / 5 · 算出来了 · 回顾性或模拟证据状态
已证实
- 底层 AlphaGenome 已发表于 Nature,多数评估达到或超过最佳外部模型
- DNM1 病例中 minigene 实验支持 Likely Pathogenic
边界
有迹象
- AVI 在 ClinVar 内含子、同义、3′UTR 等非编码类别上明显改善
- UK Biobank:经 Atlas 筛选,显著聚合关联发现率提高 22%(统计)
- AVI 直接并入 AlphaMissense 分数,接上错义变异层
未知
- Atlas 整体能否被独立复现
- 前瞻性临床有效性,而不只是回顾性排序
- 个体基因组、trans 与远距离调控效应
- 枚举的多数变异可能从未在人群中出现
- 临床验证与监管批准
主张底层模型的剪接预测领先同类。
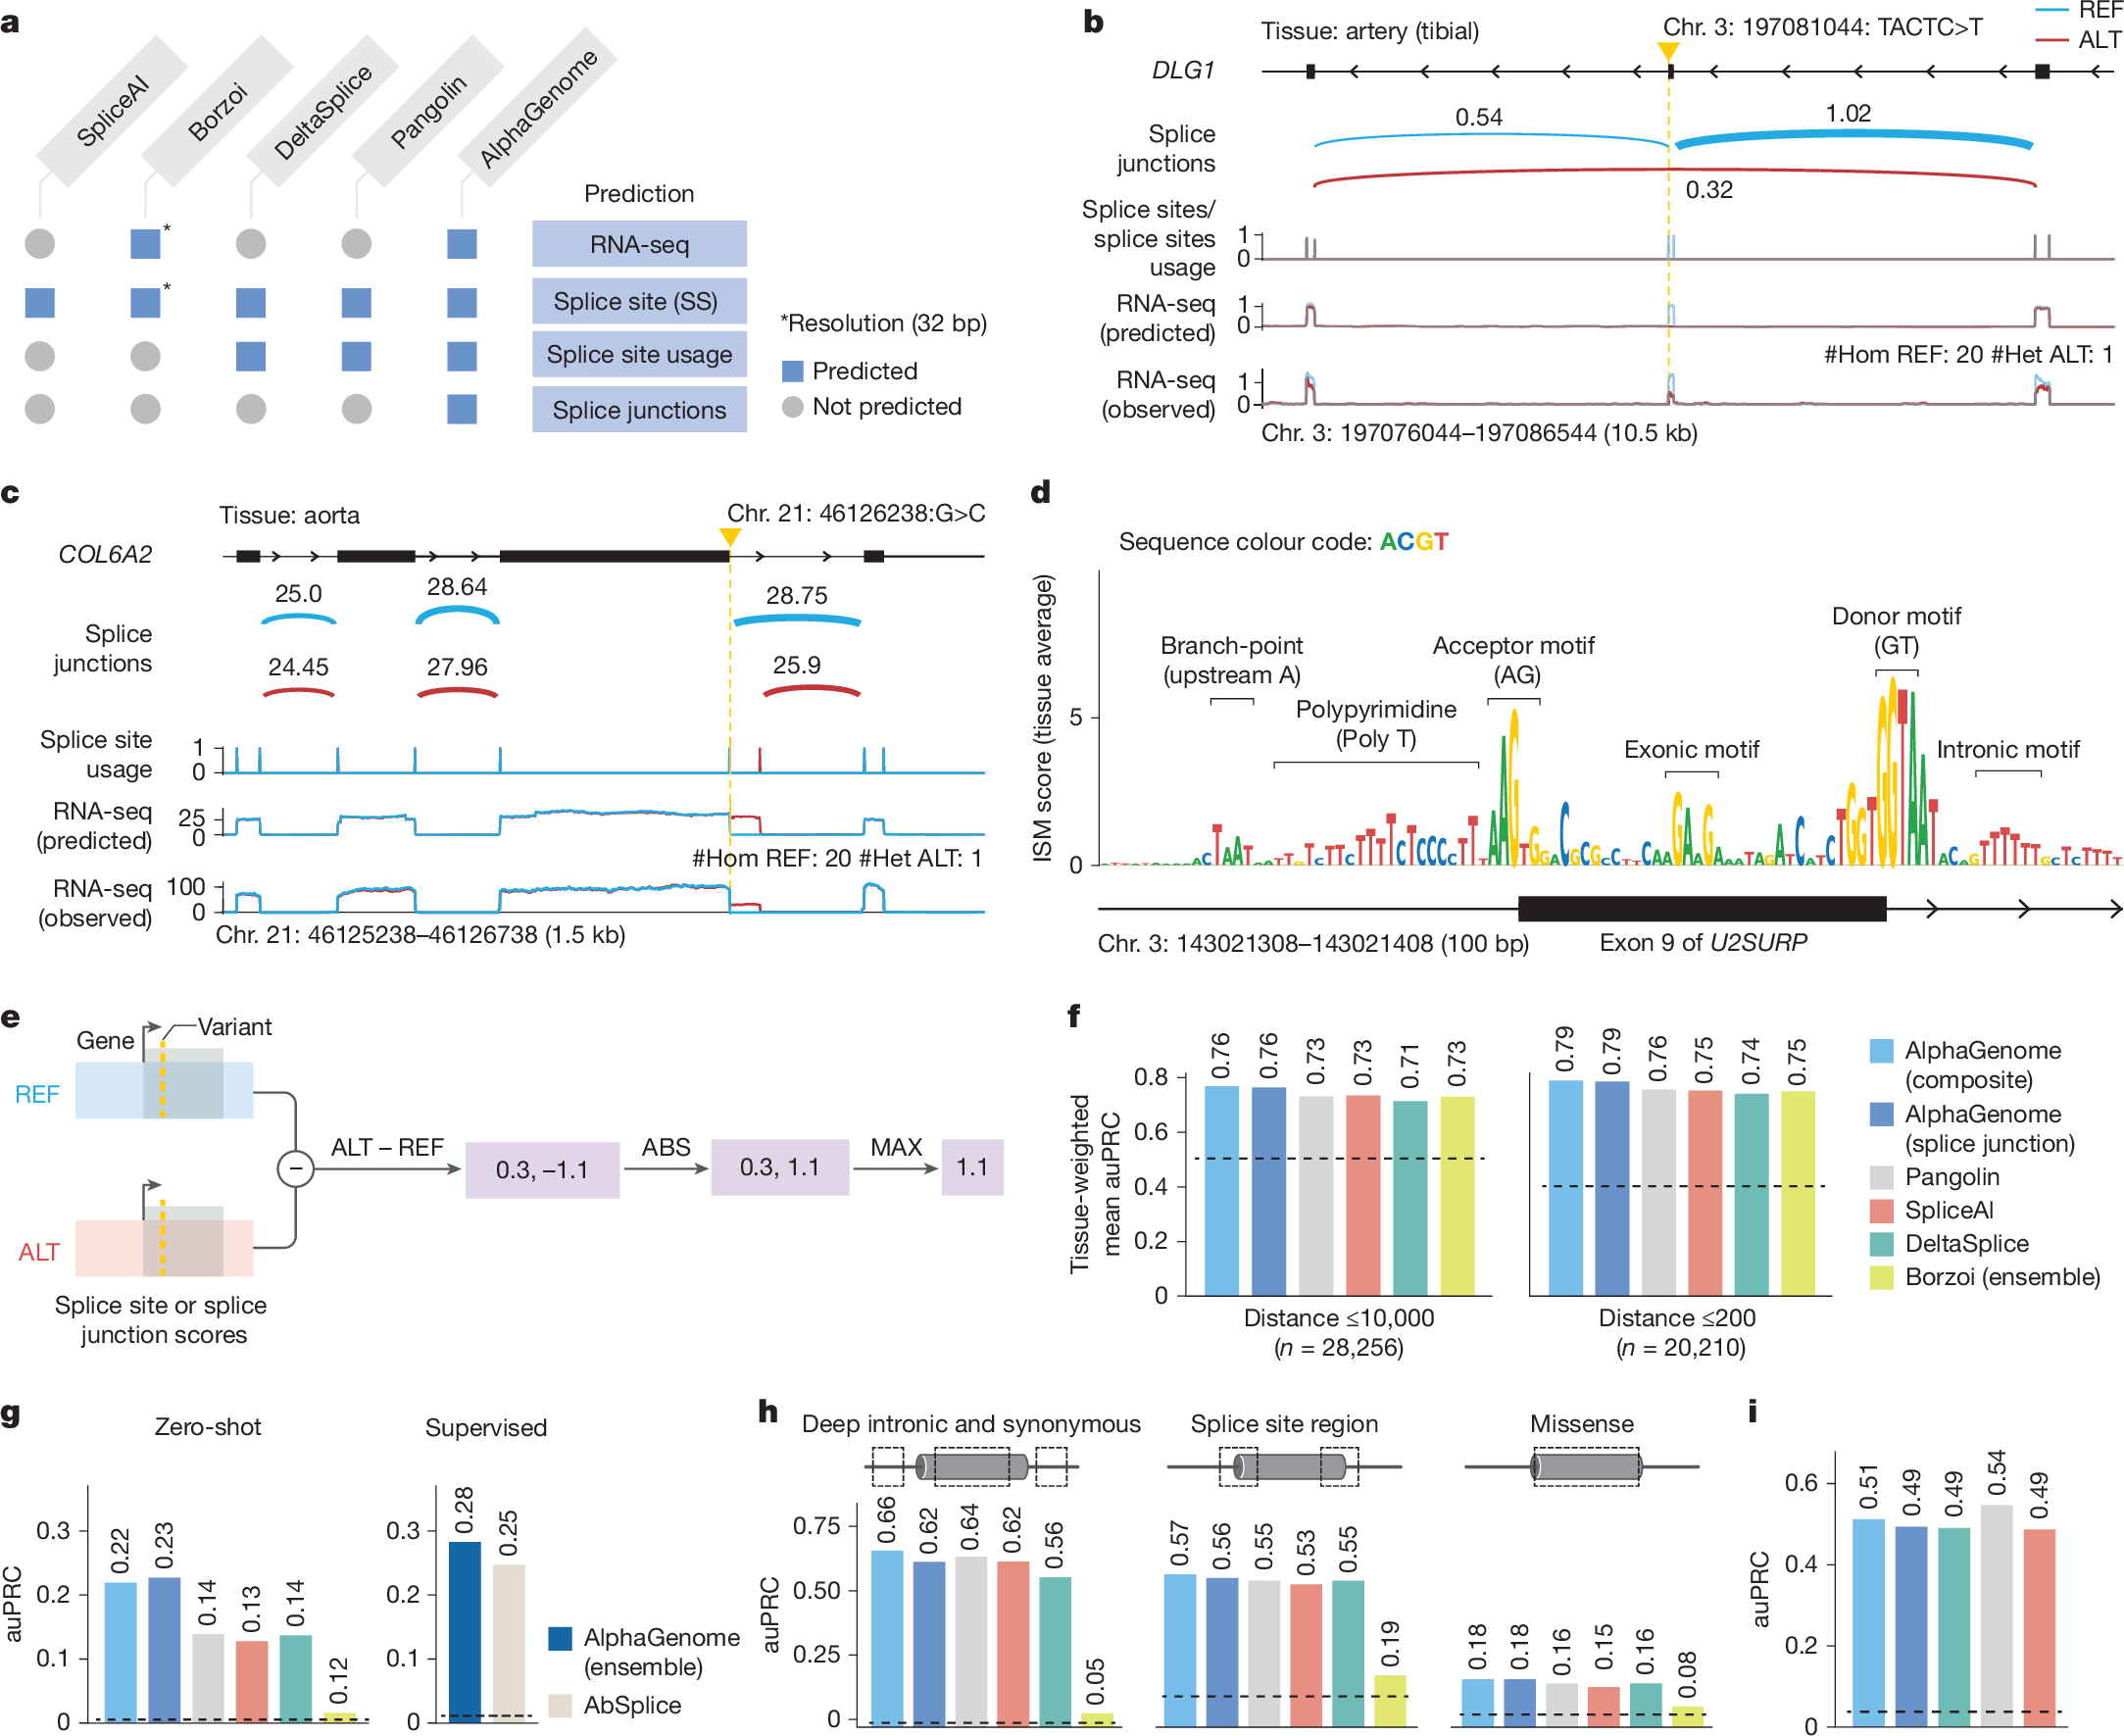
读法剪接判断综合分(auPRC)0.76 对 SpliceAI 0.73:这是底层模型的证据,不是 Atlas 的。
这张证据图评的是底层模型的剪接能力。
Nature 论文 Fig. 3 显示,在 10 kb 以内的剪接变异效应预测上,AlphaGenome 的组织加权 auPRC 为 0.76,SpliceAI 为 0.73;在 ClinVar 深内含子和剪接位点区类别上也领先(panel h)。这是底层模型的评测证据,不是 Atlas 自己的:Atlas 只是把这个模型的预测预先算好,做成可查询的资源。[S1]
底层 AlphaGenome 的基准证据比较扎实。
模型已发表于 Nature。论文报告,它在 24 项 sequence-track 评估中有 22 项超过外部模型,在 26 项变异效应评估中有 25 项达到或超过当时最佳的外部模型。它最清楚的优势,是把 1 Mb 上下文、单碱基分辨率和多模态输出装进同一个模型,而不是在每个单项任务上都大幅领先。[S1][S9]
AVI 并非在所有任务上都领先。
在 ClinVar 内含子、同义和 3′ UTR 等类别上,AVI 的提升很明显;但在 5′ UTR、非编码孟德尔病变异、fine-mapped GWAS 和罕见复杂性状等评估中,它只与最佳方法相当,甚至略低。比如非编码孟德尔病基准上 AUPRC 为 0.76,GPN-Star-M 为 0.77;fine-mapped GWAS 上是 0.28 对 0.27。更准确的说法是:它在多类基准上达到或接近最佳,并在部分非编码类别上明显改善,而不是全面领先。[S6]
DNM1 的证据链比较完整,但仍是一例。
在这名患者身上,AVI 把该变异排到首位,AlphaGenome 给出一个可检验的异常剪接机制,minigene 实验验证了这个机制,最终证据支持作者建议归为 Likely Pathogenic。这说明 Atlas 能在具体病例里帮忙排候选,但它不是前瞻性临床试验,也推不出对所有未确诊患者都同样有效。[S6]
UK Biobank 的 22% 是统计发现率,不是多出来的因果事实。
研究用的是 54,189 名参与者的 2,028 项循环蛋白水平数据。经 Atlas 筛选的聚合分析把显著关联的发现率提高了 22%,条件分析之后仍显著的 241 个聚合关联里有 177 个来自 Atlas 特征。但这些结果主要是统计遗传学信号,还没有逐个做分子或临床验证;分析用的也是稍早版本的 Atlas 数据。复杂性状那部分,31 个关联里有 25 个在 All of Us 中拿到了足够的变异计数,其中只有 4 个达到名义显著的重现,且都没有通过 Bonferroni 校正。[S6]
AVI 那个统一分数,是有意压掉上下文换来的。
它在不同组织的 AlphaGenome 预测里取最大效应,再压成一个分数。这让全基因组排序更好用,代价是丢掉了一部分细胞和组织层面的语境。SHAP 归因能说明是哪些输入把 AVI 分数推高的,但单凭它证明不了这个特征在体内真有因果作用。
训练数据里没有的生物学,AlphaGenome 建不出来。
配套技术稿把这些限制列得很清楚:poly(A) 富集的 RNA-seq 会漏掉非多聚腺苷酸化的 RNA;许多相关细胞类型根本没有数据;各模态之间的细胞类型覆盖也不均衡;模型学的主要是顺式调控语法,无法直接表示转录因子表达变化这类反式机制。超出有效上下文的远距离调控、个体基因组效应、遗传背景、发育过程和环境影响,同样仍然难办。[S1][S6]
现有的独立评估冲着底层模型来,不是冲着 Atlas。
一份用 GTEx 953 人数据做的独立预印本发现,AlphaGenome 明显好过 Enformer,却仍不及直接在个体数据上训练的 Elastic Net 和 Random Forest。这个比较不能简单读成「传统模型普遍胜过 AlphaGenome」,因为两边的训练目标和可用数据都不一样;它更准确地说明了一件事:从参考序列上的分子预测,到个体的表达预测,这一步不会自动完成。[S5]
外部专家认可它的多任务统一,也提醒单一分数容易被误读。
Science Media Centre 汇编的专家意见认为,AlphaGenome 的工程水平很高,但在单项任务上常常只是与最好的专用工具打平,现阶段还不足以直接用于患者诊疗。IEEE Spectrum 引述 UBC 基因组学家 Carl de Boer 的话说,AVI 这样的单一分数很有用,也很容易被误读,因为它压缩的是一个有许多活动部件的复杂系统。Nature 的发布报道同样把 Atlas 称为预测资源,而不是实验结论或临床判决。[S9][S10][S11]
「基因组版 AlphaFold Database」这个类比有边界。
AlphaFold Database 画的是已知的蛋白质对象;Atlas 画的是可能突变带来的反事实后果。蛋白质结构可以和相对明确的实验坐标比对,基因组的「功能」却分散在细胞类型、组织、模态和时间条件里,离「某个人会不会得病」还隔着好几层因果。Atlas 里绝大多数假设性变异也未必能在真实人群中观测到,可验证性因此本就不同。官方明确写着:AlphaGenome 和 Atlas 仅供研究,不能替代医学建议,未经临床验证,也未获批用于临床决策。[S2][S3][S6]
05我从中学到什么
- 可迁移的洞见
- 「模型 → 预计算 → 可查询资源」,DeepMind 这条路走了三回:AlphaFold DB、AlphaMissense、Atlas。
- 设计启发
- 预先算好的反事实地图是搜索基础设施:更便宜、覆盖更广,但不添一条实验事实。
- 阅读启发
- 「N 亿条预测」要读成推理成本,不是 N 亿条事实;单一分数还压掉了组织语境。
- 接下来看
- Atlas 整体能否被独立复现,能否从回顾性排序走到前瞻性临床使用。
「模型 → 大规模预计算 → 可查询资源」已经成了 DeepMind 惯用的 AI4S 产品路径。
AlphaFold Database、AlphaMissense 和 AlphaGenome Atlas 面对的科学对象各不相同,但都把只有少数团队负担得起的昂贵推理,变成了更多研究者可以直接调用的基础设施。AlphaGenome Atlas 把这条路径一举铺到了全基因组的变异空间。
预计算改的是模型进入工作流的方式,不是模型本身的能力。
不用重新训练一个更大的 AlphaGenome,Atlas 就把研究者的做法从「先挑一个变异,再申请算力跑模型」换成了「先查全局地图,再决定细看哪一个」。系统由此从 Model 往 Search / Decision Support 挪了一步,但它仍不负责给出最终的医学结论,也不会自己做实验、再按结果更新模型。
规模把模型的价值和盲区一起放大。
一个模型被跑上 90 亿次,推理成本和覆盖瓶颈确实大幅下降;但训练数据里缺的细胞类型、没被测到的 RNA、反式机制、遗传背景、发育和环境因素,也会被成片地复制到整张地图上。算力能买来搜索范围,买不回从来没有观测过的生物学。
AlphaFold Database 画的是已知对象,AlphaGenome Atlas 画的是可能的变化。
前者回答的是「这个已知蛋白质可能长什么样」,后者回答的是「如果这里换一个碱基,模型认为会变什么」。反事实地图更适合做筛选、提假设,也更要求读者分清预测、关联、机制和临床证据。
单一分数好用和易被误读,来自同一个设计。
AVI 把 18 个特征压成一个可排序的数字,非专业用户也能靠它快速缩小候选范围;但这个数字里混着分子预测、蛋白影响、保守性和人群频率代理。它最适合回答「先看哪一个」,不适合单独回答「哪一个一定致病」。规模能压低推理、覆盖和搜索的成本,却补不回测量、数据收集和生物表征环节本就缺失的信息。
长图版本方便保存转发→资料来源
本文主要依据同行评审论文、Atlas 官方技术稿和数据发布,并用独立预印本、专家评论和新闻报道核查它的证据边界。
- S1Advancing regulatory variant effect prediction with AlphaGenomeNature · 2026.01.28 · 同行评审论文
- S2AlphaGenome Atlas: a high-resolution map of human DNAGoogle Blog · 2026.09.08 · 官方发布
- S3AlphaGenome Atlas: A predictive map of every possible DNA letter change in the human genomeGoogle DeepMind · 2026.09.08 · 官方详细介绍与图片来源
- S4A catalogue of genetic mutations to help pinpoint the cause of diseasesGoogle DeepMind · 2023.09 · AlphaMissense 发布公告
- S5AlphaGenome Enhances Personal Gene Expression Prediction but Retains Key LimitationsbioRxiv · 2026.04 · 独立预印本,非同行评审
- S6AlphaGenome Atlas: Molecular predictions for 9 Billion human DNA variantsGoogle DeepMind · 2026.09 · 官方技术稿,未注明同行评审
- S7Accurate proteome-wide missense variant effect prediction with AlphaMissenseScience · 2023.09 · 同行评审论文
- S8AlphaFold: Five years of impactGoogle DeepMind · 2025.11.25 · 官方五年回顾;采用量为 DeepMind 报告口径
- S9Expert reaction to paper on Google DeepMind’s AlphaGenomeScience Media Centre · 2026.01.28 · 外部专家反应汇编
- S10Google DeepMind Maps 9 Billion Possible DNA VariantsIEEE Spectrum · 2026.09.08 · 新闻报道与独立专家评论
- S11DeepMind’s new genome ‘atlas’ charts effects of all nine billion human gene mutationsNature · Ewen Callaway · 2026.09.09 · 独立新闻报道