

论文解读 · 分子表征· 科学证据 · Frontier
分子进入 Transformer 之前,信息可能已经丢了
密歇根大学与卡内基梅隆大学的 Wadell 等人发现,分子分词器的覆盖缺口在常规药物基准上不容易暴露,一旦罕见元素、同位素与复杂立体信息叠加在一起,就会迅速放大。他们的 Smirk 用 165 个基础 token 补上了这个缺口。
◆同行评审论文 + 公开 benchmark + 同团队后续预印本
当前边界:完整覆盖 OpenSMILES 语法,不等于覆盖三维构象与物理环境。
这项工作推进的是:让分子字符串在进入模型时保留罕见元素、同位素、电荷与几何信息
- MODEL理解 / 预测
- DECIDE选择下一步
- INTERACT测试现实
- UPDATE改变下一轮
165个基础 token,从构造上覆盖有效 OpenSMILES
>28T种括号原子语法组合,是理论上限而非真实分子数
遇到合法但罕见的组合,封闭原子词表只能输出 [UNK],Smirk 不会。
- 认知更新
- 模型能做到哪一步,先要看输入保留了什么:封闭原子词表会不声不响地抹掉罕见的化学信息。
- 最强证据
- 在 REALSpace、MoleculeNet 和 tmQM 上测量,并从零预训练、微调了 18 个 RoBERTa 式 encoder。
- 关键限制
- 都是同一团队在公开 benchmark 上的计算,未经独立复现;覆盖完整,不等于单独测出了 tokenizer 的收益。
01发生了什么
- 任务
- 审计 Transformer 之前的 tokenization:每个 tokenizer 保留了多少化学信息?
- 方法
- 用 [UNK] 比例和丢失的信息量衡量;Smirk 拆开括号原子。
- 交互对象
- 只有字符串和代码:SMILES 文本;不碰三维构象、溶剂或分子间作用。
- 结果
- Smirk-GPE:在约 2.62 亿个分子上学到约 2,300 个 token 即无可合并。
35 / 20tokenizer / 其中化学专用(v3 为 34 / 19)
18.9%SPE/APE 在 MoleculeNet 上输出的 token 中 [UNK] 的比例
≈50%同一 token 占比,换到 tmQM
分子模型在 MoleculeNet 上成绩好,不代表它的 tokenizer 保留了全部输入信息。
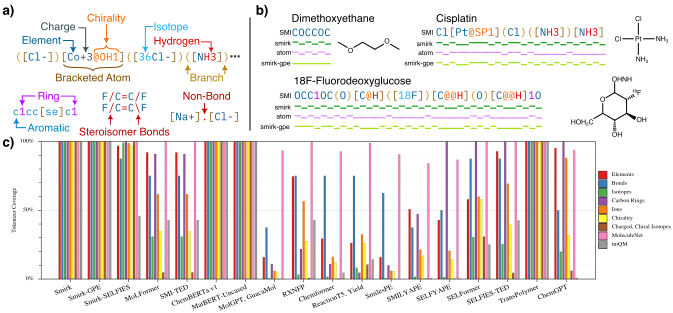
许多化学模型采用 Atom-wise tokenization,用正则表达式把 SMILES 切成原子和化学符号。常见有机分子这样切通常没有问题;盲区主要出在低频元素、同位素、电荷、显式氢和复杂立体信息凑成的罕见组合上。碰到词表里没有的组合,模型可能只拿到一个 [UNK]:训练照常进行、不会报错,原始的化学信息却已经丢了。例如 [Au](金)、[Ru](钌)、[U](铀)、[13CH3](同位素标记)、[C@H](手性中心)和 [NH3+](带电基团)。[S1]
按 OpenSMILES 的规定,“有机子集”(B、C、N、O、S、F、Cl、Br、I)以外的原子,以及显式标出同位素、手性、电荷、氢数或类别的原子,都要写进方括号。现有的原子级 tokenizer 普遍沿用同一条经典正则表达式切分 SMILES,这条正则的第一个分支就把整个括号原子当成一个不可再分的 token。[S1]
团队一共评估了 35 种 tokenizer:20 种化学专用 tokenizer(Atom-wise、SPE/APE、BPE、Unigram 等),外加 GPT-4o、LLaMA、Gemma 等通用 NLP tokenizer,并在 REALSpace、MoleculeNet 和 tmQM 三类数据上测量实际覆盖率和信息损失。[S1]
版本差异:arXiv v3 的摘要和图 2 按 34 / 19 计(图 2 各类括号里的 n 加起来是 34),同行评审版摘要改为 35 / 20。本页和海报用的论文图都来自 v3。[S2][S1]
三个指标,三个分母
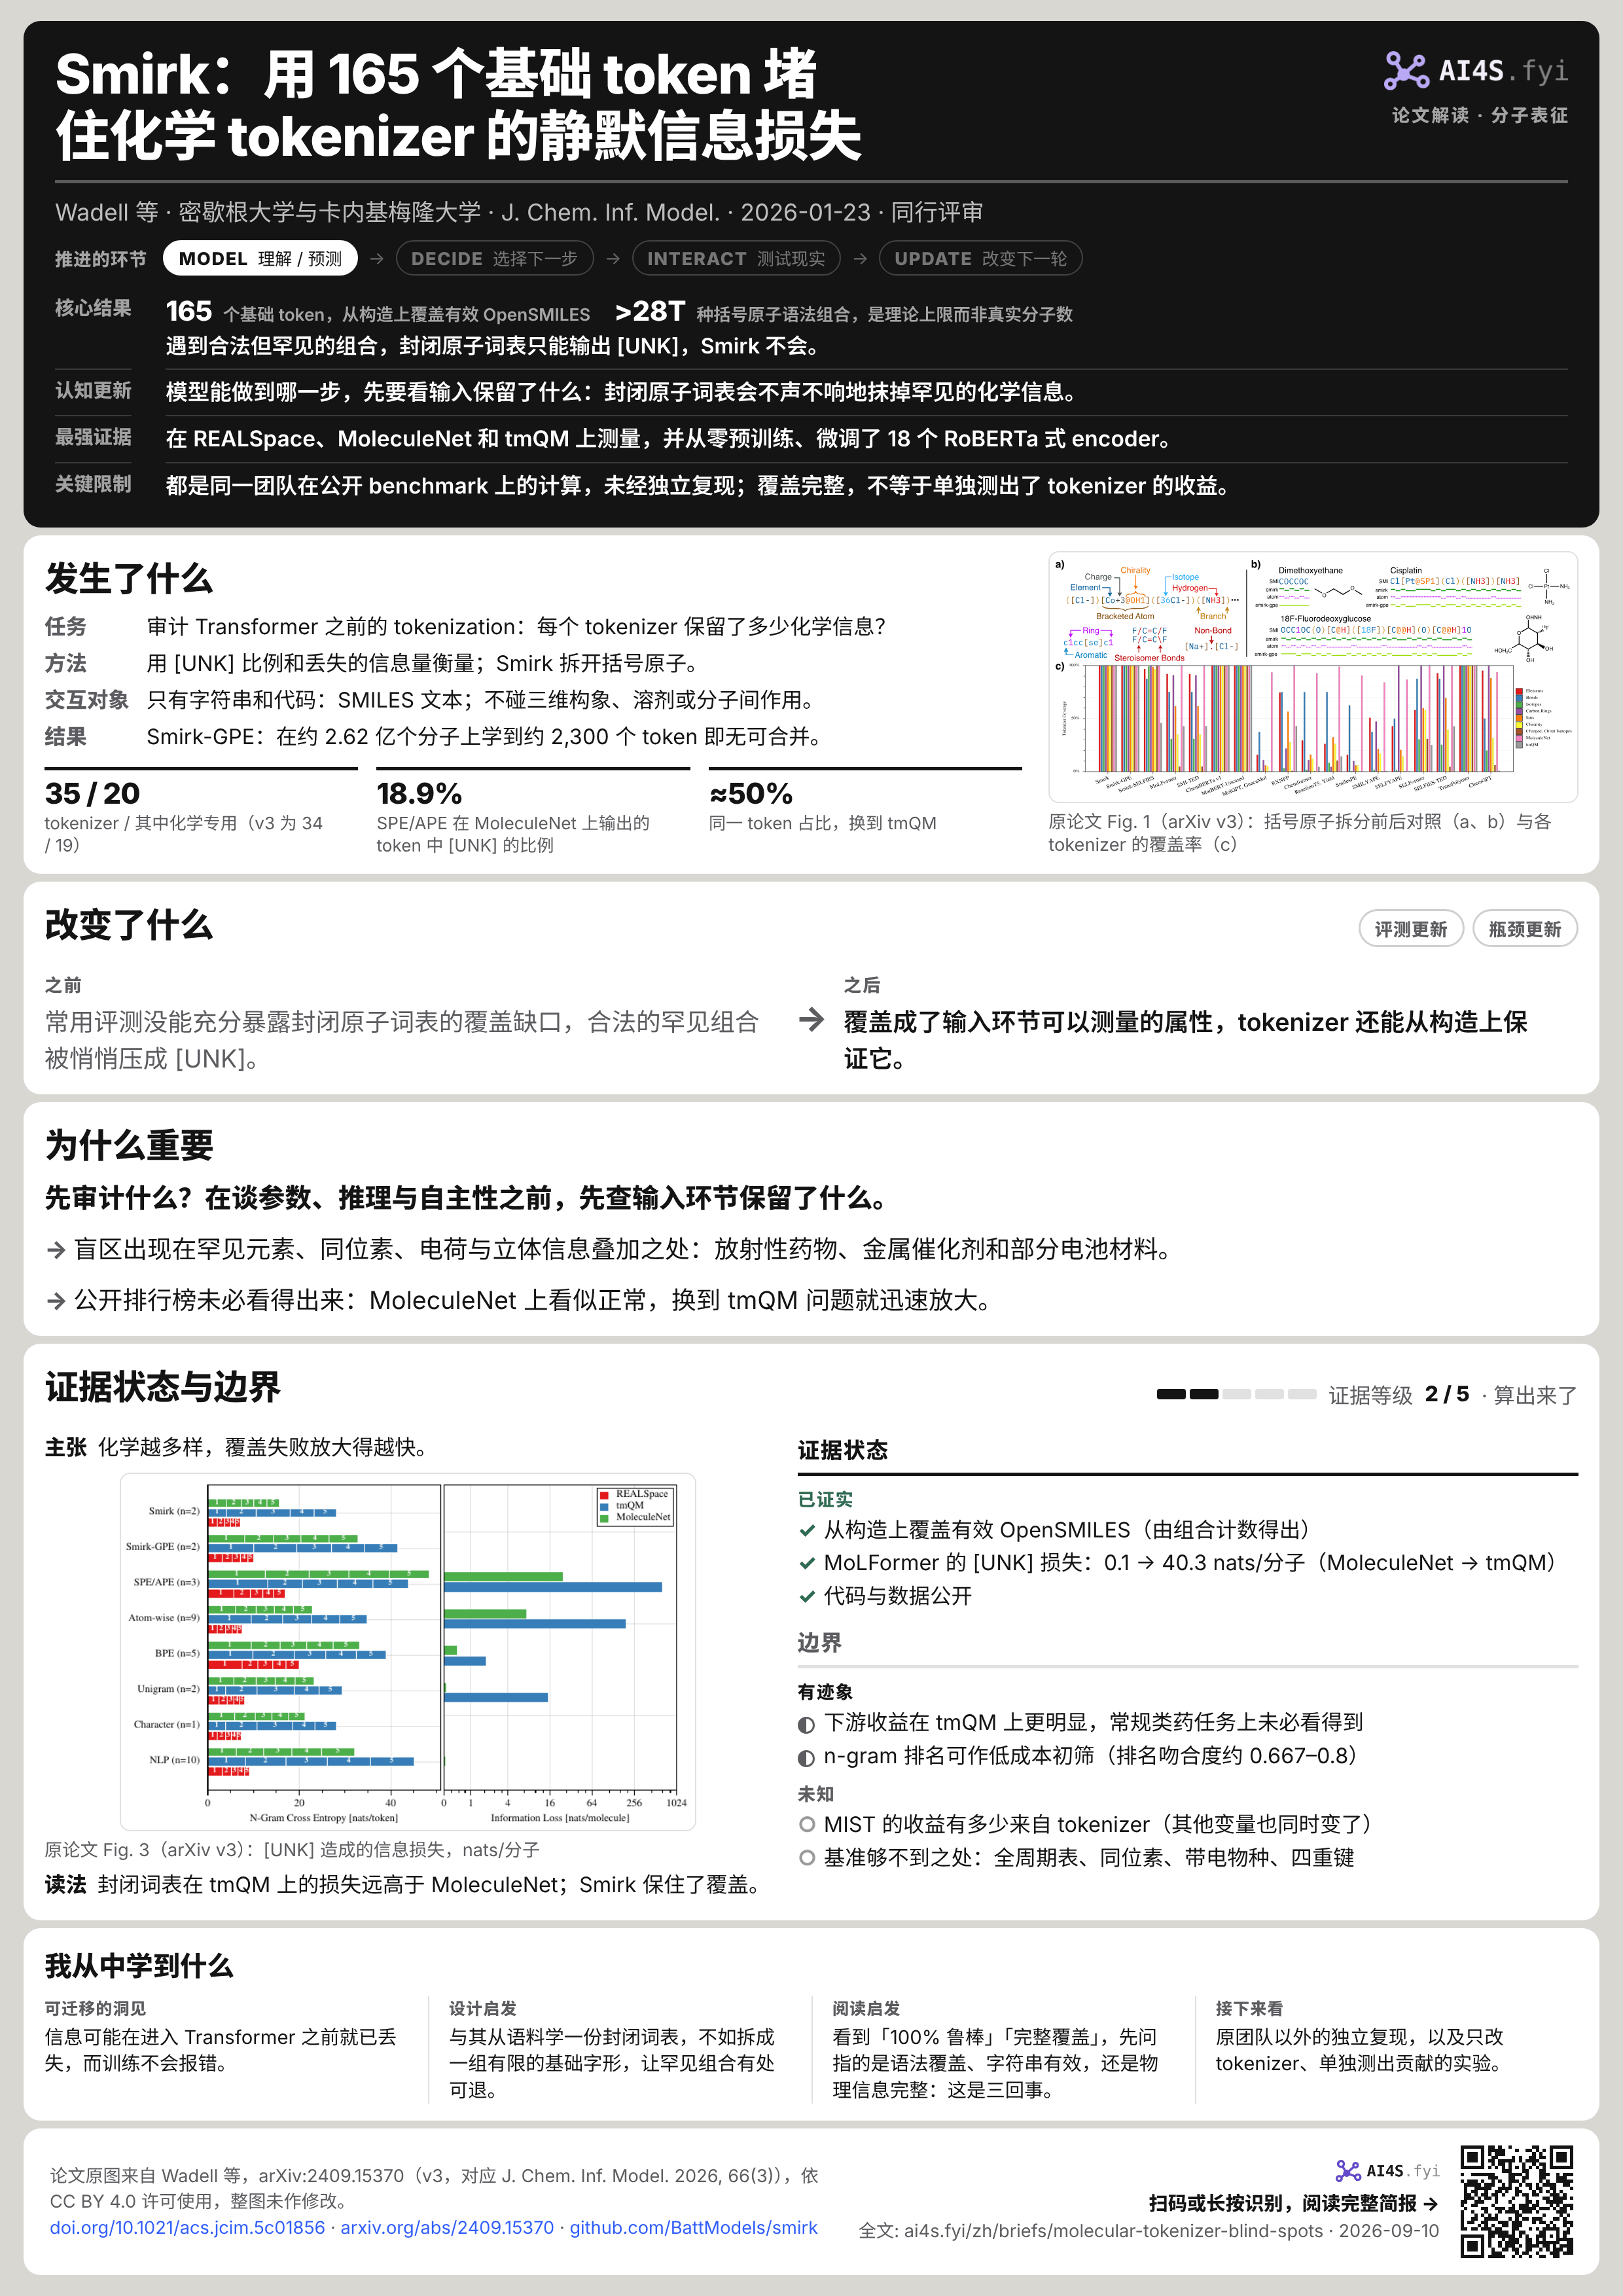
论文用了三种口径,不能混用。一是 [UNK] 的 token 占比:SPE/APE 在 MoleculeNet 上输出的 token 里有 18.9% 是 [UNK],在 tmQM 上约 50%。二是覆盖率(图 1c):处理时不出现 [UNK] 的分子所占比例。三是信息损失(图 3):用 5-gram 参照模型算出的 KL 散度,单位是 nats/分子,比如 MoLFormer 在 MoleculeNet 上 0.1、在 tmQM 上 40.3。[S2]
论文自己的例子能看清拆分前后的差别:OC[C@@H][OH] 先按原子切开,再拆成 OpenSMILES 字形。原子级 tokenizer 停在第一步,[C@@H] 整块去词表里查,查不到就是 [UNK];Smirk 走到第二步,每个字形都在 165 个 token 之内,拆开后还能原样拼回。[S2]
O C [C@@H] [OH] → O C [ C @@ H ] [ O H ]02改变了什么
评测更新瓶颈更新常用评测没能充分暴露封闭原子词表的覆盖缺口,合法的罕见组合被悄悄压成 [UNK]。
覆盖成了输入环节可以测量的属性,tokenizer 还能从构造上保证它。
括号原子为什么多到词表装不下
症结在于:把同位素、手性、电荷、氢数和类别的各种组合都算上,OpenSMILES 语法允许的括号原子理论上超过 28 万亿种,而现有原子级 tokenizer 的词表都不到三千个 token。这个数字是语法组合的上限,并不是说现实中有 28 万亿种可用分子,但已足以说明封闭的原子词表不可能做到完整覆盖。[S1]
[同位素][元素符号][手性][氢数][电荷][类别]团队给出的办法是 Smirk:不再把括号原子当成整体,而是继续拆成 OpenSMILES 中有独立含义的基础字形,比如把 [C@@H] 拆成 [、C、@@、H、]。这样得到一个 165 个 token 的基础词表,从构造上覆盖所有有效的 OpenSMILES 表达式。它不需要从语料中学一份封闭的括号原子清单,遇到合法但罕见的组合也不会输出 [UNK]。[S1]
边界要说清楚:这里的“完整覆盖”指 OpenSMILES 语法层面的覆盖,不是对物理世界的完整覆盖。三维构象、溶剂、环境、分子间相互作用和动力学,SMILES 本身就表达不充分,它们在这项覆盖保证的范围之外,不是一个有待确认的 tokenizer 性能问题。[S1]
压短序列,又不让盲区回来
拆得越细,序列就越长,而 Transformer 的注意力开销随长度快速上升。所以 Smirk-GPE 在化学字形的 token ID 上学习合并规则:常见组合得到压缩,罕见组合仍可退回基础字形,不会重新引入 [UNK]。[S1]
Smirk-GPE 的训练数据约有 2.62 亿个分子。目标词表定为 5 万,但到约 2,300 个 token 时就已没有可用的合并。这是在完整性、序列效率和语义边界之间做的工程取舍。[S1]
03为什么重要
先审计什么?在谈参数、推理与自主性之前,先查输入环节保留了什么。
- 盲区出现在罕见元素、同位素、电荷与立体信息叠加之处:放射性药物、金属催化剂和部分电池材料。
- 公开排行榜未必看得出来:MoleculeNet 上看似正常,换到 tmQM 问题就迅速放大。
为什么 MoleculeNet 上看不出问题
类药小分子里常见的 @ / @@ 手性,并不会让 tokenizer 普遍出错。风险集中在罕见元素、同位素、电荷、显式氢和复杂几何叠加而成的组合上。MoleculeNet 以常规药物化学空间为主,整体排行榜因此可能一切正常;tmQM 含有更多过渡金属配合物,覆盖问题就明显得多。[S1]
论文举了顺铂的例子:顺铂是有效的化疗药物,它的立体异构体却不是。如果表征流程抹掉了区分二者配位几何的信息,模型也就丢掉了一个有临床意义的差别。同位素标记的放射性药物、工业催化剂和电解质材料也有类似风险,而这些恰恰是分子基础模型眼下正在进入的新领域,不是它们起步时依赖的类药小分子舒适区。[S1]
论文也指出了 benchmark 自身的局限:即使是相对多样的 tmQM,也没有覆盖整个元素周期表、全部同位素、带电物种,以及四重键这类罕见结构。如果研究方向恰好落在这些盲区里,公开排行榜对模型能否读懂那一片化学空间,可能说明不了多少。[S1]
论文用 [UNK] 比例和 KL 散度衡量这种不报错的损失,并从零预训练、微调了 18 个 RoBERTa 式 encoder 作外部验证。n-gram 排名与下游结果排名的 Spearman 相关约为 0.667–0.8:拿来做低成本初筛可以,但替代不了完整的训练和任务评估。[S1]
04证据状态与边界
证据等级 2 / 5 · 算出来了 · 回顾性计算验证证据状态
已证实
- 从构造上覆盖有效 OpenSMILES(由组合计数得出)
- MoLFormer 的 [UNK] 损失:0.1 → 40.3 nats/分子(MoleculeNet → tmQM)
- 代码与数据公开
边界
有迹象
- 下游收益在 tmQM 上更明显,常规类药任务上未必看得到
- n-gram 排名可作低成本初筛(排名吻合度约 0.667–0.8)
未知
- MIST 的收益有多少来自 tokenizer(其他变量也同时变了)
- 基准够不到之处:全周期表、同位素、带电物种、四重键
主张化学越多样,覆盖失败放大得越快。
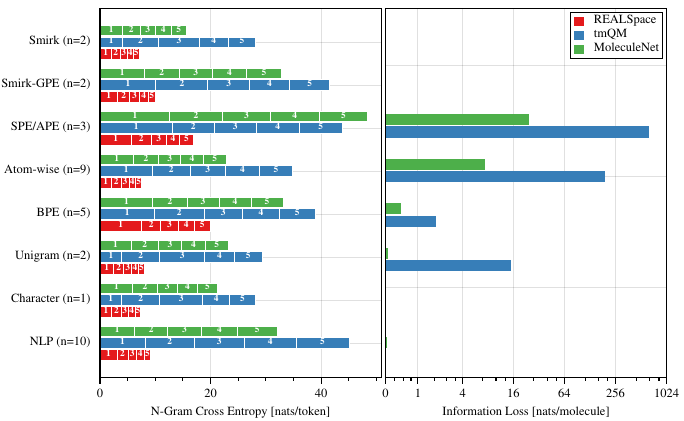
读法封闭词表在 tmQM 上的损失远高于 MoleculeNet;Smirk 保住了覆盖。
性能收益是有条件的
从论文结果看,Smirk 在 MoleculeNet 上与 Atom-wise 大致持平,正面效果要到 tmQM 这类化学更复杂的数据上才更清楚。如果任务只涉及常规类药小分子,这项改进未必能在排行榜上显出来。[S1]
与 SELFIES 的对照划出另一条边界
tmQM 中有 54% 的分子因为带有增强立体化学,无法转成实验所用的 SELFIES。字符串是否有效、语法是否覆盖、物理信息是否完整,是三个不同的问题,不能拿一句“100% 鲁棒”或“100% 覆盖”一笔带过。[S1]
MIST 把 Smirk 用到 18 亿参数,却没有分离出 tokenizer 的作用
后续的 MIST 预印本用 Smirk 训练了 28M 和 1.8B 参数的 encoder,训练数据分别约 2.45 亿和 20 亿个分子,再通过微调在 400 多项结构-性质任务上评估。可见 Smirk 能用在规模大得多的训练流程里;微调到 tmQM 上,验证集 R² 从 MIST-28M 的 0.76 升到 MIST-1.8B 的 0.80。[S3]
MIST 同时改动了模型规模、训练数据、算力预算和微调设置,性能提升不能全算在 tokenizer 头上。它展示的是 Smirk 能随规模放大、能适配不同任务;跨化学领域的结果来自针对任务的微调,而不是 zero-shot 泛化。[S3]
同行评审让来源更可信,却没有抬高物理证据的层级
Smirk 的证据仍是回顾性计算和公开 benchmark,没有湿实验,也没有物理闭环验证;MIST 目前还是预印本。[S1][S3]
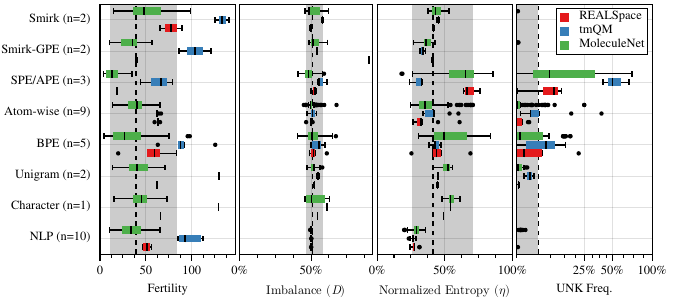
论文 Fig. 2:从 fertility、imbalance、normalized entropy 和 [UNK] 频率可以看出不同 tokenizer、不同数据集之间的覆盖差异。图中是 v3 的 34 个 tokenizer;同行评审版为 35 个。Wadell et al., arXiv:2409.15370 (v3)。 [S2]
05我从中学到什么
- 可迁移的洞见
- 信息可能在进入 Transformer 之前就已丢失,而训练不会报错。
- 设计启发
- 与其从语料学一份封闭词表,不如拆成一组有限的基础字形,让罕见组合有处可退。
- 阅读启发
- 看到「100% 鲁棒」「完整覆盖」,先问指的是语法覆盖、字符串有效,还是物理信息完整:这是三回事。
- 接下来看
- 原团队以外的独立复现,以及只改 tokenizer、单独测出贡献的实验。
长图版本方便保存转发→资料来源
本文主要依据同行评审论文、对应 arXiv 版本、MIST 预印本和 Smirk 官方代码仓库。