

论文与系统· 科学证据 · Frontier
AI 怎样读懂一张化学反应图?从认出分子到还原反应关系
上海人工智能实验室 OpenDataLab 的这项工作做反应图解析:把一张图里认出的分子进一步组织成反应关系,谁和谁反应、条件属于哪一步,以及一张合成路线图里的多条箭头怎样连起来。评测以单张图为单位,不是整篇论文。
●同行评审论文 + 预印本 + 任务评测
当前边界:证据仍停留在单张反应图上的任务表现,不是整篇论文直接入库的可靠性
这项工作推进的是:从化学图中恢复反应关系
- MODEL理解 / 预测
- DECIDE选择下一步
- INTERACT测试现实
- UPDATE改变下一轮
系列导读
MinerU.Chem 系列|从化学 PDF 到机器可用的反应数据
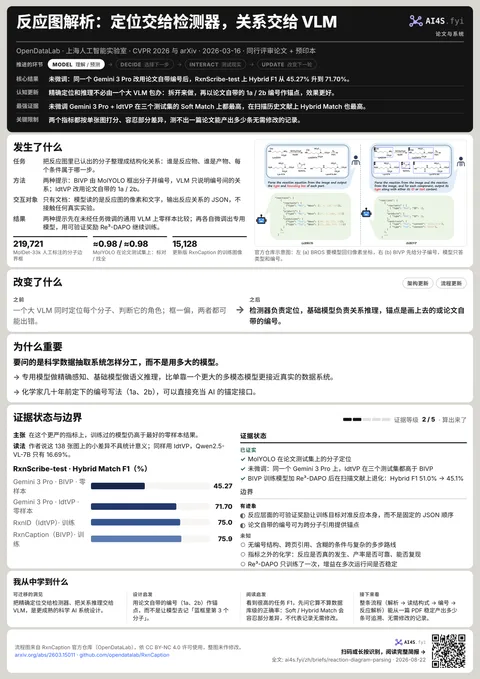
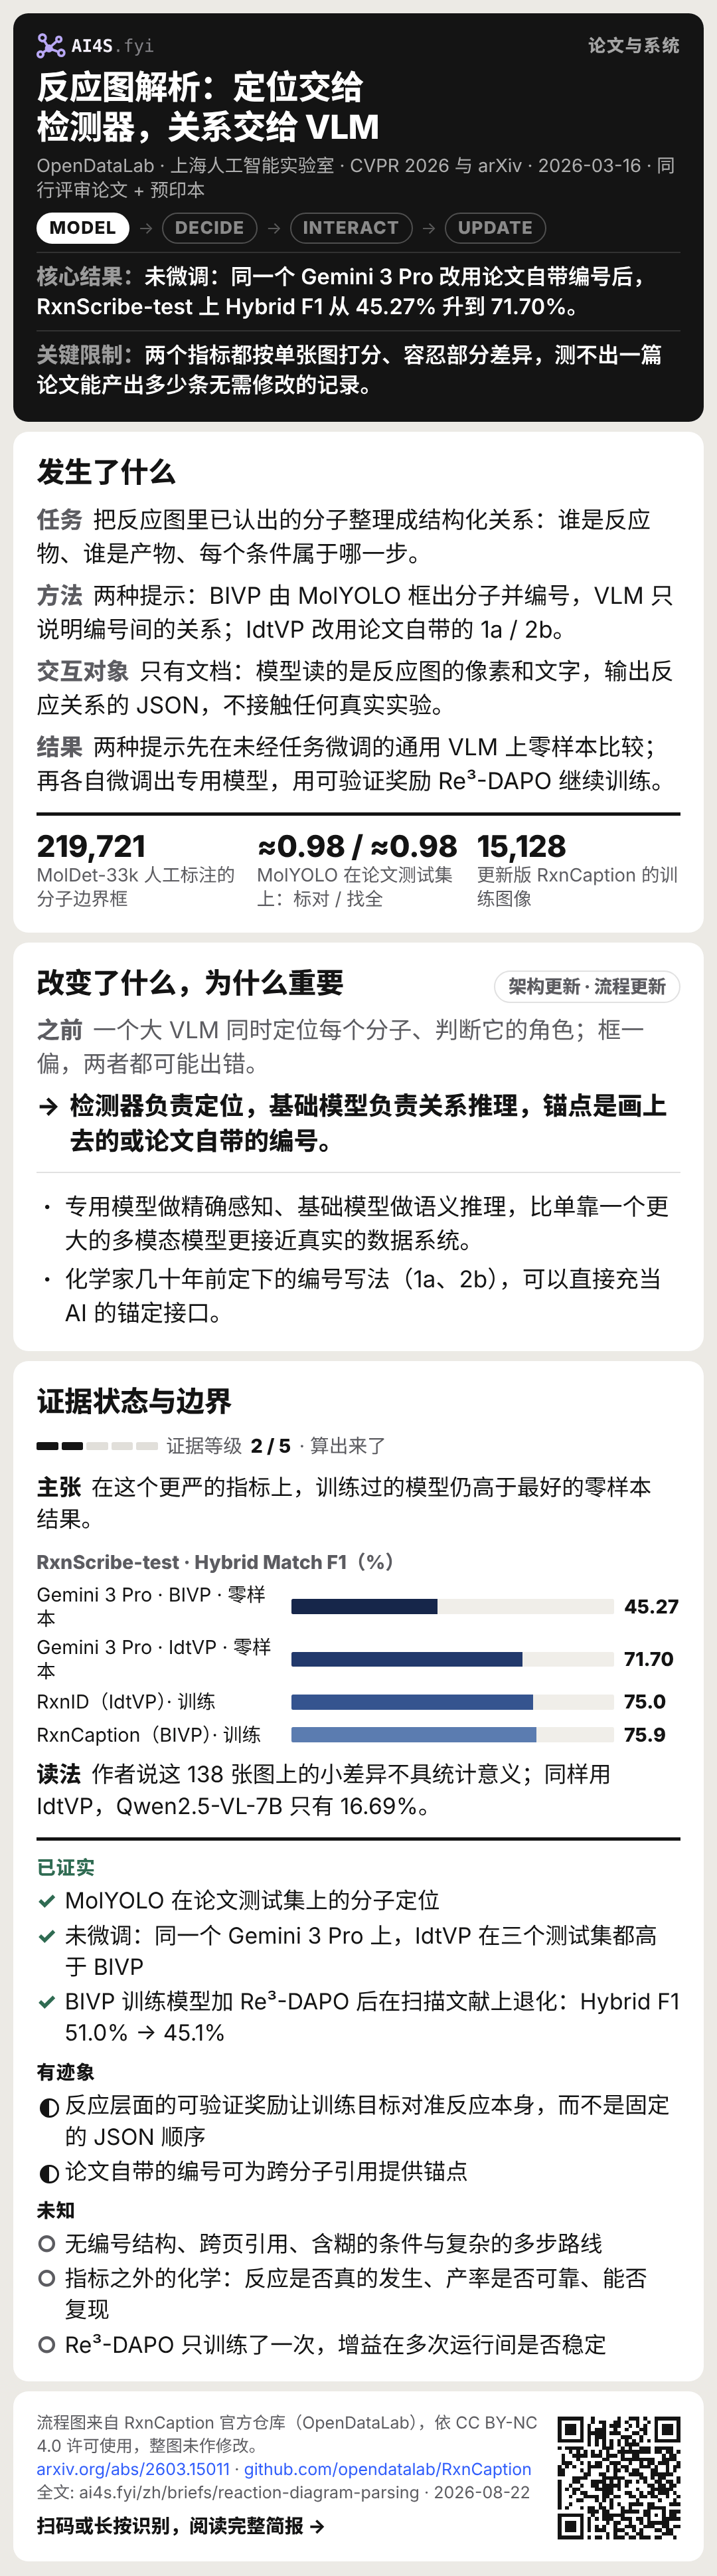
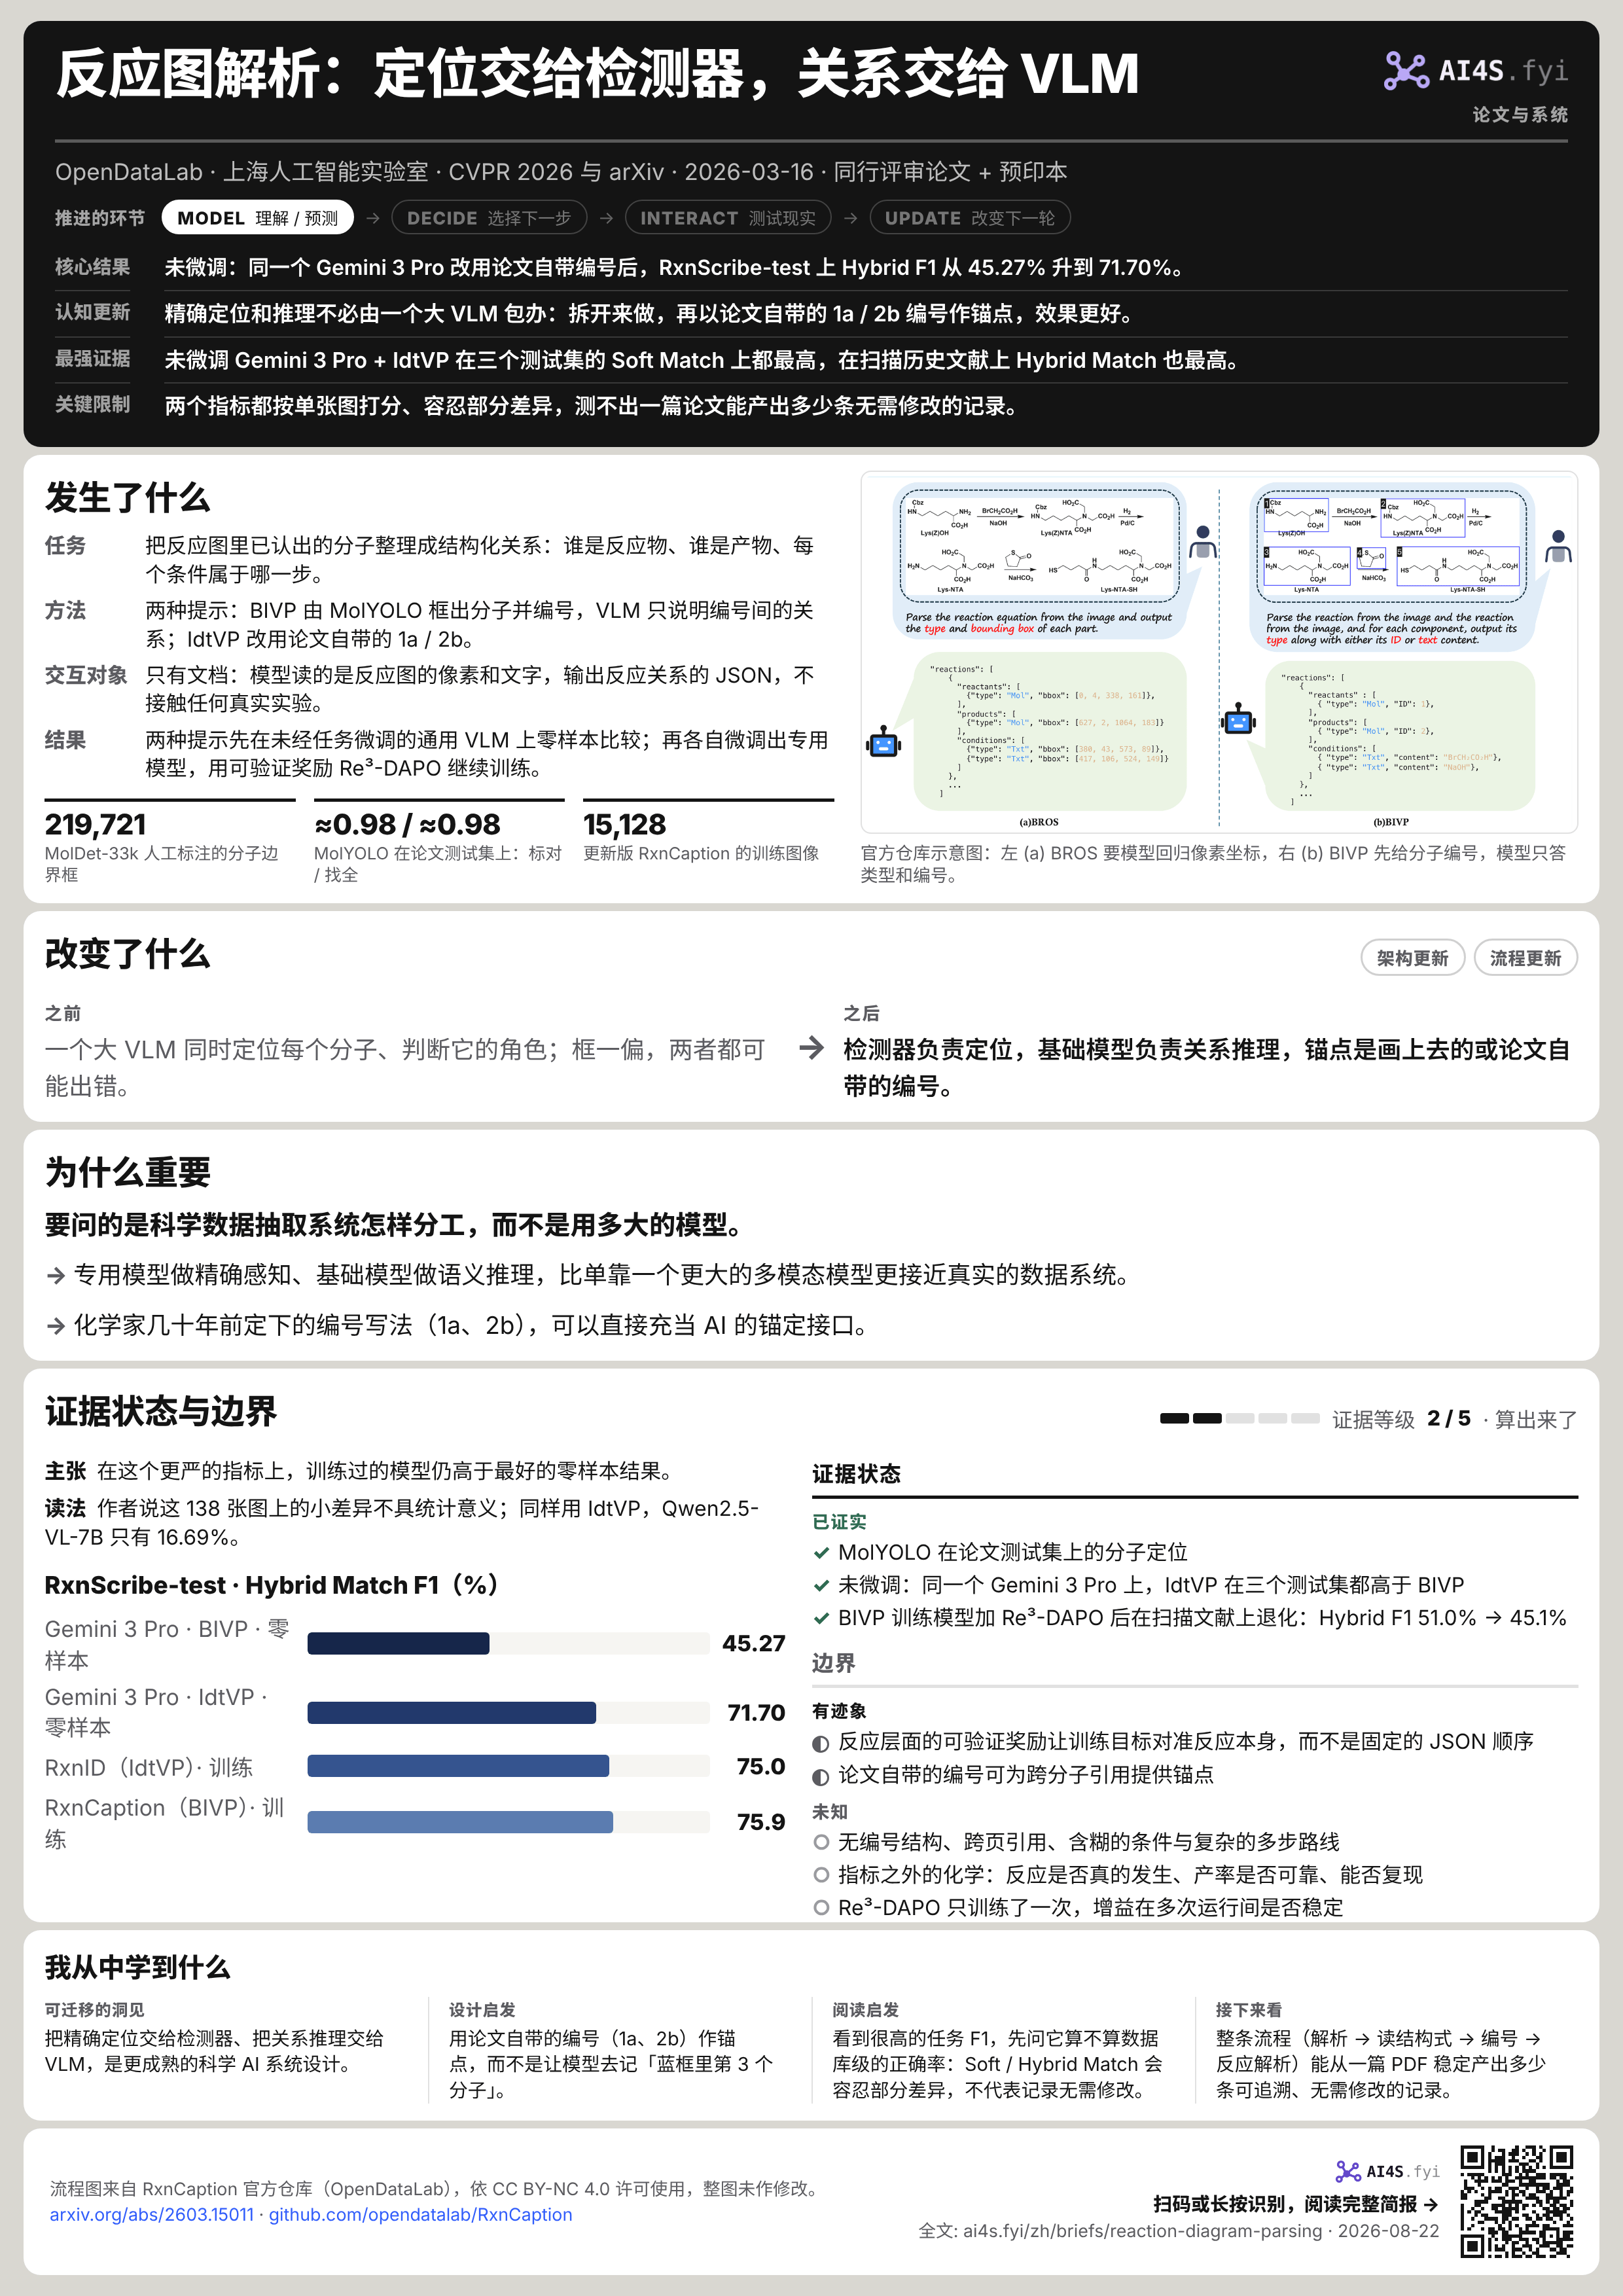
未微调:同一个 Gemini 3 Pro 改用论文自带编号后,RxnScribe-test 上 Hybrid F1 从 45.27% 升到 71.70%。
- 认知更新
- 精确定位和推理不必由一个大 VLM 包办:拆开来做,再以论文自带的 1a / 2b 编号作锚点,效果更好。
- 最强证据
- 未微调 Gemini 3 Pro + IdtVP 在三个测试集的 Soft Match 上都最高,在扫描历史文献上 Hybrid Match 也最高。
- 关键限制
- 两个指标都按单张图打分、容忍部分差异,测不出一篇论文能产出多少条无需修改的记录。
01发生了什么
- 任务
- 把反应图里已认出的分子整理成结构化关系:谁是反应物、谁是产物、每个条件属于哪一步。
- 方法
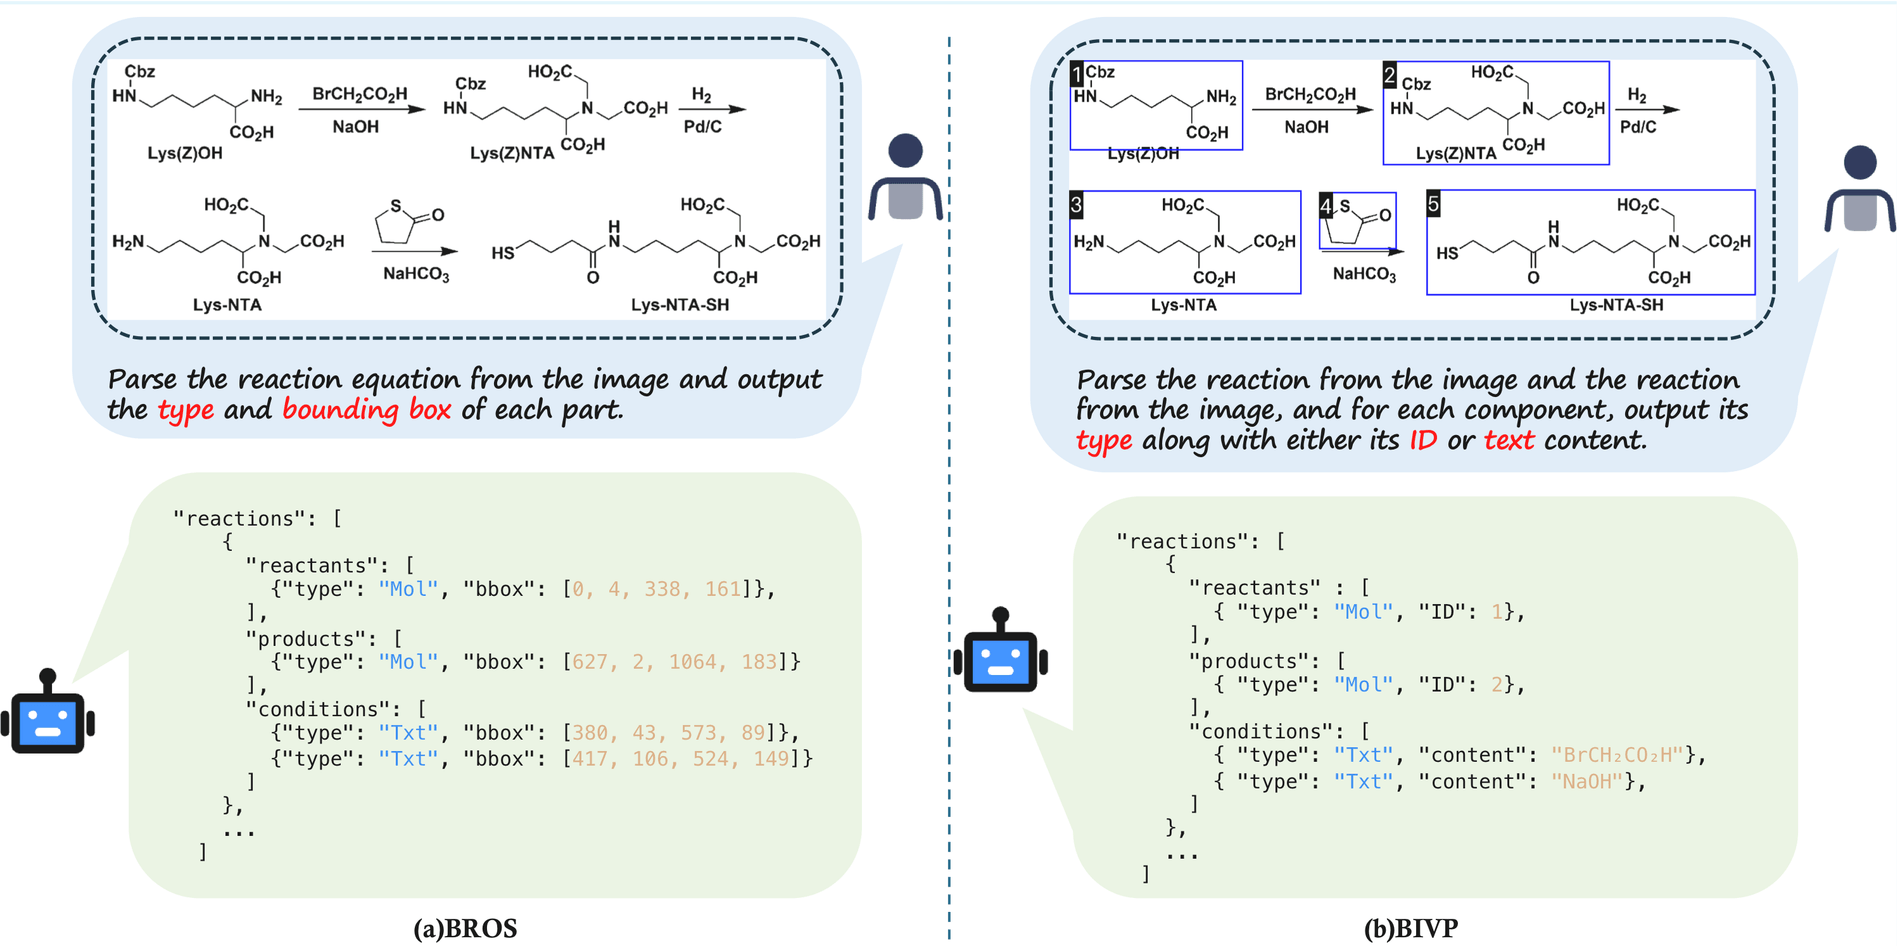
- 两种提示:BIVP 由 MolYOLO 框出分子并编号,VLM 只说明编号间的关系;IdtVP 改用论文自带的 1a / 2b。
- 交互对象
- 只有文档:模型读的是反应图的像素和文字,输出反应关系的 JSON,不接触任何真实实验。
- 结果
- 两种提示先在未经任务微调的通用 VLM 上零样本比较;再各自微调出专用模型,用可验证奖励 Re³-DAPO 继续训练。
219,721MolDet-33k 人工标注的分子边界框
≈0.98 / ≈0.98MolYOLO 在论文测试集上:标对 / 找全
15,128更新版 RxnCaption 的训练图像
认出分子之后,还要还原整条路线
前两篇分别讲了化学 PDF 的整条解析流程,以及怎样把二维结构图还原成分子图。现在假设图里每个分子都已正确框出、结构也都认对了,新的麻烦才刚开始。[S4][S5]
左边两个分子是不是反应物?右边那个一定是产物吗?箭头旁写的 H2O2、Amberlite IR 120H、溶剂和温度属于哪一步?一张图里有五六条箭头,还有分支和回环时,它们怎样拼成一条完整的合成路线?
反应图解析要同时读懂分子、文字、空间布局以及它们之间的关系,才能生成数据库可以直接使用的反应记录。[S1]
真实的反应图,需要贴近实际分布的数据
用于分子检测的 MolDet-33k 人工标注了 219,721 个分子边界框,清理后包括 12,209 张页面级图像和 21,155 张图表级图像。更新后的 RxnCaption 数据则包含 15,128 张反应解析训练图像。[S1][S2]
变的不只是数据量。从左到右的简单单步反应,和一张有多行、分支、回环和树状依赖的全合成路线图,难度根本不在一个等级,所以数据集特意覆盖了不同布局。和这个系列前两篇一样,模型真正投入使用时,样本分布往往比数据总量更重要。[S1]
02改变了什么
架构更新流程更新一个大 VLM 同时定位每个分子、判断它的角色;框一偏,两者都可能出错。
检测器负责定位,基础模型负责关系推理,锚点是画上去的或论文自带的编号。
别让一个大模型同时干两种活
最直接的做法,是把整张反应图交给 VLM,让它既找出每个分子的位置,又判断各自的角色。可大型 VLM 擅长的是理解画面在说什么,未必擅长精确回归一长串像素坐标;框稍一偏,分子身份和反应关系都可能跟着乱。[S1]
RxnCaption 的办法很工程化:先用专门的 MolYOLO 找出分子,在图上画框并编号;VLM 不再猜坐标,只描述这些编号对象之间的关系。任务从“找出产物的精确坐标,再判断它是什么”,变成了“1 号和 2 号是反应物,3 号是产物,箭头旁的文字是条件”。[S1][S2]
作者称之为 BIVP(BBox and Index as Visual Prompt,把边界框和编号画上去作视觉提示)。看上去只是“先画框”,背后却是一种成熟的科学 AI 系统设计:专用模型负责精确感知,基础模型去做它更擅长的语义推理。[S1]
论文里本来就有 1a、2b,何必重新编号?
BIVP 解决了坐标问题,代价是改动了原图。RxnID 提出更自然的 IdtVP:直接把原图里的化合物编号当作视觉与语义上的抓手。论文正文会写“compound 1a was converted to 2b”,模型也就可以直接说“1a → 2b”,不必去记“蓝框里的第 3 个分子”。[S3]
1a、2b 本来只是化学论文的排版习惯,对多模态模型来说却成了天然的锚点。在论文的零样本实验中,Gemini 3 Pro + IdtVP 在 RxnScribe-test 上的 Hybrid Match F1 为 71.70%,Soft Match F1 为 88.11%;在扫描的历史文献 ScannedRxn 上,零样本 Soft Match F1 为 86.5%。这几个数跨了两个指标、两个数据集,不能直接比高低。[S3]
这些数字不是说“86.5% 的反应图完全正确”。Soft Match 只看分子框(IoU > 0.5),忽略文字、把条件并入反应物;Hybrid Match 更严,分子框之外还要求条件文字的归一化编辑距离 ≤ 0.2。两者都会容忍一部分差异,不等于数据库记录无需修改的比例。[S3]
现实里,很多分子根本没有编号
编号好用,却不是白送的标准答案。中间体可能没有编号,同一个 7 可能在另一张图里再次出现,编号可能离结构很远;有些化合物只在正文里被称作 compound 7,图上并没有标。[S3]
所以 RxnID 加了 Mid-Mapper:带编号的分子尽量直接对应,没有编号的补一个虚拟编号,让下游模型照样能引用。到这一步,问题已经从“读一张图”转向“理解整篇文档”,跨页引用的解析会成为新的瓶颈。[S3]
03为什么重要
要问的是科学数据抽取系统怎样分工,而不是用多大的模型。
- 专用模型做精确感知、基础模型做语义推理,比单靠一个更大的多模态模型更接近真实的数据系统。
- 化学家几十年前定下的编号写法(1a、2b),可以直接充当 AI 的锚定接口。
04证据状态与边界
证据等级 2 / 5 · 算出来了 · 回顾性或模拟证据状态
已证实
- MolYOLO 在论文测试集上的分子定位
- 未微调:同一个 Gemini 3 Pro 上,IdtVP 在三个测试集都高于 BIVP
- BIVP 训练模型加 Re³-DAPO 后在扫描文献上退化:Hybrid F1 51.0% → 45.1%
边界
有迹象
- 反应层面的可验证奖励让训练目标对准反应本身,而不是固定的 JSON 顺序
- 论文自带的编号可为跨分子引用提供锚点
未知
- 无编号结构、跨页引用、含糊的条件与复杂的多步路线
- 指标之外的化学:反应是否真的发生、产率是否可靠、能否复现
- Re³-DAPO 只训练了一次,增益在多次运行间是否稳定
主张在这个更严的指标上,训练过的模型仍高于最好的零样本结果。
RxnScribe-test · Hybrid Match F1(%)
读法作者说这 138 张图上的小差异不具统计意义;同样用 IdtVP,Qwen2.5-VL-7B 只有 16.69%。
论文自带编号比画上去的编号强多少
RxnID 的零样本对比(Table 1)把三种视觉提示放在同一个 Gemini 3 Pro 上:在 RxnScribe-test 上,直接给原图、让模型回归坐标的 BROS 只有 3.90% Hybrid Match F1,生成不出有效的图结构;画框编号的 BIVP 为 45.27%;改用论文自带编号的 IdtVP 为 71.70%。在更难的 RxnCaption-15k-test 上,三者依次为 4.92%、47.40%、58.30%。但同样的 IdtVP 放到小模型上,Qwen2.5-VL-7B 只有 16.69%,Intern-S1 为 44.71%。作者的解读是:要做到高精度的零样本解析,有效的视觉引导和基础模型的强推理能力缺一不可。[S3]
零样本提示和训练过的模型,要分开看
论文里其实有两类实验。一类是提示实验:Gemini 3 Pro、GPT-4o、Qwen2.5-VL-7B 等通用 VLM 没有针对这项任务微调,只换视觉提示(Table 1 与 Table 3 下半部分)。另一类是训练:用 BIVP 或 IdtVP 格式的数据先做少量 SFT 冷启动,再用 Re³-DAPO 强化学习继续训练,得到 RxnCaption 和 RxnID(Table 3 上半部分)。Table 3 同时列出两类,按同一数据集、同一指标对比:Soft Match 上零样本的 Gemini 3 Pro + IdtVP 在三个测试集都最高(88.1% / 78.2% / 86.5%);更严的 Hybrid Match 上,它只在扫描文献 ScannedRxn 上最高(59.3%,RxnID+RL 为 56.3%),在 RxnScribe-test 上低于 RxnCaption+RL 的 75.9% 和 RxnID+RL 的 75.0%(71.7%),在 RxnCaption-15k-test 上低于 RxnID+RL 的 64.4%(58.3%)。[S3]
为什么还要用可验证奖励
反应解析最后常常输出 JSON,但一个反应并不是只有一种正确顺序的字符串。两个并列反应物谁先写,不改变化学;互不相关的几个反应在 JSON 里换个顺序,也不算错。普通的 next-token 损失却会因为序列化顺序不同,惩罚语义上正确的答案。[S3]
RxnID 的 Re³-DAPO 把奖励提到整组反应关系的层面,评判方式接近 Hybrid / Soft Match,而不是逐个 token 要求完全一致;两个并列反应物换了顺序,不会因为写法不同被判错。值得注意的不只是用了强化学习,而是训练目标对准了科学对象本身:真正的反应关系,而不是固定格式的 JSON。在分布内测试集上它确有提升,例如 RxnCaption-15k-test 上 RxnID 的 Hybrid F1 从 61.2% 升到 64.4%,BIVP 模型从 59.8% 升到 64.1%;但到扫描文献上,BIVP 模型加 RL 后反而从 51.0% 降到 45.1%,作者说它常陷入重复输出的循环。RL 只训练了一次(8 张 H200 约 70 小时),论文没有做多次运行的方差分析。[S3]
可验证奖励也有边界。箭头被裁掉、条件看不清,或者编号跨页对不上时,模型照样可能生成格式漂亮的 JSON。奖励能检查输出是否符合标注规则,却不能替化学家证明反应真的发生过、产率可靠、条件可以复现。
这组基准说明反应图解析确实有明显进步,但没有回答最现实的文档级问题:一整篇论文进了系统,最后有多少条反应记录能不经人工修改直接入库?上游分子检测、OCSR、OCR、图像裁切和编号匹配的错误,都会传到这一层。[S1][S3][S4]
Hybrid / Soft Match 是针对任务的评测,不等于科学上的正确。反应图解析能抽出“A + B → C,条件 X”,却验证不了实验是否真的成功、产率是否可靠、机理是否正确、结果能否复现。它解决的是信息抽取,不是化学验证。
05我从中学到什么
- 可迁移的洞见
- 把精确定位交给检测器、把关系推理交给 VLM,是更成熟的科学 AI 系统设计。
- 设计启发
- 用论文自带的编号(1a、2b)作锚点,而不是让模型去记「蓝框里第 3 个分子」。
- 阅读启发
- 看到很高的任务 F1,先问它算不算数据库级的正确率:Soft / Hybrid Match 会容忍部分差异,不代表记录无需修改。
- 接下来看
- 整条流程(解析 → 读结构式 → 编号 → 反应解析)能从一篇 PDF 稳定产出多少条可追溯、无需修改的记录。
基础模型不该包办一切
把精确定位交给检测器,让 VLM 专心做关系推理,是更成熟的系统设计。
科学记号也能成为 AI 的接口
1a 和 2b 原本只是论文里的编号习惯,如今成了多模态模型很好用的锚定接口。
训练目标要对准真正的反应关系
反应是一张图或一个集合,不是必须按固定顺序输出的字符串。
最终要看整条流程产出多少可用数据
用户需要的不是检测器 98%、OCSR 93%,再加一个漂亮的解析 F1,而是一篇 PDF 最后能留下多少条高可信、可追溯、无需修改的记录,修好剩余错误又要花多久。
把三篇放回同一条链上
通用解析器先找到化学区域,OCSR 把图片还原成分子图,化合物编号把结构和上下文连起来,反应解析器再恢复反应物、产物、条件和关系。单独一个 93% 或 98% 说明不了整套系统好不好,最终要看文献能否稳定变成高质量、可追溯、机器可用的数据。
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。