

论文与系统· 科学证据 · Frontier
化学 PDF 如何变成 AI 可用的数据?MinerU.Chem 在文档解析之后再加一层“化学解析”
上海人工智能实验室 OpenDataLab 的 MinerU.Chem 把整篇化学论文转成可追溯、可核对、程序能接着处理的数据,既包括分子结构图与 SMILES,也包括化合物编号和反应关系。
●技术报告 + 公开系统 + 模块评测
当前边界:整篇文档的端到端正确率尚未报告
这项工作推进的是:把化学论文读成可追溯的结构化数据
- MODEL理解 / 预测
- DECIDE选择下一步
- INTERACT测试现实
- UPDATE改变下一轮
系列导读
MinerU.Chem 系列|从化学 PDF 到机器可用的反应数据
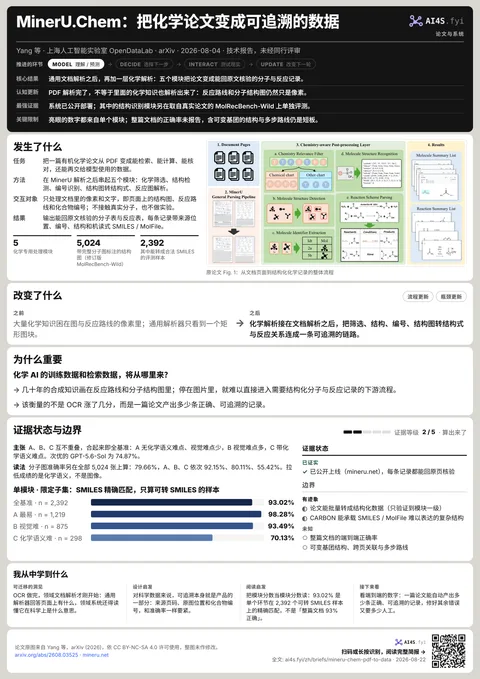
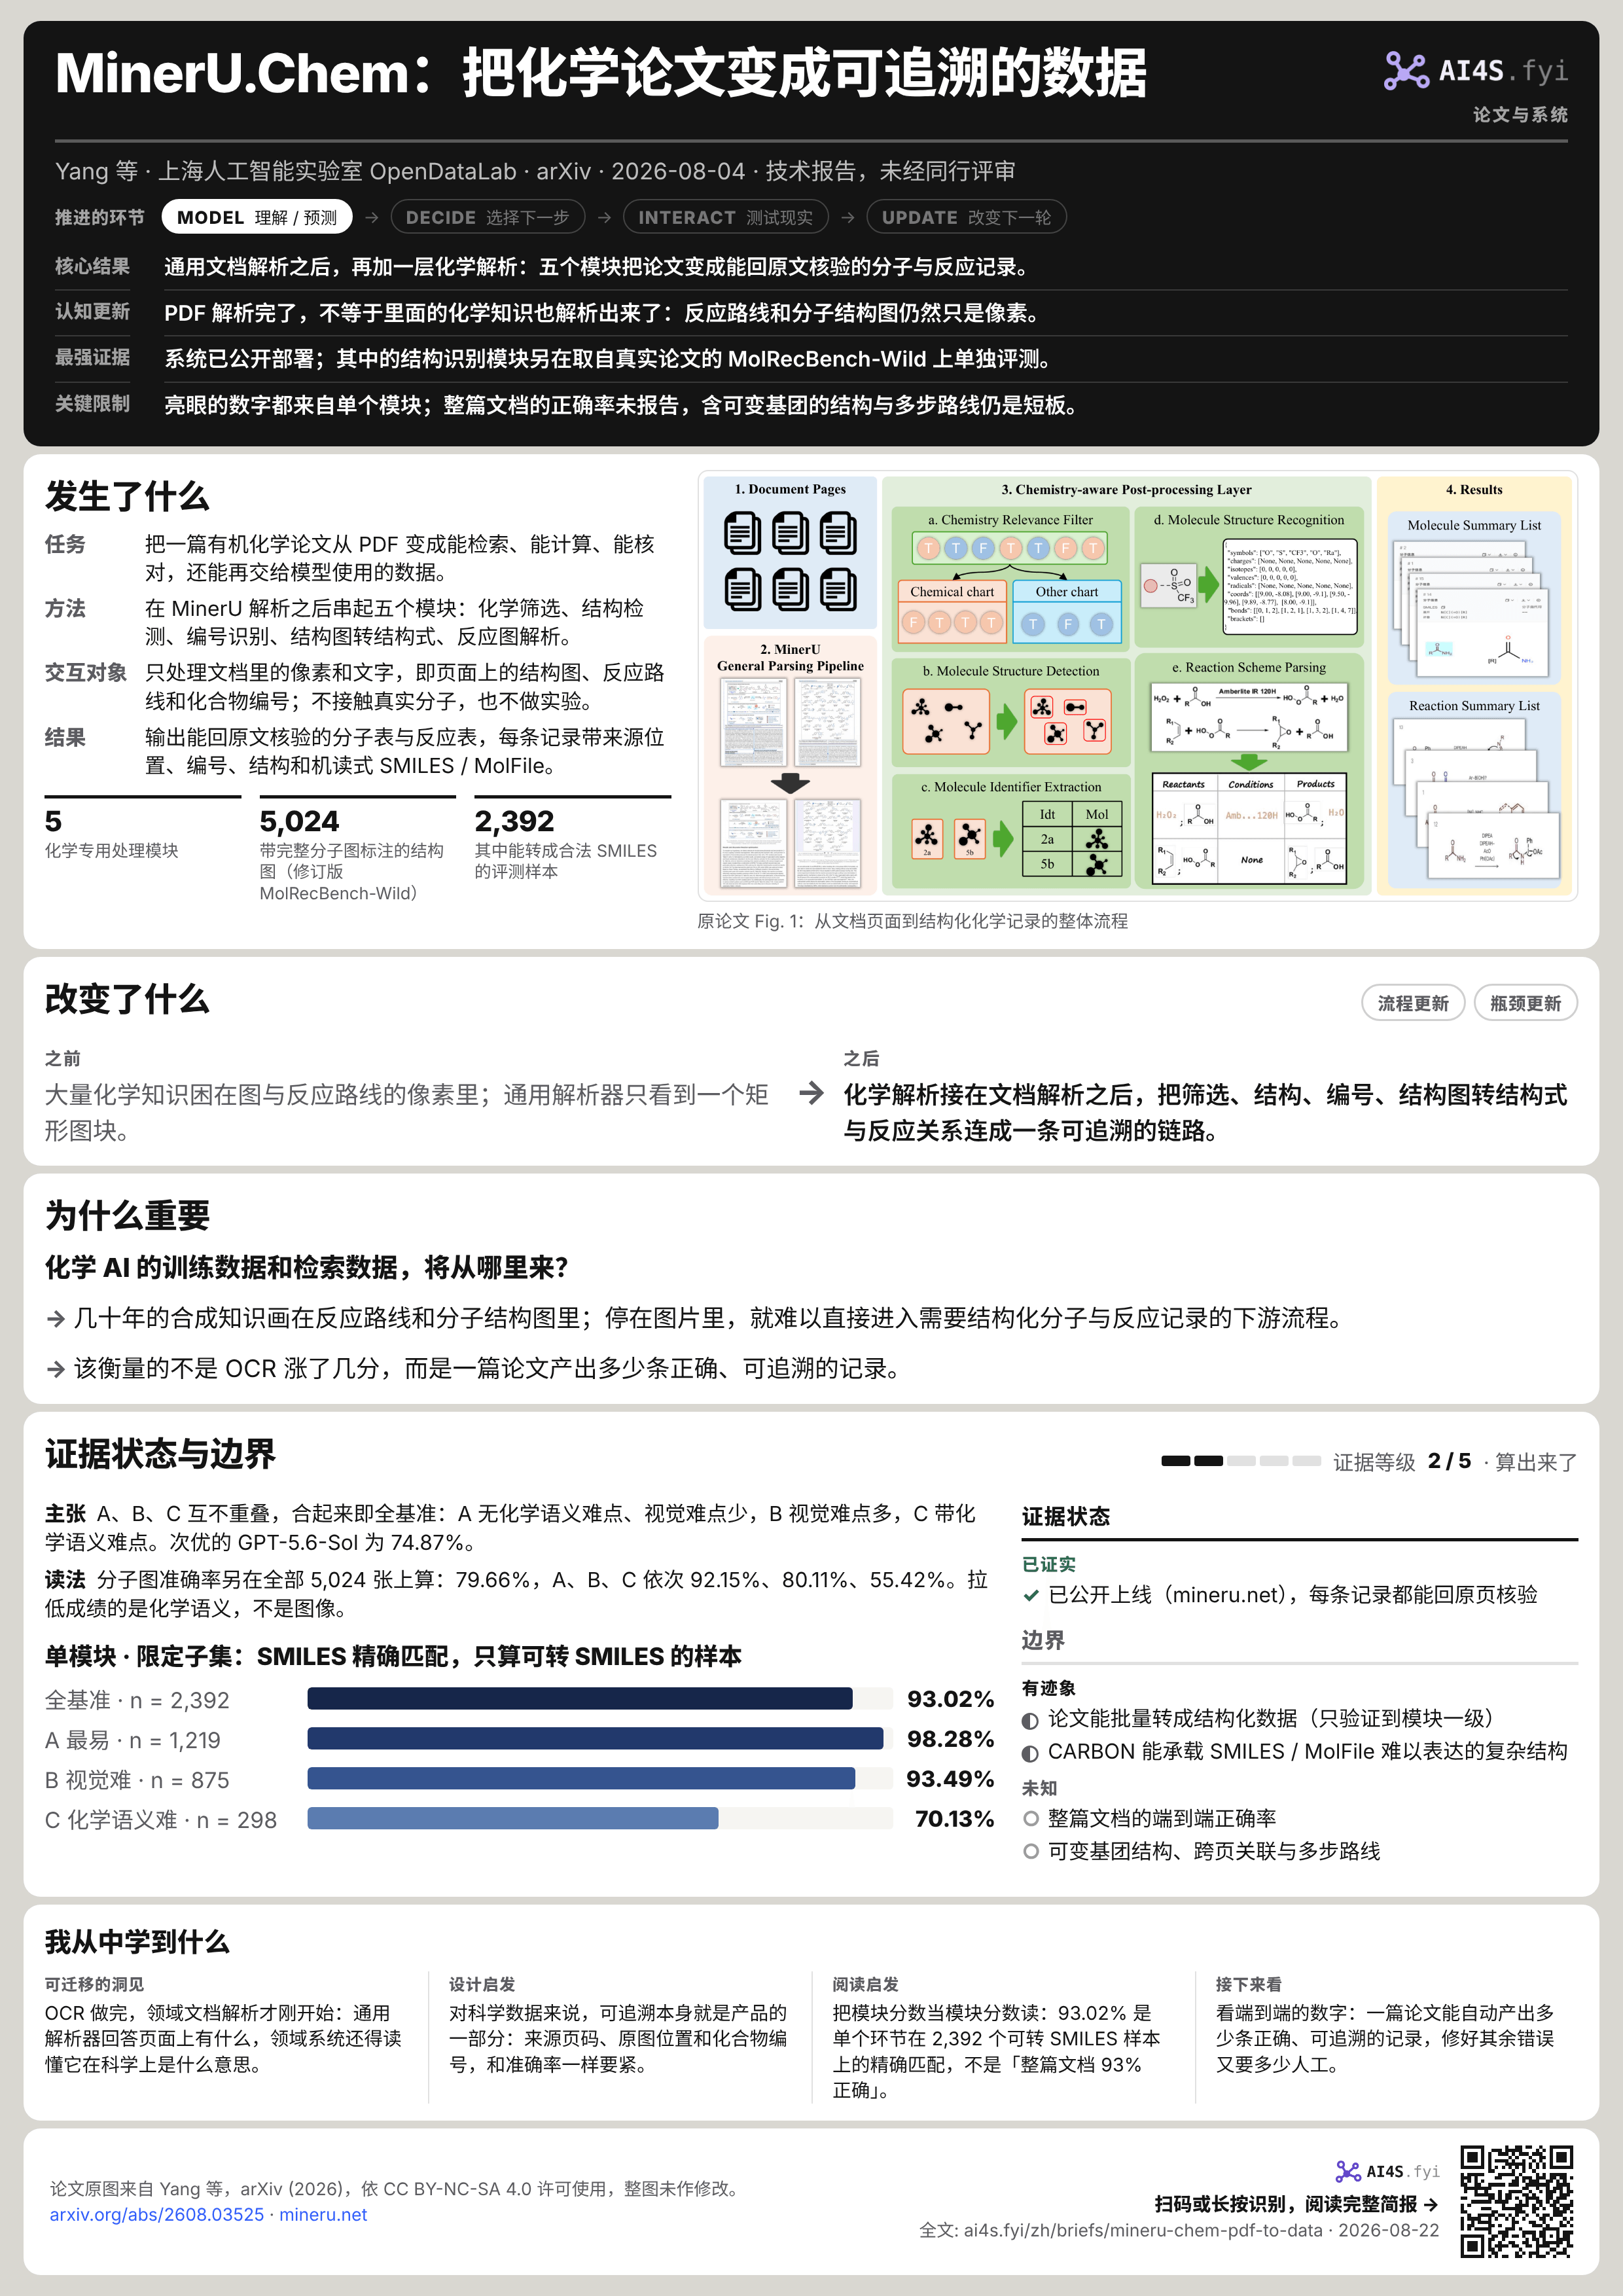
通用文档解析之后,再加一层化学解析:五个模块把论文变成能回原文核验的分子与反应记录。
- 认知更新
- PDF 解析完了,不等于里面的化学知识也解析出来了:反应路线和分子结构图仍然只是像素。
- 最强证据
- 系统已公开部署;其中的结构识别模块另在取自真实论文的 MolRecBench-Wild 上单独评测。
- 关键限制
- 亮眼的数字都来自单个模块;整篇文档的正确率未报告,含可变基团的结构与多步路线仍是短板。
01发生了什么
- 任务
- 把一篇有机化学论文从 PDF 变成能检索、能计算、能核对,还能再交给模型使用的数据。
- 方法
- 在 MinerU 解析之后串起五个模块:化学筛选、结构检测、编号识别、结构图转结构式、反应图解析。
- 交互对象
- 只处理文档里的像素和文字,即页面上的结构图、反应路线和化合物编号;不接触真实分子,也不做实验。
- 结果
- 输出能回原文核验的分子表与反应表,每条记录带来源位置、编号、结构和机读式 SMILES / MolFile。
5化学专用处理模块
5,024带完整分子图标注的结构图(修订版 MolRecBench-Wild)
2,392其中能转成合法 SMILES 的评测样本
上海人工智能实验室 OpenDataLab 团队发布了 MinerU.Chem 技术报告,合作作者来自华东师范大学、同济大学、复旦大学、上海交通大学和北京大学等机构。它要回答一个很具体的问题:一篇有机化学论文进了系统,怎样才能从 PDF 变成能检索、能计算、能核对,甚至能再交给模型使用的数据?[S1]
通用的 PDF 解析器已经能找出标题、段落、公式和表格,化学论文却还多出一层。同一张反应路线图,化学家看得到底物、产物、催化剂、温度和步骤先后;在通用文档系统眼里,它很可能只是一个矩形图片块。[S1]
PDF 解析完了,不等于其中的化学知识也解析了。MinerU.Chem 补的正是文档解析(document parsing)之后缺的那一层:化学解析(chemistry parsing)。
不是一个模型,而是一条流水线
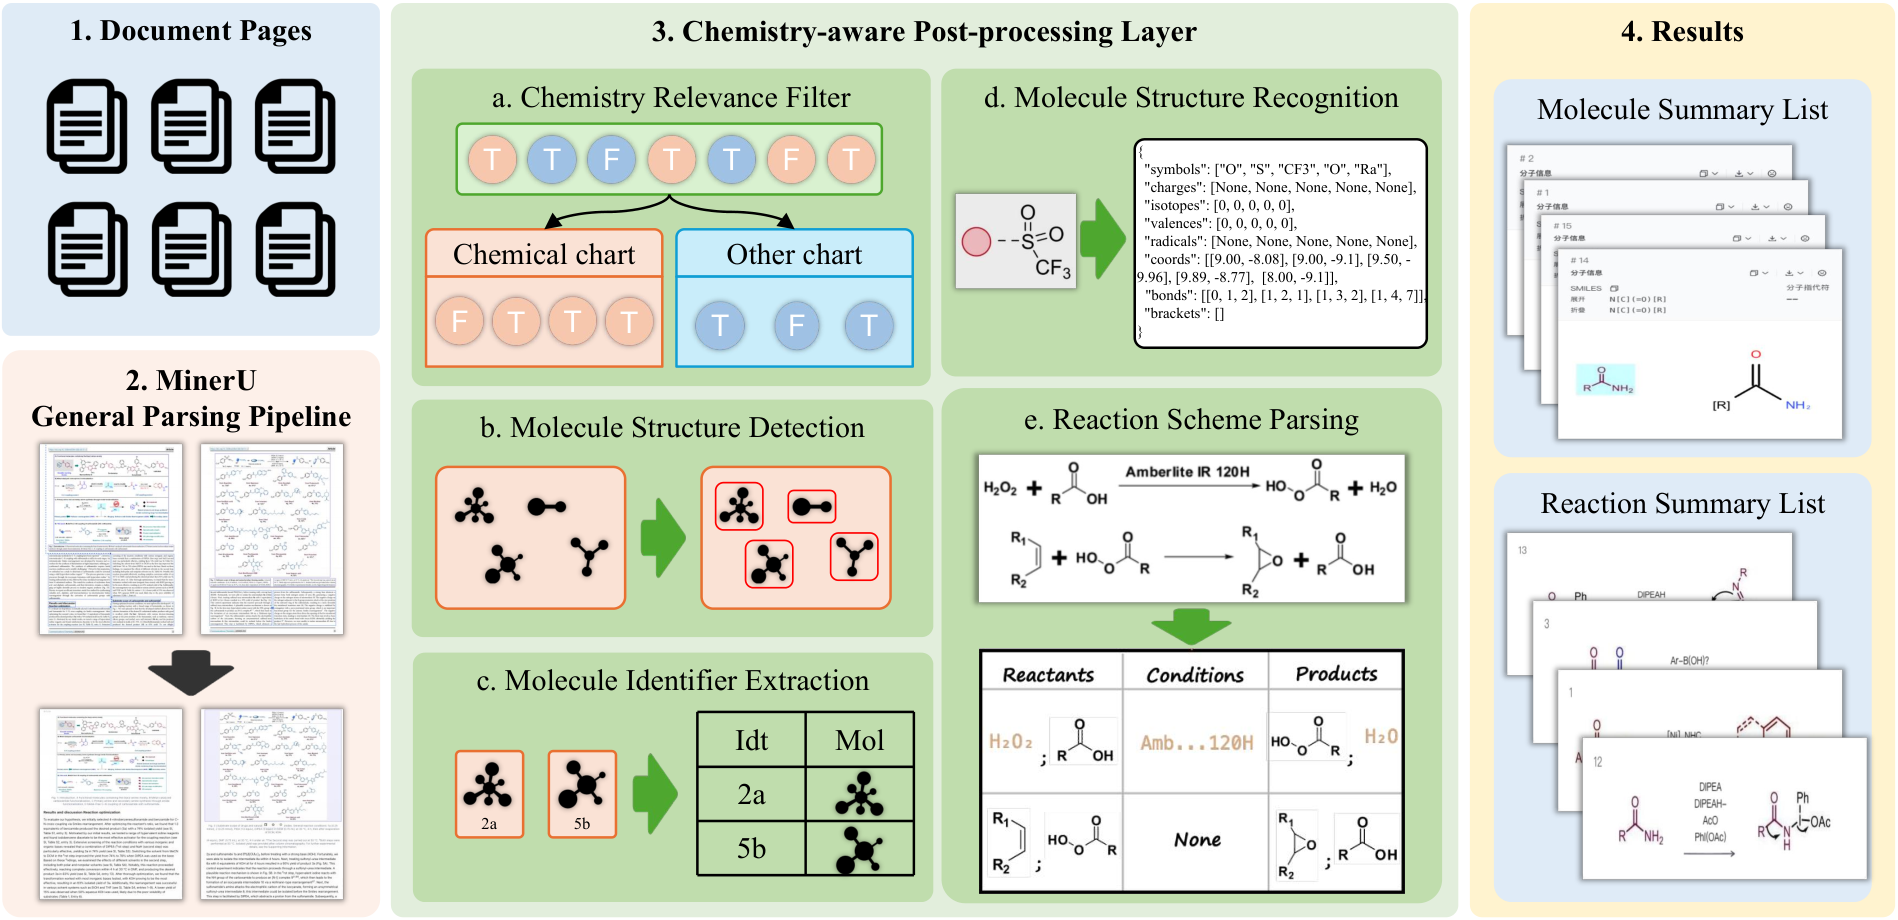
MinerU.Chem 没有让一个模型从整页 PDF 一步生成反应数据库,而是把问题拆成一串前后依赖的模块。MinerU 先做通用的页面解析;化学专用部分再判断每张图或表是否真与化学有关,免得把显微照片和普通图表也送进成本更高的专用模型。[S1]
接着,系统先定位分子结构图,再在附近找 1a、2b、compound 7 这类化合物编号,把图里的结构和正文里的叫法对上。到第四步才轮到 OCSR(光学化学结构识别):把二维结构图还原成分子图,导出 MolFile、SMILES 等机器可读格式。[S1]
最后一步解析反应图:哪些分子是反应物、哪些是产物,箭头旁的文字是试剂、溶剂还是温度,几条箭头又构成几步连续反应。五个环节接起来,系统才从认图片走到产出结构化的化学数据。[S1][S3]
只认出 SMILES,却不知道它在论文里叫 2b 还是 7c,事后就很难回原图核验;找出了所有分子,却没有还原反应关系,得到的仍是一叠分子卡片,而不是一条合成路线。
02改变了什么
流程更新瓶颈更新大量化学知识困在图与反应路线的像素里;通用解析器只看到一个矩形图块。
化学解析接在文档解析之后,把筛选、结构、编号、结构图转结构式与反应关系连成一条可追溯的链路。
光有 SMILES 为什么不够
真实论文里的结构远比教科书上的 SMILES 复杂:化学家会直接写 Ph、Et、Bu,会画 Markush 片段、聚合物重复单元、波浪键、配位键和非常规价态。如果图里写的是 Ph,系统为了得到标准 SMILES 把它展开成完整的苯环,输出也许在化学上合法,却已经不忠实于原图。[S2][S1]
CARBON 除了原子和化学键,还保存二维坐标、缩写,以及普通 SMILES 难以承载的复杂属性,再由这个信息更全的中间表示导出常用格式。要紧的是原则而不是格式名:先如实记下论文里画了什么,标准化放在后面。[S2][S1]
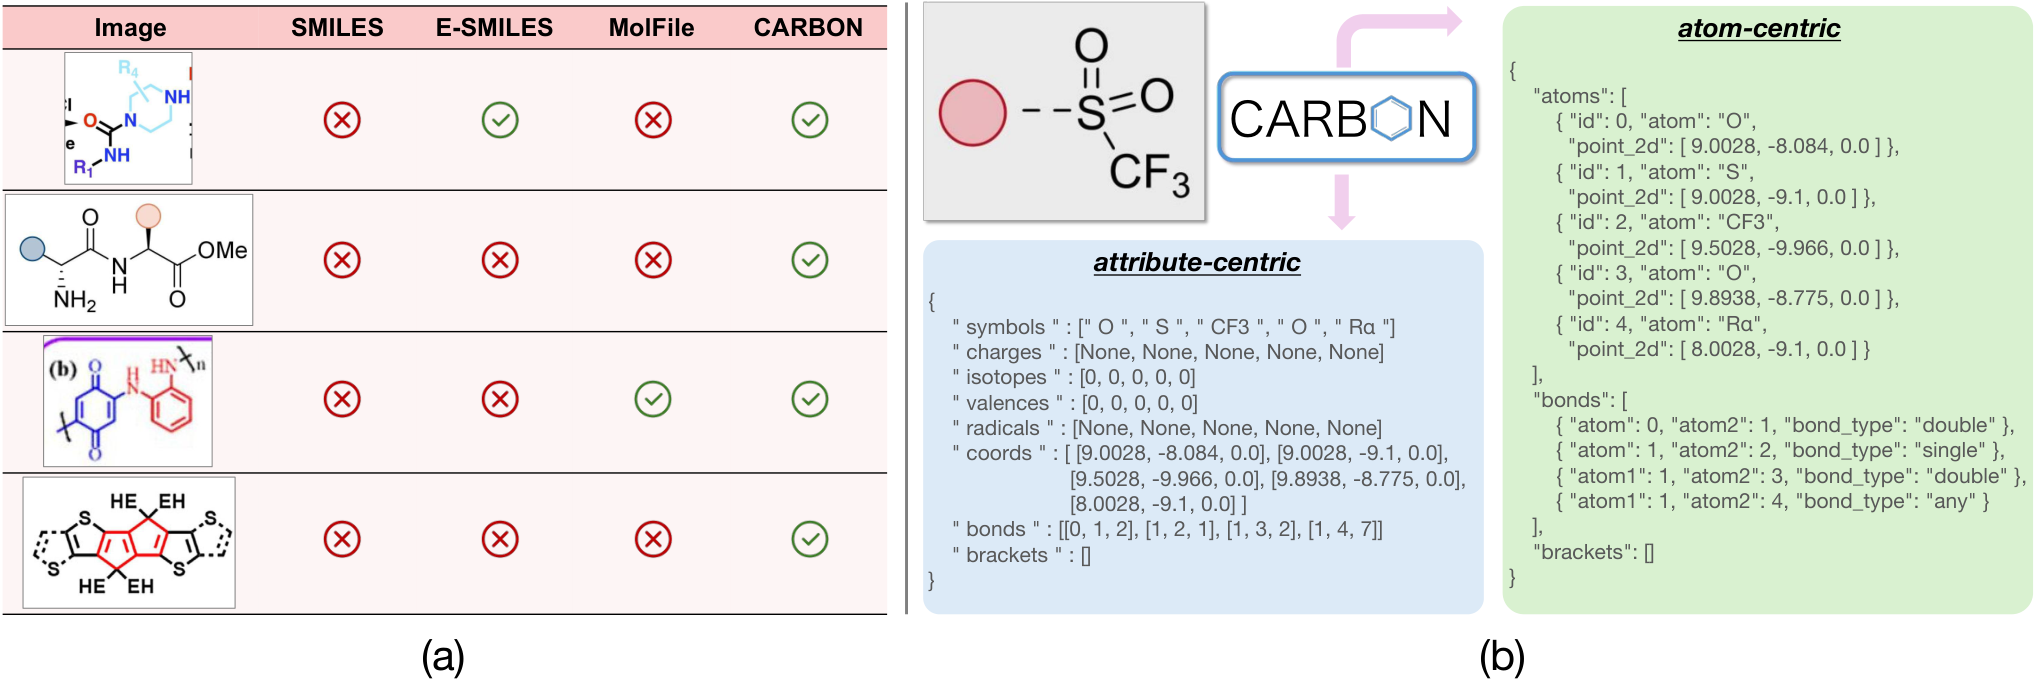
论文 Fig. 4。左侧比较几种表示能否承载 Markush、非常规键与重复结构;右侧展示 CARBON 如何同时保存原子、键、属性与二维坐标。Yang et al., arXiv (2026),CC BY-NC-SA 4.0。 [S1]
03为什么重要
化学 AI 的训练数据和检索数据,将从哪里来?
- 几十年的合成知识画在反应路线和分子结构图里;停在图片里,就难以直接进入需要结构化分子与反应记录的下游流程。
- 该衡量的不是 OCR 涨了几分,而是一篇论文产出多少条正确、可追溯的记录。
更值得问的不是 AI OCR 又涨了几分,而是化学 AI 的训练数据从哪里来。过去几十年的合成知识大多沉在论文、补充材料和专利里,而且常常画在反应路线和分子结构图中。多模态模型能读图,但只要它们还是图片,就难以直接进入需要结构化分子与反应记录的下游流程:反应预测、逆合成、条件建模和新的化学基础模型的训练数据,都要的是后者。
MinerU.Chem 想缩短的,是给人读的文献与机器能用的科学数据之间的距离。难点不只在于大规模跑模型,而在于抽取结果和来源追溯要同时保住。
04证据状态与边界
证据等级 2 / 5 · 算出来了 · 回顾性或模拟证据状态
已证实
- 已公开上线(mineru.net),每条记录都能回原页核验
边界
有迹象
- 论文能批量转成结构化数据(只验证到模块一级)
- CARBON 能承载 SMILES / MolFile 难以表达的复杂结构
未知
- 整篇文档的端到端正确率
- 可变基团结构、跨页关联与多步路线
主张A、B、C 互不重叠,合起来即全基准:A 无化学语义难点、视觉难点少,B 视觉难点多,C 带化学语义难点。次优的 GPT-5.6-Sol 为 74.87%。
单模块 · 限定子集:SMILES 精确匹配,只算可转 SMILES 的样本
读法分子图准确率另在全部 5,024 张上算:79.66%,A、B、C 依次 92.15%、80.11%、55.42%。拉低成绩的是化学语义,不是图像。
分子汇总表(Molecule Summary List)为每个分子保存来源位置、化合物编号、结构表示和 MolFile / SMILES。反应汇总表(Reaction Summary List)再把反应物、产物和反应条件组织起来,并链接回已识别的分子记录。[S1]
值得注意的不是 JSON 格式本身,而是可追溯:每条记录都保留来源位置。立体化学认错了,审核的人仍能回到对应页面和原始框选区域检查。一段通顺的摘要错了,很难查出错在哪;带来源位置的结构化记录,至少可以抽查、重新标注和修正。[S1]
不妨把 MinerU.Chem 看成给 PDF 加了一层化学证据索引。
最容易读错的数字是 93.02%。它不是“整篇化学论文有 93.02% 解析正确”,也不是全部 5,024 张结构图的成绩,只是分子结构识别这一个模块、在其中 2,392 个能转成合法 SMILES 的样本上的 SMILES 精确匹配率。它前面还有结构检测和编号匹配,后面还有反应解析和文档级关联;多个模块串起来之后的端到端正确率,是另一回事。[S1]
在同一基准上,报告还测了三类对照系统:专用 OCSR 工具与经过化学微调的视觉语言模型、商用化学 OCR 服务、通用多模态大模型。结构识别模块全面领先;排第二的 GPT-5.6-Sol SMILES 精确匹配为 74.87%,低 18.15 个百分点。报告又按 MOSAIC 难度标签把基准分成三个互斥子集,视觉与化学语义难度逐级升高:最易的子集上 SMILES 精确匹配 / 分子图准确率为 98.28% / 92.15%,视觉更难的子集为 93.49% / 80.11%,带化学语义难点标签的子集为 70.13% / 55.42%。至于分子图准确率领先次优系统多少,报告引言写 43.25 个百分点,结果部分写 42.1,前后不一致,这里不引用。[S1]
两种指标的分母不同。SMILES 精确匹配只能在有合法 SMILES 标注的样本上算:全基准 2,392 个,A、B、C 依次 1,219、875、298 个;含 Markush 结构、非常规缩写或违反价键规则等情况的结构转不成合法 SMILES,所以被排除。分子图准确率在全部 5,024 张上算,A、B、C 依次 1,987、1,976、1,061 张。三个子集互不重叠,合起来就是整个基准。版本也要分清:MolRecBench-Wild 论文首版报告的是取自 820 篇论文的 5,029 张结构图;MinerU.Chem 用的是最新修订版,5,024 张全部带分子图标注;2,392 是其中能转成 SMILES 的评测子集。[S1][S2]
这是一份技术报告,系统也已上线,但目前最亮眼的定量结果集中在单个模块,而不是整篇文档的端到端抽取。一个化合物编号配错,或一条反应条件挂到了相邻的箭头上,都可能生成格式合法、内容却错误的数据库记录。[S1]
复杂 Markush 结构、R 基团、跨页关联和多步路线仍是明显的短板。眼下它更适合做大规模的第一遍处理,再把难例交给人工复核。关键指标是:一篇论文能自动产出多少条正确记录,修好其余错误又要花多少人工。[S1]
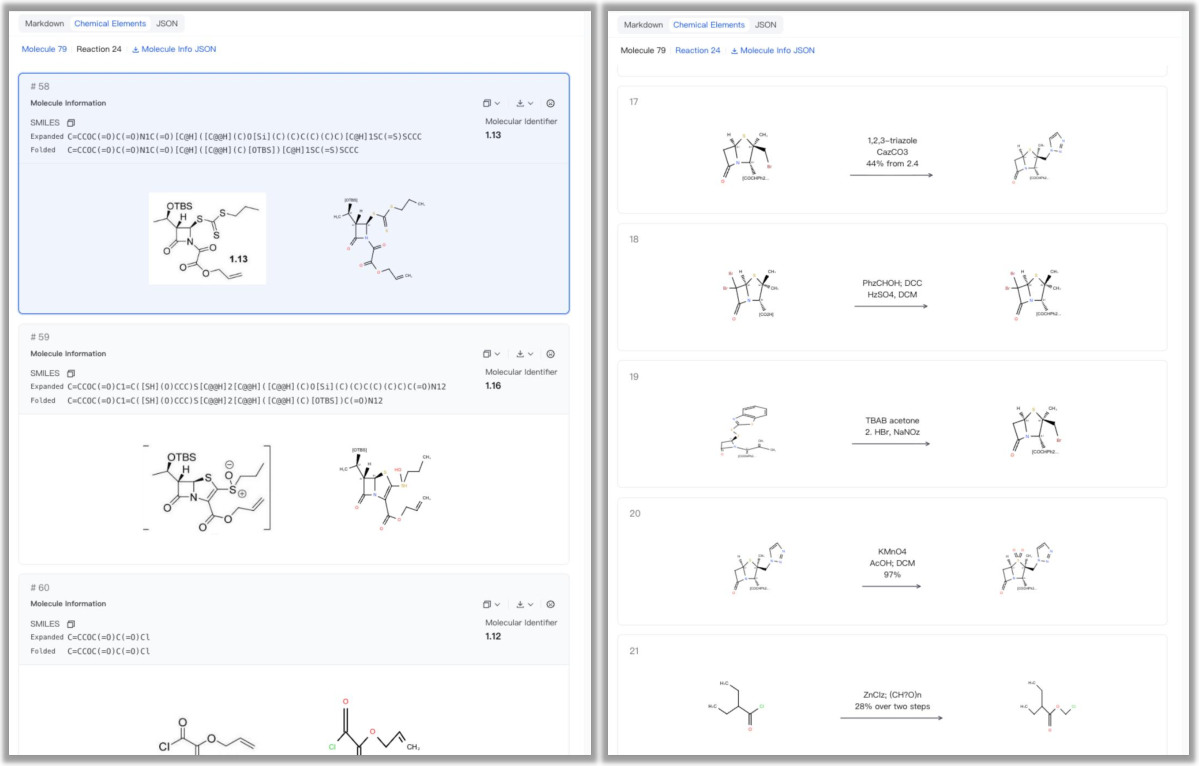
论文 Fig. 2。最终输出是一套可回原文核验的证据索引,而不是摘要:每条记录都保存 SMILES、编号、原图与识别结构,连续反应步骤也整理成可回查的记录;识别错了能回到原页和框选区域核对。Yang et al., arXiv (2026),CC BY-NC-SA 4.0。 [S1]
05我从中学到什么
- 可迁移的洞见
- OCR 做完,领域文档解析才刚开始:通用解析器回答页面上有什么,领域系统还得读懂它在科学上是什么意思。
- 设计启发
- 对科学数据来说,可追溯本身就是产品的一部分:来源页码、原图位置和化合物编号,和准确率一样要紧。
- 阅读启发
- 把模块分数当模块分数读:93.02% 是单个环节在 2,392 个可转 SMILES 样本上的精确匹配,不是「整篇文档 93% 正确」。
- 接下来看
- 看端到端的数字:一篇论文能自动产出多少条正确、可追溯的记录,修好其余错误又要多少人工。
科学文档解析从 OCR 收尾处起步
化学论文里的反应路线是一张图结构,材料论文里可能有相图,生物论文里可能有通路图。通用解析器回答页面上有什么,领域系统还要弄懂这些内容在科学上意味着什么。
科学数据既要准确,也要能追溯来源
一个错误的立体中心悄无声息地进了训练数据库,和聊天机器人说错一句话不是一回事。来源页码、原图位置和化合物编号看上去不怎么像 AI,却是科学数据系统的核心基础设施。
最有用的自动化,往往不是无人值守
让机器先做大规模抽取,把人的时间留给复杂 Markush、低置信度结构和跨页关联,可能比执着于“完全自动”更有价值。
大量文献知识还没变成 AI 能用的数据
模型变强以后,瓶颈未必总在网络结构。很多高价值的科学知识,也许只是还没变成模型和程序能用的数据。
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。