

论文与基准· 科学证据 · Frontier
AI 为什么容易认错分子结构图?论文里的结构图比专利基准难得多
上海人工智能实验室 OpenDataLab 的出发点是:OCSR 在 USPTO 等专利基准上早已拿到高分,论文里的结构图却同时考验视觉识别和化学表达,图像再清楚,常用的分子表示也未必装得下图里的化学语义。
◐真实论文基准 + 技术报告评测
当前边界:验证仍局限于一个经过挑选的真实论文基准,对专利、老旧扫描件和复杂 Markush 结构覆盖不足
这项工作推进的是:从真实论文图像恢复分子结构
- MODEL理解 / 预测
- DECIDE选择下一步
- INTERACT测试现实
- UPDATE改变下一轮
系列导读
MinerU.Chem 系列|从化学 PDF 到机器可用的反应数据
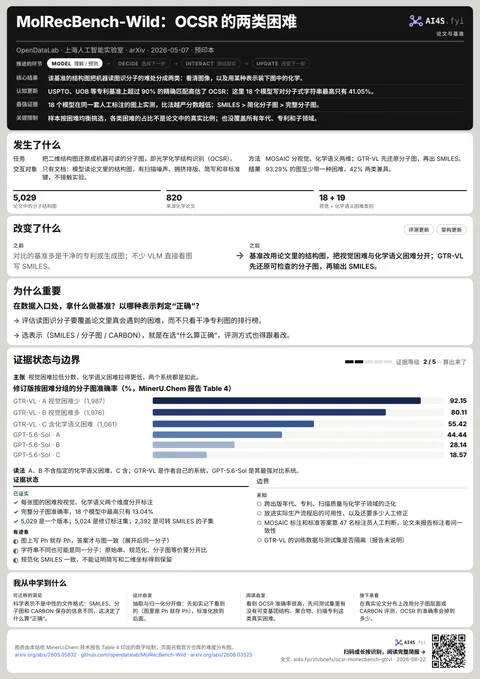
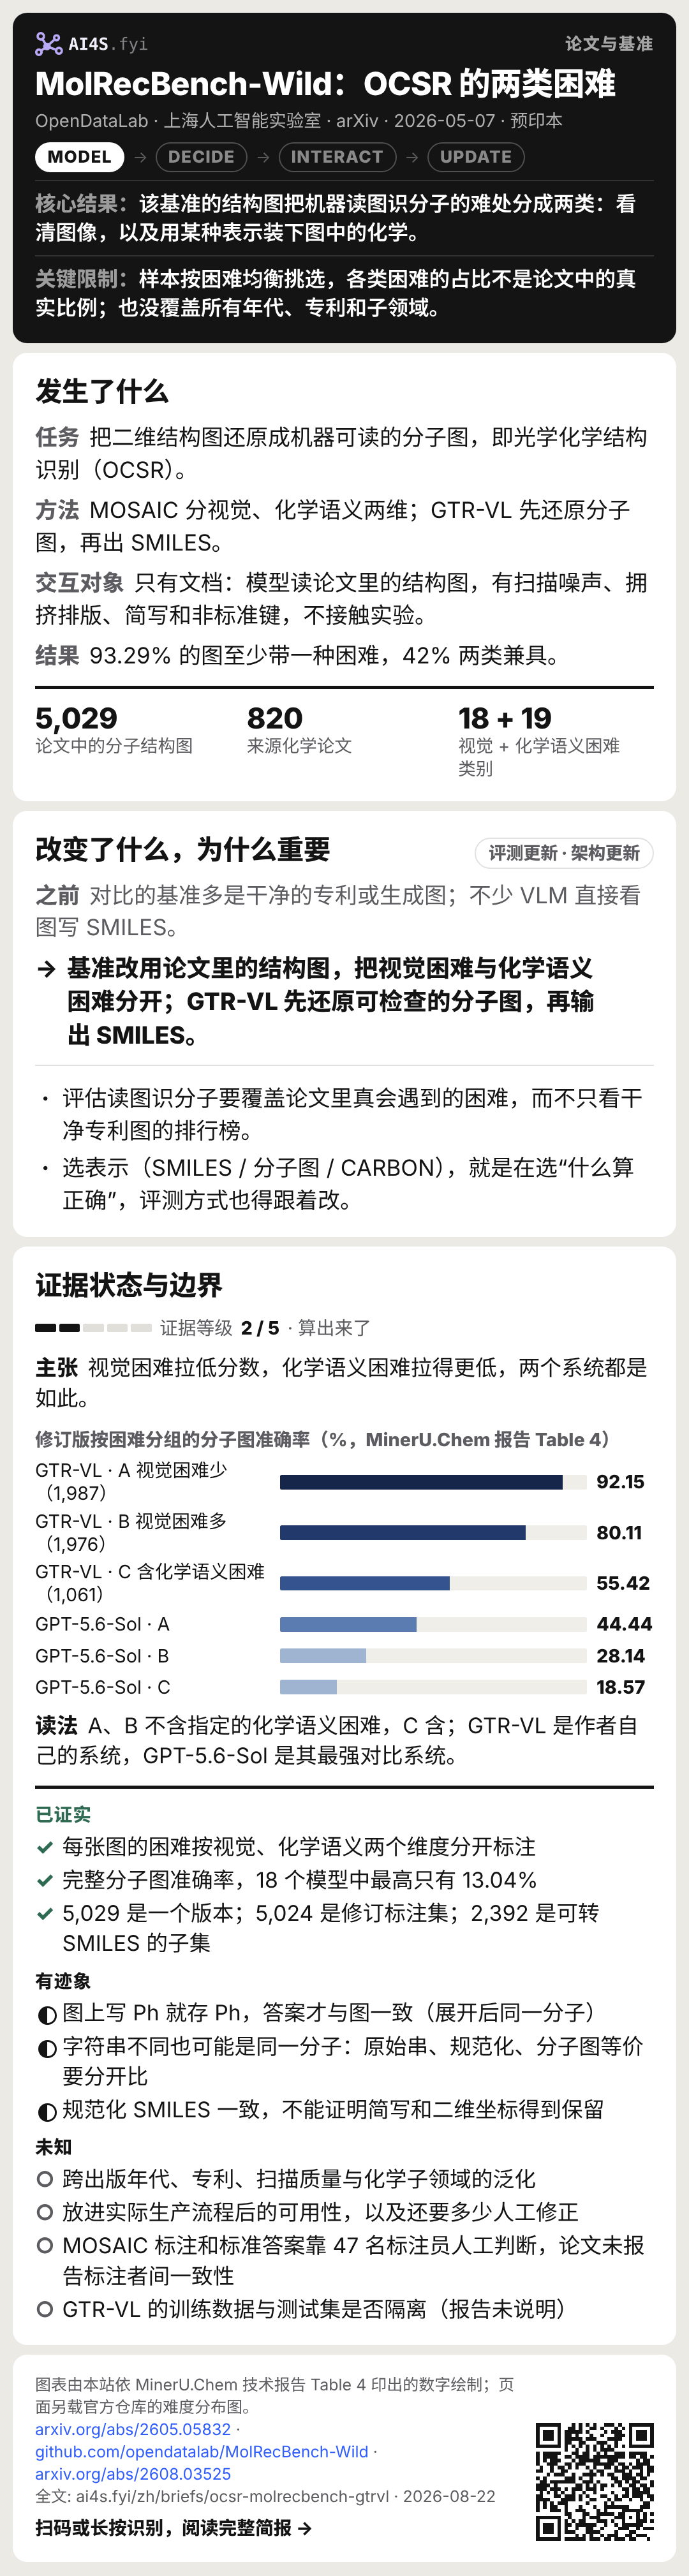
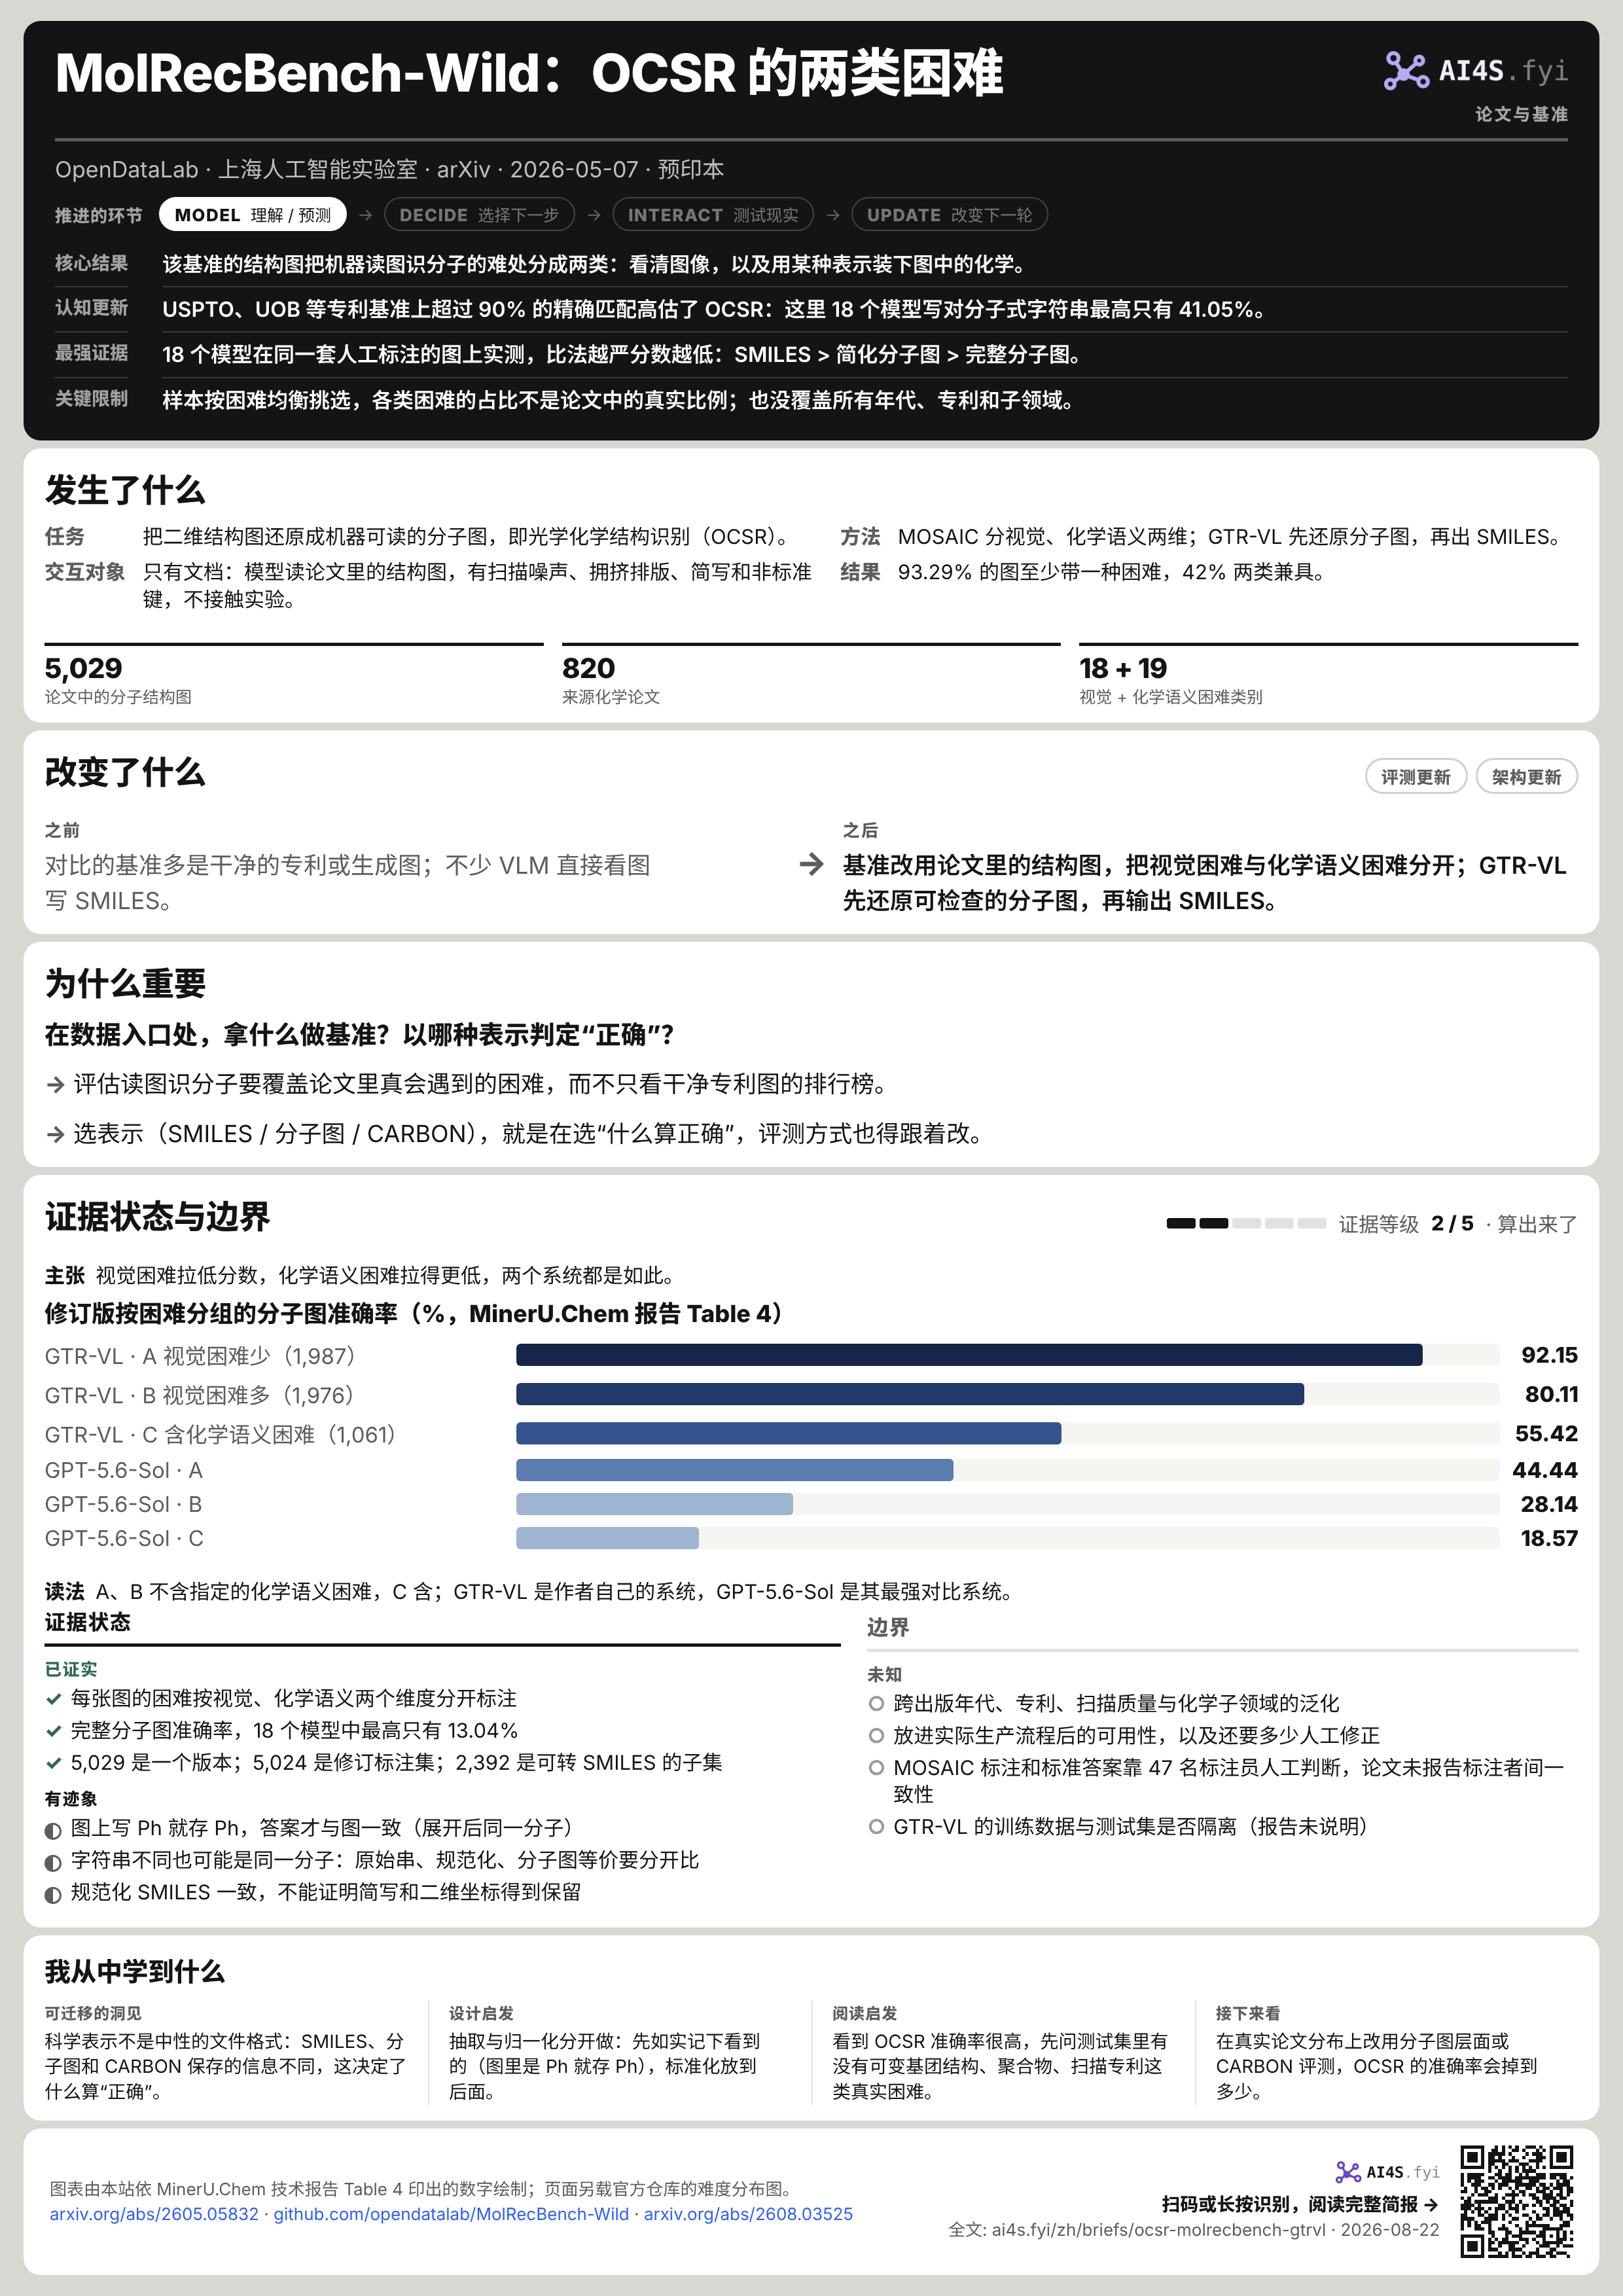
该基准的结构图把机器读图识分子的难处分成两类:看清图像,以及用某种表示装下图中的化学。
- 认知更新
- USPTO、UOB 等专利基准上超过 90% 的精确匹配高估了 OCSR:这里 18 个模型写对分子式字符串最高只有 41.05%。
- 最强证据
- 18 个模型在同一套人工标注的图上实测,比法越严分数越低:SMILES > 简化分子图 > 完整分子图。
- 关键限制
- 样本按困难均衡挑选,各类困难的占比不是论文中的真实比例;也没覆盖所有年代、专利和子领域。
01发生了什么
- 任务
- 把二维结构图还原成机器可读的分子图,即光学化学结构识别(OCSR)。
- 方法
- MOSAIC 分视觉、化学语义两维;GTR-VL 先还原分子图,再出 SMILES。
- 交互对象
- 只有文档:模型读论文里的结构图,有扫描噪声、拥挤排版、简写和非标准键,不接触实验。
- 结果
- 93.29% 的图至少带一种困难,42% 两类兼具。
5,029论文中的分子结构图
820来源化学论文
18 + 19视觉 + 化学语义困难类别
上一篇跟着一份化学 PDF 走完了 MinerU.Chem 的整条流水线。这一篇只看其中最难的一环:把二维分子结构图还原成机器可读的分子图,也就是光学化学结构识别(Optical Chemical Structure Recognition,OCSR)。[S4]
论文举的例子是 MolGrapher 和 MolParser:它们在 USPTO、UOB 等基准上的精确匹配准确率都超过 90%,只看排行榜,很容易以为这个任务快做完了。作者指出,DECIMER、CLEF、Staker、USPTO、JPO 这类常用基准大多取自专利或自动生成的图像,画法标准、背景干净、分辨率高、噪声少。论文里的结构图不是这样:扫描噪声、模糊键线和拥挤排版,还只是第一类困难。[S1]
第二类困难性质完全不同:图片很清楚,模型照样会错,因为图里画的是非标准键、特殊价态、自由基、配位结构、Markush 结构、聚合物重复单元,或者简写成 Ph 的基团。一张结构图可能难在视觉,可能难在化学语义,也可能两样都难。[S1]
02改变了什么
评测更新架构更新对比的基准多是干净的专利或生成图;不少 VLM 直接看图写 SMILES。
基准改用论文里的结构图,把视觉困难与化学语义困难分开;GTR-VL 先还原可检查的分子图,再输出 SMILES。
把两种“难”分开来看
MolRecBench-Wild 的 MOSAIC 框架把 OCSR 的困难拆成两个维度。视觉一侧包括低分辨率、扫描噪声、拥挤排版、文字压在结构图上,以及模糊或断开的键线,考的是模型能不能稳定地“看清”。[S1]
化学语义一侧的困难,像素再清楚也照样存在:特殊价态、自由基、配位结构、缩写、Markush 与聚合物的表示。问题从“看没看清”变成了“用什么表示来表达看到的化学”。[S1]
数据来自 7 种化学期刊约 820 篇 CC BY 4.0 论文。团队先从候选图中初筛出约 6,548 张,人工标注 MOSAIC 困难,再按标注挑出 5,029 张,让样本在“视觉困难数 × 化学困难数”的二维空间里分布均匀。37 类困难中 18 类属视觉,19 类属化学语义;该基准收集的结构图中 93.29% 至少带一种困难,42% 两类兼具。因为是按困难均衡挑选的,这两个比例描述的是这套基准,不是化学论文里结构图的真实比例。[S1]
在这套图上,论文评测了 18 个能做 OCSR 的模型,所有类别都明显下降:SMILES 准确率最高的是 MolScribe(41.05%),GTR-Mol-VLM 为 40.43%;更严的完整分子图指标上,最好的是 Gemini 2.5 Pro,只有 13.04%。每个模型都是 SMILES 高于简化分子图、简化分子图高于完整分子图,评测的严格程度本身就改变了分数。[S1]
直接看图写 SMILES,为什么会出错
GTR-VL 论文把现有方法分成两类。ChemVLM、ChemDFM-X、OCSU 等把 OCSR 当成给图片配说明文字(image captioning):输入一张分子图,直接生成一串 SMILES。MolGrapher、MolScribe、MolNexTR 等图解析方法则先预测原子、再预测化学键,拼出分子图。直接生成 SMILES 的问题在于:SMILES 是高度序列化的表达,一个原子、一根键或一处立体化学判断错,后面整串字符都可能跟着变;只给出最终字符串,也很难定位到底哪里看错了。[S3]
GTR-VL 也输出分子图,但不像以往图解析方法那样分两步:它沿着分子图交替生成原子和化学键,再走向下一个原子,中间明确经过一张分子图。这张中间图可以检查:结果错了,能定位到某个原子、某根键,甚至对回原图坐标。对要进数据库的数据来说,这比只知道“整串 SMILES 不匹配”有用得多。[S3][S4]
图里写的是 Ph,标准答案里为什么冒出一个苯环?
GTR-VL 论文指出,MolScribe、MolNexTR 的专利训练数据取自 MOL 文件,标准答案里的 Ph 已被完整展开成苯环。化学上这完全等价,展开本身不是错误;问题在于是否忠实保留原图的写法:图上只写了“Ph”,没画六元环,答案却要求模型输出一个。监督目标与图上画的东西对不上,模型会在该写缩写的地方去猜展开式。[S3]
GTR-VL 把这条原则概括为“看见什么,就如实识别什么”(Faithfully Recognize What You've Seen):原图写 Ph,就先把它作为超原子(superatom)保留,等到后续标准化时再展开。团队按这个思路整理了约 130 万条训练数据。这个标注细节背后是一条更普遍的数据原则:抽取和归一化不该挤在第一步一起做。[S3][S4]
03为什么重要
在数据入口处,拿什么做基准?以哪种表示判定“正确”?
- 评估读图识分子要覆盖论文里真会遇到的困难,而不只看干净专利图的排行榜。
- 选表示(SMILES / 分子图 / CARBON),就是在选“什么算正确”,评测方式也得跟着改。
这里要先分清版本:5,029 是 MolRecBench-Wild 原论文里基准的一个版本;5,024 是 MinerU.Chem 技术报告所用修订版中带分子图标注的集合;2,392 是其中能转成有效 SMILES、可按 SMILES 评测的子集。其余结构含 Markush、非常规缩写或违反价态规则的键,转不成有效 SMILES。三个数分母不同,不能混用。[S1][S4]
MolRecBench-Wild 的用意不是为难而出难题,而是把考场搬到模型真正要干活的地方。如果实际数据里满是 Markush、聚合物、缩写、扫描专利和拥挤的补充材料插图,测试集却只有画法标准、背景干净的图,那么 90% 以上的准确率也回答不了能不能用的问题。
OCSR 又恰好卡在化学数据流水线的入口。一根立体键看错,后面的反应解析、数据库构建、性质关联和模型训练都可能继承这个错误。最危险的往往不是非法的 SMILES,而是那些合法、看着正常、却和原图对不上的分子。
04证据状态与边界
证据等级 2 / 5 · 算出来了 · 回顾性或模拟证据状态
已证实
- 每张图的困难按视觉、化学语义两个维度分开标注
- 完整分子图准确率,18 个模型中最高只有 13.04%
- 5,029 是一个版本;5,024 是修订标注集;2,392 是可转 SMILES 的子集
边界
有迹象
- 图上写 Ph 就存 Ph,答案才与图一致(展开后同一分子)
- 字符串不同也可能是同一分子:原始串、规范化、分子图等价要分开比
- 规范化 SMILES 一致,不能证明简写和二维坐标得到保留
未知
- 跨出版年代、专利、扫描质量与化学子领域的泛化
- 放进实际生产流程后的可用性,以及还要多少人工修正
- MOSAIC 标注和标准答案靠 47 名标注员人工判断,论文未报告标注者间一致性
- GTR-VL 的训练数据与测试集是否隔离(报告未说明)
主张视觉困难拉低分数,化学语义困难拉得更低,两个系统都是如此。
修订版按困难分组的分子图准确率(%,MinerU.Chem 报告 Table 4)
读法A、B 不含指定的化学语义困难,C 含;GTR-VL 是作者自己的系统,GPT-5.6-Sol 是其最强对比系统。
连评测的尺子也可能把“对”判成“错”
同一个分子可以写成多条不同的 SMILES,所以要分清三种比法:原始字符串精确匹配、规范化(canonicalization)之后再比、以及直接比分子图是否等价。模型还原的分子图可能与标准答案完全相同,却因为遍历顺序、缩写展开方式或规范化不同,生成的原始字符串不一样,按字符串精确匹配就被判错;GTR-VL 论文还指出,MolScribe、MolNexTR 的评测把缩写替换成星号(*),这些部分等于没评。MolRecBench-Wild 的 SMILES 赛道比的是规范化后的序列,而且为了能比较,把标签里的非标准键简化成了普通键。反过来,两条规范化后的 SMILES 相同,也不代表模型如实保留了缩写、二维坐标和非标准语义。[S1][S3]
按困难分组看分数
MinerU.Chem 技术报告按 MOSAIC 标注把修订版基准分成三个互不重叠的子集:A 不含指定的化学语义困难、视觉困难也较少(1,987 张);B 同样不含化学语义困难,但视觉困难更多(1,976 张);C 含指定的化学语义困难(1,061 张)。报告里自家的 GTR-VL-1.4.13 分子图准确率依次为 92.15%、80.11%、55.42%;SMILES 最好的对比系统 GPT-5.6-Sol 为 44.44%、28.14%、18.57%。两类困难各自拉低分数,化学语义那一类拉得更多。注意 GTR-VL 的训练数据含按 MolRecBench-Wild 规程人工标注的论文结构图,报告没有说明与测试集是否隔离。[S4]
所以 MolRecBench-Wild 同时保留 CARBON、分子图层面的表示和 SMILES。当模型逼近 USPTO 这类旧基准的上限,要改的未必只有模型,有时连“什么叫正确”也得重新定义。[S1]
基准更真实,也不等于经过了实际生产的检验
取自论文的基准比专利基准更接近论文里实际会遇到的困难,但仍不是化学文献的全貌,更不是其中各类图的真实比例。5,029 张图来自 7 种期刊约 820 篇近期 CC BY 论文,又按困难均衡挑选,代表不了所有出版商、年代、扫描质量、专利和化学子领域;MOSAIC 标注和复杂结构的标准答案由 47 名化学背景的标注员完成,论文没有报告标注者间一致性。[S1]
该得出的结论不是“终于知道 OCSR 的真实准确率了”,而是:USPTO 这类专利基准很可能让这个任务显得比实际容易,现在有了一把更贴近论文场景的尺子。
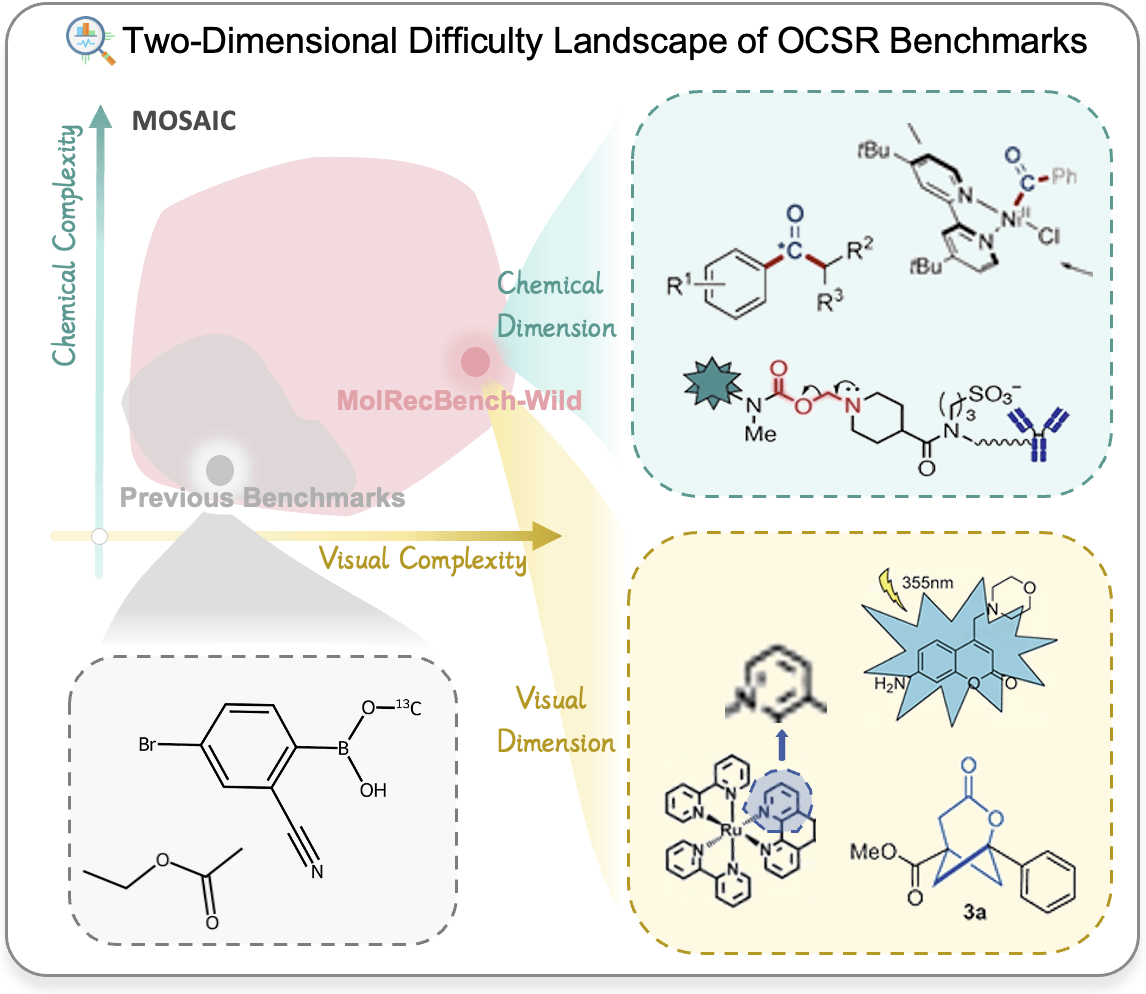
官方仓库的难度分布图:以往基准的样本集中在视觉、化学困难都少的一角,MolRecBench-Wild 沿两条轴铺开;这是按困难均衡挑选的结果,不是论文中各类图的真实比例。MolRecBench-Wild 官方仓库(OpenDataLab),整图未作修改;仓库的 Apache 2.0 许可针对代码,不涵盖图片。 [S2]
05我从中学到什么
- 可迁移的洞见
- 科学表示不是中性的文件格式:SMILES、分子图和 CARBON 保存的信息不同,这决定了什么算“正确”。
- 设计启发
- 抽取与归一化分开做:先如实记下看到的(图里是 Ph 就存 Ph),标准化放到后面。
- 阅读启发
- 看到 OCSR 准确率很高,先问测试集里有没有可变基团结构、聚合物、扫描专利这类真实困难。
- 接下来看
- 在真实论文分布上改用分子图层面或 CARBON 评测,OCSR 的准确率会掉到多少。
基准应当像模型真正要工作的地方
将来的数据里有 Markush,测试集却从来没有,排行榜再好看也不够。
科学表示不是中性的文件格式
SMILES、分子图与 CARBON 保存的信息不一样,什么结果能算“正确”也随之改变。
标注上的错位,可能比模型大小更根本
图片写的是 Ph,标准答案却要求完整苯环,这种监督错位不会因为模型变大就自动消失。
能找到“哪里错了”很重要
一张可以检查的分子图,往往比黑盒式的最终字符串更适合放进数据生产流程。
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。