

模型与数据发布· 科学证据 · Frontier
OpenBind-0:多四年的 PDB 数据,为什么没有让模型全面变强?
OpenBind 联盟与 ASAP Discovery、Syngenta 发布的 OpenBind-0,意义不止于完整开放。真实药物发现项目暴露出一个更深的问题:数据多了,模型不会自动变强,除非新增结构补上模型不熟悉的区域。
●官方模型与数据发布 + 公开基准评测
当前边界:结果来自官方评测而非同行评审论文;模型在 FatA 和两个 RdRp 靶点上的表现仍然很低
这项工作推进的是:用新增实验结构检验分子相互作用模型的数据盲区
- MODEL理解 / 预测
- DECIDE选择下一步
- INTERACT测试现实
- UPDATE改变下一轮
717三个靶点新公开的实验结合结构
92.2% vs 6.7%top-25:最易与最难靶点之间(非前后对比)
OB0 是完整开放的共折叠基线,与 AlphaFold3、Protenix 相当;四个靶点里只有 EV-A71 接近解决,两个 RdRp 仍是个位数。
- 认知更新
- 多四年 PDB 数据没让每项测试都变容易;明显的提升主要落在新结构补到模型陌生区域的地方。
- 最强证据
- 以真实实验结构为参照:药物位置偏差 ≤2 Å、接触吻合 ≥0.8,并通过 PoseBusters 检查。
- 关键限制
- 评测由 OpenBind 自己完成,非同行评审;2021 与 2025 对比也不是只改截止日期的受控实验。
01发生了什么
- 任务
- 用四个真实靶点测共折叠:EV-A71,以及新公开数据的 FatA、登革热与寨卡 RdRp。
- 方法
- 以 OpenFold3 为基础、用截至 2025-06 的 PDB 训练开放基线,采样时引导向合理化学结构,刻意不用 OpenBind 自产结构。
- 交互对象
- 这一步只做软件预测、用真实晶体结构打分,不做新实验;那 717 个参照结构本身来自真实实验。
- 结果
- top-25:EV-A71 2A 蛋白酶 92.2%,FatA 28.2%(最好 39.4%),两个 RdRp 最好也不到 8%。
48% → 61%同一模型加入 chemical steering 前后:位姿正确且化学有效的联合成功率
547 + 170公开的片段 + 命中结合结构(三靶点合计 717)
2026 年 8 月 21 日,OpenBind 发布了第一代分子结构预测模型 OpenBind-0(OB0)。模型以 OpenFold3 为基础,专攻蛋白质与小分子的共折叠,训练数据是 PDB 中截至 2025 年 6 月的公开结构。[S1]
这次还公开了 717 个带配体的实验结构,来自 FatA、登革热病毒 RdRp 和寨卡病毒 RdRp 三个真实的 fragment-to-hit 项目,其中 547 个是片段结合结构,170 个是后续命中化合物的结合结构。[S1][S3]
为什么叫“0”
OB0 的训练集刻意不含 OpenBind 自己测的结构,只用公开数据建立基线。等下一代模型加入这些实验结构,就能直接比出新数据到底带来了多少改善。[S1]
OpenBind-0 使用 Apache 2.0 许可证,并公开训练数据、代码、模型权重和训练方法。使用者不只能跑预测,还可以重新训练模型,或把自己的内部数据混进原有训练数据再做实验。[S1][S2]
位置对了还不够,化学上也得成立
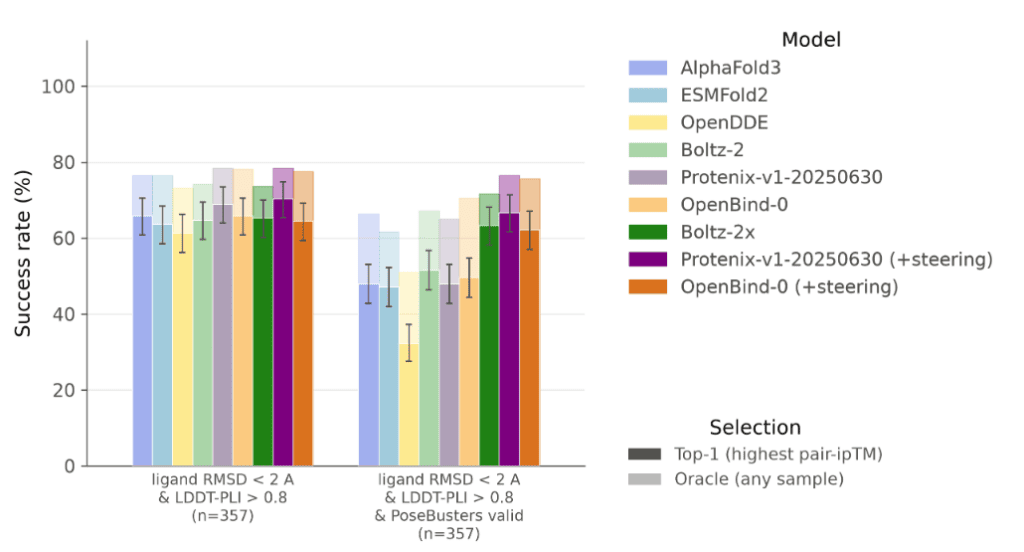
共折叠模型可能把配体大致放对了位置,键长、键角或局部几何却不合理。只看 RMSD,这样的结构也可能算作预测正确;可一旦拿去做自由能计算,或据此做药物化学决策,这些化学错误就会拖累结果。[S1]
OpenBind 在扩散采样阶段加入 chemical steering,并用 PoseBusters 检查配体的化学合理性。位置正确且化学几何有效的联合成功率由 48% 升到 61%。[S1]
OpenBind 官方博客 Fig. 2:chemical steering 对位姿准确率影响不大,但明显提高了结构正确且化学有效的比例。[S1]
02改变了什么
瓶颈更新评测更新开放的共折叠模型早已有之,但训练过程不透明,与真实药物靶点相关的结构覆盖也有限。
完整开放的基线加上新实验结构,把三个真实项目变成了基准;数据有多大价值,要看它补上哪块空白。
对科学基础模型来说,网络结构只是一部分。训练数据的来源、截止日期、不同模态数据的配比、选用哪个 checkpoint、微调时是否保留原有训练分布,都会影响模型表现。这些环节一起公开,OB0 就成了可以研究、可以修改的基线,而不是黑箱服务。[S1][S2]
四年新数据为何没带来全面提升
OB0 的训练数据截至 2025 年 6 月,OpenFold3-preview2 则截至 2021 年。按直觉,多看了近四年的 PDB 数据,每个测试都该变容易些;实际上在许多训练集相似度区间里,两者表现相差无几。[S1]
团队进一步查看每个测试复合物与训练集中最近结构的距离。PDB 虽然新增了大量蛋白质-配体结构,许多测试样本的最近参照却没有因此明显靠近。数据集变大了,这些靶点对模型来说依然陌生。[S1]
明显的提升主要出现在新增数据确实补上相关结构的样本上:原本陌生的靶点有了更接近的训练参照,模型才变强。所以衡量数据价值不能只数新增了多少结构,关键在于它填补了哪一块结构和化学空间。[S1]
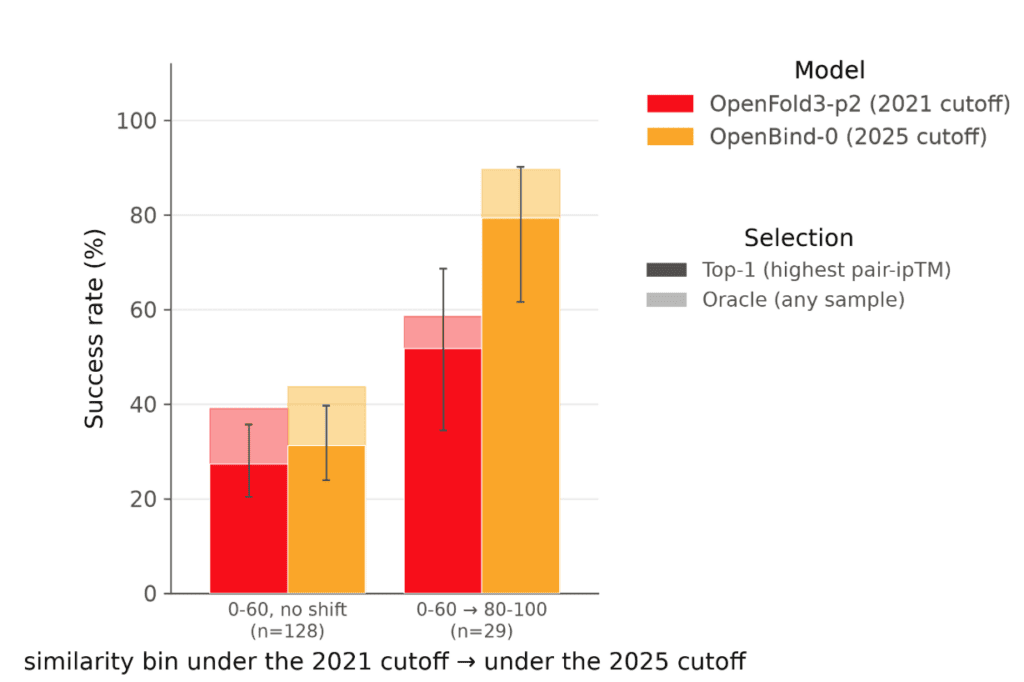
OpenBind 官方博客 Fig. 5:横轴衡量 2025 年的数据是否比 2021 年的数据让目标更接近训练分布。新增结构确实补上相关空白时,模型收益更明显。图片来自 OpenBind 原文。 [S1]
03为什么重要
下一批实验数据该投向哪里?
- 衡量 AI4S 数据集,不看规模,要看它补上了哪一块科学覆盖。
- 微调替代不了缺失的数据;缺的若是一整块相关结构,可能就得做新实验。
即便只算又一个完整开放的共折叠模型,OpenBind-0 也已经有用,但它更深一层的价值在于数据闭环。OB0 刻意不用 OpenBind 自己的数据,留下一个干净的基线;团队据此找出模型失败的区域,再决定哪些新结构最值得用实验测出来。[S1]
OpenBind 明确表示,模型预测正在帮团队决定下一步做哪些实验。SAPP/DMX 解决的是与之相邻的问题:OpenBind 问实验该补什么数据,SAPP/DMX 问实验怎样更快交回数据。[S1]
微调补得回来吗?要看是哪个靶点
团队又用特定靶点的片段结构做了微调。在 EV-A71 上,这类数据曾明显改善 OpenFold3-preview2;OB0 在预训练阶段就吸收了这些片段结构,表现又超过了微调版本。至少在这个体系里,相关数据放进预训练可能更有效。[S1]
这种改善并不普遍。FatA 只提高了一点,两个 RdRp 微调后依然很差。稳妥的结论不是“预训练一定优于微调”,而是训练上的技巧未必能替代缺失的实验覆盖。[S1]
04证据状态与边界
证据等级 3 / 5 · 对照已有证据检验 · 实体验证证据状态
已证实
- 代码、权重、训练数据与方法:Apache 2.0
- chemical steering:联合成功率 48% → 61%
边界
有迹象
- 数据的价值在于补上模型陌生的结构空间
- 相关数据入预训练或胜过事后微调(仅 EV-A71)
未知
- 柔性、训练未见靶点(RdRp)的共折叠仍未解决
- 如何选出下一批最有价值的实验;数据闭环能否稳定改善模型
top-25 = 25 个预测有一个位置偏差 ≤2 Å、接触吻合 ≥0.8 并通过 PoseBusters;各靶点取最好模型。
读法不是一条 92.2%→6.7% 的下滑,而是四个难度递增的靶点。EV-A71 训练前已见过近似结构;柔性 RdRp 差异大,各模型都不到 10%。
证据形式
OpenBind-0 目前是模型与数据发布,外加团队自己的基准评测,还不是完整的同行评审论文。文中的性能数字都来自 OpenBind 官方发布及随附评测。[S1][S3]
92.2% 指什么
92.2% 不是通用的“药物结合预测准确率”。每个结合事件生成 25 个结构,只要其中至少一个满足配体 RMSD ≤2 Å、LDDT-PLI ≥0.8 并通过 PoseBusters 检查,就算 top-25 成功。[S1]
三个真实项目,三种失败方式
EV-A71 为 92.2%,FatA 为 28.2%,两个 RdRp 上最好的模型也不到 8%(DENV-2 RdRp 最好 7.7%,ZIKV RdRp 最好 6.7%,各模型都在同一批真实结构上比较)。EV-A71 的训练覆盖较好;FatA 上模型通常能找到口袋,主要是配体摆不对;RdRp 上则常常连结合口袋都选错,蛋白构象和配体位姿也跟着出错。[S1][S4][S5]
OpenBind 用真实的 fragment-to-hit 项目检验模型。在 EV-A71 2A 蛋白酶上,OB0 的 top-25 成功率达到 92.2%,top-1 为 73.8%。相关片段结构在训练截止日之前就已进入 PDB,模型见过非常接近的结构。[S1]
换到 FatA,OB0 的 top-25 成功率降到 28.2%,表现最好的 Protenix-v1-20250630 也只有 39.4%。模型通常能找到正确的结合口袋,蛋白构象也大体合理,却常常把配体摆错。换句话说,它大致知道分子该去哪里,却不知道该怎么放。[S1][S4]
在登革热和寨卡病毒的 RdRp 上,几乎所有模型都失败了。RdRp 体量大,表面有多个口袋,主要结合位点附近又很灵活;这两个体系与 2021 年和 2025 年训练集里的已知结构都很不相似。[S1][S5]
比较边界
2021 与 2025 的比较并不是只改训练数据截止日期的严格受控实验。OpenFold3-preview2 与 OB0 的网络结构相似但不完全相同,OpenBind 自己也指出了这一点。[S1]
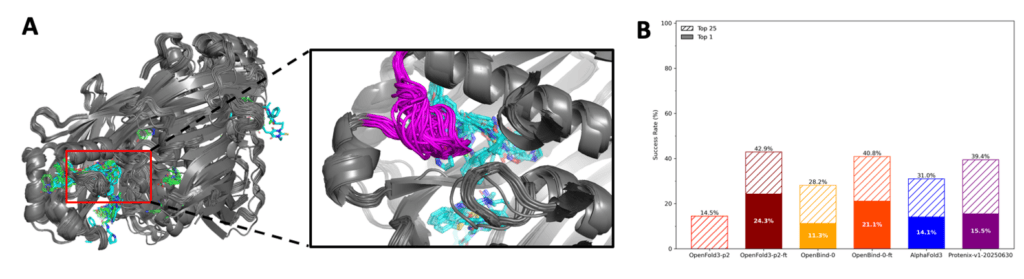
OpenBind 官方博客 Fig. 7:在 FatA 上,模型往往能找到口袋,主要难在配体位姿;OB0 的 top-25 为 28.2%。图片来自 OpenBind 原文。 [S1]
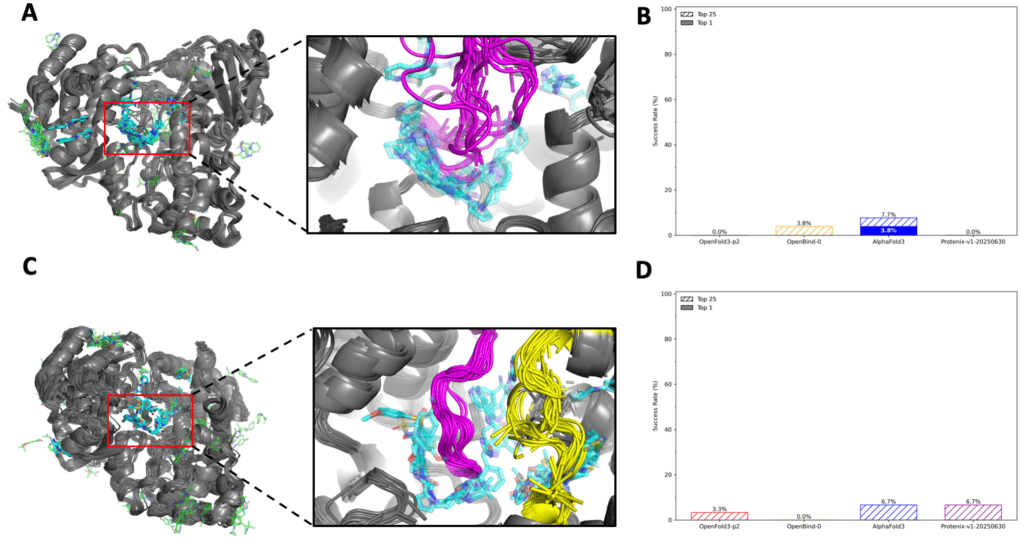
OpenBind 官方博客 Fig. 8:登革热与寨卡 RdRp 上,各模型 top-25 成功率都不到 10%(最好 7.7% / 6.7%)。图片来自 OpenBind 原文。 [S1]
05我从中学到什么
- 可迁移的洞见
- AI4S 的数据问题正从“够不够多”转向“有没有补到模型薄弱的地方”。
- 设计启发
- 发布时就留好干净的基线:先不放自产数据,日后才量得出它的贡献。
- 阅读启发
- 看到“新数据让模型更强”,先问新增结构落在模型原本强的区域,还是弱的区域。
- 接下来看
- 下一代模型加入这批结构后,能否在 FatA 和 RdRp 上真正改善:这是检验数据闭环的关键。
1|数据问题:从“够不够多”到“补没补对地方”
多出的四年 PDB 数据并没有让每项测试自动变容易。新增结构如果都落在模型已经熟悉的区域,对困难靶点可能帮助不大。今后看一个 AI4S 数据集,除了规模,还要问它补上了哪一块新的科学覆盖。
2|失败方式比平均分更有用
EV-A71、FatA 和 RdRp 同属蛋白质-配体预测,表现却各不相同:一个训练覆盖较好,一个主要是配体摆不对,一个常常连口袋都选错。只知道模型错了还不够,还要知道为什么错,下一笔实验预算该花在哪里。
3|缺数据时,微调不是万能补丁
同一种微调方法,换个体系,可能从明显有效变成几乎无效。训练集里要是缺了一整块结构区域,几十个特定靶点的样本未必补得回来,新的实验可能更重要。
4|完整开放,数据与模型的关系才能研究
只开放权重,通常只能比较预测结果。训练数据、训练方法、代码和权重都开放了,更深的问题才能检验:加入哪类数据最有价值?应该放进预训练还是微调?一种数据配比改善了什么,又损害了什么?
5|自动化科学最难的,也许是决定下一个实验做什么
有价值的主动学习不只是从 10,000 个候选里挑出 100 个,还要判断这 100 个实验能否最大程度地减少关键的不确定性,或填补训练分布中影响最大的空白。一个系统若能反复回答“下一条最值得生成的数据是什么”,它的价值可能超过任何单个模型或数据集。
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。