RL with Verifiable Rewards, but the Verifier is a Lab
人类文本快被用尽,AI 如何从真实实验中获得新数据?
为什么推荐
Latent Space 对 Lila Sciences 首席技术官 Andy Beam 和联合创始人、物理科学首席科学官 Rafael Gómez-Bombarelli 的专访,探讨如何用真实的实体实验室作为强化学习的验证器,从而解决 AI for Science 面临的数据枯竭问题。
- 科学领域的数据枯竭与“新 Scaling Law”:大语言模型LLM的成功依赖于几乎抽干了互联网上所有的人类文本,如 Andy 所说,那是 AI 的“化石燃料”。而在科学领域,无论是生物医药还是材料科学,高质量、真实的数据是极度稀缺且难以获取的。Lila 把“生成实验数据”当作新的 Scaling 维度。
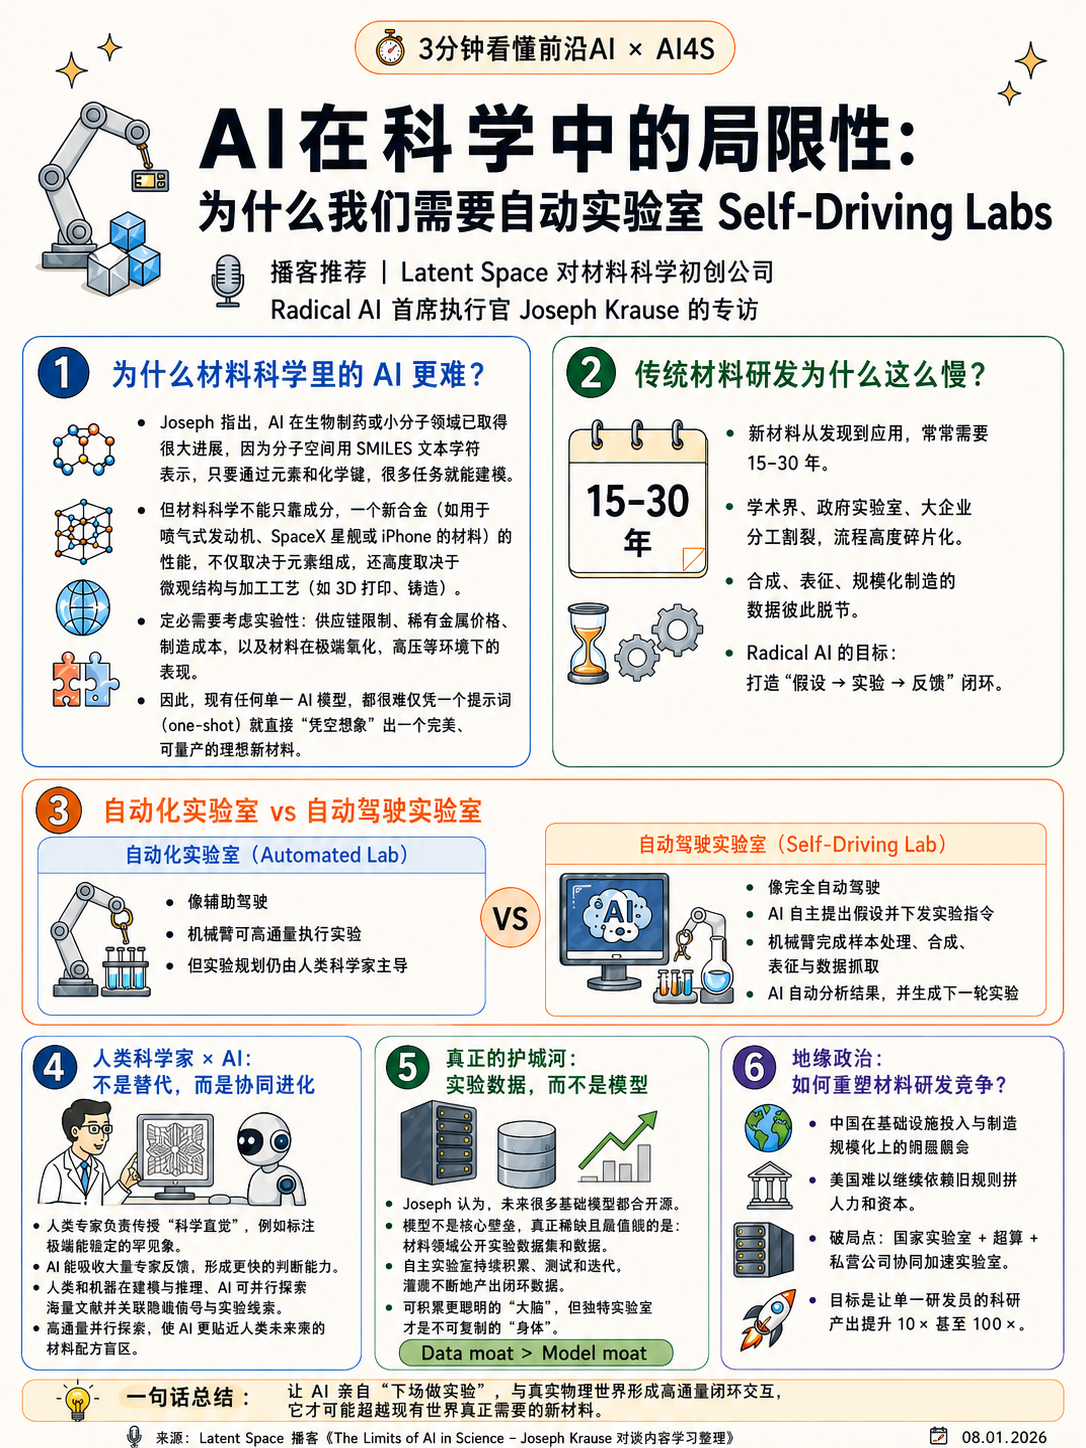
- AI科学工厂:他们不把自己定位为传统 Biotech,也不是一家单纯的“实验室自动化”公司。他们的目标是一个由模型控制的实验平台。平台上的仪器共用一条类似计算机“PCI 总线”的物理传输层,比如在磁悬浮轨道上移动的 96 孔板。
- 闭环强化学习 RL 与把大自然当验证器:在数学和写代码领域,强化学习因为有明确的规则,比如代码能跑通,数学能证出,而非常成功。在科学发现中,高通量自动化实验的真实结果可以成为强化学习的奖励信号。AI 提出假设 -> 写实验代码 -> 实验室自动执行 -> 生成的成功/失败数据重新喂给模型。
- 跨领域的通用性推理:不同于为蛋白质折叠或电池材料分别开发垂类模型,Lila 在采访中称已汇集约 10 万亿个跨生命科学、化学与材料的实验验证 reasoning tokens,用于基础模型后训练;这一规模及跨领域收益目前仍是公司自述。
Reinforcement learningScientific dataSelf-driving labs
阅读来源笔记 →