

证据地图· 科学证据 · Frontier
AIntibody 盲测:511 个抗体同一套检测测下来,AI 赢在哪项任务、输在哪项
Specifica 组织的 AIntibody 盲测:29 家机构、三项任务、511 个抗体全部做出来测量。文库内提高结合强度这一项,最好的提交与实验室自己的最佳抗体打平;挑出簇内最强克隆这一项,除一家外都输给随机抽取。
●同行评审论文,开放获取;每个提交的抗体都由外部实验室做出来并测量
这项工作推进的是:把各家自报的抗体设计成绩,放到同一套盲测与实测之下
- MODEL理解 / 预测
- DECIDE选择下一步
- INTERACT测试现实
- UPDATE改变下一轮
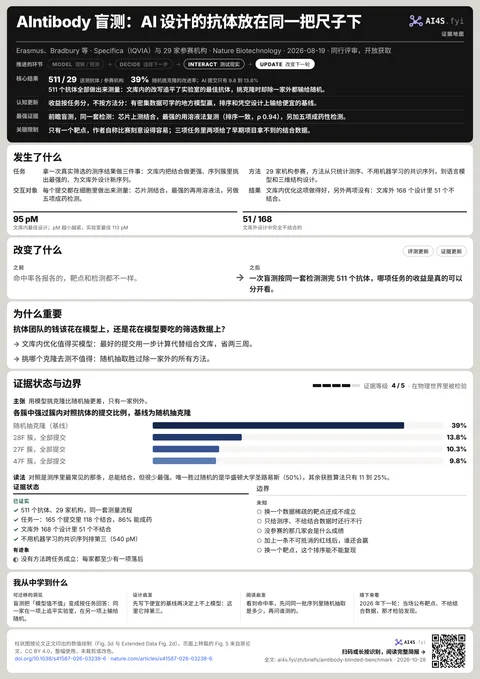
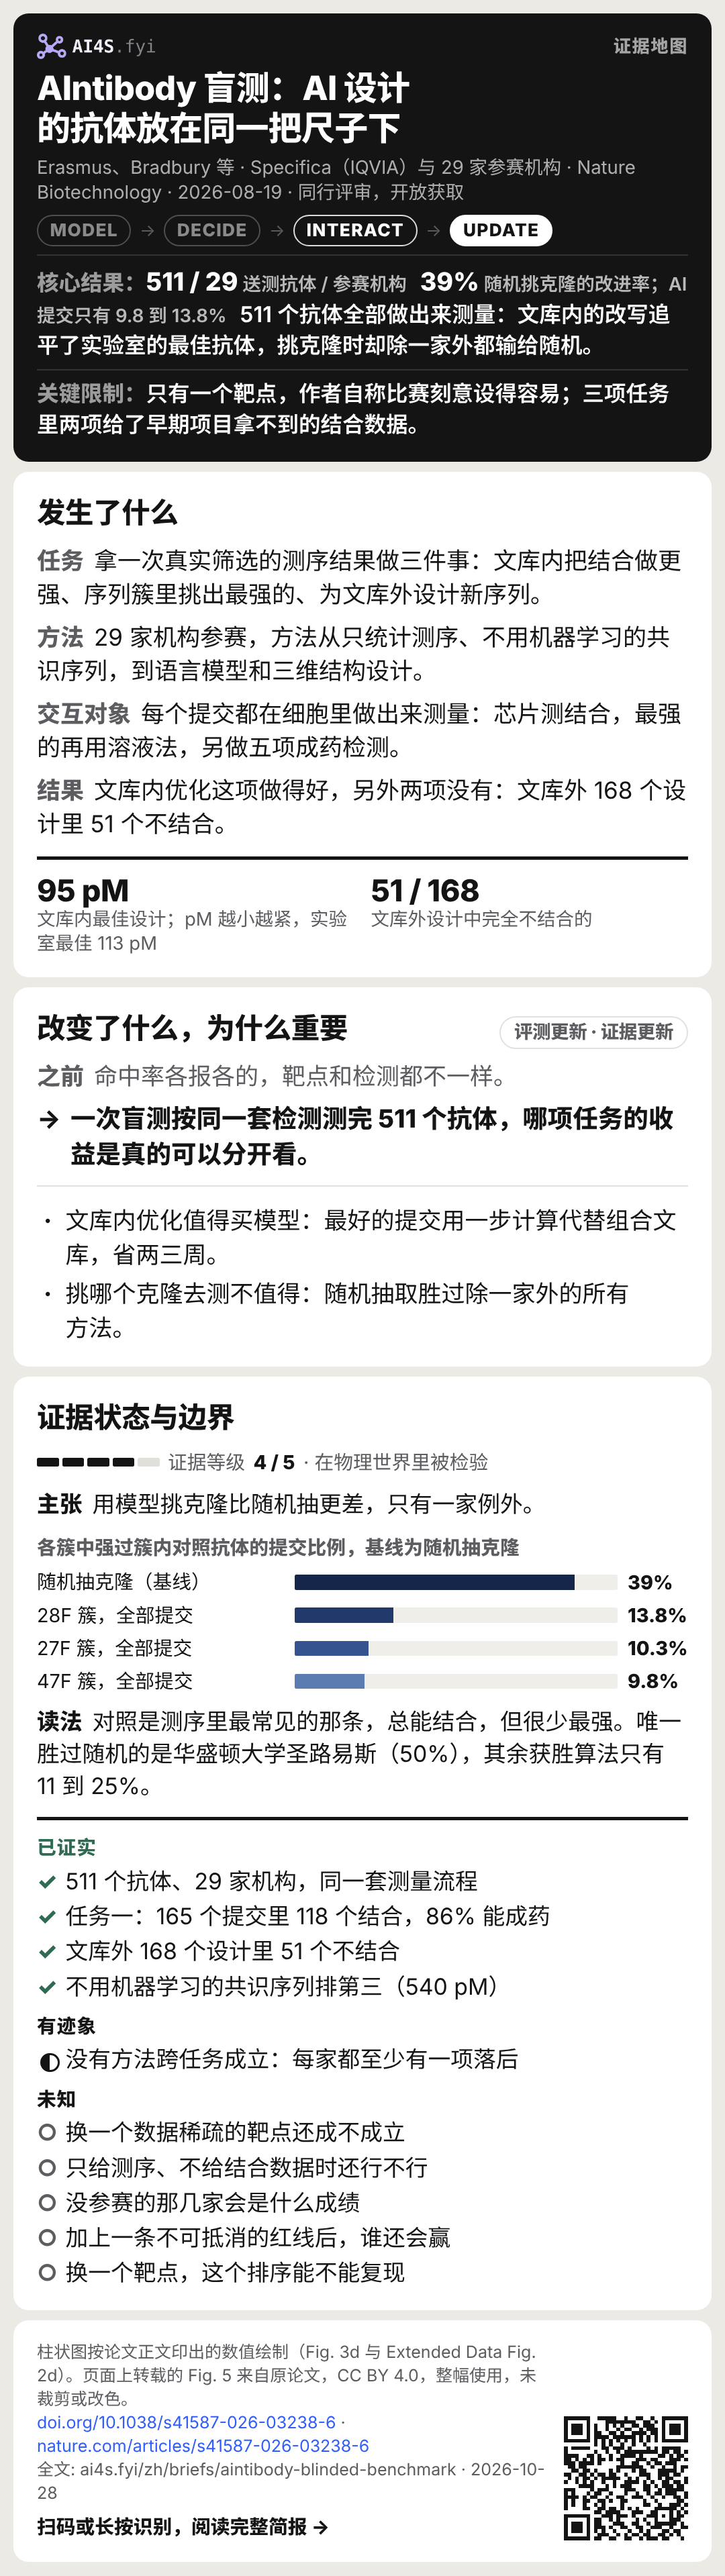
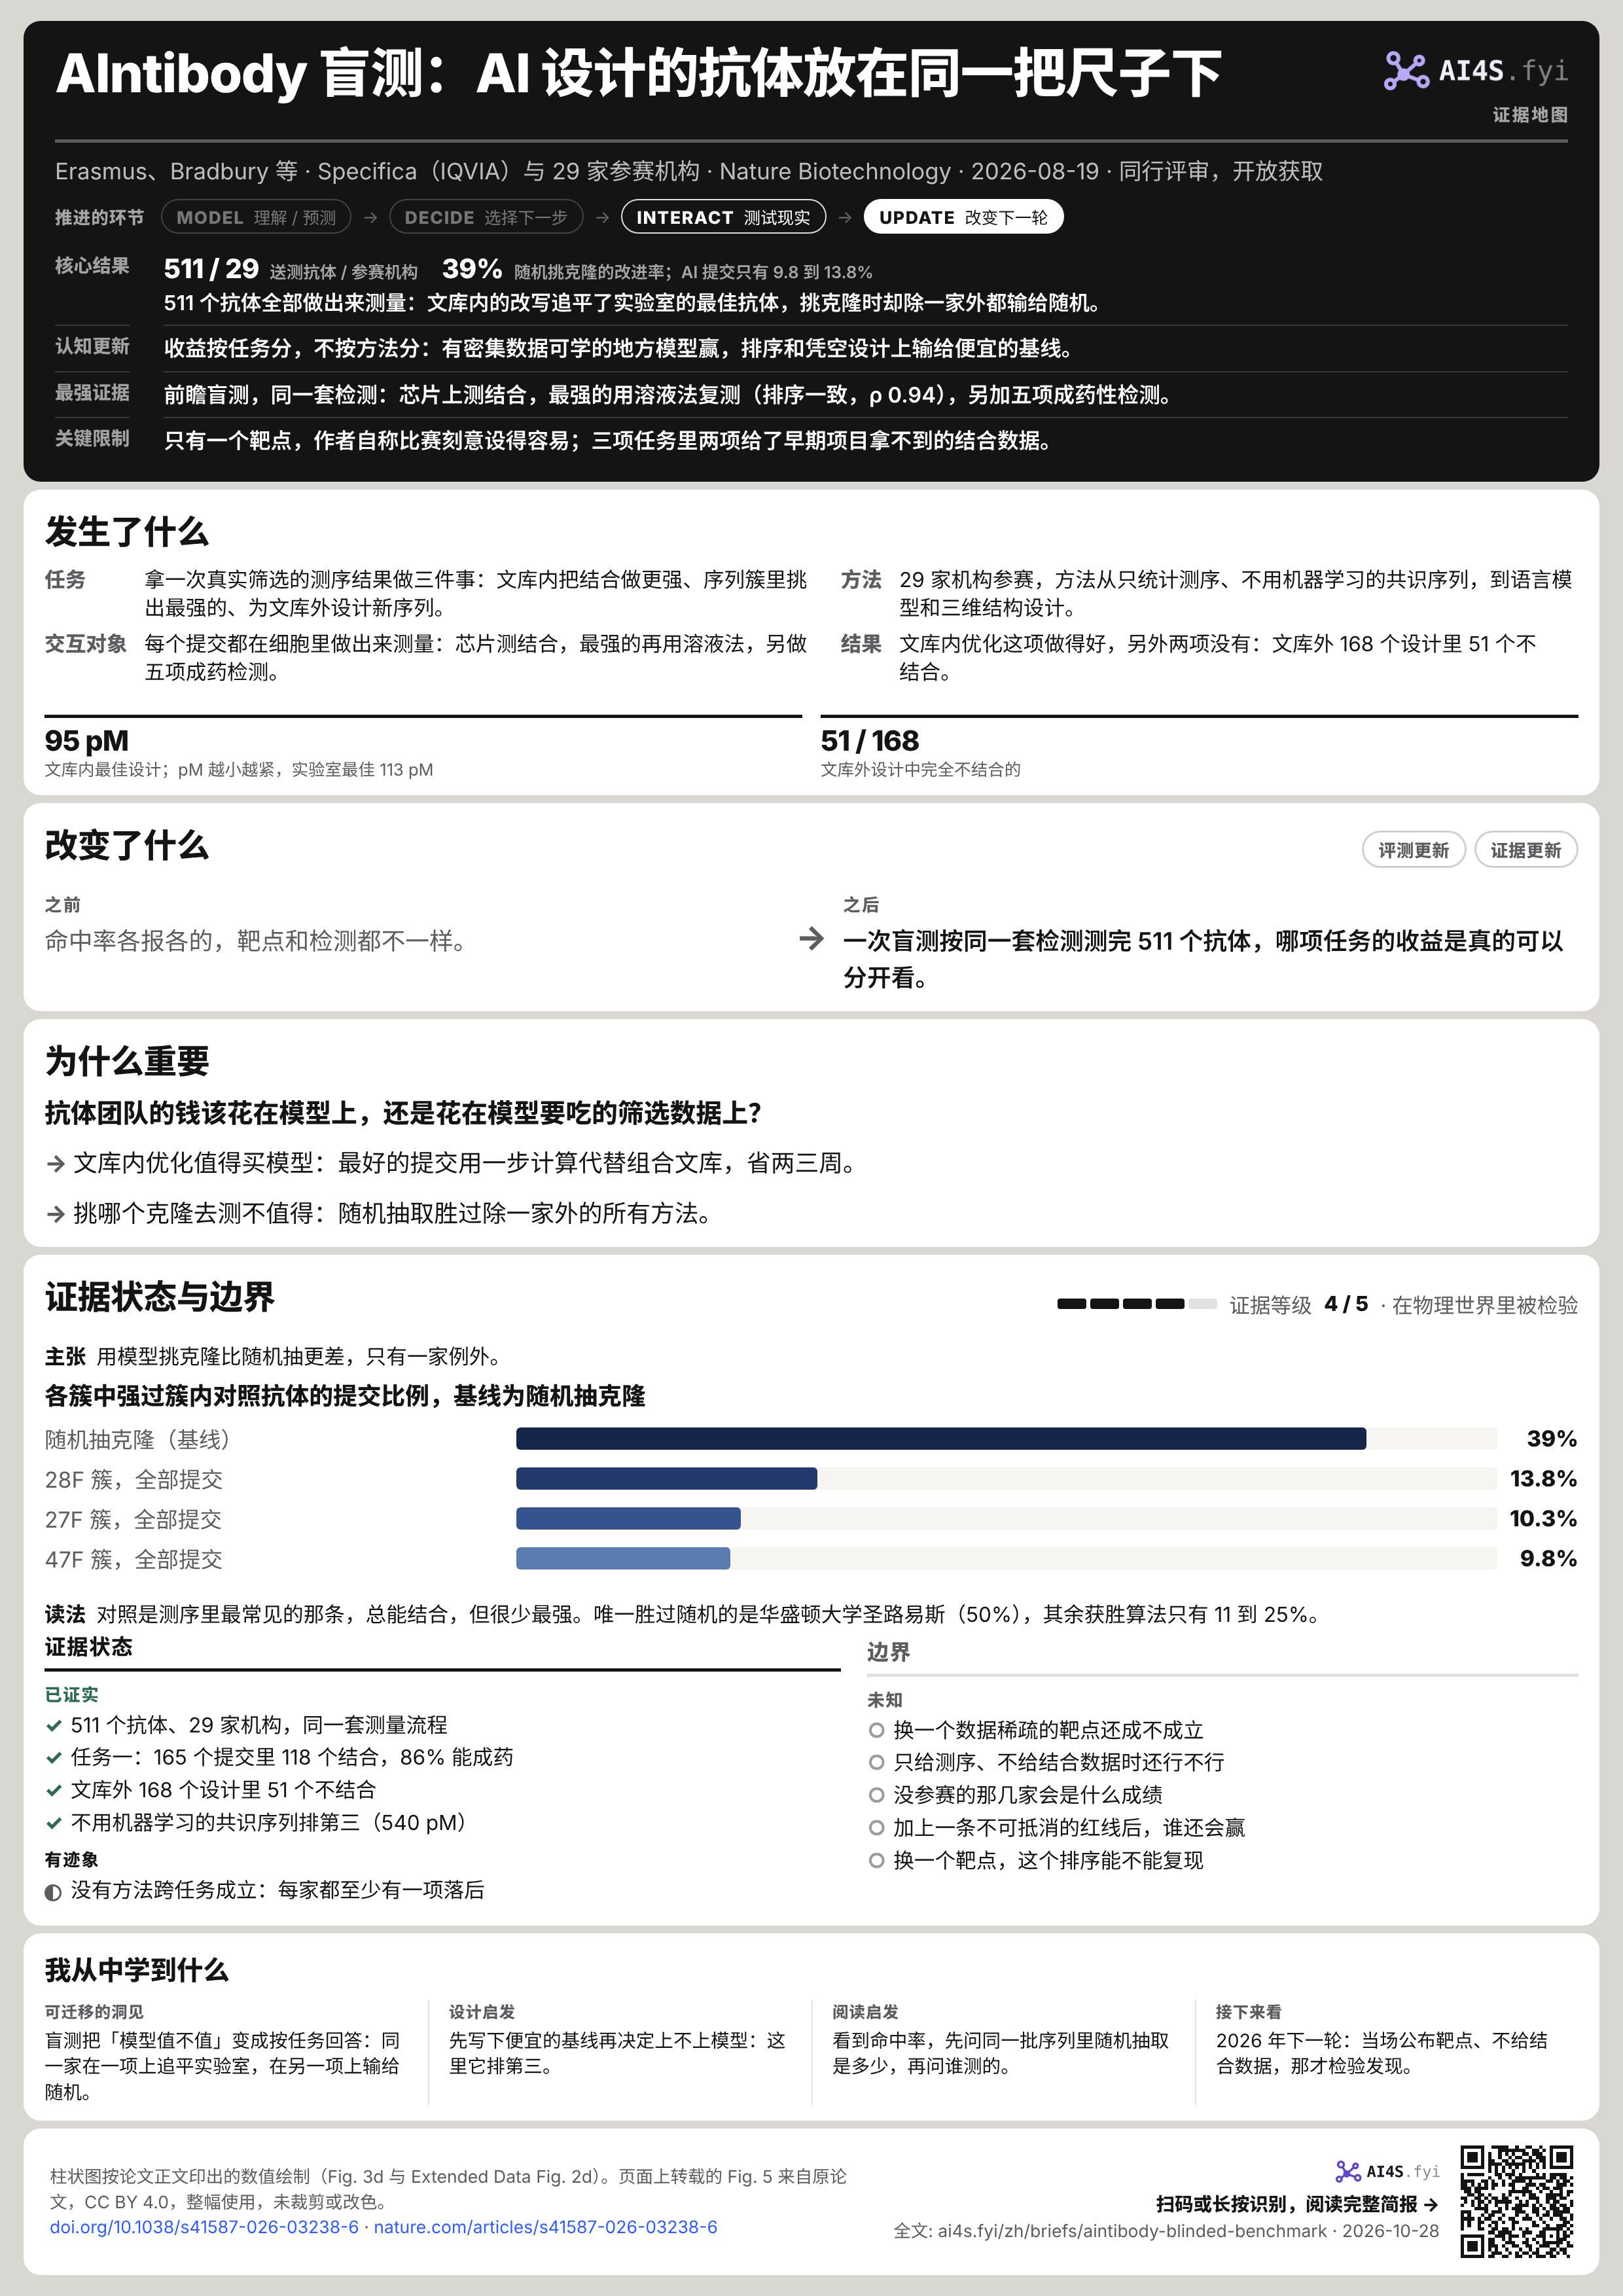
511 / 29送测抗体 / 参赛机构
39%随机挑克隆的改进率;AI 提交只有 9.8 到 13.8%
511 个抗体全部做出来测量:文库内的改写追平了实验室的最佳抗体,挑克隆时却除一家外都输给随机。
- 认知更新
- 收益按任务分,不按方法分:有密集数据可学的地方模型赢,排序和凭空设计上输给便宜的基线。
- 最强证据
- 前瞻盲测,同一套检测:芯片上测结合,最强的用溶液法复测(排序一致,ρ 0.94),另加五项成药性检测。
- 关键限制
- 只有一个靶点,作者自称比赛刻意设得容易;三项任务里两项给了早期项目拿不到的结合数据。
01发生了什么
- 任务
- 拿一次真实筛选的测序结果做三件事:文库内把结合做更强、序列簇里挑出最强的、为文库外设计新序列。
- 方法
- 29 家机构参赛,方法从只统计测序、不用机器学习的共识序列,到语言模型和三维结构设计。
- 交互对象
- 每个提交都在细胞里做出来测量:芯片测结合,最强的再用溶液法,另做五项成药检测。
- 结果
- 文库内优化这项做得好,另外两项没有:文库外 168 个设计里 51 个不结合。
95 pM文库内最佳设计;pM 越小越紧,实验室最佳 113 pM
51 / 168文库外设计中完全不结合的
三项任务,一把尺子
AIntibody 仿照结构预测竞赛 CASP:题目先出,提交封存,结果由主办方统一测量。29 家机构参赛,按论文的分类是 10 家学术或非营利实验室、8 家 AI 生物技术公司、5 家中小生物技术公司、5 家大药厂和 1 家大型科技公司。靶点只有一个,新冠病毒刺突蛋白的受体结合区,作者说这是刻意挑的:靶点研究得透、数据给得足,整场比赛被「预设成容易成功」的样子。[S1]
任务一是在文库内提高结合强度:给出一次酵母展示筛选第一阶段的测序结果,要求改动六个可变环中的五个(重链第三环和骨架不许动),写出结合更强、又能做成药的序列。除母本抗体外,不提供任何结合强度数据。25 家机构交了 165 个序列。[S1]
任务二是排序:在三个按重链第三环分组的序列簇(27F 有 2,524 条、28F 有 3,554 条、47F 有 410 条)里,各挑出结合最强且能成药的那一条。每个簇给了少量已测的结合强度(分别是 22、14 和 3 条),还给了「簇内对照」,也就是测序里出现最多的那条序列。任务三是文库外设计:拿全部 32,059 条序列和 142 条已测结合强度,设计数据集里没有的新序列,骨架不许动。[S1]
测量这一层是这项工作最硬的部分。所有提交先在芯片上测(高通量表面等离子共振),结合最强的再用溶液里的平衡法(KinExA)复测,两法之间的排序相关系数为 0.94 和 0.97,与芯片法之间为 0.92:绝对数值两法并不一致(溶液法普遍测得更紧),但谁强谁弱的排序是稳的。能否做成药由五项检测合成一个分数:疏水色谱保留时间、非特异结合、自相互作用、熔解温度和聚集温度,单项 0 到 2 分,合计 3 分以内算通过。[S1]
每项任务的结果
任务一:165 个提交里 118 个(71.5%)结合,22 个(13.3%)到个位数纳摩尔,5 个(3.0%)低于 1 纳摩尔,1 个(0.6%)低于 100 皮摩尔;86.1% 通过成药性检测,63.0% 既结合又能成药。第一名 Aureka 做到 95 pM,是母本抗体的约 2,000 倍,与实验室自己做出的最佳抗体(113 pM)的 95% 区间重叠,统计上分不出高下。Aureka 的序列与母本相差 19 个氨基酸,与实验数据集中任何序列至少差 12 个,是少见的大胆改法。但同一项任务里,有 8 家机构一个能成药的结合物都没做出来。[S1]
任务二:三个簇分别有 10.3%、13.8% 和 9.8% 的提交强过簇内对照。作者在同一批序列里实测过随机抽克隆的改进率,是 39%。也就是说,对大多数参赛者而言,用模型挑抗体比「取最常见的那条、再随便抽几条」更差。唯一的例外是圣路易斯华盛顿大学(50% 对 39%),而它在 27F 簇上同样无效。获胜算法也不跨簇成立。[S1]
任务三:168 个提交里 51 个(30.4%)完全不结合,24 个(14.3%)低于 100 皮摩尔,53.6% 既结合又能成药。按比赛规则,第一名是一个 2.9 pM 的设计,比实验室最佳的 9.2 pM 还紧;但它在疏水色谱柱上洗不下来,按通常的药物开发标准这一条大概就足以出局,只是复合评分允许高亲和力抵消单项失败。下一个能成药的设计是 8.69 pM,与实验室最佳统计上打平。[S1]
02改变了什么
评测更新证据更新命中率各报各的,靶点和检测都不一样。
一次盲测按同一套检测测完 511 个抗体,哪项任务的收益是真的可以分开看。
03为什么重要
抗体团队的钱该花在模型上,还是花在模型要吃的筛选数据上?
- 文库内优化值得买模型:最好的提交用一步计算代替组合文库,省两三周。
- 挑哪个克隆去测不值得:随机抽取胜过除一家外的所有方法。
这篇论文最可直接使用的,是它把「AI 抗体设计有没有用」这个问题拆成了三问,并各给了一个带基线的答案。按任务买,不按公司买:同一家机构在一项任务上第一、在另一项上远离前列,是这一轮的常态,而不是例外。论文的跨任务排名表显示,每一家公开身份的队伍都至少有一项成绩明显落后。[S1]
另一处值得记下的是获胜者的构成。只有一家获胜者(Aureka)自称 AI 公司,其余是三所大学的课题组(Scripps、UCSD、圣路易斯华盛顿大学)和一家中型生物技术公司(Xencor),后者并不自称有 AI 专长,却用两套不同的算法拿下一个簇和文库外设计。作者据此说,这个领域还没有被资金规模决定。[S1]
对评测设计本身也有一条教训,作者自己写了出来:复合成药性评分允许一项失败被其他项补回来,于是一个洗不下色谱柱的设计拿了第一。他们说下一轮会设「一票否决」的红线。打分规则会决定参赛者优化什么,这不是抗体独有的问题。[S1]
04证据状态与边界
证据等级 4 / 5 · 在物理世界里被检验 · 实体验证证据状态
已证实
- 511 个抗体、29 家机构,同一套测量流程
- 任务一:165 个提交里 118 个结合,86% 能成药
- 文库外 168 个设计里 51 个不结合
- 不用机器学习的共识序列排第三(540 pM)
边界
有迹象
- 没有方法跨任务成立:每家都至少有一项落后
未知
- 换一个数据稀疏的靶点还成不成立
- 只给测序、不给结合数据时还行不行
- 没参赛的那几家会是什么成绩
- 加上一条不可抵消的红线后,谁还会赢
- 换一个靶点,这个排序能不能复现
主张用模型挑克隆比随机抽更差,只有一家例外。
各簇中强过簇内对照抗体的提交比例,基线为随机抽克隆
读法对照是测序里最常见的那条,总能结合,但很少最强。唯一胜过随机的是华盛顿大学圣路易斯(50%),其余获胜算法只有 11 到 25%。
本站把这条记在证据阶梯第 4 级:每一个提交都被做出来、在仪器上测过,不是在已有数据上回算。它的强度还来自三件事:题目先出、提交封存、测量由第三方统一做;基线被实测而不是估计;以及两套独立的测量方法排序一致。[S1]
需要说清的是这场比赛有多宽容。靶点只有一个,而且是被研究得最透的抗原之一;数据给得很足,任务二和任务三甚至提供了 142 条已测的结合强度,而在真实项目里结合强度通常要到后期才测得出来。作者自己写道,只有任务一用的是正常条件下能拿到的那种数据。所以这一轮能回答「在数据充足时模型能不能优化」,还不能回答「在数据稀疏时模型能不能发现」。[S1]
盲测还有一处弱点作者主动写了出来:封存靠的是主办方的操守,而不是数据上的任何密码学校验,他们说下一轮会补。此外,参赛要求披露部分方法细节,作者认为这挡住了一些有商业秘密顾虑的团队,而几个公开宣称有强能力的团队确实没有出现。[S1]
按方法分类读,获胜的类别每项任务都不一样:任务一是蛋白质语言模型配三维结构(Aureka),任务二三个簇分别由经典机器学习、自建 transformer 和语言模型拿下,任务三是语言模型(Xencor)。作者据此说,语言模型在设计走出文库时最有用,而在文库内与结构方法合用最有用,不存在一个方法通吃。[S1]
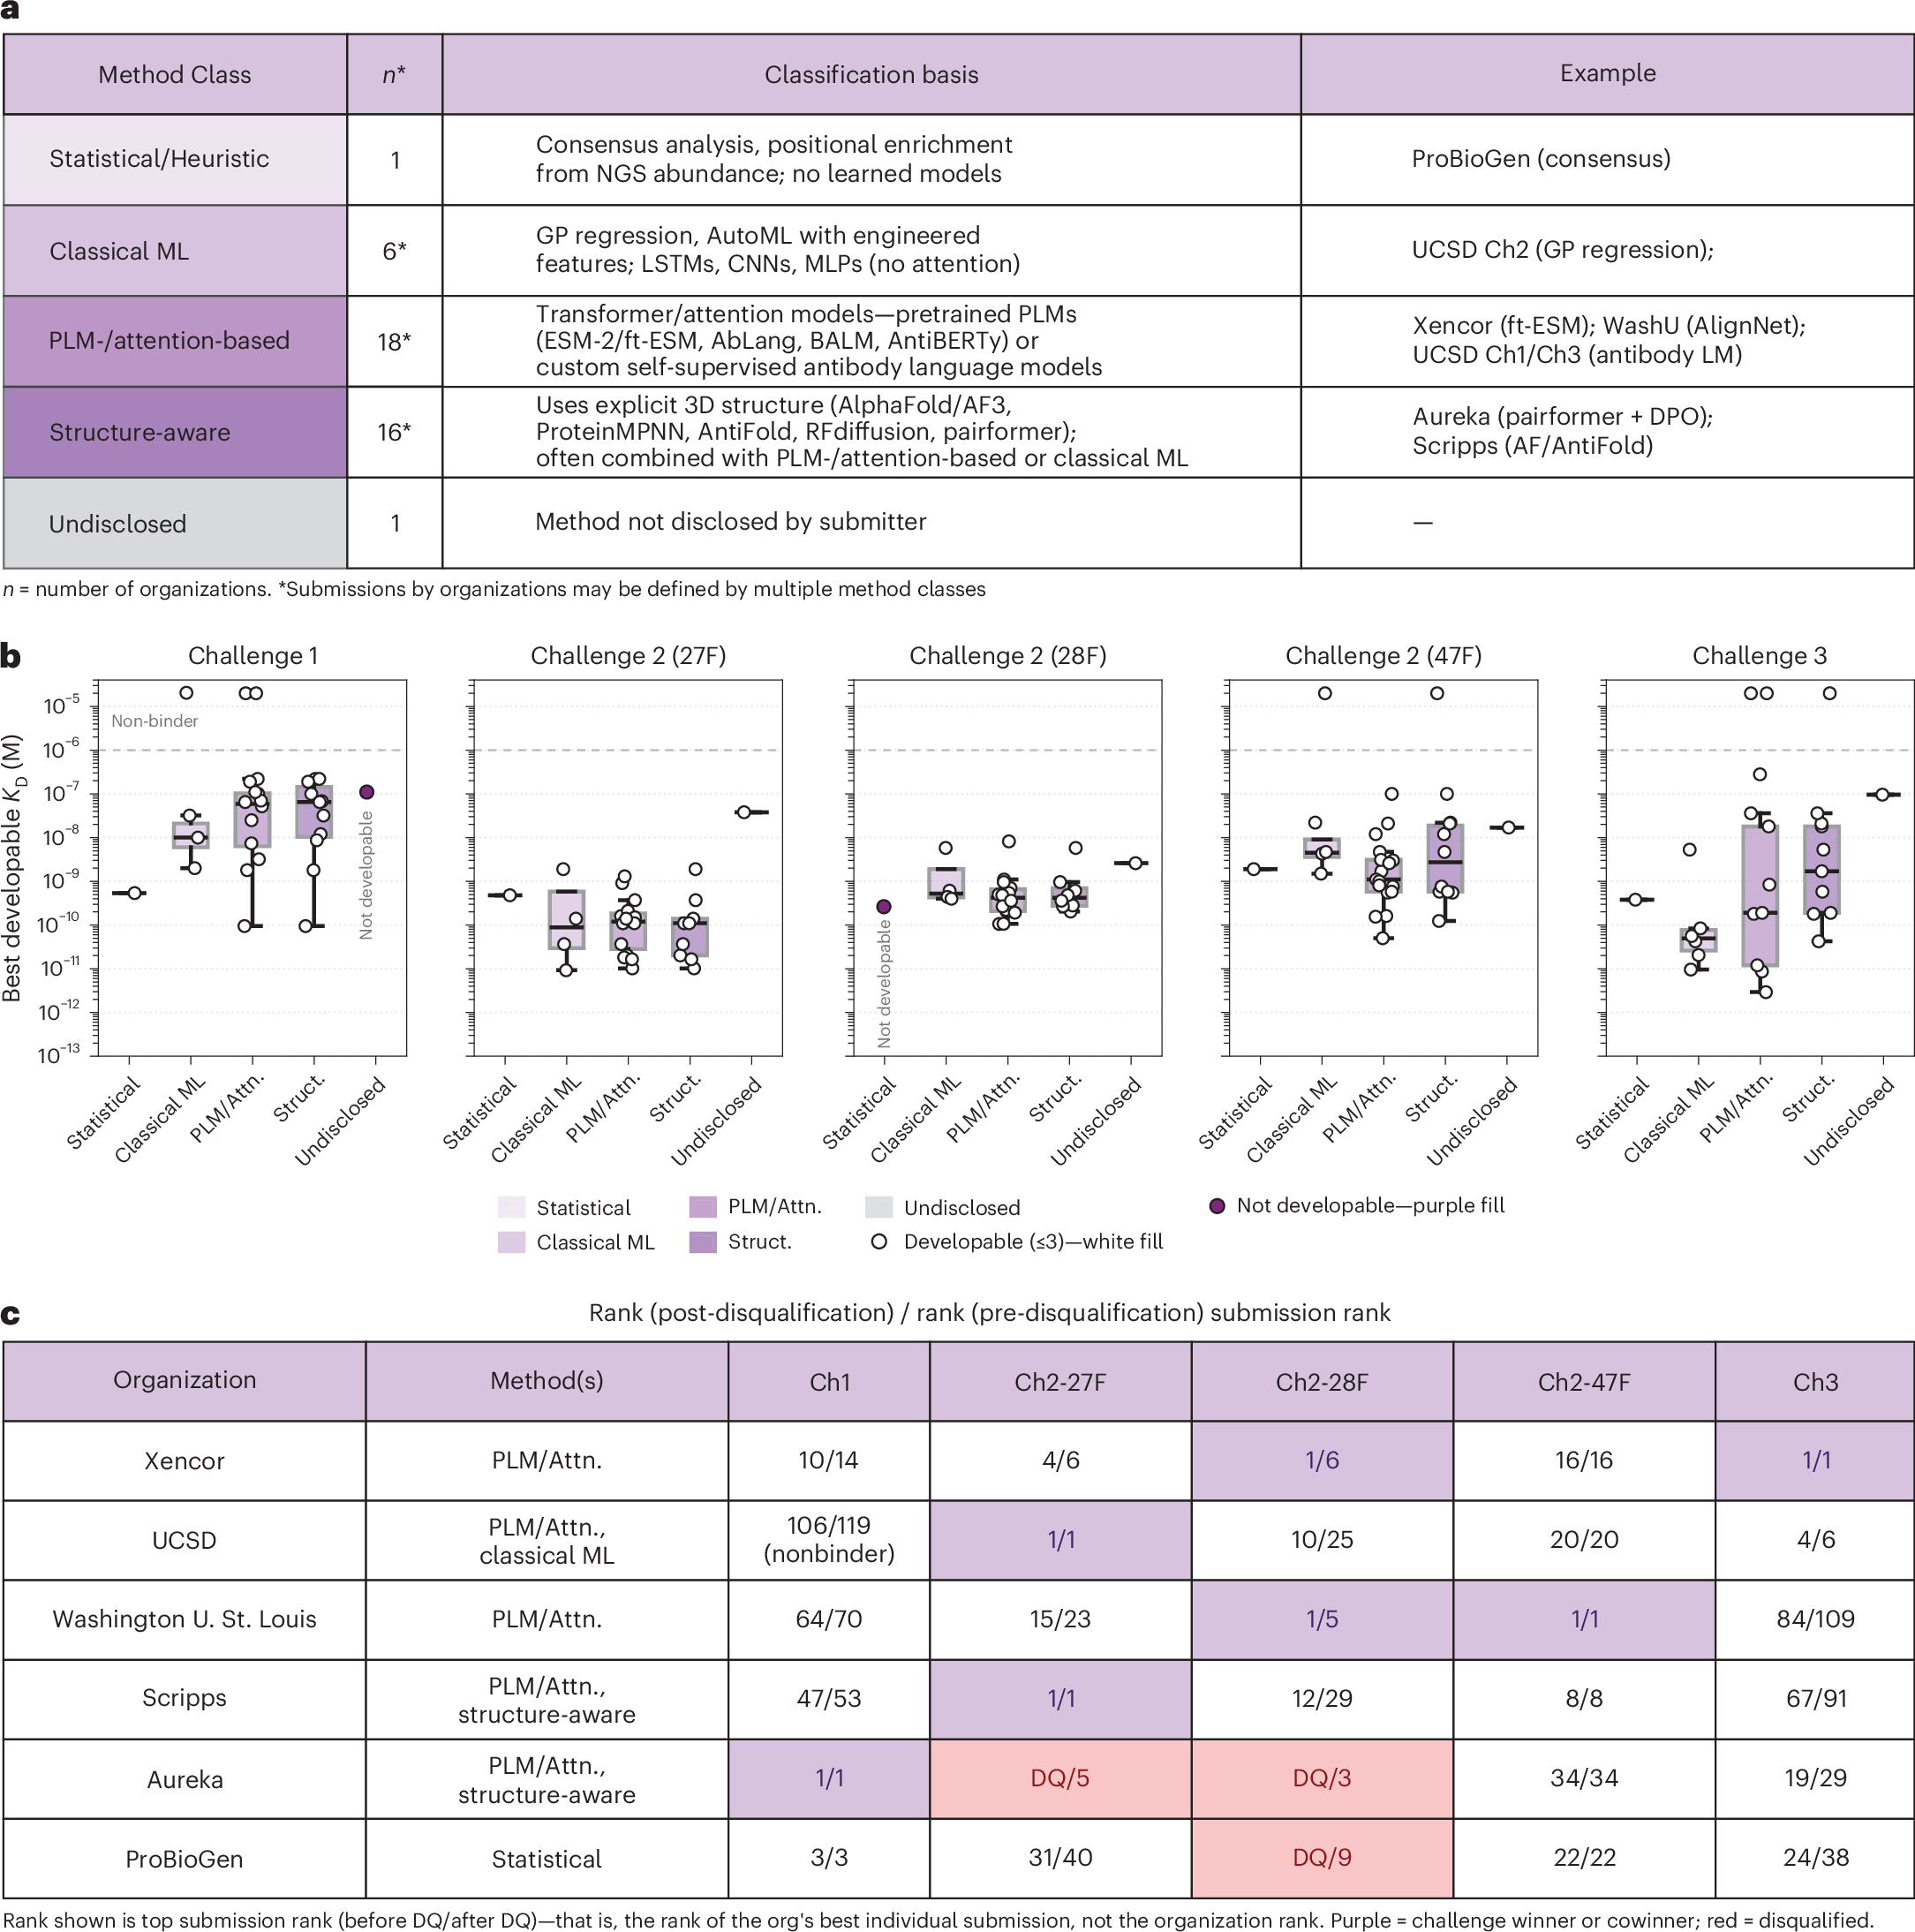
Fig. 5c 的跨任务排名表是本页「没有方法跨任务成立」这句话的依据:Xencor 在 28F 簇和文库外设计都是第一,却在 47F 簇排 16/16;UCSD 拿下 27F 簇,在任务一的最好提交却不结合;圣路易斯华盛顿大学赢了两个簇,文库外设计排 84/109;Aureka 赢了任务一,在两个簇上被判失格。来源:Erasmus 等,Nature Biotechnology,CC BY 4.0。 [S1]
05我从中学到什么
- 可迁移的洞见
- 盲测把「模型值不值」变成按任务回答:同一家在一项上追平实验室,在另一项上输给随机。
- 设计启发
- 先写下便宜的基线再决定上不上模型:这里它排第三。
- 阅读启发
- 看到命中率,先问同一批序列里随机抽取是多少,再问谁测的。
- 接下来看
- 2026 年下一轮:当场公布靶点、不给结合数据,那才检验发现。
基线决定一条结果值多少
任务二里 AI 的改进率看着不低(9.8% 到 13.8%),只有把随机抽取的 39% 摆在旁边,这个数字才变成坏消息。基线不是评测的装饰,它是读数的单位。[S1]
评分规则就是激励
复合成药性评分允许一项失败被别处补回来,于是任务三的第一名是一个洗不下色谱柱的分子。作者说下一轮会加红线。任何把多项指标压成一个数的评测都要回答同一个问题:哪一项失败不该被抵消。[S1]
这条结论会在两种情况下加强:下一轮不给结合强度数据、换一个陌生靶点,而同一批模型仍能在优化任务上追平实验室;或者有第三方在别的靶点上重复这次的排序结果。它会在两种情况下减弱:获胜方法被发现依赖这一个靶点的公开数据;或者更多团队参赛后,排序大幅改写。
对本站记录的影响也要说一句:现在时间线上好几条抗体设计条目报的是各家自己的命中率(Latent Labs 的 91 到 100%、Aureka 的 80 个设计中 38 个结合、Anthropic 的 211 个中 17 个)。这一轮没有推翻它们中的任何一条,但它给了一把尺子:没有盲测和基线的命中率,读的时候要知道自己在读什么。
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。