

论文与仿真
大语言模型写出电池快充策略,模拟中比多段恒流多保住约 4 个百分点的健康度
帝国理工的 Ge Lei 和 Samuel Cooper 等人让 GPT-5 根据一段文字写成的限制条件,直接写出充电策略的代码,或者设计一个小神经网络再交给贝叶斯优化调参。在一个加速老化的电池模型里,两种做法都比三段恒流方案多保留约 4.2 个百分点的健康度。它改变的是“搜什么”,而不是“怎么搜”;全部结果都在模拟里。
●同行评审论文 + 模拟
当前边界:在一个加速老化的模拟电芯上胜过三段恒流基线;真实电芯、其他化学体系、与强化学习等方法的比较都还没有
92.17% / 92.10%最好策略的最终健康度(P2O
87.93%三段恒
100 个加速老化的模拟循环后;P2P 用的评估次数与基线相同(210
- 认知更新
- 评估又慢又贵时,大语言模型的用处在于提出新的策略形式,而不是代替优化器调
数字。 - 最强证据
- 同一模拟器、同样约束、同样评估次数下与基线对比,每种方法跑
10 次。 - 关键限制
- 全部是一个模拟电芯,老化被人为加速;没有任何策略在真实电芯上
跑过。
01发生了什么
- 任务
- 30 分钟从 0 充到 90%,电压不超过 4.2 V,100 个循环后健康度尽
量高。 - 方法
- GPT-5 读文字写的限制:P2P 直接写出电流函数;P2O 写一个小神经网络,由贝叶斯优化(SAASBO)
调参。 - 交互对象
- 只有软件:策略代码在 PyBaMM 电化学与老化模型里运行,没有接触真实
电池。 - 结果
- 两者都胜过三段恒流基线;同等预算下 P2P 最好,P2O 多花评估后
略高。
210每次运行的评估次数(每次评估 = 100 个充放电
> 99%模型写出的候选能直接运行
4.2 V写进提示词的电
Ge Lei、Ferran Brosa Planella、Sterling G. Baird 和 Samuel J. Cooper 的论文 2026 年 10 月 11 日发表在 Advanced Science,开放获取(CC BY 4.0);预印本 2026 年 1 月 14 日以“From Prompt to Protocol”为题挂在 arXiv。Lei 和 Cooper 在帝国理工戴森设计工程学院,Brosa Planella 在法拉第研究所和华威大学,Baird 在多伦多大学的 Acceleration Consortium
论文提出两条路线。P2P(Prompt-to-Protocol,单层循环)让大语言模型直接写出完整的充电策略代码,每个候选拿去模拟、打分,好的留在池子里作为下一轮的“父本”。P2O(Prompt-to-Optimizer,两层循环)让模型写一个小神经网络作为策略的形式,内层用 SAASBO 这种贝叶斯优化在不求梯度的情况下调网络参数,外层再让模型根据得分改网络结构。所有实验用的都是 GPT-5(2025-08-07 版本,推理强度中等);提示词里只写电压、电流和时间这类运行限制,不告诉模型电芯的化学体系和参数。作者说没有手工修改任何模型生成的代码,超过 99% 的候选能直接
三个由简到繁的案例:一是拟合预先给定的发热曲线,用简单的等效电路模型,只检验外层的结构搜索;二是找出让电芯在一小时充电里保持 0.4 W 恒定发热的电流,用 DFN 电化学模型,检验内层的无梯度调参;三是真正的快充问题,在带热模型和老化子模型(SEI 生长、颗粒开裂等)的 DFN 模型里,30 分钟从 0 充到 90%,跑 100 个循环后看健
92.17% / 92.10% / 87.93%
第三个案例里 P2O、P2P 和三段恒流基线最好结果的最终
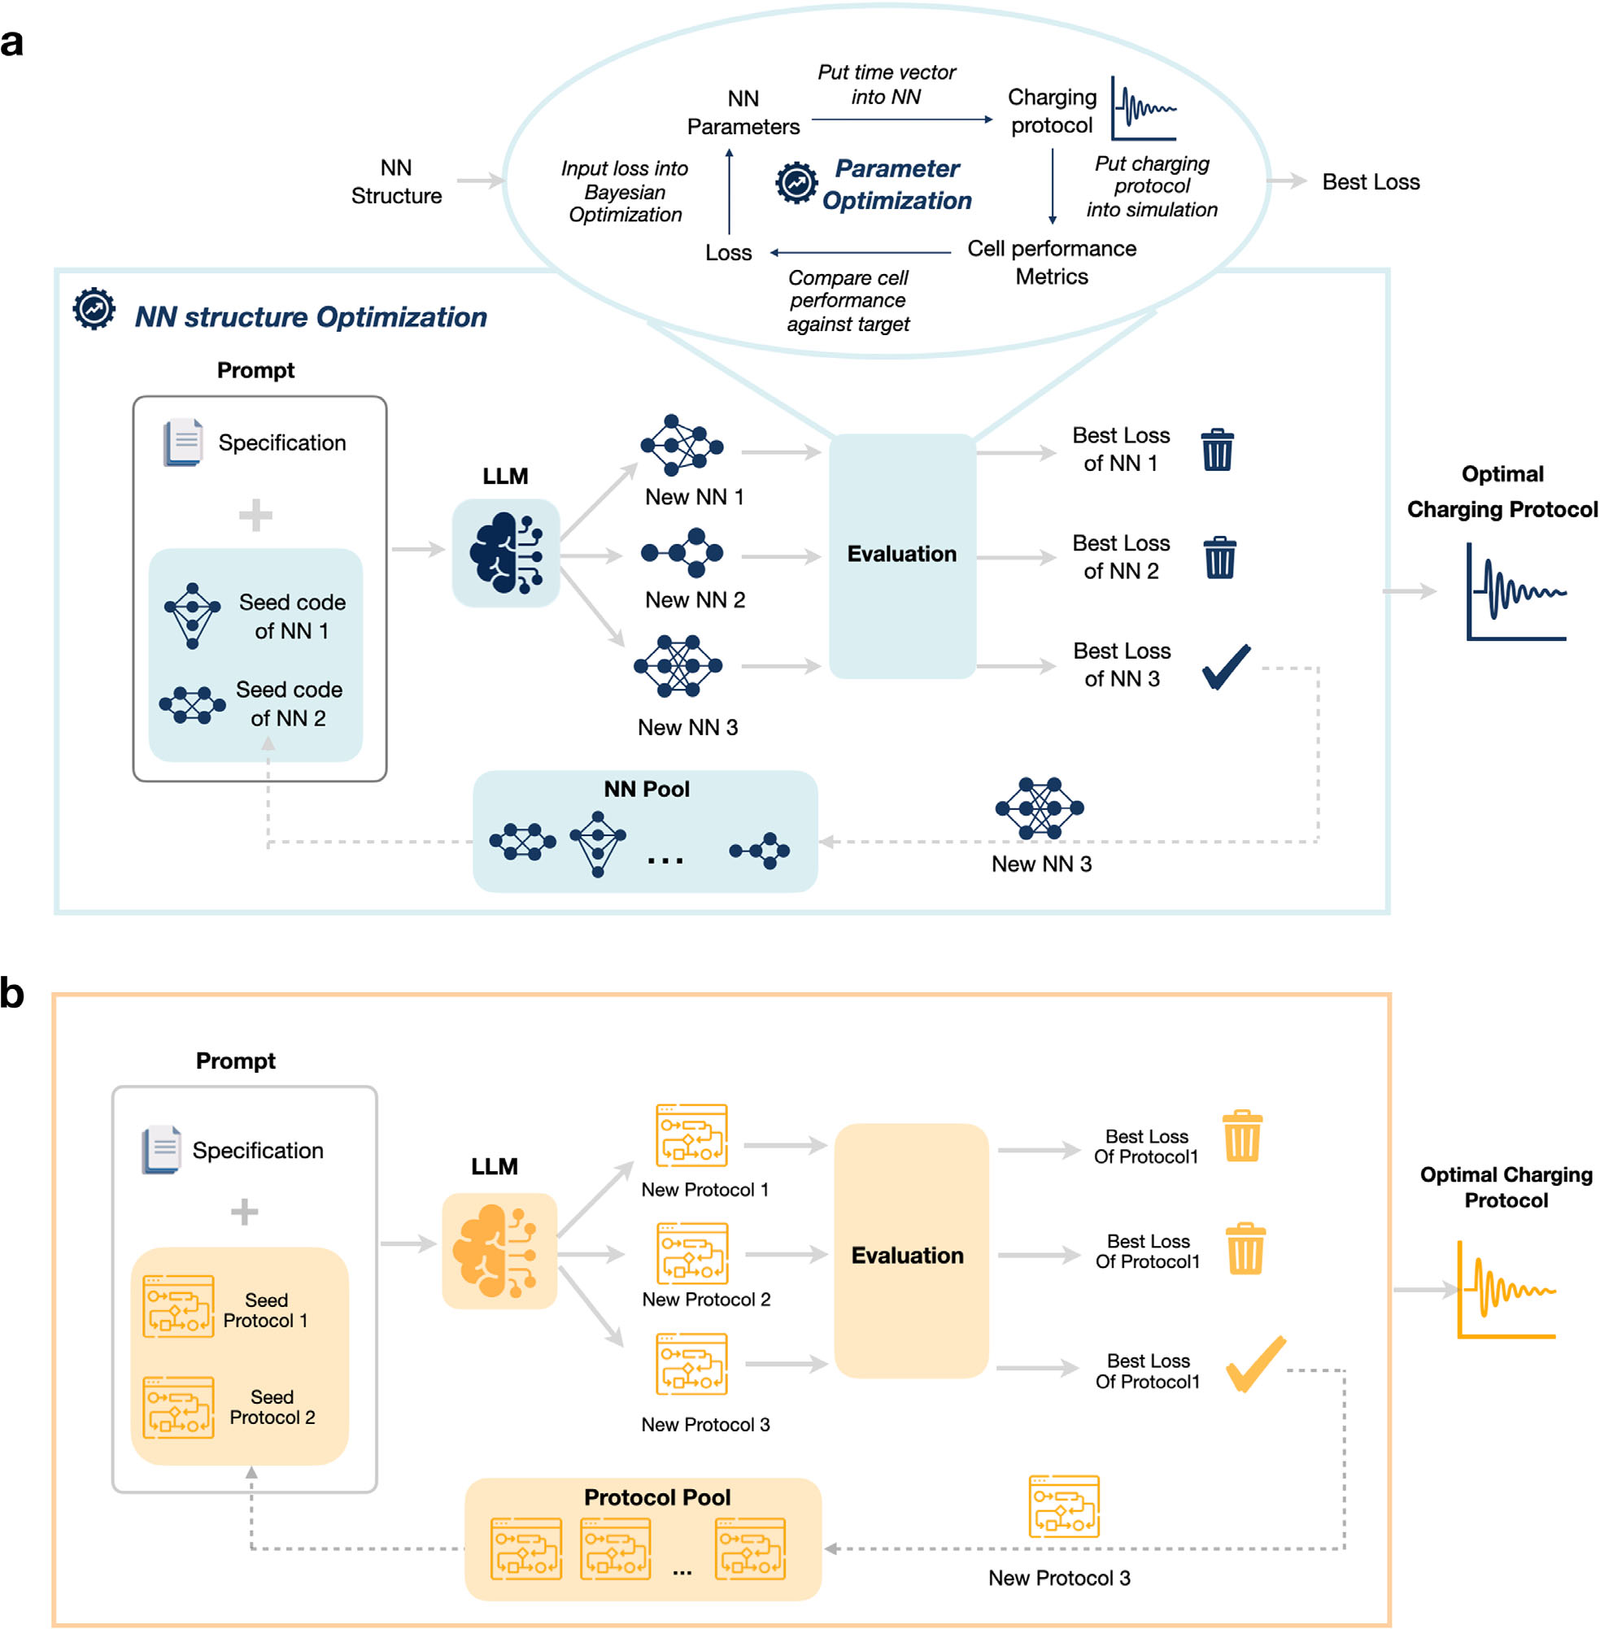
Fig. 1:(a) P2O:大语言模型生成并改进神经网络结构,内层用 SAASBO 调参;(b) P2P:大语言模型直接生成完整的充电策略,没有内层优化。 [S1]
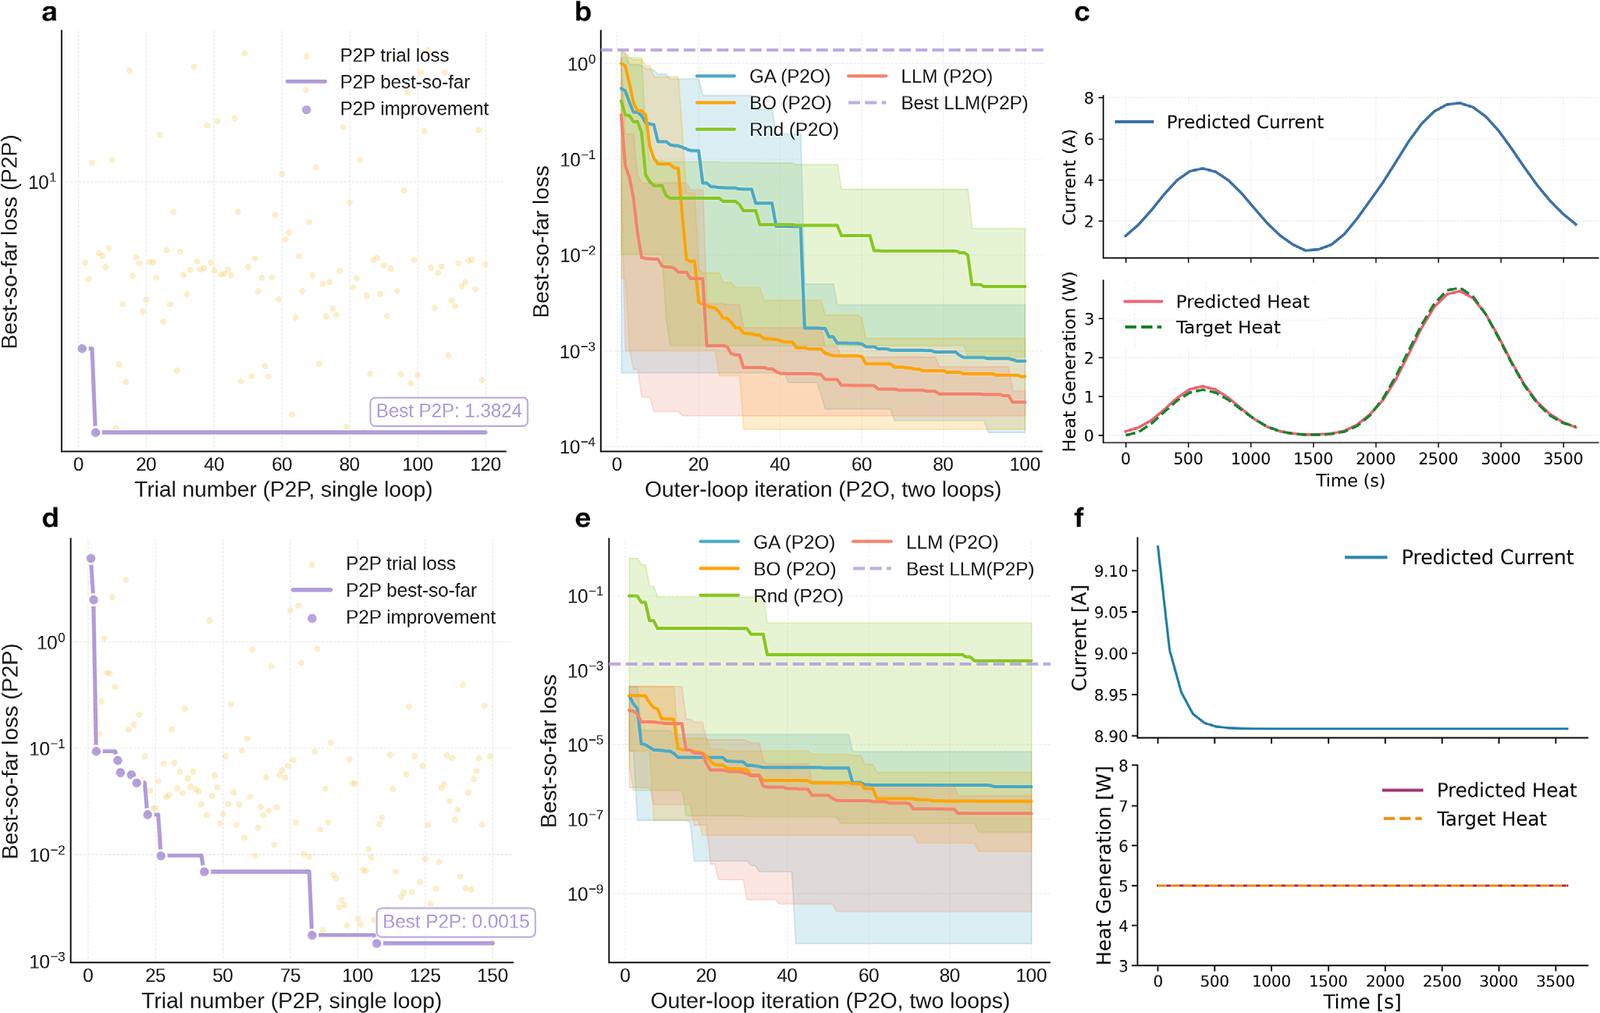
Fig. 2:第一个案例。复杂的预设曲线上,由大语言模型改结构的 P2O 在 20 次迭代内把损失降了近两个数量级,快于贝叶斯优化、遗传算法和随机搜索;简单的恒定发热任务里差别小得多。 [S1]
02改变了什么
流程更新快充优化通常只在几种固定形状里搜,比如三段恒流:评估慢,参数多了调
大语言模型按文字限制提出新的策略形式,反馈选出好的;安全限制写进提示词,不靠
限制写在文字里,候选一开始就更守规矩
作者把 P2P 在同等预算下的优势归于提示词:提示里写明超过 4.2 V 会被扣分,模型提出的候选在数值评估之前就倾向于守住电压。P2O 的神经网络没法直接表达这种文字约束,只能靠内层一次次试参数去发现,所以要多花评估、改进外层结构之后才追上并略超 P2P。作者据此给出分工:关键约束能用文字说清时,P2P 效率高;需要系统地调许多连续参数时,P2O
最好的 P2P 策略在电量和电压还低时用大电流充,接近高电量、高电压区时逐步降低电流,并在端电压接近 4.20 V 时明显压低。作者认为健康度的改善至少部分来自把充电量挪到不易引起老化的低电压区,但也说明模拟没有把各个老化机制的贡献
第二个案例里,作者用 PyBaMM 直接算出保持 0.4 W 恒定发热所需的参考电流(优化时不用),优化出的电流与它基本重合;P2P 在约 150 次试验内取得有效优化,前 50 次进步最快,结果介于 SAASBO 和随机搜索之间。作者也指出,这种已知答案的检验在真实实验或更复杂的模拟里做
03为什么重要
做快充方案的团队可以先让大语言模型在模拟里提出策略,把少量真实电芯测试留给最有希望的
- 每次评估都要跑 100 个循环,“搜什么形状”比“怎么调参”更决定
结果。 - 框架不需要梯度,作者说模拟器原则上可以换成真实电芯循环
测试。
04证据状态与边界
证据等级 2 / 5 · 算出来了证据状态
已证实
- 同等 210 次评估下 P2P 胜过三段恒
流基线 - 多花评估后 P2O 略
高于 P2P - 案例二的优化电流与独立算出的参考电
流吻合
边界
有迹象
- 改善部分来自避开高电压区(作者的
解读) - 加速老化不改变方案排序(3 个方案的
检查)
未知
- 在真实电芯上是
否成立 - 换化学体系是
否成立 - 与强化学习相
比如何 - 换一种提示词写法能
否复现
主张同样 210 次评估,P2P 的损失(越低、健康度越高)低于基线,10 次运行波动
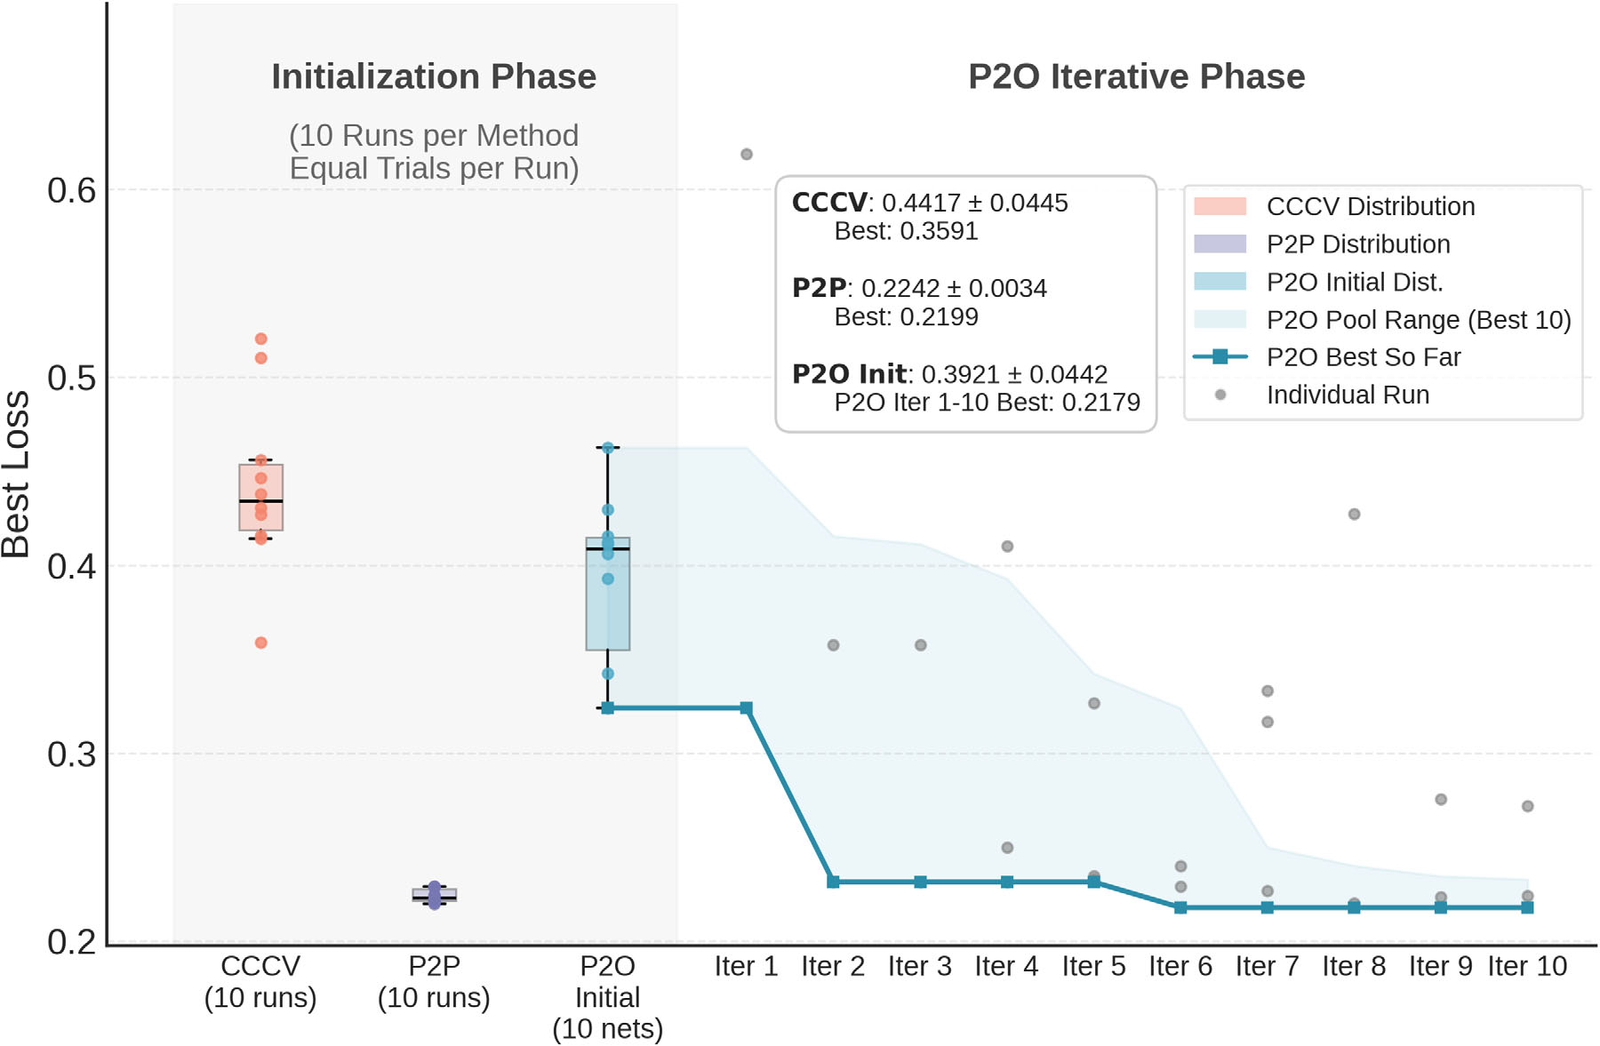
读法只有左侧是同等预算:基线均值 0.4417,P2P 0.2242;右侧 P2O 多跑了迭代,最好
基线是什么,以及把它加复杂之后。
基线参照 Attia 等人的多段恒流方法:三个恒流段分别在 20%、40%、60% 电量处切换,同样 30 分钟充到 90%。它只有三个参数,表达力比大语言模型的方案弱。作者把它加到 35 段,让可调自由度相当,但同样预算下这个高维的分段恒流很难优化,健康度轨迹出现明显的锯齿。作者的结论是分段太少会限制解空间,太多又难调,除非另加平滑约束或专门的优
老化是怎么加速的。
电芯参数取自 Ai2020 数据集。为了在可行的运行时间里看到老化,作者把 SEI 反应交换电流密度放大五倍,并调整了电极损失、颗粒开裂速率、换热系数和环境温度。为了确认这种加速不改变方案优劣的排序,他们挑了三个代表性方案,在不加速的条件下模拟 1000 个循环,排序保持一致。由于模型不包含所有有害副反应(如电解液氧化、过渡金属溶解),他们另加了一个电压惩
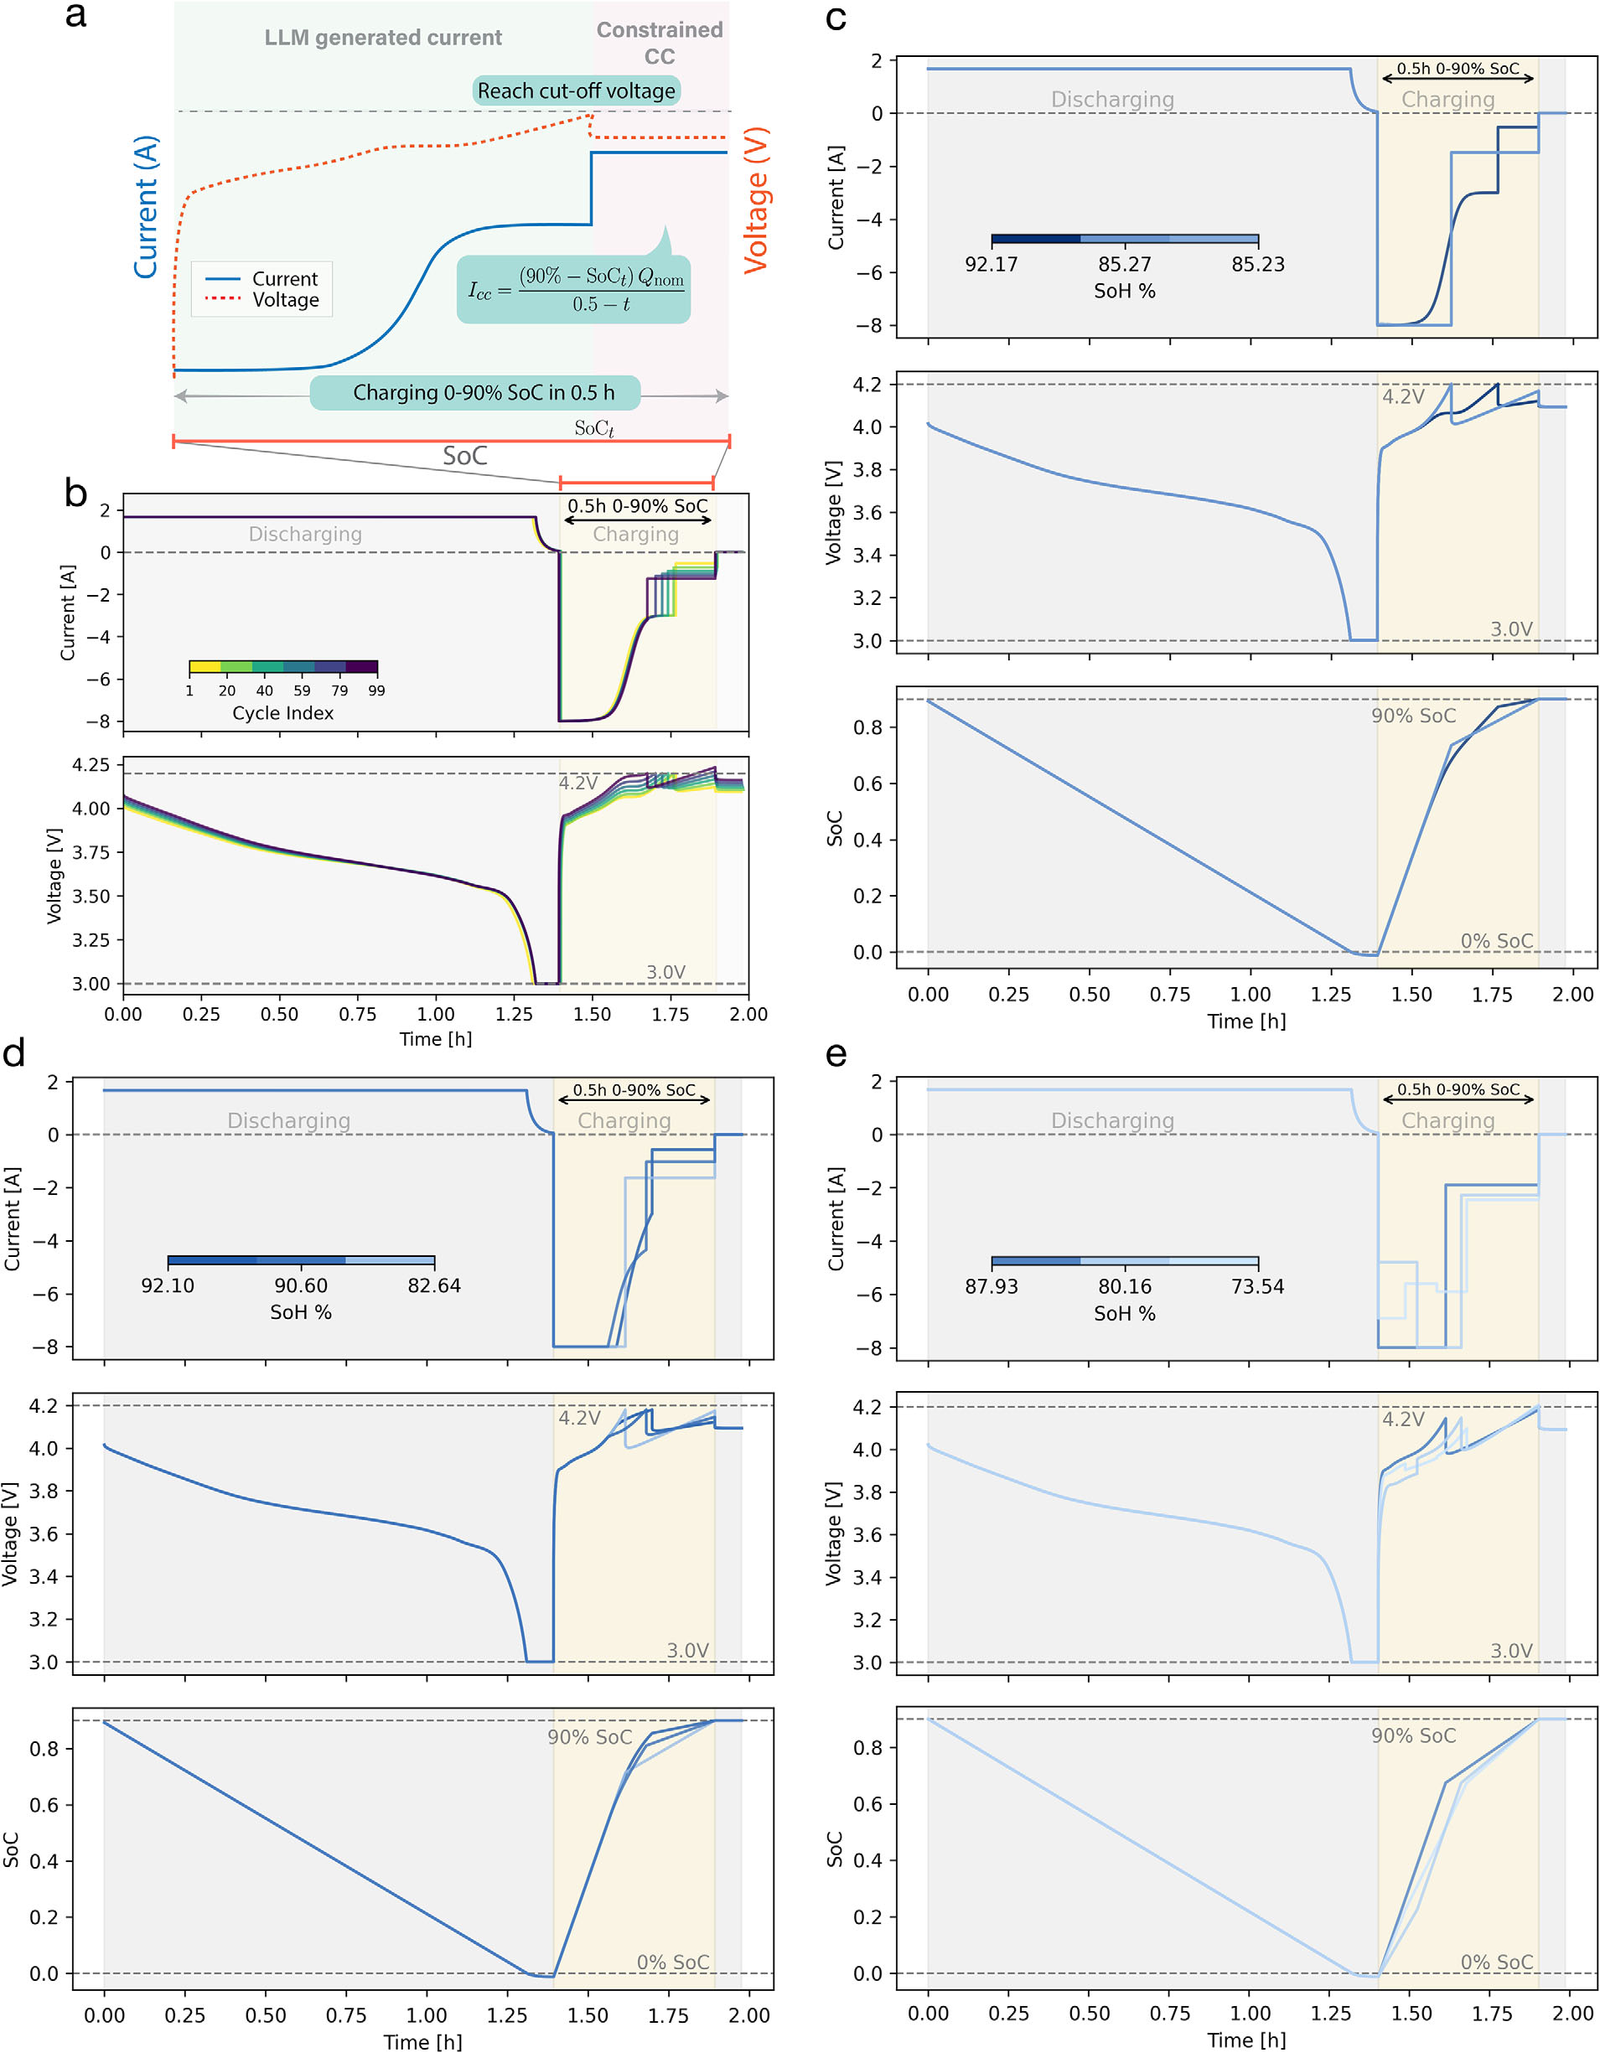
Fig. 5:充电阶段由模型生成的变电流段加一段受约束的恒流组成;(c)(d)(e) 分别是 P2O、P2P 和三段恒流的最好、中间和最差轨迹,色条标出 100 个循环后的健康度。 [S1]
05我从中学到什么
- 可迁移的洞见
- 评估很贵时,瓶颈常是“搜索空间由谁定”;大语言模型能提出空间,不只在空间里
找点。 - 设计启发
- 一句话说得清的约束(电压上限)写进提示词;精细数值交给优
化器。 - 阅读启发
- 先找同等预算的那张图:只有 Fig. 4 左侧是公平
比较。 - 接下来看
- 同一流程在真实电芯上的结果;与强化学习的同预算
比较。
同一个课题组的另一篇论文给它补了一条注意事项
Ge Lei 和 Samuel Cooper 2026 年 5 月的预印本《Elicitation Matters》发现,用大语言模型当代理模型时,提示词的措辞和提问格式会改变它的预测和置信度,进而改变被选中的实验。放到这篇快充论文里,意思是 P2P 的好结果与它的提示词写法分不开,换一种写法未必能
这条线背后有一家公司
Samuel Cooper 是帝国理工的材料设计人工智能教授,也是 2023 年从他课题组拆分出来的 Polaron 的联合创始人和首席科学家;Ge Lei 自 2025 年 6 月起在 Polaron 兼职做大语言模型工程师。论文本身没有提到 Polaron,也没有说这套方法在公司里怎
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。