

论文与数据集
GPT-4o 读了 83,910 篇生态学论文,提取出 144,402 条物种相互作用,精确率 89.5%、召回率 70%
苏黎世大学和 Eawag 的 François Keck、Henry Broadbent 与 Florian Altermatt 搭了一条流程:先筛出同时提到两个物种和一个相互作用词的段落,交给 GPT-4o 按固定表格提取“谁对谁做了什么”,再把每个名称对到 NCBI 分类库,对不上的丢掉。人工核对 500 个随机段落,它报告的相互作用 89.5% 是对的,文中实有的找到了 70%。整次运行约花 582 美元。标注只有一人,网络带着文献本身的偏向。
●论文 + 数据集 + 人工抽查
当前边界:标注只有一人;十条相互作用漏掉三条;检验的是“论文里是否这样写”,不是自然界里是否如此;模型闭源
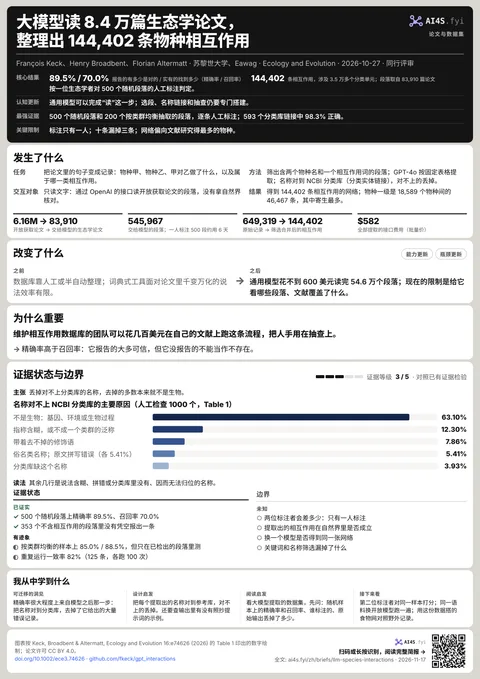
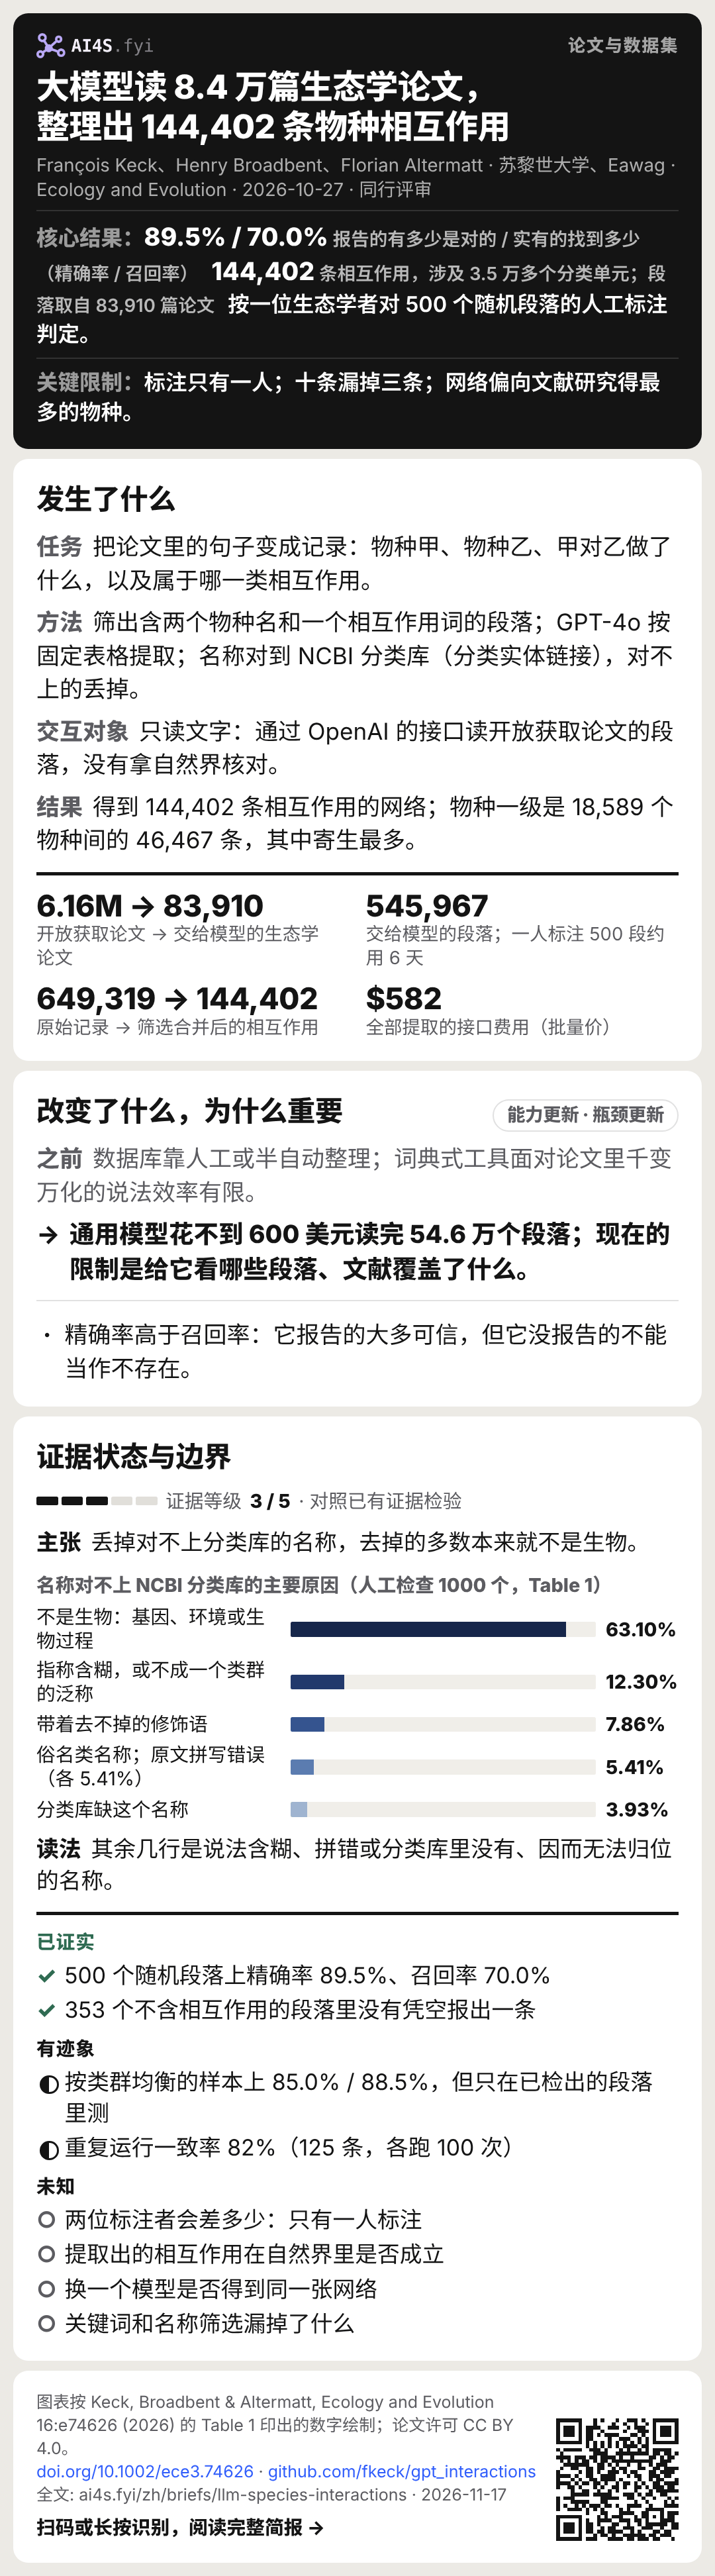
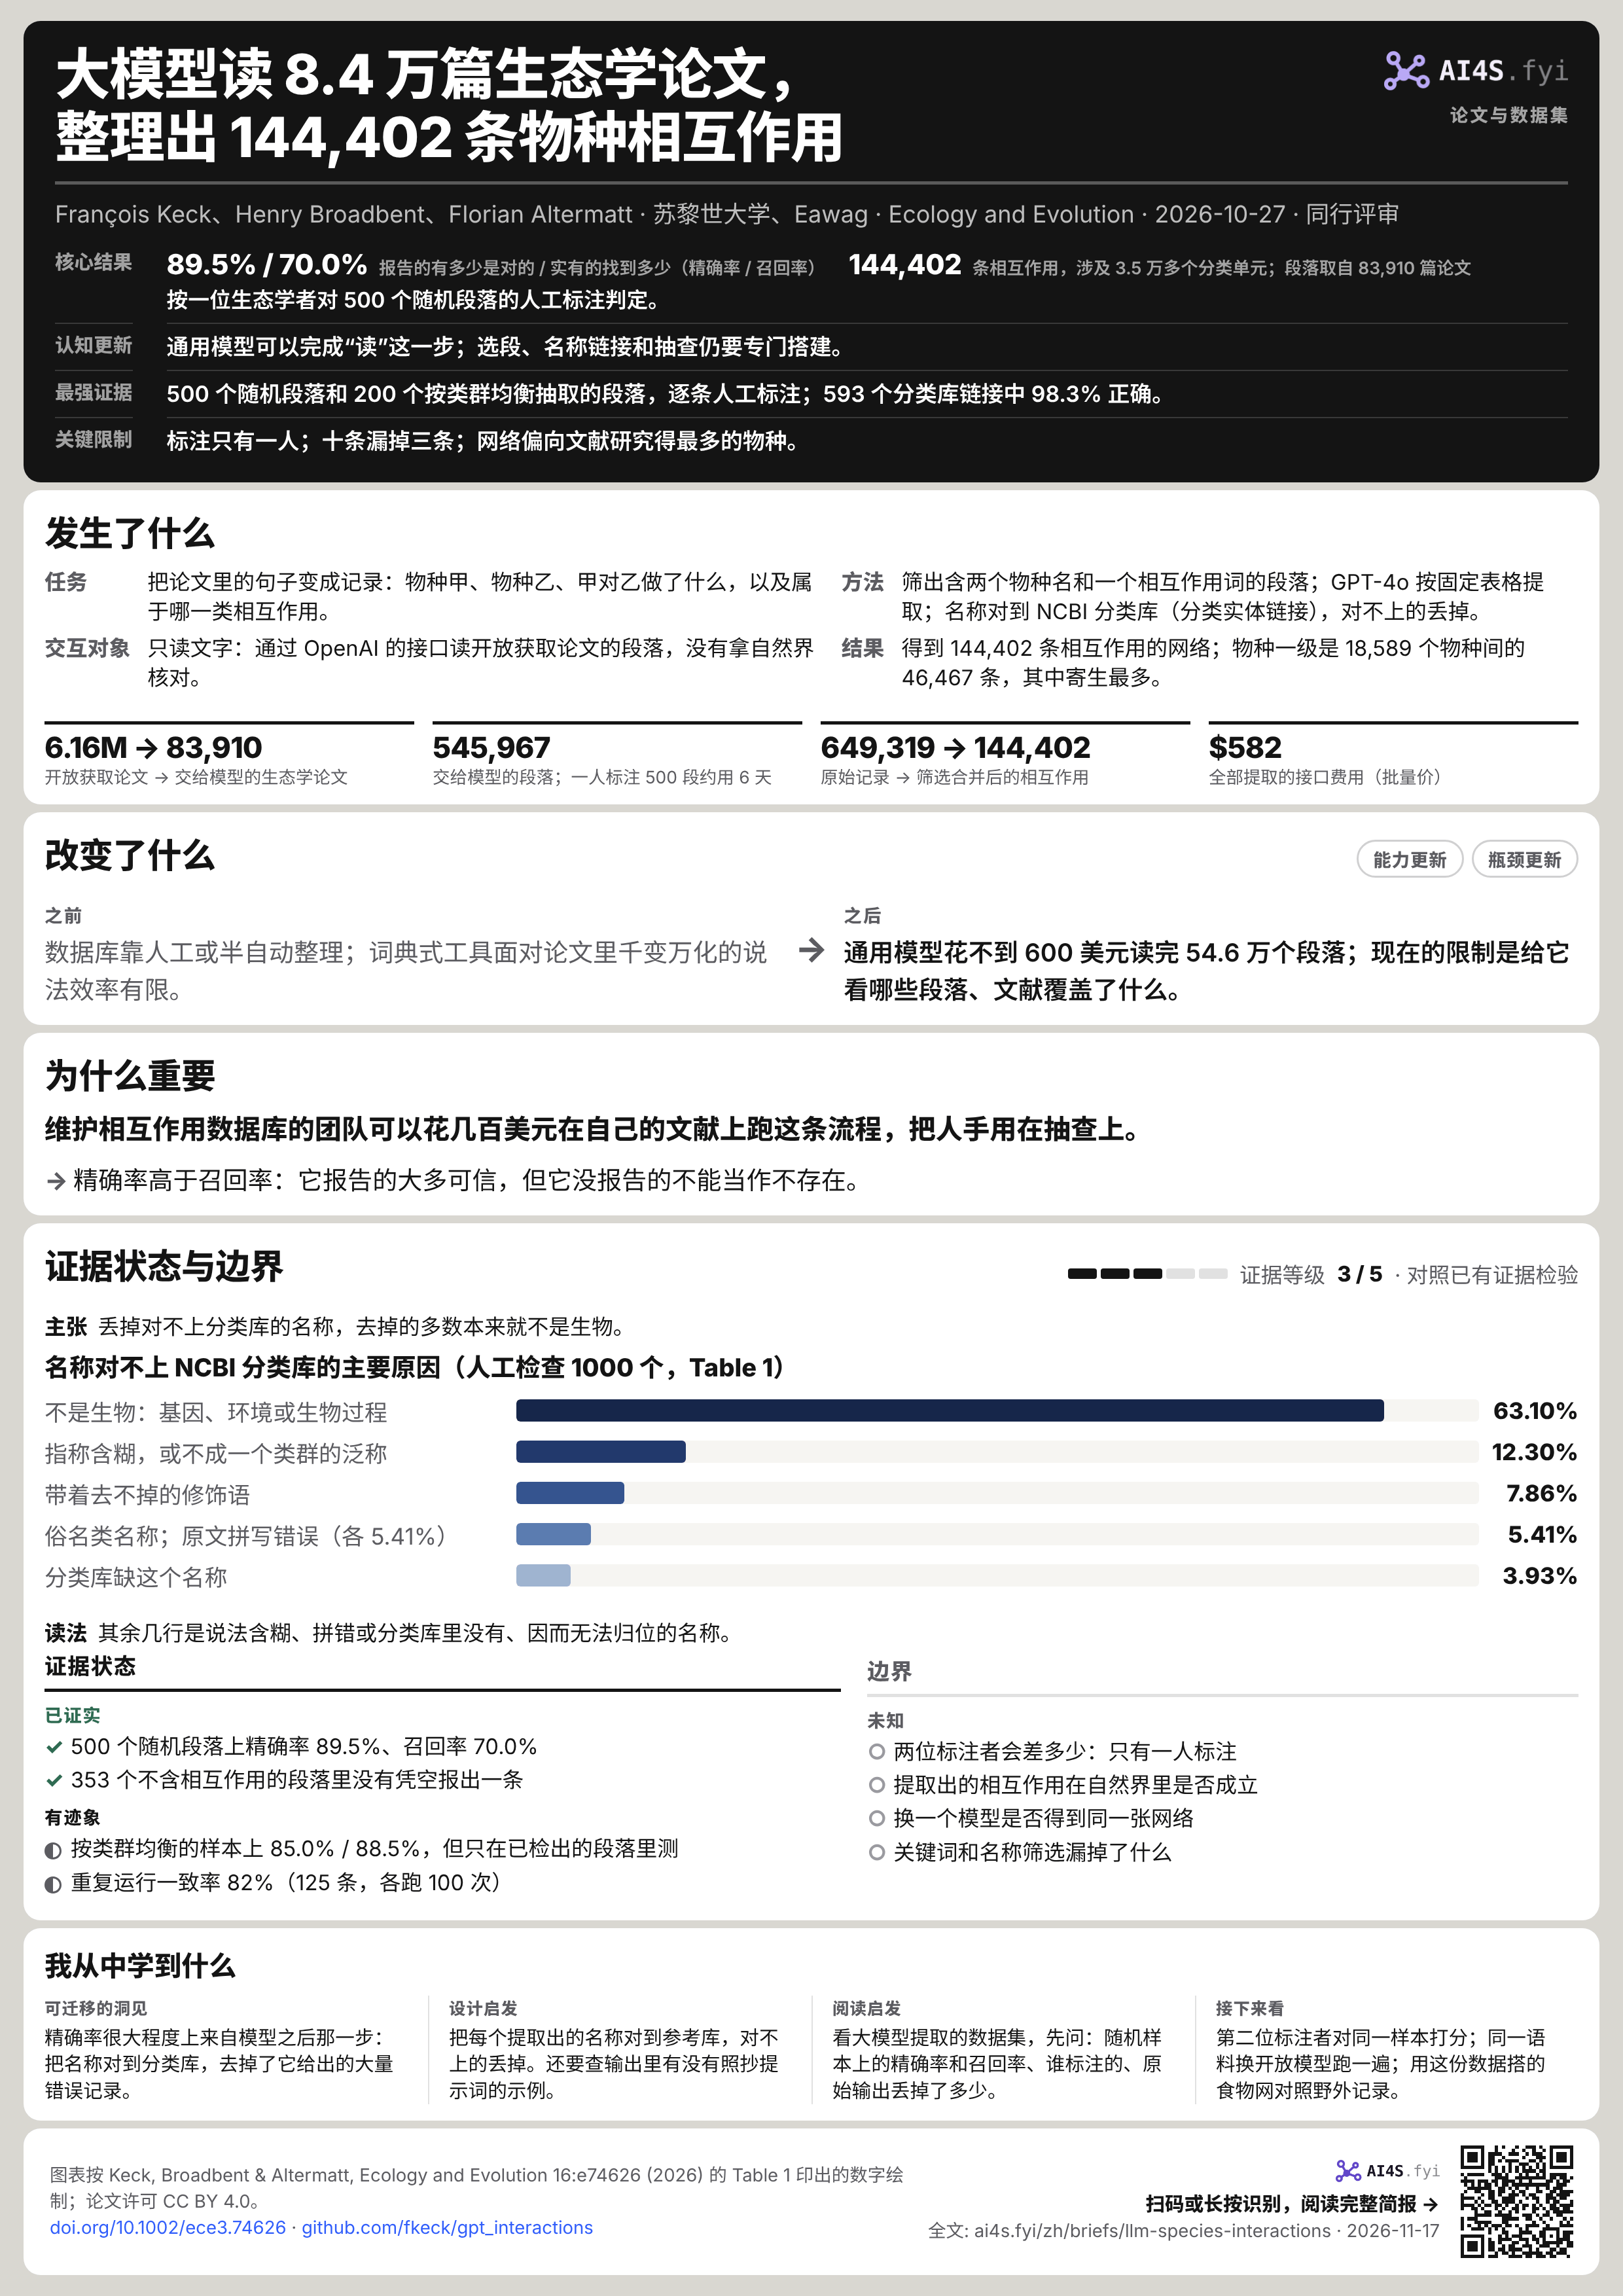
89.5% / 70.0%报告的有多少是对的 / 实有的找到多少(精确率 / 召
144,402条相互作用,涉及 3.5 万多个分类单元;段落取自 83,910
按一位生态学者对 500 个随机段落的人工标注
- 认知更新
- 通用模型可以完成“读”这一步;选段、名称链接和抽查仍要专门
搭建。 - 最强证据
- 500 个随机段落和 200 个按类群均衡抽取的段落,逐条人工标注;593 个分类库链接中 98.3%
正确。 - 关键限制
- 标注只有一人;十条漏掉三条;网络偏向文献研究得最多的
物种。
01发生了什么
- 任务
- 把论文里的句子变成记录:物种甲、物种乙、甲对乙做了什么,以及属于哪一类相互
作用。 - 方法
- 筛出含两个物种名和一个相互作用词的段落;GPT-4o 按固定表格提取;名称对到 NCBI 分类库(分类实体链接),对不上的
丢掉。 - 交互对象
- 只读文字:通过 OpenAI 的接口读开放获取论文的段落,没有拿自然界
核对。 - 结果
- 得到 144,402 条相互作用的网络;物种一级是 18,589 个物种间的 46,467 条,其中寄生
最多。
6.16M → 83,910开放获取论文 → 交给模型的生态
545,967交给模型的段落;一人标注 500 段
649,319 → 144,402原始记录 → 筛选合并后的相
$582全部提取的接口费用(批
论文 2026 年 10 月 27 日在线发表于 Ecology and Evolution(第 16 卷第 11 期,e74626),5 月 28 日投稿,9 月 29 日接受,许可为 CC BY 4.0。三位作者都署苏黎世大学进化生物学与环境研究系和 Eawag(瑞士联邦水科学与技术研究所)水生生态系;François Keck 是通讯作者,负责构思、数据、分析和软件,Florian Altermatt 负责经费和指导。经费来自苏黎世大学和瑞士国家科学基金会。数据和代码在 GitHub(fkeck/gpt_interactions)并存档于
语料是怎么缩小的
起点是 PubMed Central 开放获取库的 6,159,719 篇论文。用 OpenAlex 的主题分类取出标为“Ecology”子领域的 99,555 篇,拆成 3,552,030 个段落。选段落而不是句子,是因为一个相互作用常常跨几句话才说清;不用全文,是因为无关内容太多、费用也高。再用 TaxoNERD(一个识别物种学名和俗名的模型)找出 8,160,227 处名称,并用 43 个相互作用关键词及其变体做正则匹配。同时含有至少两个不同名称和一个关键词的段落留下:545,967 段,来自 83,910 篇论文。作者说这一步宁可多留,但承认关键词表可能漏掉少见的说法,TaxoNERD 在不同类群上的表现也不
提示词和提取
模型是 GPT-4o(2024-05-13 版),温度设为零,其余参数用默认值,每批提交 5 万个请求,没有一个报错。提示词要求先分步推理,给了一个完整示例,用大写和感叹号强调容易漏掉的要求,用 TypeScript 写明输出表格的格式,并要求不要啰嗦。作者说提示词是边看输出边改出来的,没有系统地比较过不同写法。输出是四列:两个物种的名称、文中对相互作用的原话、按 mangal 数据库的类别给出的分类。整次提取用了 414,029,114 个输入 token 和 12,812,317 个输出 token,按 2026 年 2 月的批量价约合 581.6
64.9 万条为什么只留下 14.4 万条
模型给出 649,319 条可能的相互作用,涉及 157,354 个不同的名称,其中 70,841 个能对到 NCBI 分类库。作者只保留两端都能对上的记录,并把同一对节点之间同一类别的记录合并。此外还去掉了两类明显的错误:29 个段落里模型不停重复同一个词直到输出上限;4,272 条记录和提示词里的示例一模一样,作者认为很可能是照抄示例,而不是来自段落。最后的网络有 144,402 条相互作用,来自 36,044 篇论文的 112,647 个段落。节点数在摘要里印的是 36,471,在结果部分印的是
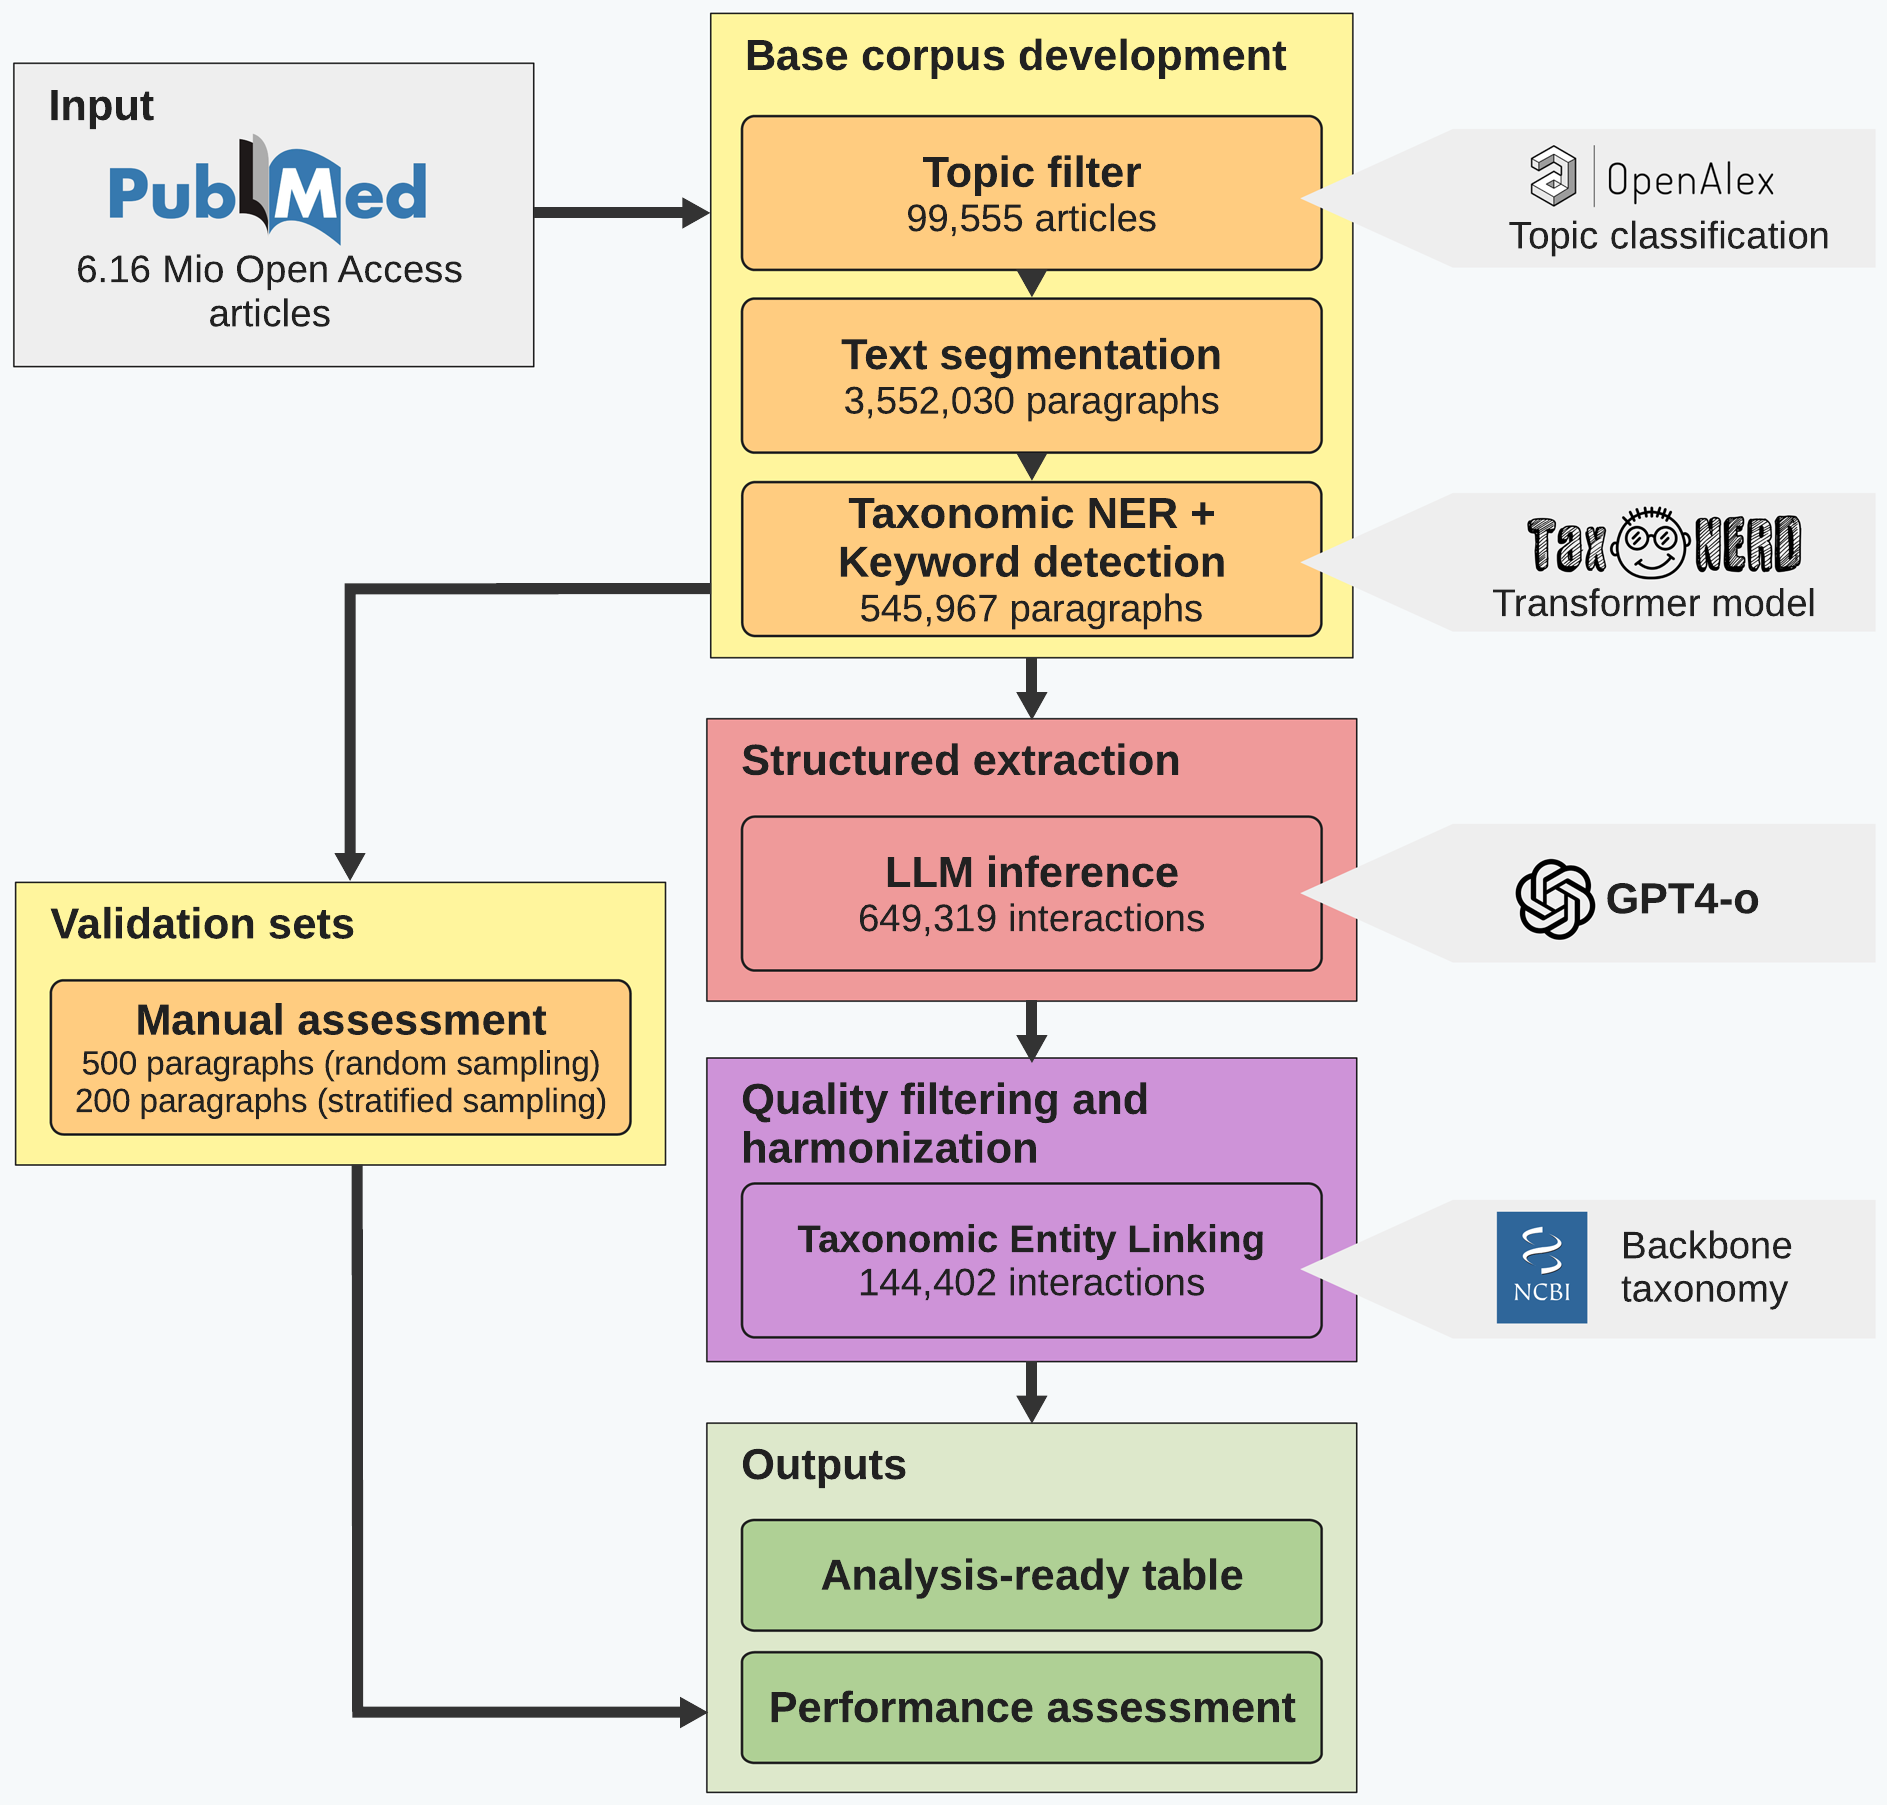
Figure 1:流程图。616 万篇开放获取论文经主题筛选、分段、名称识别和关键词匹配,缩到 545,967 个段落;GPT-4o 给出 649,319 条相互作用;分类实体链接之后留下 144,402 条。左侧是两组人工评估样本。 [S1]
02改变了什么
能力更新瓶颈更新数据库靠人工或半自动整理;词典式工具面对论文里千变万化的说法效率
通用模型花不到 600 美元读完 54.6 万个段落;现在的限制是给它看哪些段落、文献覆盖了
作者在引言里写道,相互作用的表述涉及两个物种和一个有方向的关系,词汇庞杂、说法含糊,词典式方法因此效率有限;按他们的说法,这种复杂性使得此前没有人尝试过大规模自动提取生物相互作用。他们把本文定位为方法上的可行性验证。在结果讨论里他们还写明,模型之后的筛选是必要的:它去掉了模型给出的大量假阳性,例如涉及无关或含糊名称的相互
漏掉的多,编造的少
500 个随机段落里,标注者找到 327 条相互作用。流程找对了 229 条,报错 27 条,漏掉 98 条:精确率 89.5%(95% 置信区间 83.8% 到 94.2%),召回率 70.0%(63.1% 到 76.8%),F1 为 78.6%(72.6% 到 83.5%)。500 段中有 353 段不含任何相互作用,流程在这些段落里一次也没有报出明显不存在的相互作用。作者说漏掉的主要来自模型对整段给了空结果,所以最难的一步是判断“这里有没有相互作用”,而不是之后的命名和
第二组 200 个段落的抽取力求各类群均衡,同一分类单元不重复出现,用来看常见和少见类群上的表现:精确率 85.0%(78.4% 到 91.2%),召回率 88.5%(84.7% 到 92.1%),F1 为 86.7%。作者提醒这一组只从流程已经提取出结果的段落里抽,所以它的召回率是“在已检出的前提下”的表现,不能当作整体召
对不上分类库的名称,大多不是生物
作者人工检查了 1000 个名称。593 个被链接到 NCBI 分类号,其中 98.31% 正确。对不上的名称按原因分:63.10% 根本不是生物,而是基因、环境或生物过程(例如 Glucan);12.30% 指称含糊(例如 Algal grazer populations);7.86% 带着去不掉的修饰语(Small bullfrog tadpoles);5.41% 是俗名或拉丁名派生的普通名词(Coleopteran);5.41% 是原文拼写错误;3.93% 是分类库本身缺这个名称;1.97% 原因不明。文中描述相互作用的原话有 14,767 种不同
03为什么重要
维护相互作用数据库的团队可以花几百美元在自己的文献上跑这条流程,把人手用在抽
- 精确率高于召回率:它报告的大多可信,但它没报告的不能当作不
存在。
作者说标准化的输出可以浏览、查询,或与现有的相互作用库和分类库对接。代码仓库的说明里有 GloBI(Global Biotic Interactions)的索引标记;2026 年 11 月 17 日用 GloBI 的接口按 globi:fkeck/gpt_interactions 查询,可以取回这份数据的
作者自己写明了用闭源模型做科研的两个问题。一是输出不完全可复现:他们把 100 个段落各重跑 100 次,按最细的分类层级看,125 条相互作用的平均一致率是 82%;只看物种一级的 22 条,是 88%。他们建议把“多次运行都出现”当作一个实用的可信度指标。二是模型是黑箱,训练数据和方法不公开,所以只能靠仔细检查输出来验证。他们认为本地运行、经过微调的小型开放模型是一个有希望的方向,还能处理许可更严的文献,但本文没
04证据状态与边界
证据等级 3 / 5 · 对照已有证据检验证据状态
已证实
- 500 个随机段落上精确率 89.5%、召回
率 70.0% - 353 个不含相互作用的段落里没有凭空报
出一条
边界
有迹象
- 按类群均衡的样本上 85.0% / 88.5%,但只在已检出的段
落里测 - 重复运行一致率 82%(125 条,各跑
100 次)
未知
- 两位标注者会差多少:只有一
人标注 - 提取出的相互作用在自然界里是
否成立 - 换一个模型是否得到同一
张网络 - 关键词和名称筛选漏掉
了什么
主张丢掉对不上分类库的名称,去掉的多数本来就不是
名称对不上 NCBI 分类库的主要原因(人工检查 1000 个,Table 1)
读法其余几行是说法含糊、拼错或分类库里没有、因而无法归位的
评估是怎么做的。
比较的是段落级的人工标注和流程的最终输出(经过分类库链接和筛选之后),所以数字反映的是整条流程,不只是模型。两个名称能对到同一个 NCBI 分类号就算同一物种;相互作用的方向要和原文一致;同一段里同一对类群同一类别只算一次;被否定的相互作用不算;推测性的说法逐条判断,只有段落把它当作实际发生的才算。置信区间用以段落为单位的自助法重抽样 1000 次得到。全部标注由一位有生态学背景的标注者完成,每组约用 6 天;因为没有第二位标注者,标注者之间的差异无法
模型是不是靠记忆答的。
提示词明确要求模型不要动用对这些生物的已有知识,但作者承认无法保证预训练里的信息没有影响个别输出,对常见、记载很多的相互作用尤其可能。他们的理由是这不影响评估:一条提取只有在所给段落支持它时才算对,而且每条记录都能追溯到原文。也就是说,不确定的是模型怎么得出答案,而不是留下的相互作用有没有原文
文献的偏向。
结果里出现最多的物种包括人(Homo sapiens)、人类病原体(Escherichia coli、Pseudomonas aeruginosa、Staphylococcus aureus)和家养物种(Canis lupus、Sus scrofa、Bos taurus)。作者写道,提取只能把文献的偏向显示出来,不能纠正它,看这类结果时必须始终记着这一点;他们也说,系统地分析这些偏向本身可以用来研究科研投入和知识空白。作者说明本文的目的不是给出新的生态学
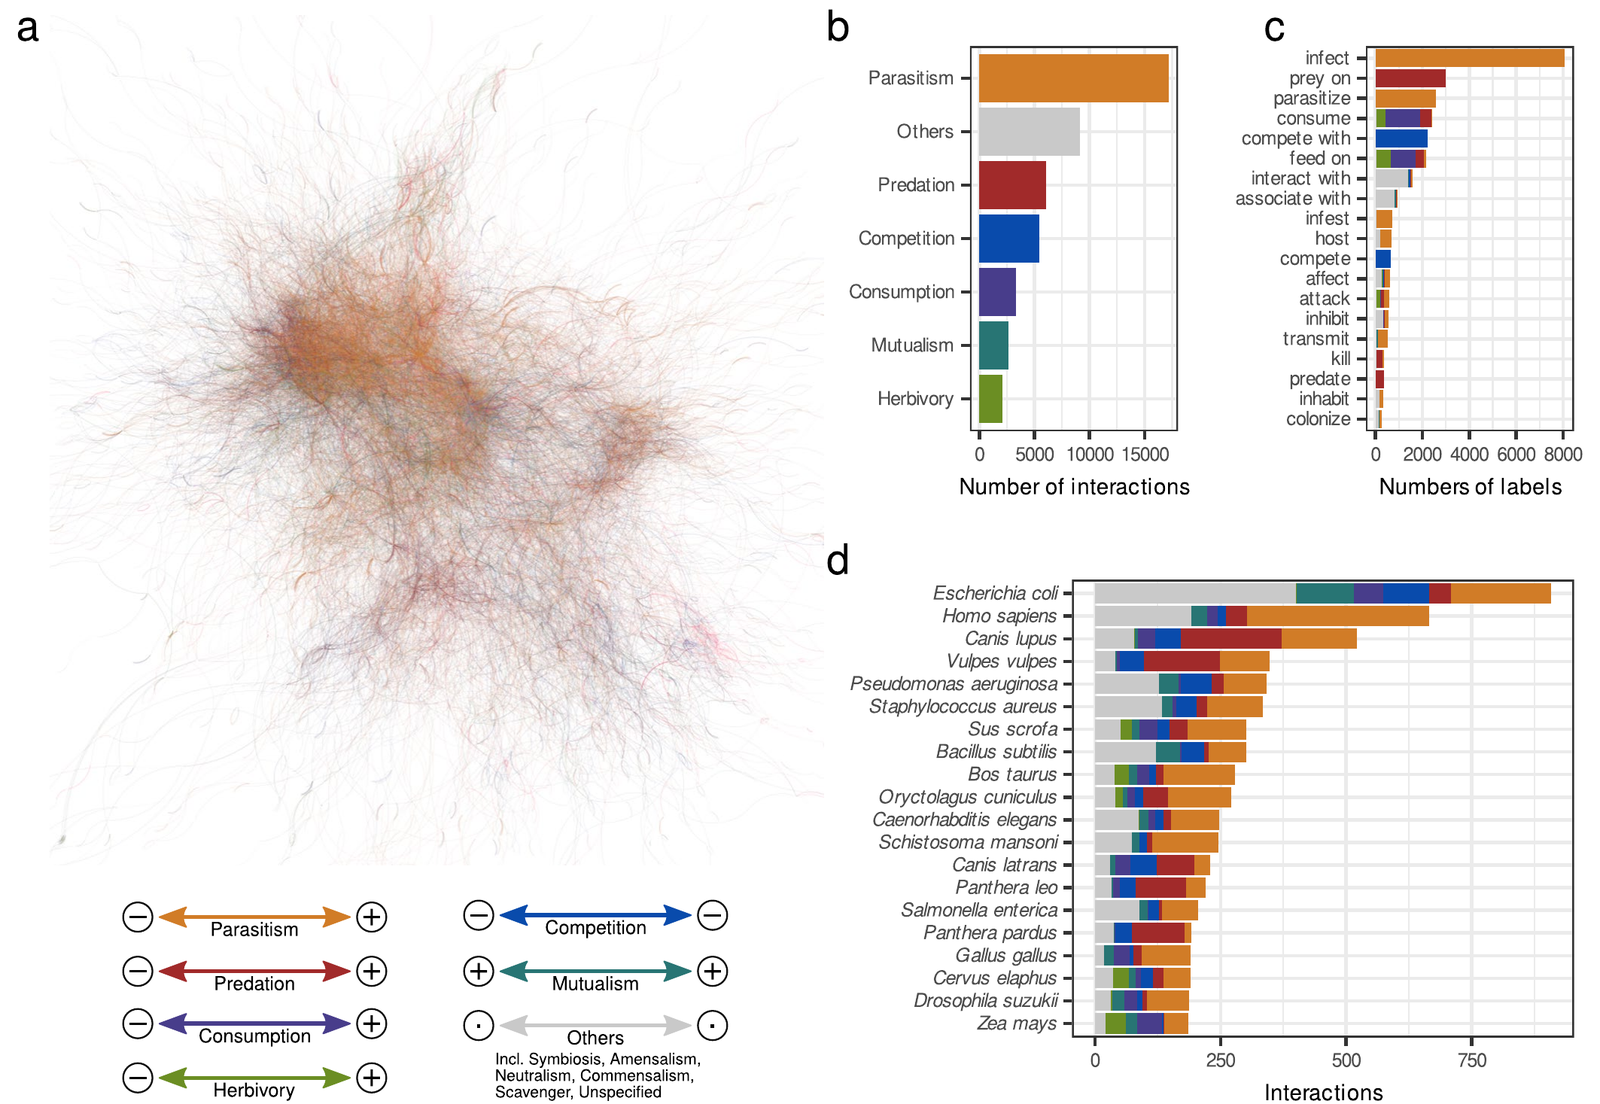
Figure 3:a 是物种一级网络的主连通部分;b 按类别计数,寄生最多;c 是最常见的 20 种原话及其被归入的类别,同一个动词(如 consume、feed on)会落进几个类别;d 是连接最多的 20 个物种,以 Escherichia coli、Homo sapiens 和 Canis lupus 居首。灰色是“其他”,包括共生、偏害、中性、偏利、食腐和未说明类型。 [S1]
05我从中学到什么
- 可迁移的洞见
- 精确率很大程度上来自模型之后那一步:把名称对到分类库,去掉了它给出的大量错误
记录。 - 设计启发
- 把每个提取出的名称对到参考库,对不上的丢掉。还要查输出里有没有照抄提示词的
示例。 - 阅读启发
- 看大模型提取的数据集,先问:随机样本上的精确率和召回率、谁标注的、原始输出丢掉了
多少。 - 接下来看
- 第二位标注者对同一样本打分;同一语料换开放模型跑一遍;用这份数据搭的食物网对照野外
记录。
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。