

论文解读
南洋理工的 OmniQ 让 AI 智能体按论文重做 59 项计算量子研究:最强组合复现约 93%,而 60 篇论文里有 18 篇本身有缺口
Yuxuan Du、Dacheng Tao 等人把 60 篇已发表的计算量子研究各挑一张图,做成复现任务:智能体只拿到论文和任务说明,要自己写代码重算出这张图,评判标准对它保密,由一个评审智能体逐项核对代码、数据和图。先跑一遍各家智能体,再让审计智能体和领域专家专查几个配置(包括最强的)都过不了的同一条标准,结果在 18 篇论文里找到问题,其中一篇的图、代码和理论上限对不上,被剔除。在剩下的 59 项上,Claude Code 搭配 Opus 5.5 复现约 93%;同一个 DeepSeek V4 Pro 换上六个第三方框架,只有 19% 到 48%。作者自己的智能体 RA 把专家核实过的修正存成经验,让低成本的 DeepSeek V4.1 Flash 从 68% 升到约 85%。每个配置每项任务只跑一次,评审智能体基于 Claude Opus 4.8,论文和 RA 都由作者自己挑选和搭建。
●预印本 + 自建基准 + 专家审计
当前边界:各家智能体在同一套任务、同一个评审下的成绩,以及专家确认的 18 篇论文问题,这些测到了;但每个配置只跑一次,评审基于 Claude 模型,论文由作者挑选,模型是否在训练中见过这些论文或代码也没有讨论。
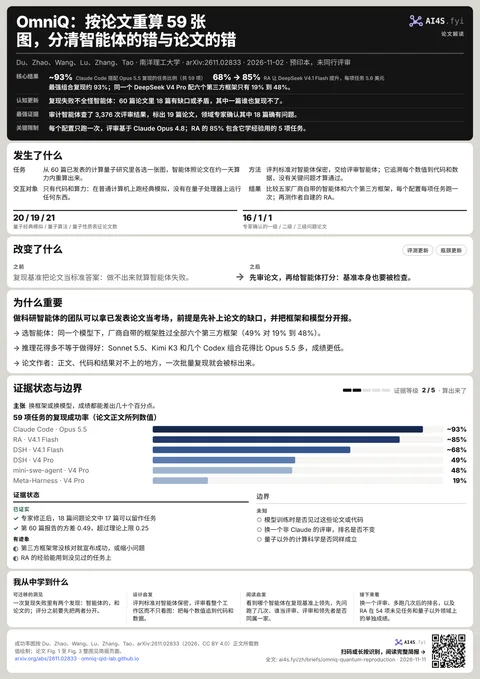
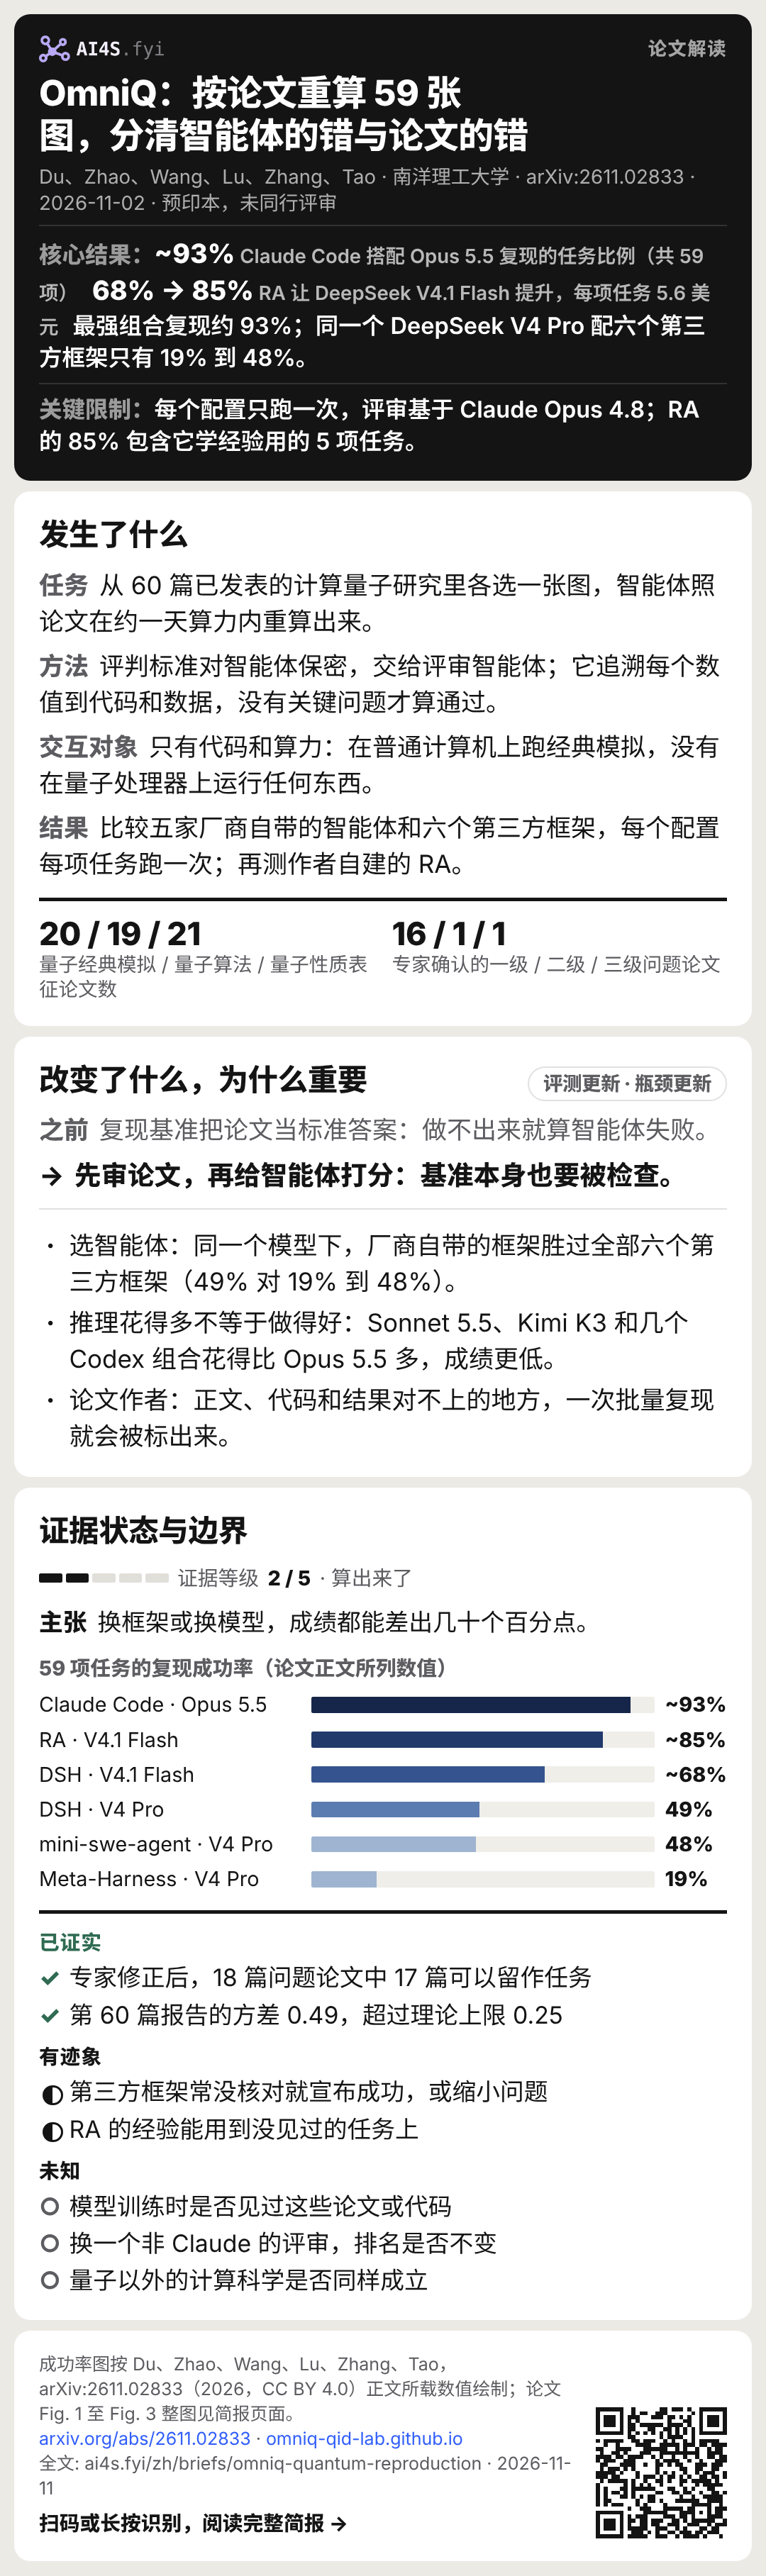
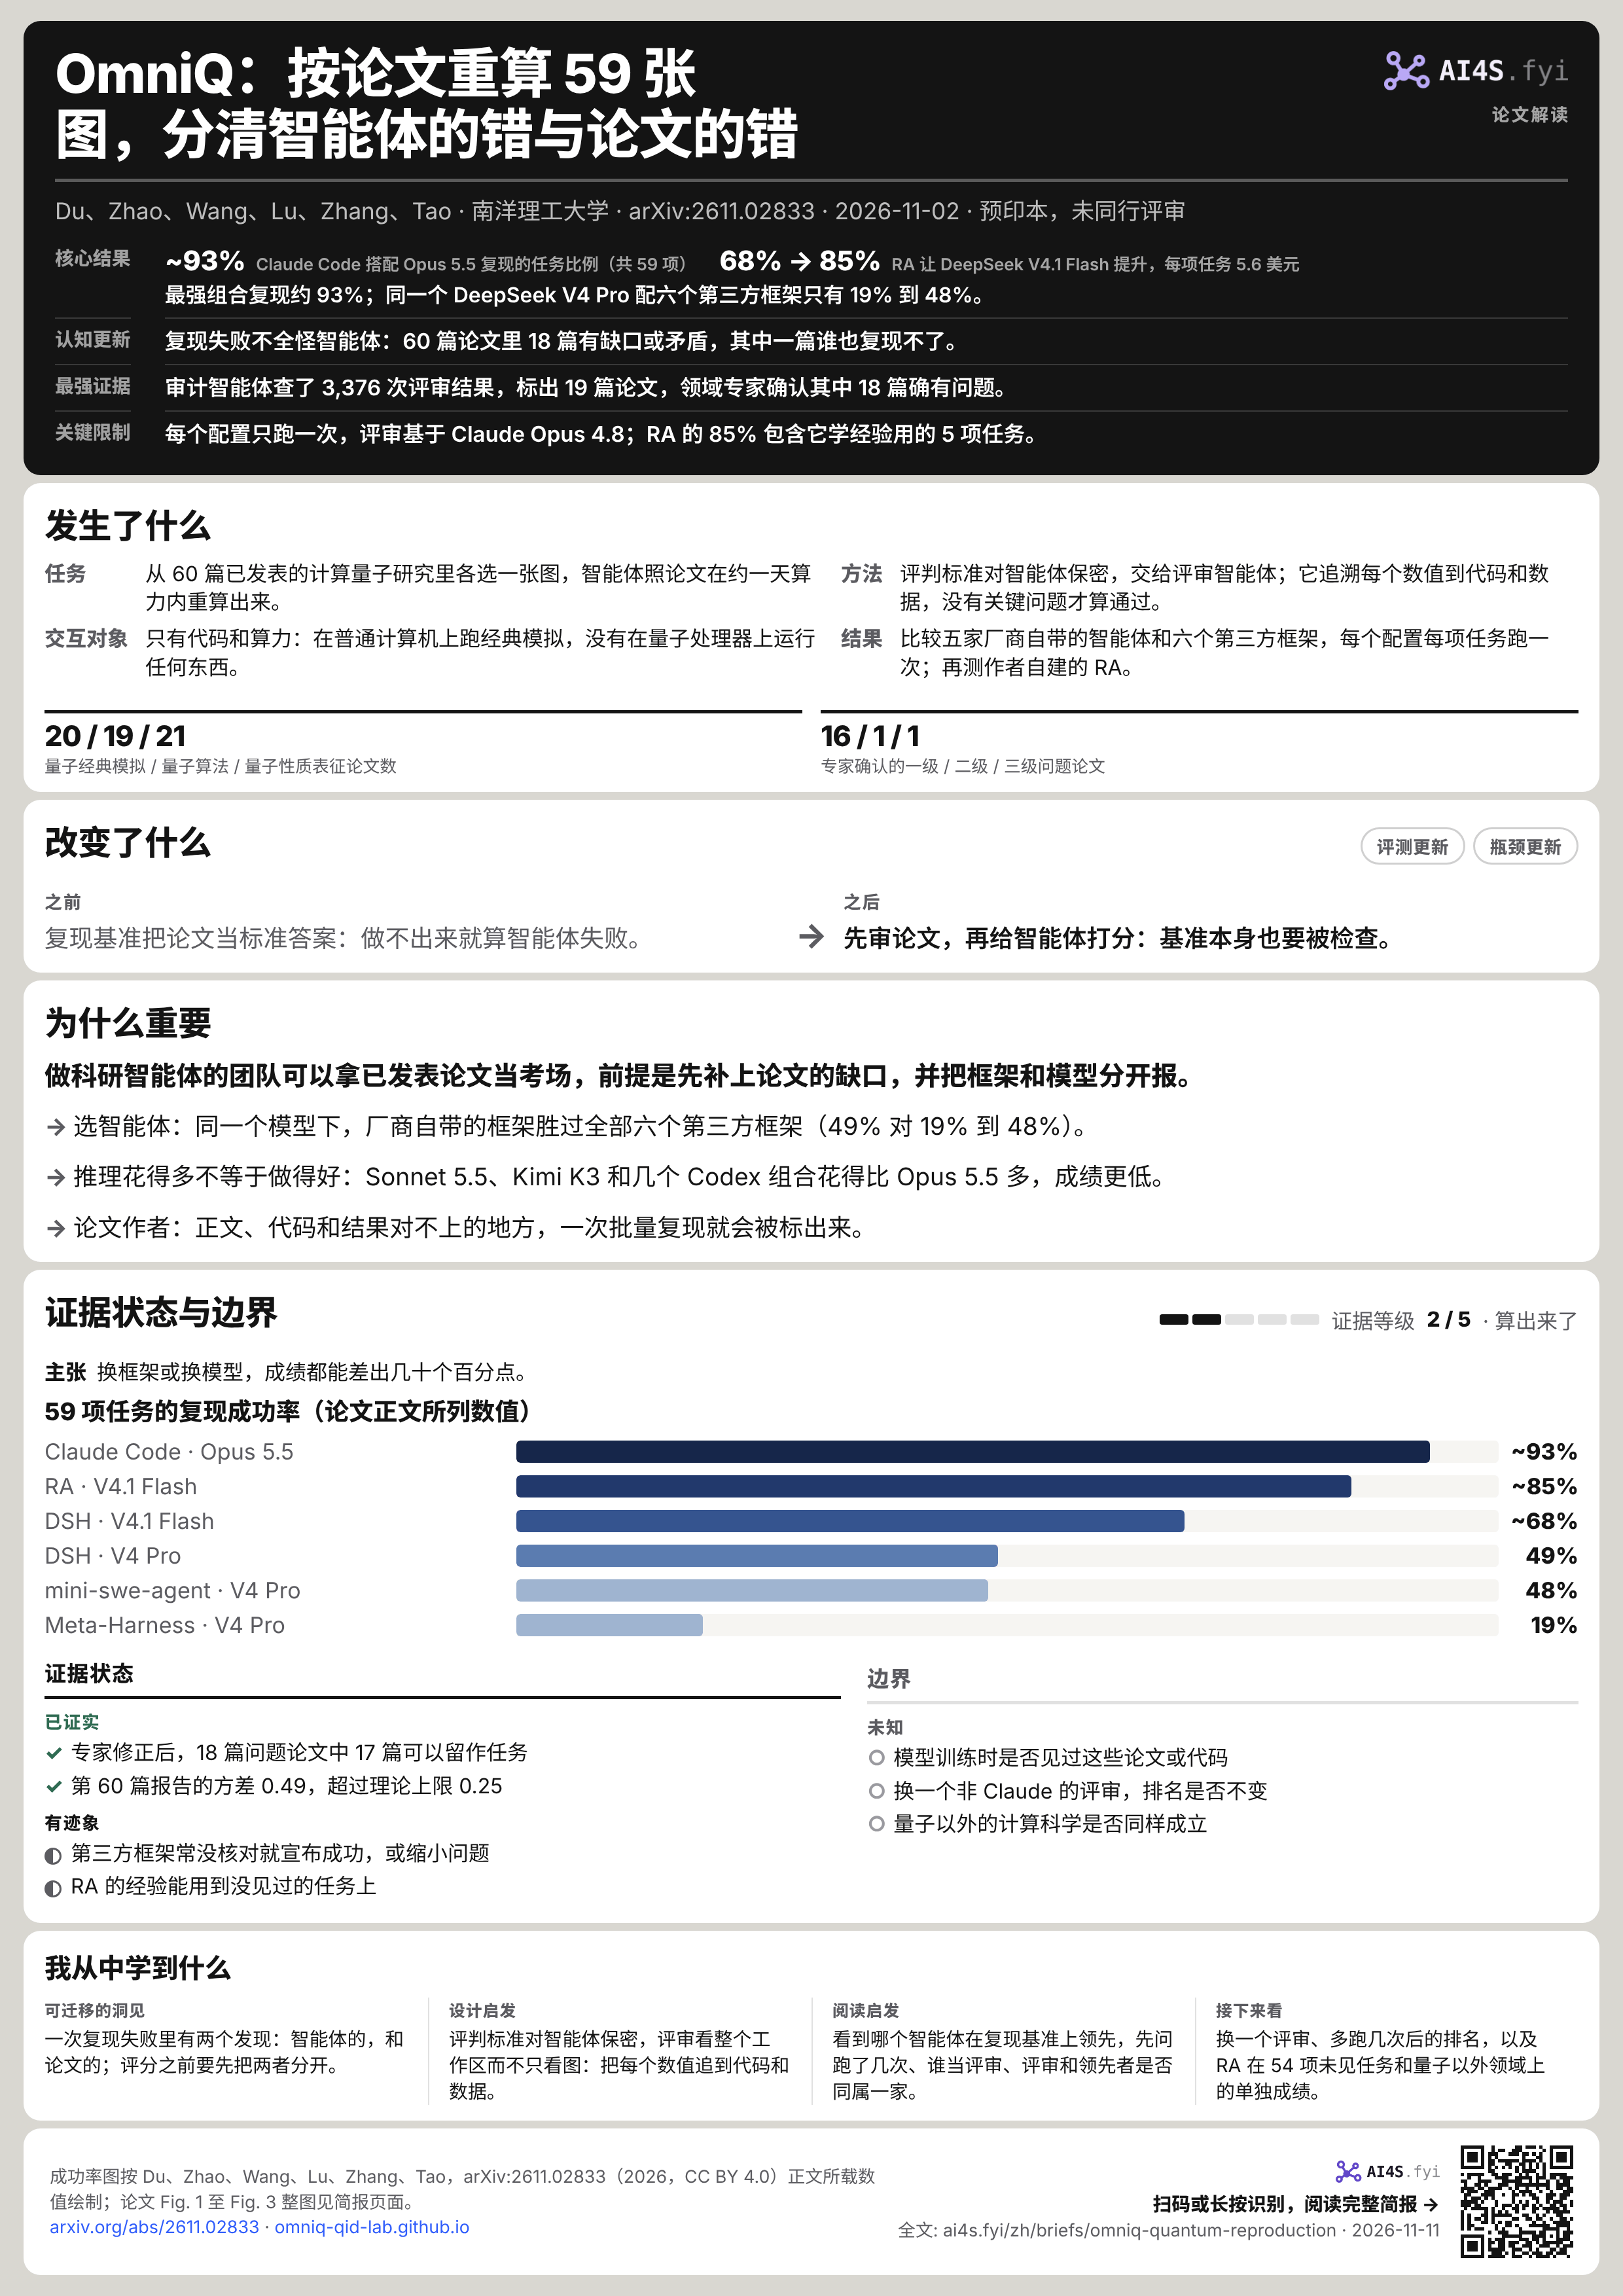
~93%Claude Code 搭配 Opus 5.5 复现的任务比例(共
68% → 85%RA 让 DeepSeek V4.1 Flash 提升,每项任务
最强组合复现约 93%;同一个 DeepSeek V4 Pro 配六个第三方框架只有 19%
- 认知更新
- 复现失败不全怪智能体:60 篇论文里 18 篇有缺口或矛盾,其中一篇谁也复现
不了。 - 最强证据
- 审计智能体查了 3,376 次评审结果,标出 19 篇论文,领域专家确认其中 18 篇确有
问题。 - 关键限制
- 每个配置只跑一次,评审基于 Claude Opus 4.8;RA 的 85% 包含它学经验用的 5 项
任务。
01发生了什么
- 任务
- 从 60 篇已发表的计算量子研究里各选一张图,智能体照论文在约一天算力内重算
出来。 - 方法
- 评判标准对智能体保密,交给评审智能体;它追溯每个数值到代码和数据,没有关键问题才算
通过。 - 交互对象
- 只有代码和算力:在普通计算机上跑经典模拟,没有在量子处理器上运行任何
东西。 - 结果
- 比较五家厂商自带的智能体和六个第三方框架,每个配置每项任务跑一次;再测作者自建
的 RA。
20 / 19 / 21量子经典模拟 / 量子算法 / 量子性质表征
16 / 1 / 1专家确认的一级 / 二级 / 三级问
2026 年 11 月 2 日,南洋理工大学计算与数据科学学院的 Yuxuan Du、Hanqing Zhao(并列第一作者)、Xinbiao Wang、Yiming Lu、Kaining Zhang 和 Dacheng Tao 在 arXiv 发布预印本《Reimagining computational quantum research with AI scientists》(arXiv:2611.02833v1,quant-ph,CC BY 4.0),通讯作者为 Du 和 Tao。论文提出 OmniQ:一个经专家审核的「虚拟研究环境」,把已发表的计算量子研究变成可执行的复现任务;以及 Residual Agents(RA),一个从专家核实过的修正中积累经验的开源智
选了哪些论文
60 篇论文分三个方向,大致均衡:量子系统的经典模拟 20 篇(张量网络、神经网络量子态、Pauli 传播、量子蒙特卡洛、开放系统等),量子算法 19 篇(哈密顿量模拟、相位估计、变分算法、量子机器学习等),量子性质表征 21 篇(高效测量、学习未知量子态与过程等)。作者优先选影响大、发在主要期刊上的研究,并要求数值结果能在约一天的算力内重算,这基本排除了计算量很大的深度学习方法。每篇论文选一到几张代表核心结论的图作为
任务和评审怎么做
每项任务有两份文件:给智能体的 Preliminary.md,写明目标图、通用规则(照论文的方法和设置做,禁止编造或从外部拿结果,所有近似都要写明)和本篇的问题与范围;只给评审的 Criteria.md,写明图的结构、带参考值和容差的数值检查点、必须的参数与计算步骤。两份都由大模型起草、领域专家审改。评审是一个基于 Claude Code 和 Opus 4.8 的智能体,任务结束后才拿到评判标准,检查整个工作区:源代码、日志、数值数据、图和报告,把画出来的每个值追到保存的数据和代码。问题分关键和非关键两类:方法不对、数值超出容差、参数不一致、数值追不到实际计算,都算关键;颜色、图例位置之类只算非关键。一张图没有关键问题才通过,一项任务所有目标图都通过才算复现
比了哪些智能体
厂商自带的智能体有 Codex(配多个 GPT 模型)、Claude Code(Opus 5、Opus 5.5、Sonnet 5、Sonnet 5.5)、Kimi Code(K3)、Grok Build(Grok 4.6)和 DeepSeek Harness(DSH,配 DeepSeek V4 Pro 和 V4.1 Flash)。六个第三方框架是两个通用软件框架 mini-swe-agent 和 live-swe-agent、两个专做论文复现的 InternAgent 和 DeepCode,以及两个自我演化的 Huxley-Gödel Machine(HGM)和 Meta-Harness;它们都配 DeepSeek V4 Pro,用公开实现和默认设置,只为任务调整了步数和时间上限。每个配置在每项任务上跑
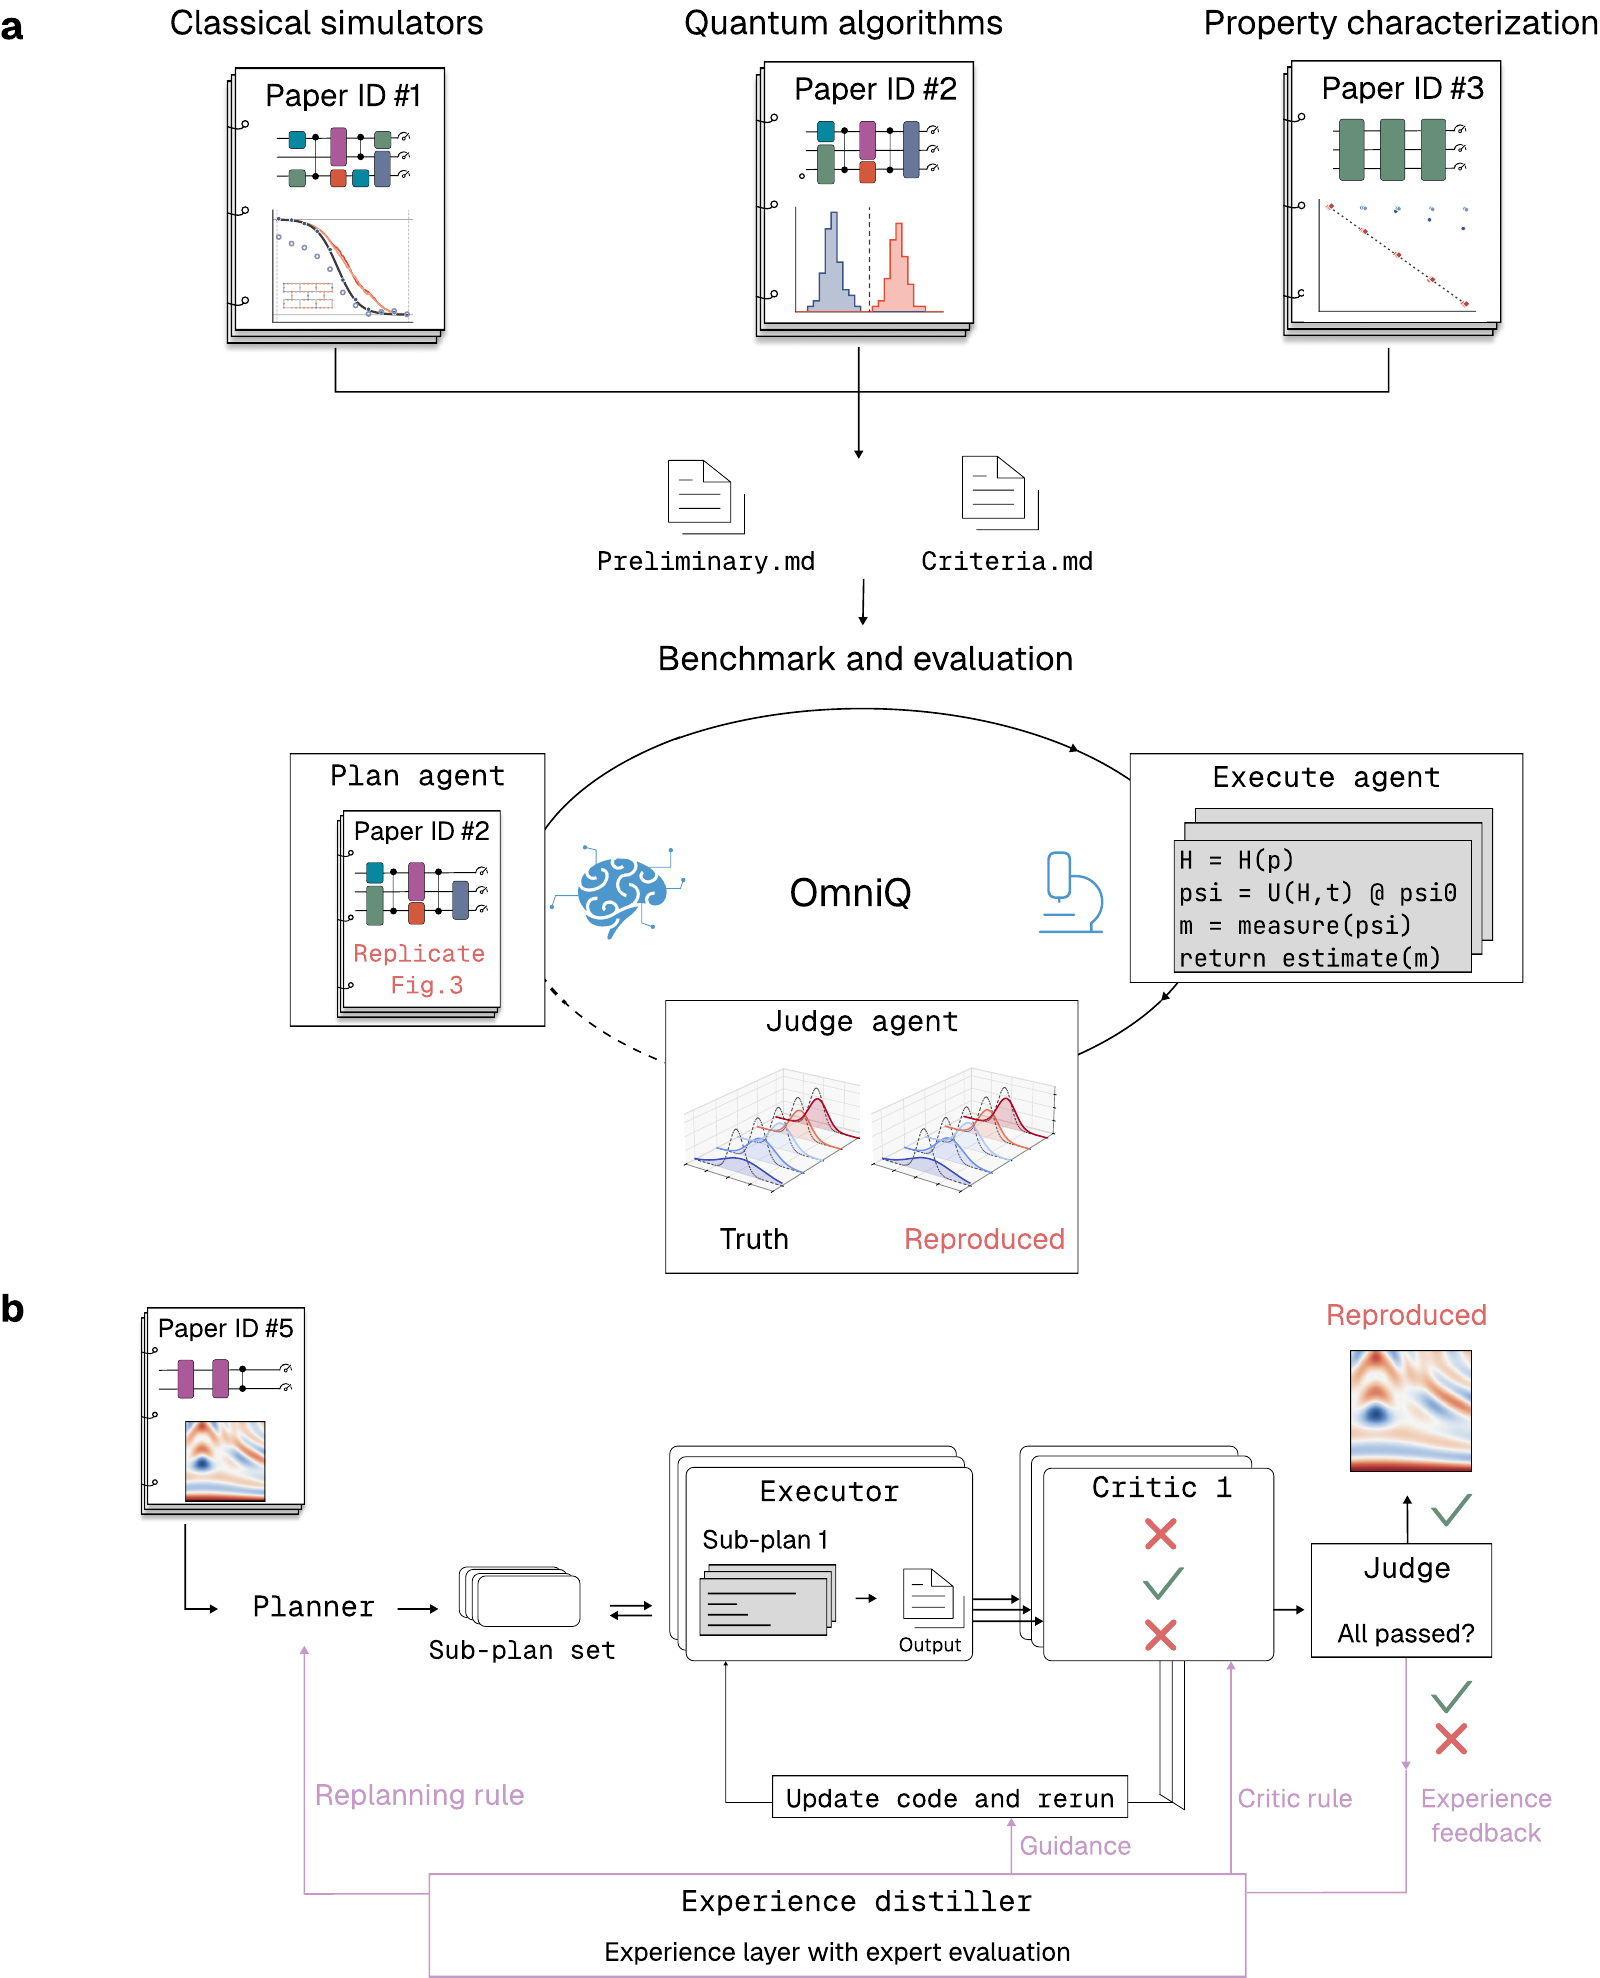
论文 Fig. 1:(a) 论文变成任务说明(Preliminary.md)和保密的评判标准(Criteria.md),规划、执行、评审三个智能体复现目标图;(b) RA 的流程,经验提炼器把专家核实过的修正写回规划、批评和执行。Du 等,arXiv:2611.02833,CC BY 4.0;由 arXiv 源文件中的 PDF 整图渲染,未作修改。 [S1]
02改变了什么
评测更新瓶颈更新复现基准把论文当标准答案:做不出来就算智能体
先审论文,再给智能体打分:基准本身也要被
问题论文是这样查出来的:第一轮各家智能体跑完后,一个审计智能体复查了 3,376 次评审结果,专找包括最强配置在内、不同配置都过不了同一条标准的情况,标出 19 篇论文;它再对照原论文、任务说明、评判标准和各配置的计算结果,能算的地方用解析计算、作者公开的代码或从图中提取的数据核对关键数值。领域专家随后逐篇审查,确认 18 篇确有问题,按严重程度分三级:一级 16 篇,缺的方法细节可以从公开代码或专家解读中补回;二级 1 篇,论文里有局部错误,需要专家查看证据才能解决;三级 1 篇,图、代码和理论约束之间的矛盾无法解决。专家据此修改任务说明或评判标准,受影响的任务重新评审或
三个例子
一级的例子是第 46 篇,一篇用随机森林做量子纠错缓解的论文:论文写每次分裂只考虑一个特征,作者公开的代码却在每次分裂时用全部特征(max_features=1.0)。照论文文字做,模型在外推区间失去报告中的优势;照代码做,优势恢复。二级的例子是第 42 篇,用量子核方法识别拓扑序:在两比特随机线路深度为 4 时,论文报告的轮廓系数(衡量聚类分得开不开,-1 到 1)约 0.59,复现只有 0.29;专家发现要得到论文的数值,还需要两步论文没有写的操作,而按论文写的步骤处理作者自己的数据只得 0.24。专家把任务改成检验论文的结论(保真度核随深度变差、纠缠核一直更好),RA 复现了这个结论。三级的例子是第 60 篇,关于量子核随比特数增加是否会集中:图上标的是核的方差,代码算的却是核里距离项的方差;在 2 个比特时报告值 0.49,超过取值在 0 到 1 之间的核方差的理论上限 0.25;在 12 个比特时,论文的方差比用作者代码重算的值大一个数量级以上。专家找到了统计错误,但无法确定生成图中数据用的配置,这篇被剔除,剩下
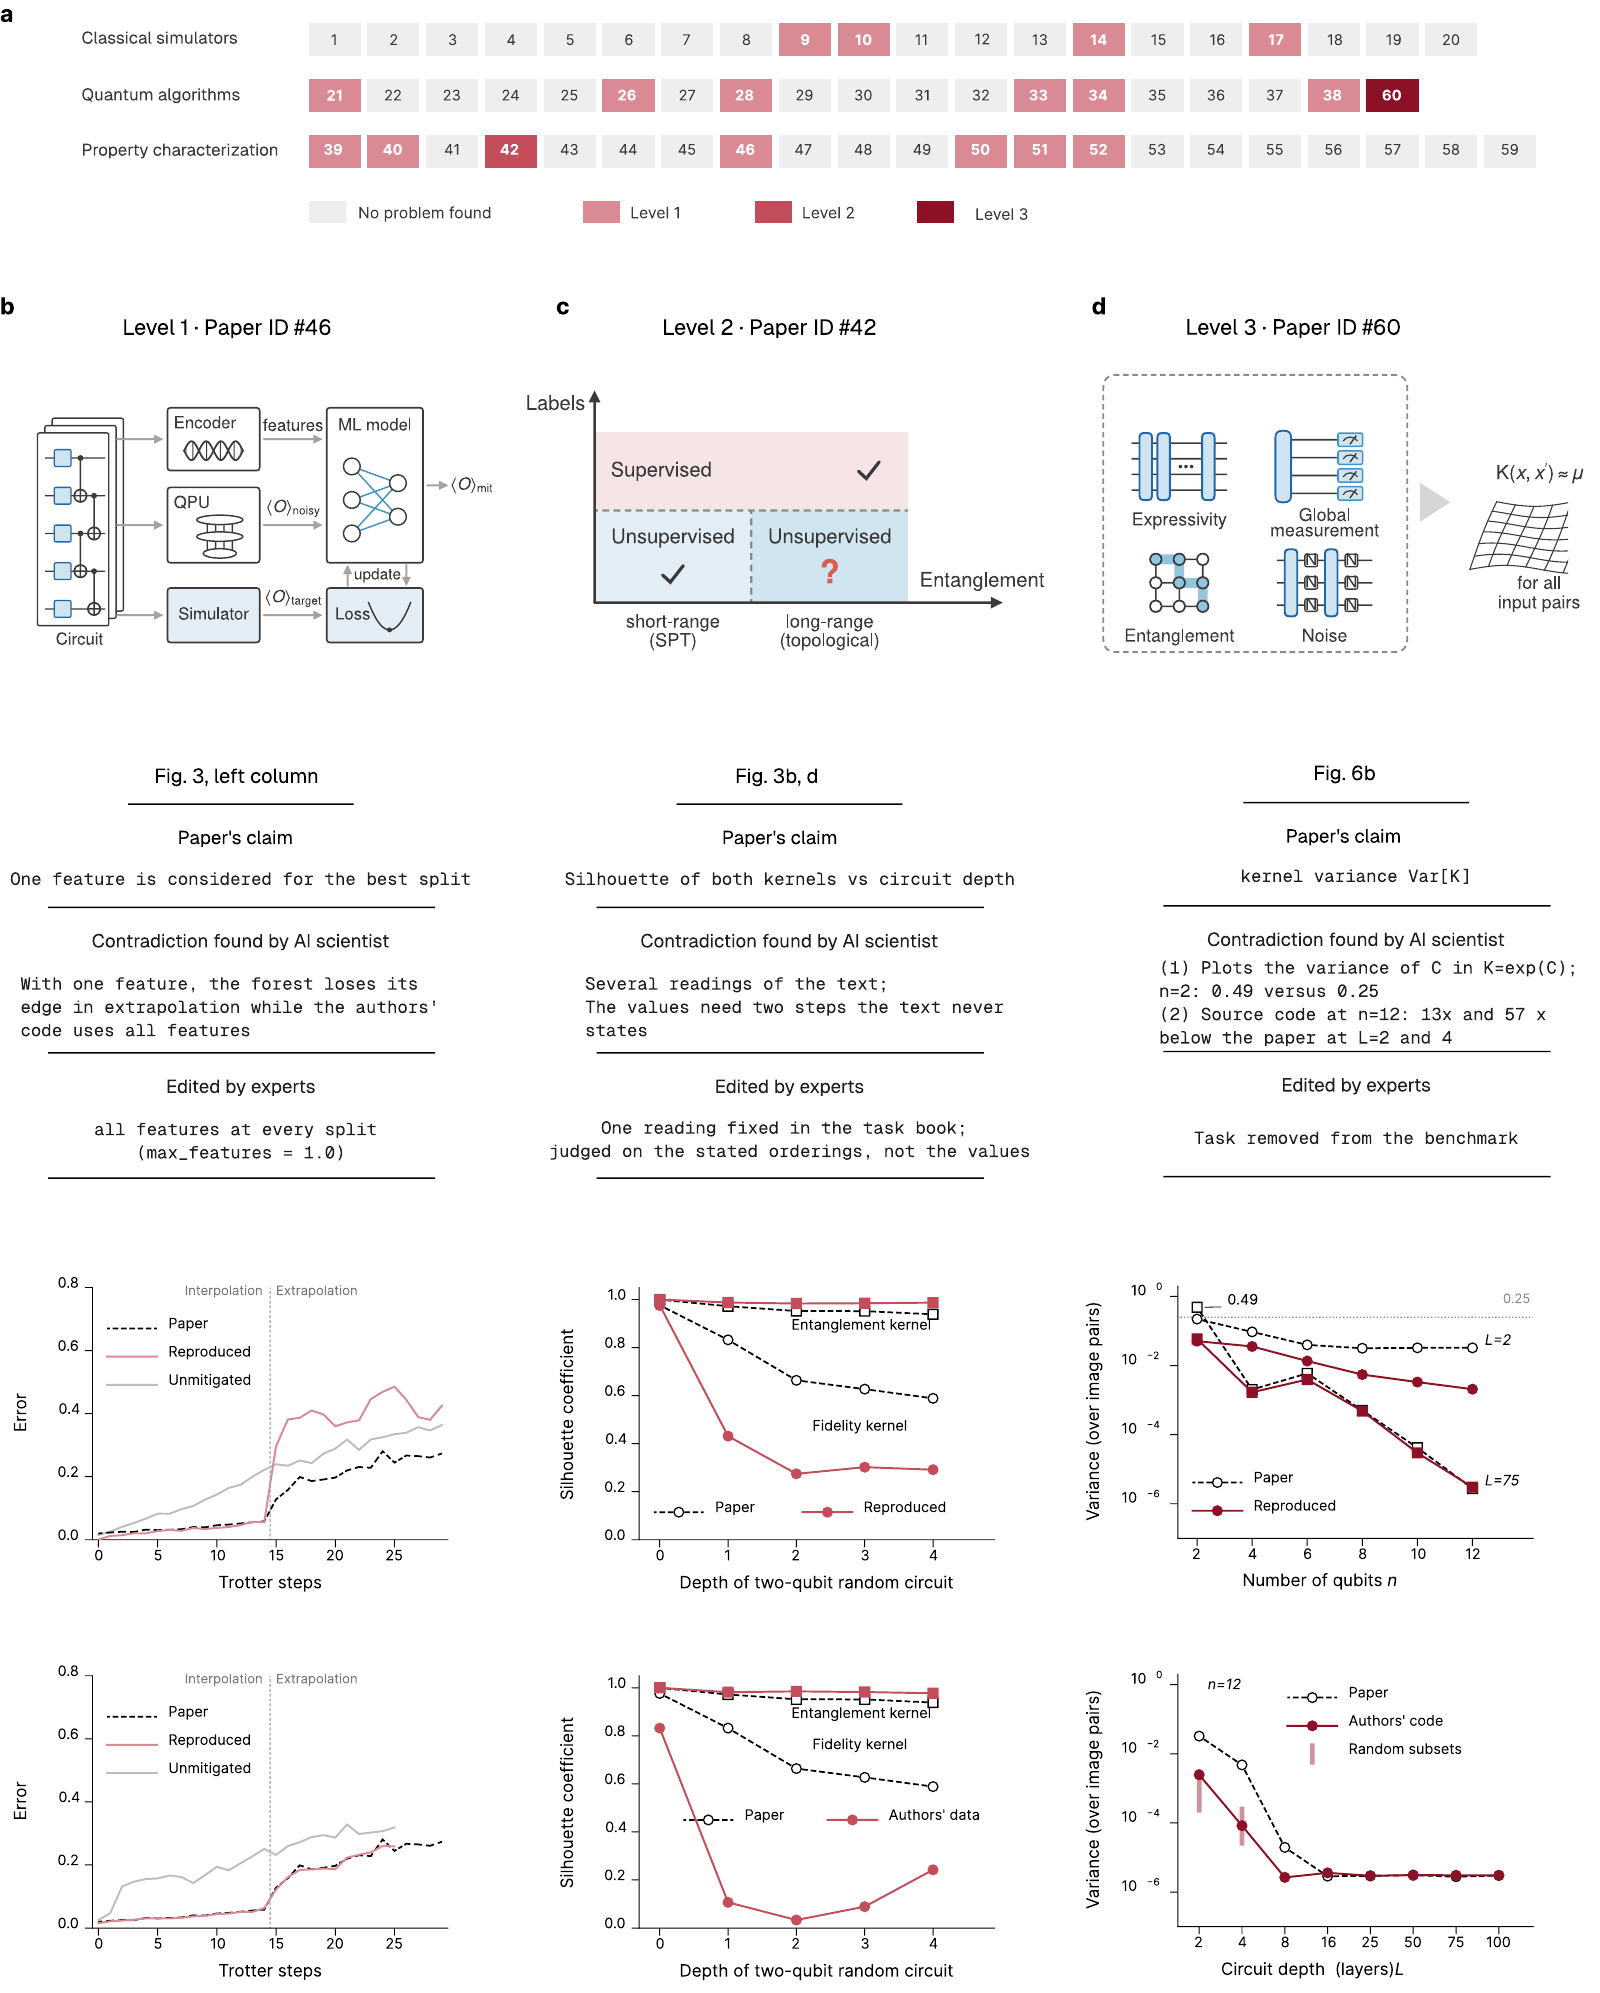
论文 Fig. 2:(a) 60 篇论文中 18 篇有问题(浅红一级、红二级、深红三级);(b)-(d) 第 46、42、60 篇的例子,虚线为论文结果,实线为复现结果。Du 等,arXiv:2611.02833,CC BY 4.0;由 arXiv 源文件中的 PDF 整图渲染,未作修改。 [S1]
03为什么重要
做科研智能体的团队可以拿已发表论文当考场,前提是先补上论文的缺口,并把框架和模型分
- 选智能体:同一个模型下,厂商自带的框架胜过全部六个第三方框架(49% 对 19% 到
48%)。 - 推理花得多不等于做得好:Sonnet 5.5、Kimi K3 和几个 Codex 组合花得比 Opus 5.5 多,成绩
更低。 - 论文作者:正文、代码和结果对不上的地方,一次批量复现就会被标
出来。
对买或搭科研智能体的人,最直接的结论是框架的影响和模型一样大。同样用 DeepSeek V4 Pro,DeepSeek 自己的 DSH 复现 29 项(49%),通用的 mini-swe-agent 28 项,成本约为 DSH 的三分之一;live-swe-agent 只有 18 项,成本却约是 mini-swe-agent 的两倍;为复现论文专门设计的 DeepCode 和 InternAgent 反而不如自我演化的 HGM(24 项);Meta-Harness 最低,11 项。作者用 Claude Opus 5.5 把失败运行里的 954 条关键问题归类,常见的有三种:没对照论文核实就宣布成功,用便宜的替代计算顶替要求的计算,以及悄悄缩小问题规模。Meta-Harness 的 48 次失败里有 18 次缩小了问题,live-swe-agent 的 41 次失败里有 22 次是实现错误,InternAgent 的 43 次失败里有 13 次没交
成本这条,论文称之为「想得多、做得少」:Claude Code 配 Sonnet 5.5、Kimi Code 配 K3 和几个 Codex 组合每项任务的推理花费都高于 Claude Code 配 Opus 5.5,成绩却更低;DSH 配 DeepSeek V4.1 Flash 以最低成本复现约 68%,胜过所有每项任务低于 7 美元的系统,也胜过几个贵一个数量级的系统。对出版方和论文作者,代价在另一头:一篇论文的方法写不全、代码和图对不上,以前多半没人发现,现在一次批量复现就能把它标出来;第 60 篇这样的三级问题,连专家也无法从公开材料里
04证据状态与边界
证据等级 2 / 5 · 算出来了证据状态
已证实
- 专家修正后,18 篇问题论文中 17 篇可以留
作任务 - 第 60 篇报告的方差 0.49,超过理论上
限 0.25
边界
有迹象
- 第三方框架常没核对就宣布成功,或缩
小问题 - RA 的经验能用到没见过的
任务上
未知
- 模型训练时是否见过这些论文
或代码 - 换一个非 Claude 的评审,排名是
否不变 - 量子以外的计算科学是否同
样成立
主张换框架或换模型,成绩都能差出几十个百
59 项任务的复现成功率(论文正文所列数值)
RA 的 85% 怎么来的。
RA 用同一个基础模型扮演规划、执行和批评三个角色:规划者把任务拆成有资源上限的子计划,执行者逐个完成,批评者对照论文检查结果,不通过就修复或重新规划;任务结束后才由评审按保密标准打分。经验提炼器把失败的执行和专家核实过的修正之间的差别,提炼成可复用的「失败特征」,存进三类记忆;每条更新都要人类专家批准,底层模型和编排不变。开发时 RA 只用了最难的 5 项任务,其余 54 项在开发中没见过。评测时用 DSH 配 DeepSeek V4.1 Flash 做执行者,每项任务给 24 小时,结果从 68% 升到约 85%,每项任务 5.6 美元,与 Claude Code 配 Opus 5(16 美元)和 Codex 经 API 配 GPT-5.6-sol(35 美元)的约 85% 相当。批评者否决了一半以上的中间结果;成功的任务里 90% 至少经过一次修正,包括比 DSH 多复现的全部 13 项。论文没有单独给出 54 项未见任务上的成功率,所以 85% 里包含了 RA 学经验用
只跑一次,评审来自同一家。
论文写明,初始基准中每个配置只评一次,图中每个点都是单次结果,没有误差范围;百分比之间几个点的差距,不能当作稳定的排名。评审智能体基于 Claude Code 和 Opus 4.8,而得分最高的是 Claude Code 配 Opus 5.5,论文没有讨论评审和被评者同属一家是否有影响,也没有用另一个评审交叉检验。失败分类同样是 Claude Opus 5.5 做的,作者对 60 条随机样本重复分类,一致率 98.3%(
论文没有讨论的。
这 60 篇都是已发表的研究,按论文附表,20 篇有完整的公开代码,11 篇只公开了一部分,29 篇没有找到公开实现;论文没有讨论模型训练时是否见过这些论文或代码,也没有说明智能体在复现时能否联网。60 篇由作者挑选,RA 由作者搭建,比较 RA 的对照也由作者跑;这些都是团队自己的评估。论文还介绍了一个基于 MCP 协议的平台,让智能体检索和复用已复现的工作流,但目前只实现了原型网页和 MCP 工具定义,完整的公开服务尚在计
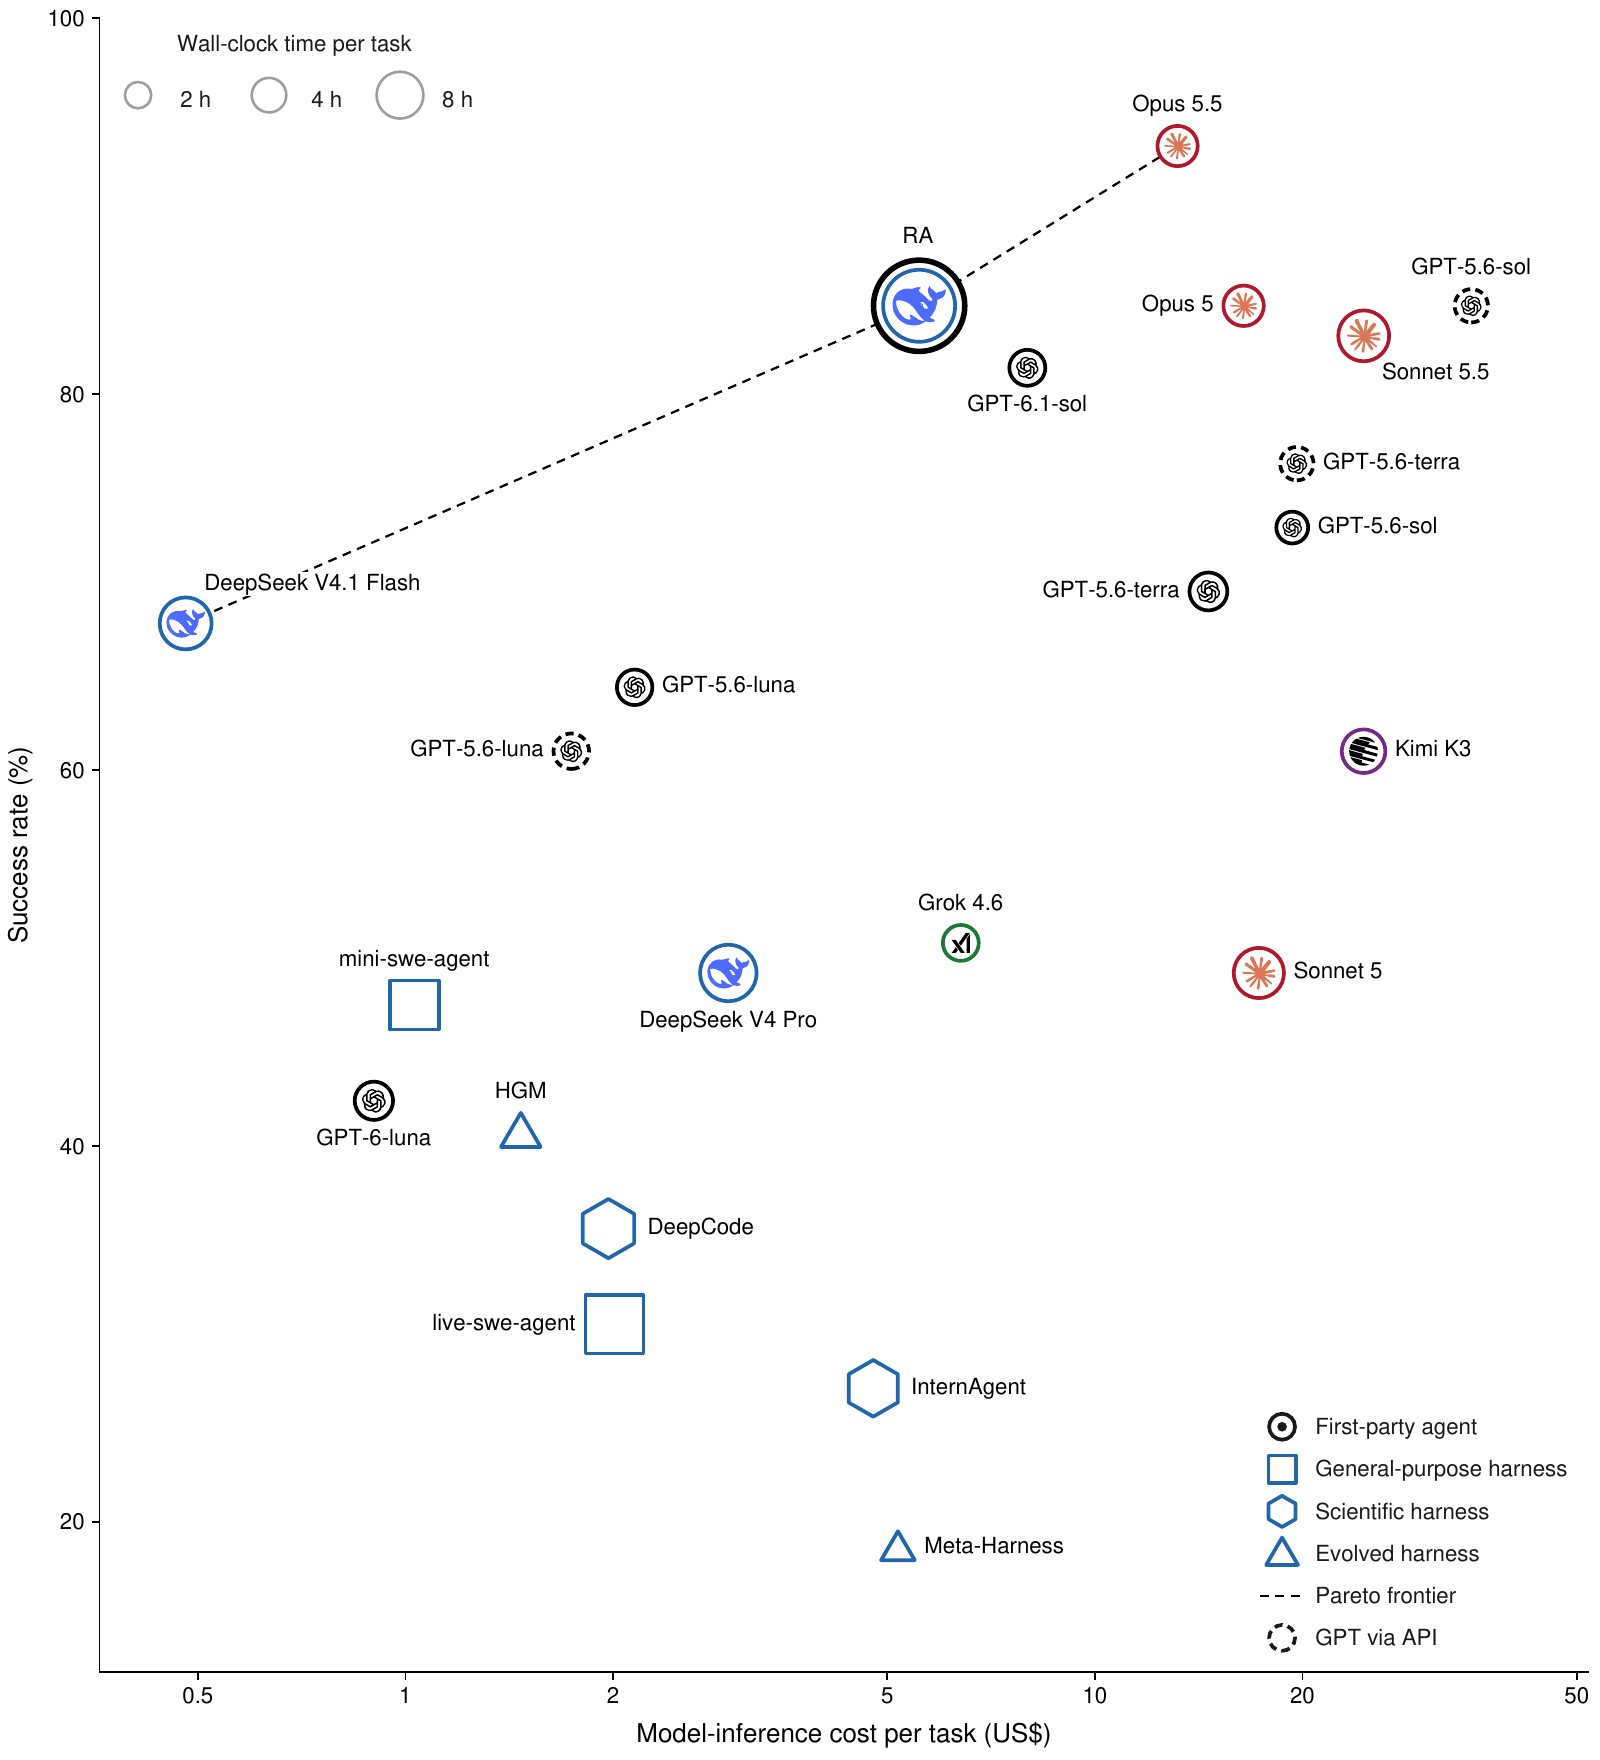
论文 Fig. 3:复现成功率对每项任务的推理成本(对数轴),点的大小是单项任务耗时,虚线是成功率与成本的前沿。Du 等,arXiv:2611.02833,CC BY 4.0;由 arXiv 源文件中的 PDF 整图渲染,未作修改。 [S1]
05我从中学到什么
- 可迁移的洞见
- 一次复现失败里有两个发现:智能体的,和论文的;评分之前要先把两者
分开。 - 设计启发
- 评判标准对智能体保密,评审看整个工作区而不只看图:把每个数值追到代码和
数据。 - 阅读启发
- 看到哪个智能体在复现基准上领先,先问跑了几次、谁当评审、评审和领先者是否同属
一家。 - 接下来看
- 换一个评审、多跑几次后的排名,以及 RA 在 54 项未见任务和量子以外领域上的单独
成绩。
基准本身也要被审
这篇论文最可迁移的,是它查基准的办法:让很多配置先跑一遍,专找连最强配置也过不了的同一条标准,再交给专家判断是论文的错、任务的错还是智能体的错。这样查出的 18 篇问题论文,在一般的复现基准里会被直接算成智能体失败,拉低所有人的分数,也让排名混进噪声。任何拿已发表结果当标准答案的科研基准,都可以照这个办法先审一遍
经验存在模型外面
RA 不改模型,只改它带着的经验:专家核实过的修正被提炼成规则,规划、批评和执行时调用。它让便宜模型接近贵模型的成绩,是这篇论文对搭建科研智能体的人最实际的一点;但经验来自 5 项任务、由专家逐条批准,能否在别的领域、别的模型上同样起作用,论文还没有单独
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。