

论文解读· 科学证据 · Frontier
VISTA 不训练新模型,只改模型看和记的方式:ARC-AGI-3 的 25 个公开游戏全部通关
何恺明在 MIT 的团队给现成的多模态模型加了一套框架:游戏画面直接以图像输入,每一帧原样保存,模型可以随时放大任意区域、回看任意一帧、读出像素值。25 个公开游戏全部通关,Claude Opus 5.0 得 100,GPT-5.6 Sol 得 99.00;主办方的官方设置下两者是 40.68 和 13.33。作者逐项加组件的拆解显示,保存原始帧并让模型自己回看是最大的一步;但官方基线经 API 运行、上限更紧,Opus 那一行的推理强度也低一档,只能作外部参照,而且只测了模型可能见过的公开游戏。
●技术报告 + 公开基准 + 逐项拆解
当前边界:同一模型、同一接入方式下,逐项加组件把分数从 47.32 推到 99.00,这一点测到了;但没有在私有游戏上检验,公开游戏可能进过训练数据,与官方基线的比较也混着接入方式、上限和推理强度的差别
这项工作推进的是:给现成多模态模型加一套框架:直接看渲染画面,保存每一帧,按需放大、回看、读像素,让它在规则未知的交互游戏里试探并通关
- MODEL理解 / 预测
- DECIDE选择下一步
- INTERACT测试现实
- UPDATE改变下一轮
40.68 → 100Claude Opus 5.0 的 RHAE:官方 high → VISTA xhigh
13.33 → 99.00GPT-5.6 Sol 的 RHAE:官方设置 → VISTA
25 个公开游戏全部通关;Opus 用了 7,302 个动作,比首次玩的人类少 57.4%。
- 认知更新
- 差距有一大块在模型外面:同一个 GPT-5.6 Sol、同样的上限,只改框架,51.66 → 99.00。
- 最强证据
- 同一模型、同一接入方式逐项加组件:保存原始帧加按需查看 +24 分,读像素再 +5 分。
- 关键限制
- 只测了模型可能见过的公开游戏;官方基线经 API 运行、上限更紧,Opus 那一行的推理强度也低一档。
01发生了什么
- 任务
- ARC-AGI-3 的交互游戏不给规则和目标,要靠试探弄懂每个游戏并逐关通过。
- 方法
- 不训练模型:现成多模态模型看渲染图像,每一帧原样存档,可按需放大、回看、读像素;外加两份笔记。
- 交互对象
- 只有代码和算力:模型在游戏环境里出动作、读返回的画面;每局最多 2,000 个动作、48 小时。
- 结果
- RHAE:按首次玩的人类所用动作数给每关计分,后面的关卡权重更大,没通关的关卡记 0。
~308 / ~4,000每帧 token:512×512 图像 / 64×64 文字网格
30.7M每局平均 token(GPT-5.6 Sol)
1.89 → 66.93开放权重 GLM-5.3 Flash:官方设置 → VISTA
2026 年 10 月 1 日,麻省理工学院的 Qiushi Han、Keya Hu、Linlu Qiu(并列第一作者)、Cathy Wu 与何恺明在 arXiv 发布技术报告《VISTA: A Visual Harness for Reasoning in an Interactive World》(arXiv:2610.02200v1,CC BY 4.0)。报告注明,较早的版本以博客形式发表于 2026 年 8 月 5 日(vista-research.github.io)。论文尚未经过同行评审,代码在 GitHub 公开。何恺明的个人主页写明,他是 MIT 电气工程与计算机科学系终身副教授,同时兼职担任 Google DeepMind 杰出科学家;论文署名单位只有 MIT。[S1][S2][S3]
ARC-AGI-3 测什么
ARC-AGI-3 是 ARC Prize 基金会的一组交互式视觉游戏,每个游戏有多个关卡,不告诉玩家规则和目标;智能体每一步看到当前画面和可用动作,要从动作的结果里推断物体的作用、转换规则和目标,并把前面关卡学到的东西带到后面。论文只在 25 个公开游戏上评估。计分用 RHAE(相对人类动作效率):通过一关,动作数与首次玩的人类相同记 100%,更少最多记 115%,更多则部分计分;没通过记 0;后面的关卡权重更大,整局得分不超过按权重计的通关比例。人类基线来自主办方的研究:486 名普通公众参与,每个游戏由 10 名第一次玩的人测试,每关取通关者动作数的上中位数。[S1]
三样东西:看图、存档、回看
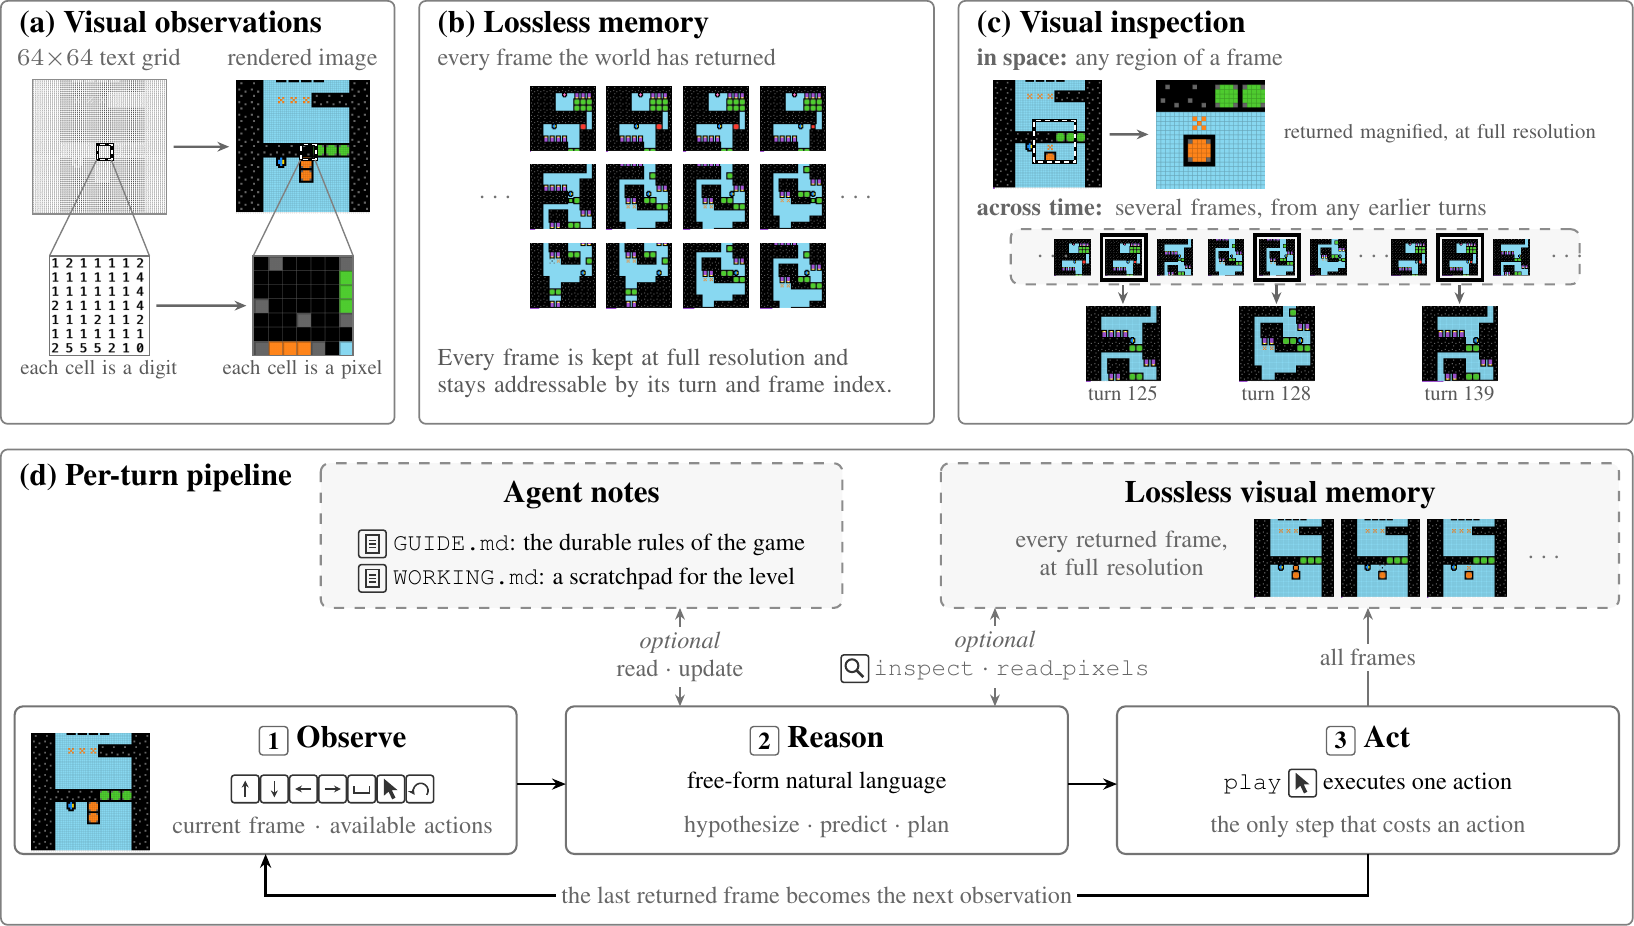
VISTA 的出发点是:现有的多模态模型通常只把一张图编码一次,原图随即丢掉;上下文快满时,早先的观察会被删掉或换成文字摘要,而模型在编码那一刻并不知道之后会需要哪些细节。所以它做了三件事。一是直接给模型看渲染图像:官方 64×64 的帧按最近邻放大 8 倍成 512×512 的 PNG。二是无损视觉记忆:环境返回的每一帧,包括动作引起的中间动画帧,都按原样存档,按轮次和帧号编号,不管模型当前上下文里还留着什么都可以取回。三是按需查看:inspect 可以取出任意轮次的任意帧、裁出任意矩形区域并放大,一次可取多帧对比;read pixels 给出所选像素的精确 RGB 值。框架本身是纯机械的,不含训练过的模型;只有 play 会推进游戏,其余工具都是只读的。[S1]
每一轮里,模型看到当前帧和可用动作,可以读写两份笔记(GUIDE.md 记跨关卡有用的规则,WORKING.md 记当前关卡的草稿),用自然语言推理、预测动作结果,再调用 play 执行一个动作。上下文快到上限时,它先写一段交接摘要,再在新的上下文里接着玩,笔记、视觉记忆和动作历史都还在。每个游戏用同一套接口和同一段简短提示词。Claude Opus 5.0 经 Claude Code CLI、以 extra-high 推理强度运行,GPT-5.6 Sol 经 Codex CLI、以 max 推理强度运行;在 Claude Code 里,这些工具通过一个 MCP 服务器提供,内置工具全部关闭,智能体不能直接访问命令行或文件系统。[S1]
成绩与成本
Claude Opus 5.0 加 VISTA 的 RHAE 为 100.00,共用 7,302 个动作,人类基线为 17,135 个,少 57.4%;GPT-5.6 Sol 加 VISTA 为 99.00,三次重复为 99.00、98.90、99.23(99.04 ± 0.17)。论文表 1 里,同期几个写程序搭世界模型的系统也到了 95.35 到 100(Tycho 两个模型都是 100),VISTA 的说法是:据作者所知,它是第一个不靠程序合成达到满分或接近满分的系统。默认设置下(200K 上下文),GPT-5.6 Sol 每局平均用 3,070 万 token;改用文字网格输入,得分 96.75、动作略多,每局 7,190 万 token,因为一个 64×64 网格约 4,000 个 token,一张 512×512 图约 308 个。上下文加到 780K,每局 1.057 亿 token,得分不升反降;降到 100K,RHAE 只低 0.4,token 约减半。[S1]
02改变了什么
瓶颈更新架构更新ARC-AGI-3 多被当成文字题:模型读数字网格、写程序搭世界模型;不写程序的官方基线只有 13 到 41 分。
不写程序、直接看图也能到 99 到 100 分;关键在模型能否留住原始画面、自己决定回看哪里。
论文把 ARC-AGI-3 从一道语言题改成一道视觉题。此前的做法大多把每一帧写成一行行颜色编号,再让模型把环境抽象成可以执行、可以检验的程序;这在 ARC-AGI-3 上有效,但论文认为,环境在视觉上越复杂,用显式程序描述状态、转换和目标就越难。VISTA 让模型直接对画面推理,用自然语言而不是代码描述它对游戏的理解。[S1]
和同类智能体相比,变化在记忆。论文梳理的游戏智能体(Voyager、JARVIS-1、SIMA 等)通常只保留有限的视觉上下文,或对过去的经验做筛选和压缩;VISTA 把完整的视觉交互历史无损保存,让模型在推理中随时回到任意一帧、任意一块区域。论文把这称为对交互历史的一种显式注意力,并给了两个例子:棋盘重置后,模型一次取出前 22 轮里的四帧拼出整张地图;三个小方块看不清朝向时,模型把它们放大约 13 倍,看清紫色标记在哪一面。[S1]
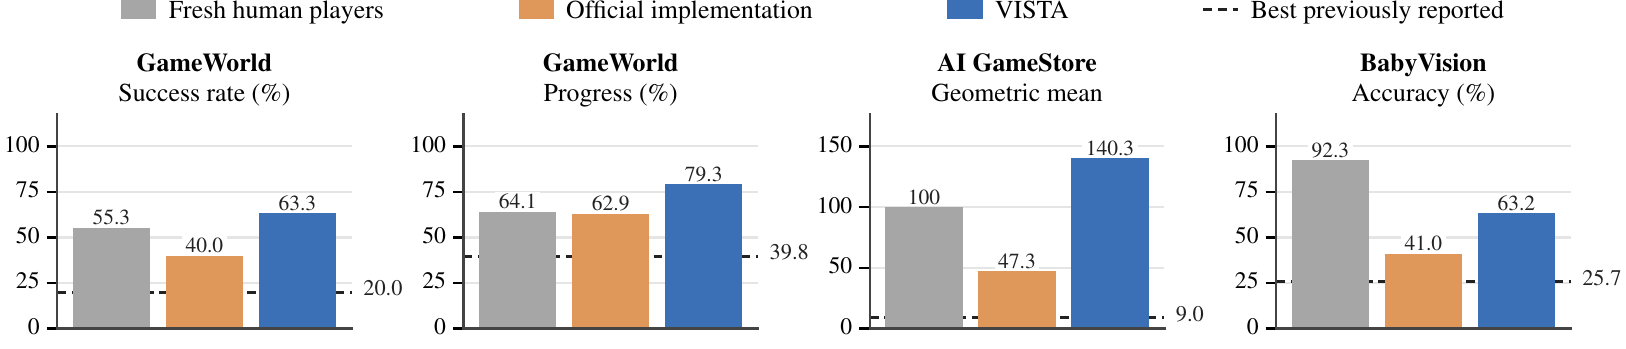
论文 Fig. 11(下半部分):同一框架用在另外三个基准上。GameWorld 成功率 63.3%(官方实现 40.0%,新手人类 55.3%),AI GameStore 几何均值 140.3(人类中位数 = 100),BabyVision 准确率 63.2%(官方实现 41.0%,人类 92.3%)。Han 等,arXiv:2610.02200,CC BY 4.0;由 arXiv 源文件中的 PDF 整图渲染,未作修改。 [S1]
03为什么重要
要让科学智能体更可靠,先换更大的模型,还是先改它看和记的方式?
- 评估智能体时,把框架和模型分开报:同一模型只换外围设置,这里从 13.33 到 99.00。
- 盯实验的智能体:原始画面先存下来,回看哪一帧交给模型(推断,论文没测科学任务)。
对评估智能体的人,这篇论文最直接的提醒是:同一个模型的分数,可以随外围设置变化好几倍。GPT-5.6 Sol 在官方设置下 13.33,只把文字网格换成图像就到 47.32,放宽上限 51.66,改成连续对话 65.82,加笔记 70.05,加无损记忆与查看 94.10,加读像素 99.00。所以一个「模型 X 在基准 Y 上得 Z 分」的说法,离开框架、接入方式和动作上限就说不清楚。[S1]
对 AI for Science,这里的类比是实验室里的观测流:显微镜延时摄影、机器人摄像头、仪器屏幕。常见的做法是把画面先转成文字描述或少数指标,后面只看这些;VISTA 的结果提示,保留原始观测、让模型在出现疑问时回头取帧、放大、比对,可能比一次性压缩更有用。这是本站的推断,不是论文的结论:论文只测了游戏和谜题,作者自己把具身任务和更接近物理世界的环境列为下一步。成本也要算:默认设置每局 3,070 万 token,持续盯一台仪器不能照搬这种用法,更现实的是便宜的低频看护负责标出可疑时刻,只在那些时刻调用这种回看。[S1]
04证据状态与边界
证据等级 2 / 5 · 算出来了 · 回顾性或模拟证据状态
已证实
- 两个前沿模型通关全部 25 个公开游戏
- 逐项拆解:记忆与查看 +24,读像素 +5
- 开放权重 GLM-5.3 Flash 从 1.89 升到 66.93
- 最终配置三次重复:99.04 ± 0.17
边界
有迹象
- 逐项拆解每步只跑一次,没有误差范围
未知
- 在没见过的私有游戏上是否成立
- 能否用于有噪声、连续变化的真实画面
主张同一模型、同一接入方式,逐项加组件,得分从 47.32 升到 99.00;最大的一步是保存原始帧供回看。
GPT-5.6 Sol 的 RHAE,逐项加组件(论文 Fig. 5)
读法首行是主办方经 API 的结果,只作参照;其余同经一个接口,可直接比较。
对照基线的口径不同。
表 1 里的 40.68(Opus 5.0,high 推理强度)和 13.33(GPT-5.6 Sol,max)是主办方公布的结果,其中 40.68 是作者按官方逐游戏得分在 25 个公开游戏上算出的。官方实现经 API 调用模型,用文字网格,每个动作最多保留 7 个中间帧,上下文 175K、超出就丢最早的轮次,每段动作上限是人类的 5 倍、运行时间 12 小时;VISTA 经订阅版 CLI 调用,每局 2,000 个动作、48 小时。论文附录 A.2 自己写明,官方结果应视为外部参照,只有 (i) 到 (vi) 这一组配置彼此直接可比。Opus 的 VISTA 成绩也是 extra-high 推理强度,比官方基线的 high 高一档。[S1]
逐项拆解:最大的一步是记忆与查看。
附录 A.2 和 Fig. 5 给出逐步加组件的结果(都用 GPT-5.6 Sol、max 推理强度、200K 上下文)。把文字网格换成图像,从 13.33 升到 47.32,论文推测部分原因是图像省 token、给推理留出更多上下文:7 帧文字约 2.8 万 token,图像约 2,200。放宽动作和时间上限到 51.66,作者说继续放宽没有明显收益;改成连续对话、用模型自带的压缩越过上下文上限,到 65.82;加两份笔记到 70.05;加无损记忆和 inspect,到 94.10,通关的游戏从 76% 升到 96%,总动作数从 23,702 降到 12,261;加 read pixels 到 99.00,全部通关,9,126 个动作。在开放权重的 GLM-5.3 Flash 上,只去掉 inspect 和 read pixels,分数就从 66.93 降到 13.27。[S1]
只测了公开游戏,模型可能见过。
论文的局限一节写明:所用模型发布于公开游戏之后,不能排除这些游戏进过训练数据;用 ARC-AGI-3 的私有游戏评估,才是更有力的泛化检验。8 月的博客也说「私有集才是泛化的真正考验」。报告没有给出私有集成绩。作者也承认,成功的关键仍是模型已有的能力,VISTA 是一种把它引出来的简单方法。[S1][S2]
博客和报告的数字不完全一致。
8 月 5 日的博客已报告 Opus 5.0 得 100、动作比人类少 56.0%(7,542 个),GPT-5.6 Sol 得 98.27;表中官方最简接口的 Opus 基线写作 30.16。10 月的报告改为 7,302 个动作、少 57.4%,GPT-5.6 Sol 为 99.00,Opus 官方基线为 40.68(按官方逐游戏得分在 25 个公开游戏上计算)。逐项拆解、开放权重模型和另三个基准的结果只出现在 10 月的报告里。本简报的数字一律取自报告。[S1][S2]
3D 渲染与另三个基准。
把同样的游戏渲染成 3D 画面,VISTA 仍得 84.12,但动作数从 9,126 增到 20,640。在另三个基准上(都用 GPT-5.6 Sol,与同一模型的官方最简实现对比):GameWorld 的 34 个浏览器游戏、170 个任务,成功率 63.3%(官方 40.0%,一名新手人类 55.3%);AI GameStore 的 10 个游戏,几何均值 140.3(人类中位数记为 100,官方 47.3);BabyVision 的 39 道静态视觉追踪题,准确率 63.2%(官方 41.0%,人类 92.3%)。最后一项说明,即使没有交互历史,只在一张图里按需放大,也有帮助。[S1]
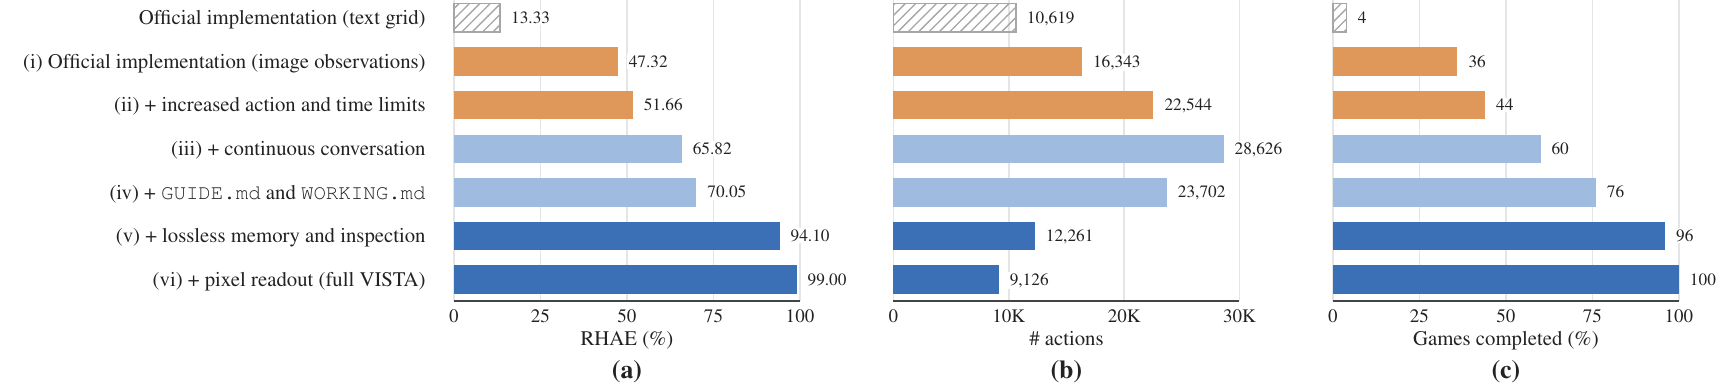
论文 Fig. 5:从官方实现(斜线灰条)到完整的 VISTA,逐步加组件后的 (a) RHAE、(b) 25 个游戏的总动作数、(c) 通关游戏比例。Han 等,arXiv:2610.02200,CC BY 4.0;由 arXiv 源文件中的 PDF 整图渲染,未作修改。 [S1]
05我从中学到什么
- 可迁移的洞见
- 能力的上限不一定在模型里:模型和上限都不变,只改看和记的方式,通关的游戏从 44% 变成全部。
- 设计启发
- 存原始观测,不只存摘要;让模型自己决定回看哪一帧、放大哪一块。
- 阅读启发
- 看到「换个框架分数翻几倍」,先看对照是否固定了模型、接入方式和动作与时间上限。
- 接下来看
- VISTA 在 ARC-AGI-3 私有游戏上的成绩,以及同样的回看机制用在真实实验画面上的结果。
框架是证据的一部分
这篇论文最可迁移的,不是某个分数,而是它的拆解方法:在同一模型、同一接入方式下一次只加一个组件,看每一步带来多少。按这个方法,它把「图像比文字好」「记忆比没有好」这些泛泛的说法,变成了可以比较大小的几步。任何声称「智能体能力提升」的工作,都可以问一句:这是模型变了,还是框架变了?
压缩早了会丢掉之后才需要的细节
论文的核心论证是:模型在第一次看到一张图时,不知道之后会需要哪些细节;把原图丢掉、只留编码或摘要,等到需要时就回不去了。这和本站「信息保真的上限」这个问题是同一件事:测量、提取、编码的每一道关口,都可能静默地丢掉信息。VISTA 是一个受控的例子:同一个模型,补上「能回到原始观测」这一条,分数提高了 24 分。
和写程序的路线对照
表 1 里写程序搭世界模型的系统(Schema、Retrodict、Tycho 等)也到了 95 到 100 分,所以 VISTA 没有在分数上超过它们,它的论点是「不写程序也行」。这两条路线在 ARC-AGI-3 上难分高下,但论文认为,画面越复杂,程序越难写;如果这个判断成立,对实验室这种难以写成程序的环境,看图加回看的路线更有希望。这一点还没有被检验。
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。