

综合解读
同一个模型,换一套外围系统:三份证据说明框架能决定多少成绩
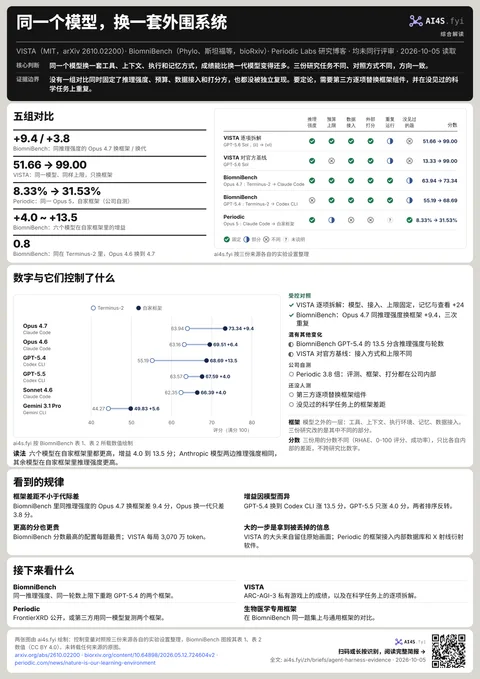
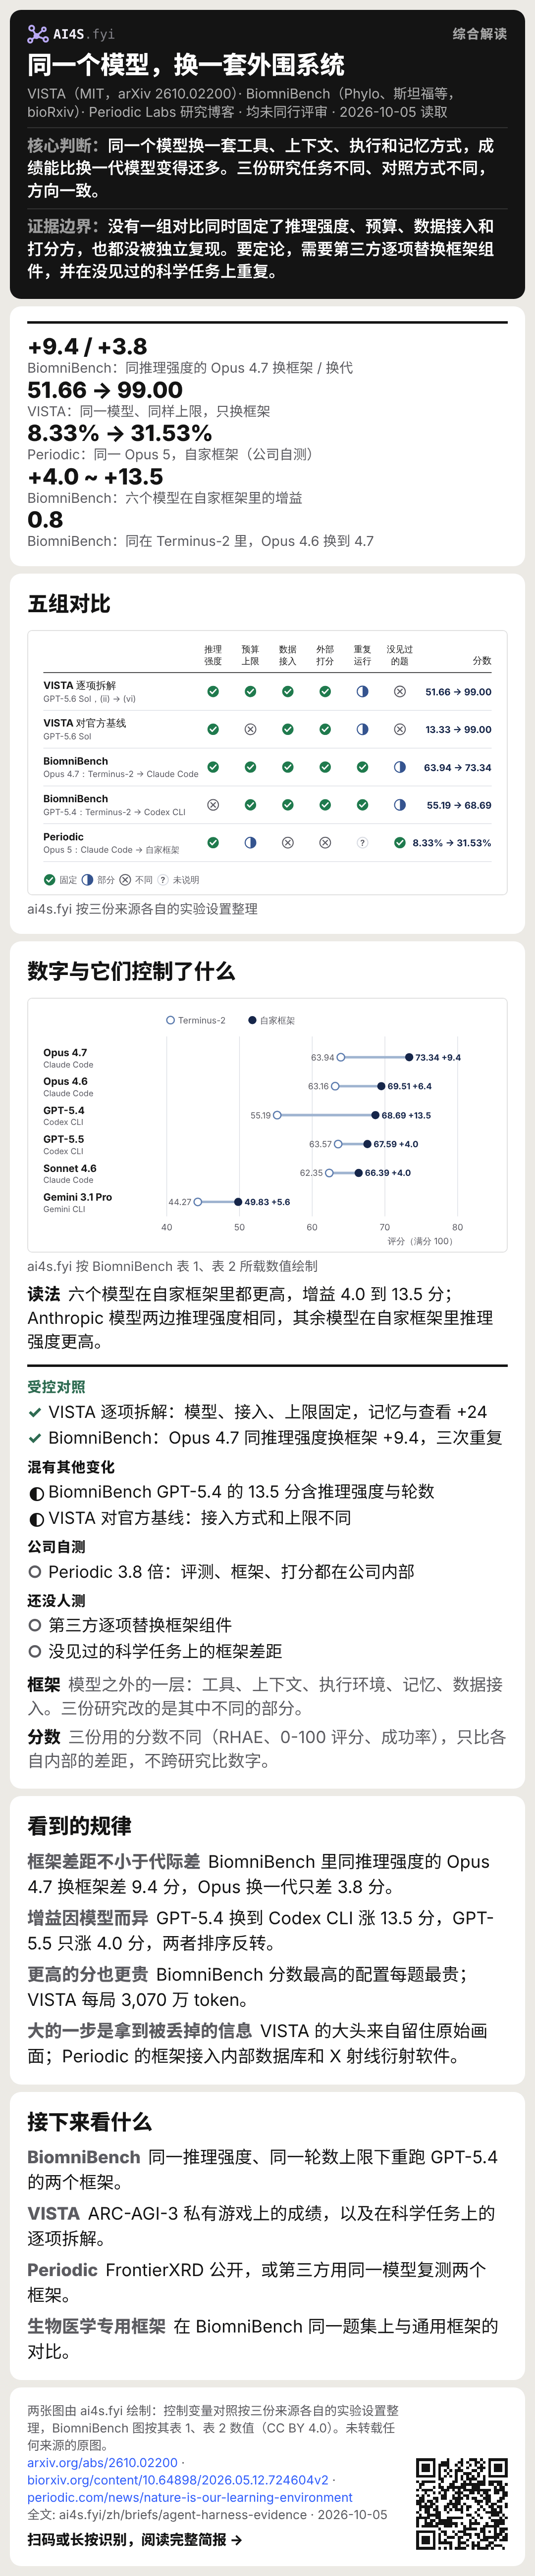
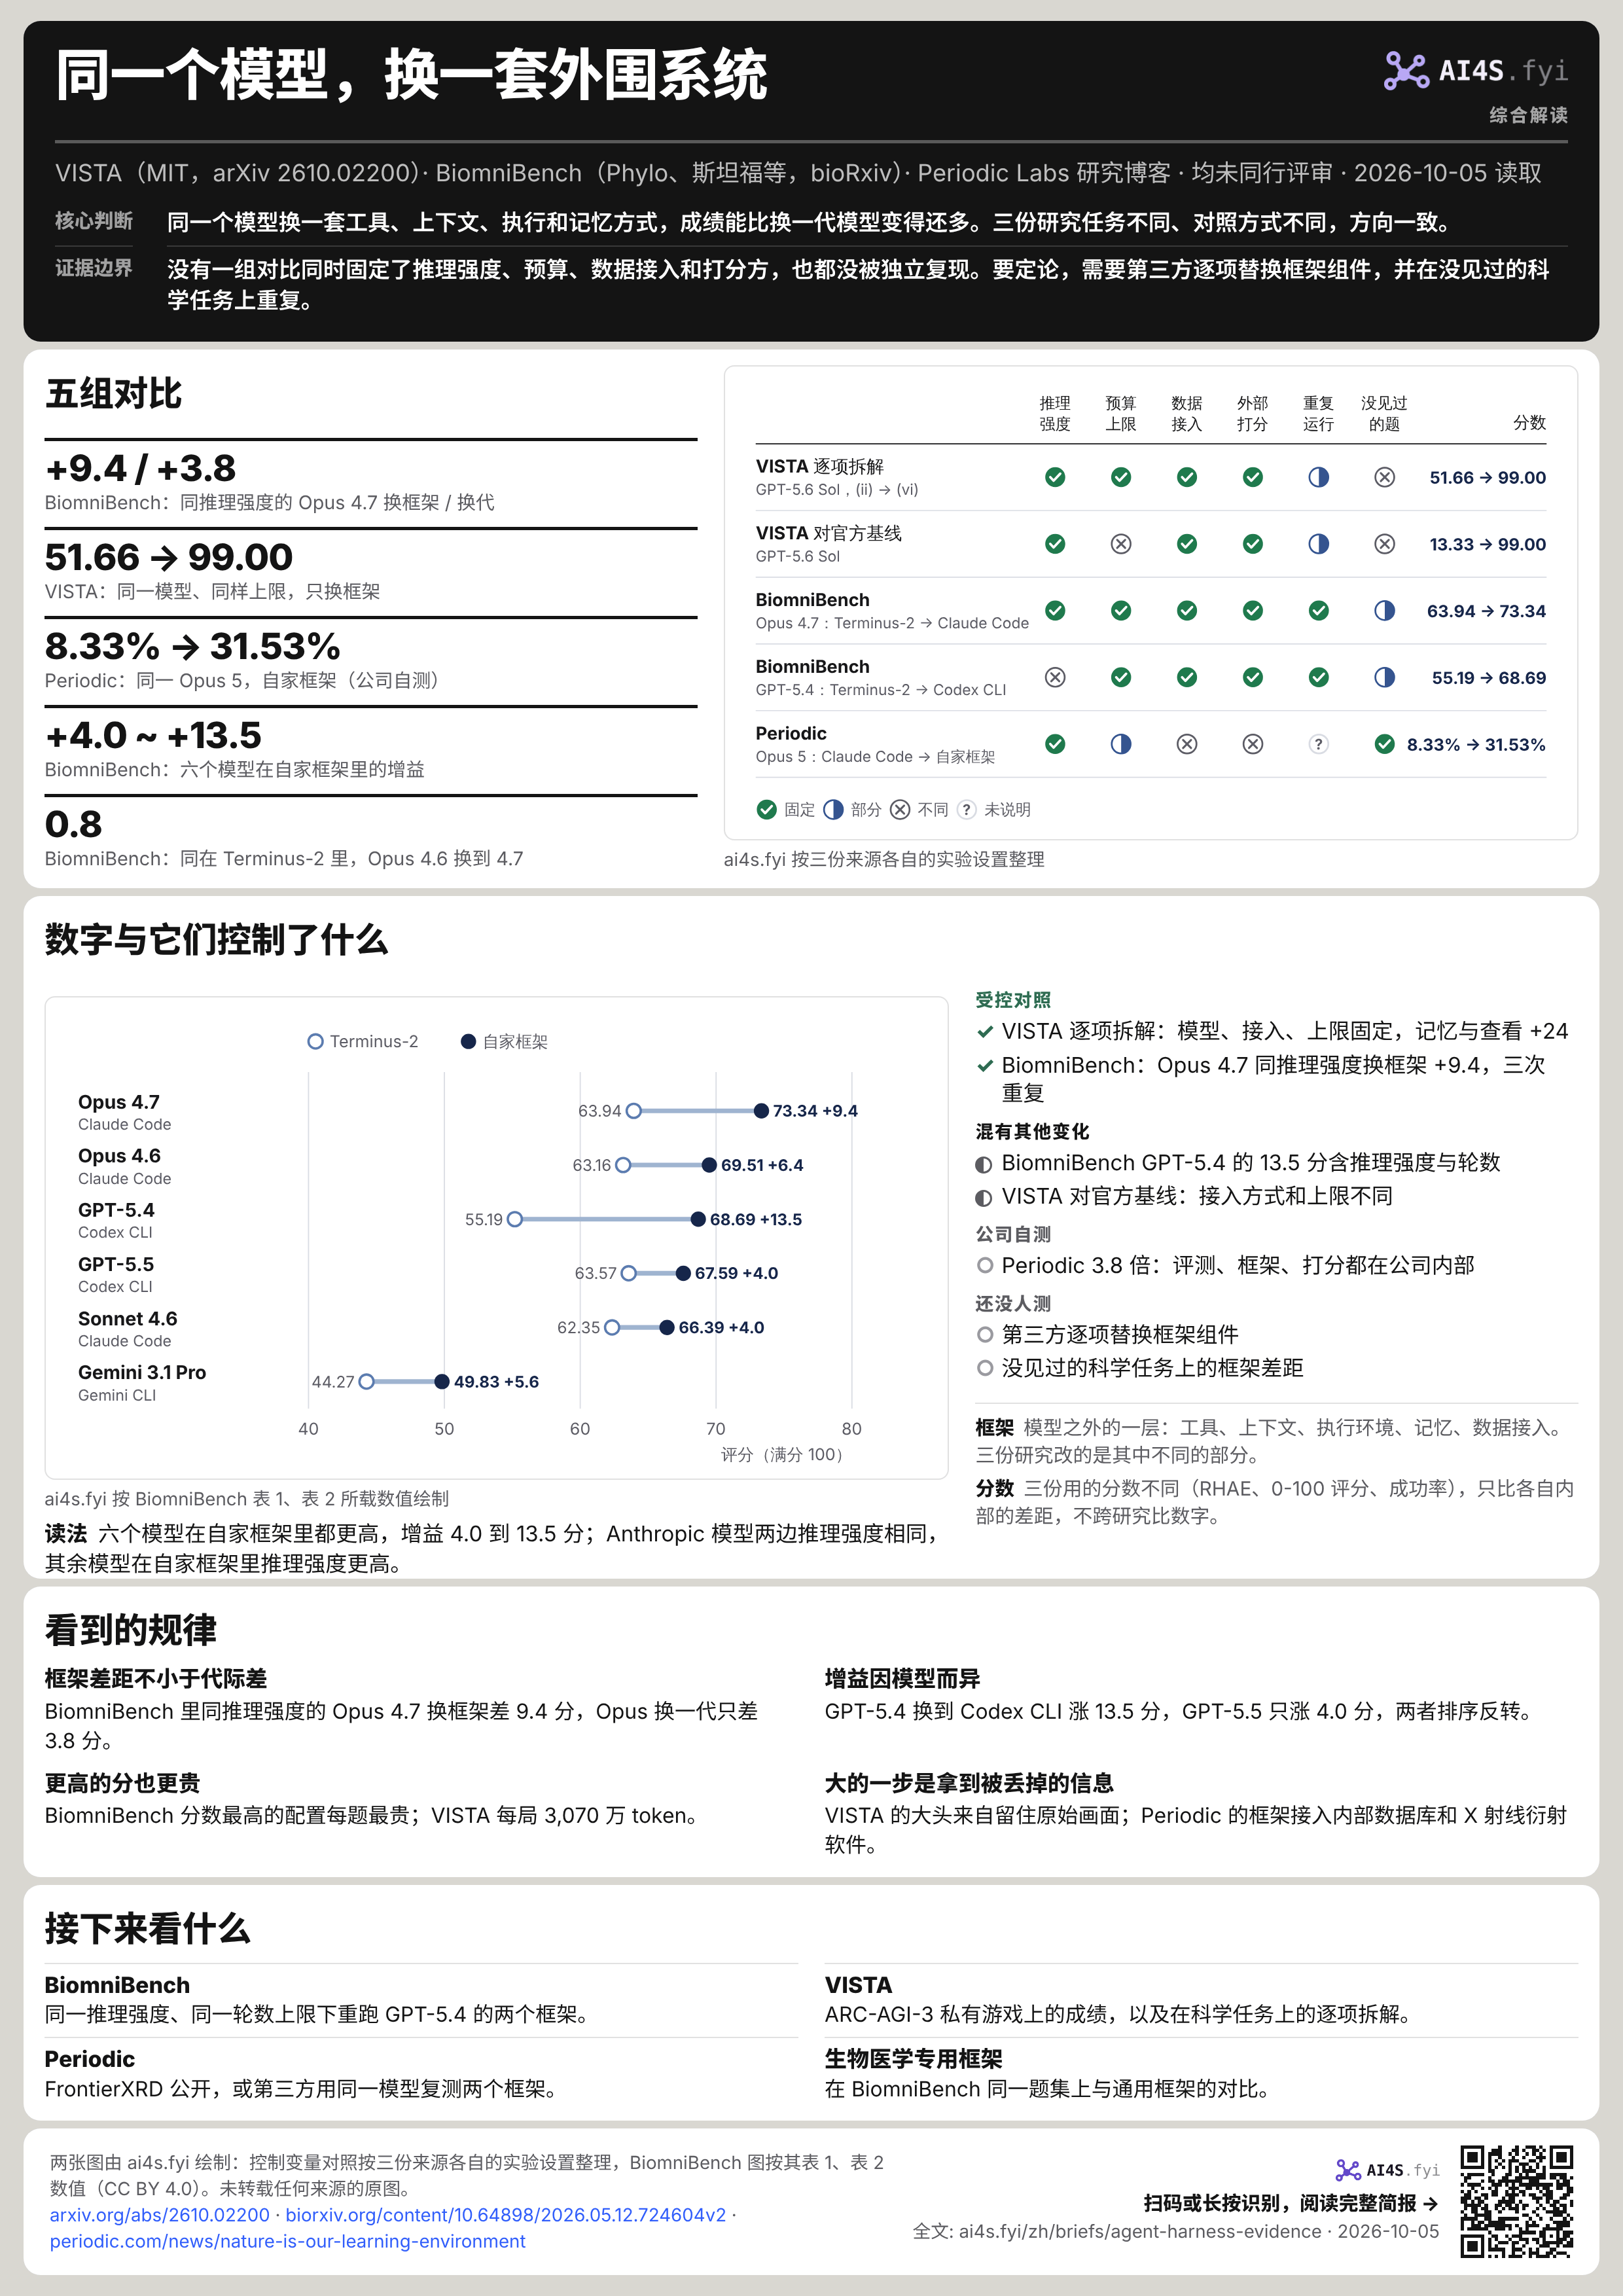
MIT 的 VISTA、Phylo 与斯坦福等的 BiomniBench,以及 Periodic Labs,都让同一个模型在不同框架里做同一组任务。方向一致,但每一组对比里,框架之外还有别的东西也变了。
◆三份来源 + 控制变量对照
- 核心判断
- 同一个模型换一套工具、上下文、执行和记忆方式,成绩能比换一代模型变得还多。三份研究任务不同、对照方式不同,方向一致。
- 证据边界
- 没有一组对比同时固定了推理强度、预算、数据接入和打分方,也都没被独立复现。要定论,需要第三方逐项替换框架组件,并在没见过的科学任务上重复。
+9.4 / +3.8BiomniBench:同推理强度的 Opus 4.7 换框架 / 换代
51.66 → 99.00VISTA:同一模型、同样上限,只换框架
8.33% → 31.53%Periodic:同一 Opus 5,自家框架(公司自测)
+4.0 ~ +13.5BiomniBench:六个模型在自家框架里的增益
0.8BiomniBench:同在 Terminus-2 里,Opus 4.6 换到 4.7
01五组对比
这篇简报把三份研究放在一起读:MIT 何恺明团队的 VISTA(2026 年 10 月 1 日技术报告,游戏环境)、Phylo 与斯坦福等团队的 BiomniBench(2026 年 5 月 12 日 bioRxiv 预印本,v2 发布于 5 月 18 日,生物医学数据分析),以及 Periodic Labs 2026 年 9 月 15 日的研究博客(XRD 相分析)。三份都让同一个模型在不同的外围系统里做同一组任务,都报告了明显的差距。本站对 VISTA 和 Periodic 各有一篇单独的简报;这里只看三者放在一起能说明什么、不能说明什么。[S2][S1][S3]
这里说的「框架」是什么
三份研究用的词都是 harness,指模型之外的那一层:给它什么工具、怎么管理上下文、在什么环境里执行、记住什么、能接入哪些数据。但三者改动的是不同的部分。VISTA 改的是模型看和记的方式:图像输入、保存每一帧原图、按需放大和回看、读像素,外加两份笔记。BiomniBench 比的是四个现成的通用编程智能体(Terminus-2、Claude Code、Codex CLI、Gemini CLI),任务、数据和容器都相同。Periodic 的自家框架除了工具,还接入了公司内部的结构与模拟数据库和实验室上下文,对照组只能用开源数据库和软件。[S2][S1][S3]
02数字与它们控制了什么
读法六个模型在自家框架里都更高,增益 4.0 到 13.5 分;Anthropic 模型两边推理强度相同,其余模型在自家框架里推理强度更高。
受控对照
- VISTA 逐项拆解:模型、接入、上限固定,记忆与查看 +24
- BiomniBench:Opus 4.7 同推理强度换框架 +9.4,三次重复
混有其他变化
- BiomniBench GPT-5.4 的 13.5 分含推理强度与轮数
- VISTA 对官方基线:接入方式和上限不同
公司自测
- Periodic 3.8 倍:评测、框架、打分都在公司内部
还没人测
- 第三方逐项替换框架组件
- 没见过的科学任务上的框架差距
框架模型之外的一层:工具、上下文、执行环境、记忆、数据接入。三份研究改的是其中不同的部分。
分数三份用的分数不同(RHAE、0-100 评分、成功率),只比各自内部的差距,不跨研究比数字。
BiomniBench 每个模型都在自家框架里更高
表 1 把九个模型放进同一个 Terminus-2 框架:前四名 Opus 4.7(63.94)、GPT-5.5(63.57)、Opus 4.6(63.16)、Sonnet 4.6(62.35)相差不到 1.6 分,开放权重的 GLM-5.1、Qwen 3.6、Kimi K2.6 落后 3 到 5 分。表 2 把六个模型放进各自厂商的框架:Opus 4.7 在 Claude Code 里 73.34(+9.4),Opus 4.6 69.51(+6.4),GPT-5.4 在 Codex CLI 里 68.69(+13.5),GPT-5.5 67.59(+4.0),Sonnet 4.6 66.39(+4.0),Gemini 3.1 Pro 在 Gemini CLI 里 49.83(+5.6)。每个配置跑三次,三次均值之间的标准差在 0.3 到 1.8 分之间,小于这些差距。[S1]
推理强度没有处处对齐
BiomniBench 附录 A.1 写明:Anthropic 的模型在 Terminus-2 里用自适应版本、effort=max,在 Claude Code 里也是 effort=max,所以 Opus 和 Sonnet 的差距是在相同推理强度下测的。其他模型在 Terminus-2 里用 reasoning_effort=high(该框架支持的最高档),在 Codex CLI 里用 xhigh,Gemini CLI 用动态思考预算(thinkingBudget=-1)。论文把 GPT-5.4 的 13.5 分写成「完全来自智能体架构」,但推理强度也不同。框架也改变了运行方式:GPT-5.4 的中位轮数从 13 轮到 82 轮,GPT-5.5 每题成本从 1.98 美元到 4.58 美元,Opus 4.7 从 0.87 美元到 2.52 美元;分数最高的配置也最贵。[S1]
谁打分
VISTA 用 ARC-AGI-3 官方的 RHAE 计分公式。BiomniBench 用 LLM 评委按每题的专家细则逐条打分,作者在 35 个任务、597 条细则上比较了五个候选评委,选了与专家一致度最高的 Gemini 3.1 Pro(逐条准确率 82%,线性加权 κ 0.70),并建议高风险评估再加人工复核。Periodic 用 Opus 5 和 GPT-5.6 Sol 组成的 LLM 评委,按专家评分校准,评测集 FrontierXRD 是自家实验室的 134 个样品,没有公开。三者的分数单位不同,所以本简报只比较每份研究内部的差距,不跨研究比数字。[S2][S1][S3]
03看到的规律
- 框架差距不小于代际差
- BiomniBench 里同推理强度的 Opus 4.7 换框架差 9.4 分,Opus 换一代只差 3.8 分。
- 增益因模型而异
- GPT-5.4 换到 Codex CLI 涨 13.5 分,GPT-5.5 只涨 4.0 分,两者排序反转。
- 更高的分也更贵
- BiomniBench 分数最高的配置每题最贵;VISTA 每局 3,070 万 token。
- 大的一步是拿到被丢掉的信息
- VISTA 的大头来自留住原始画面;Periodic 的框架接入内部数据库和 X 射线衍射软件。
三份放在一起能说什么
最稳的结论是方向:在游戏、生物医学数据分析和 XRD 三类任务上,同一个模型换外围系统,分数都变了一大截,而且在唯一做了代际对照的 BiomniBench 里,同推理强度下的框架差距(Opus 4.7 的 9.4 分)大于相邻两代模型的差距(3.8 分)。所以一句「模型 X 在任务 Y 上得 Z 分」,不写明框架、推理强度和预算就说不清楚。这一点比任何一份单独的研究都站得稳,因为三份的对照方式和任务类型都不同,却指向同一个方向。[S2][S1][S3]
三份放在一起还不能说什么
还不能说框架设计本身贡献了多少。VISTA 和官方基线的比较混着接入方式和上限;BiomniBench 最大的差距混着推理强度;Periodic 的差距混着私有数据库,而且是公司自测。三份都没有在独立团队手里复现过,VISTA 只测了公开游戏,BiomniBench 的任务改编自已发表的论文(智能体被禁止读原文,作者抽查没有发现抄近路,但不能完全排除记忆),只有 Periodic 用的是从未公开的样品。也还不能说「好框架」有统一的样子:VISTA 的增益来自留住原始观测,Periodic 的来自接入数据和领域软件,BiomniBench 的作者则认为现成框架都不是为生物医学设计的,专用框架还有空间。[S2][S1][S3]
对 AI for Science 意味着什么
对评估科学智能体的人,这意味着把框架当成被测对象的一部分来报告:模型、框架、推理强度、预算、数据接入,缺一项就不能和别人的数字比。对造科学智能体的团队,它意味着投入框架可能比等下一代模型更快见效,但也更贵:BiomniBench 里分数最高的配置每题成本最高,VISTA 每局用 3,070 万 token。Periodic 把框架当作核心系统来建,并说明所有模型的比较都在自家框架上做,这说明至少有一家前沿 AI4S 公司已经这样做了;但它的 3.8 倍是三份证据里控制最少的一个。[S1][S2][S3]
04接下来看什么
- BiomniBench同一推理强度、同一轮数上限下重跑 GPT-5.4 的两个框架。
- VISTAARC-AGI-3 私有游戏上的成绩,以及在科学任务上的逐项拆解。
- PeriodicFrontierXRD 公开,或第三方用同一模型复测两个框架。
- 生物医学专用框架在 BiomniBench 同一题集上与通用框架的对比。
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。
- S1BiomniBench: Process-level Evaluation of LLM Agents for Real-world Biomedical ResearchbioRxiv · Qu, Lu et al. (Phylo, Stanford et al.) · 2026.05.12 · 预印本 v2,未同行评审 · CC BY 4.0
- S2VISTA: A Visual Harness for Reasoning in an Interactive WorldarXiv:2610.02200 · Han, Hu, Qiu, Wu, He (MIT) · 2026.10.01 · 技术报告,未同行评审 · CC BY 4.0