

论文与证据观察· 科学证据 · Frontier
AI 智能体开始审计科学知识:从沿用 75 年的数据库错误,到成批复现顶会论文
从 Nature 的报道、SAI 的一项审计和三篇预印本看,AI for Science 不只需要更快地提出假设,也需要更快地核查已经写进论文、代码和数据库的知识。新的核验系统能把审计做到语料规模,但它们给出的是待查的线索,不是最终裁决。
◐新闻报道的案例 + agent 审计 + 预印本评测
当前边界:这类系统已能成规模地发现客观错误和复现障碍,但漏检、误报和执行失败仍让它们无法独立判定一篇论文
这项工作推进的是:核验数据库主张并复现科学论文
- MODEL理解 / 预测
- DECIDE选择下一步
- INTERACT测试现实
- UPDATE改变下一轮
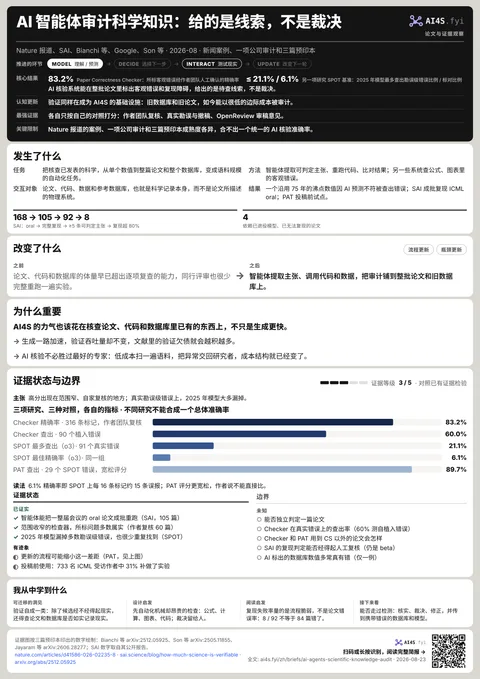
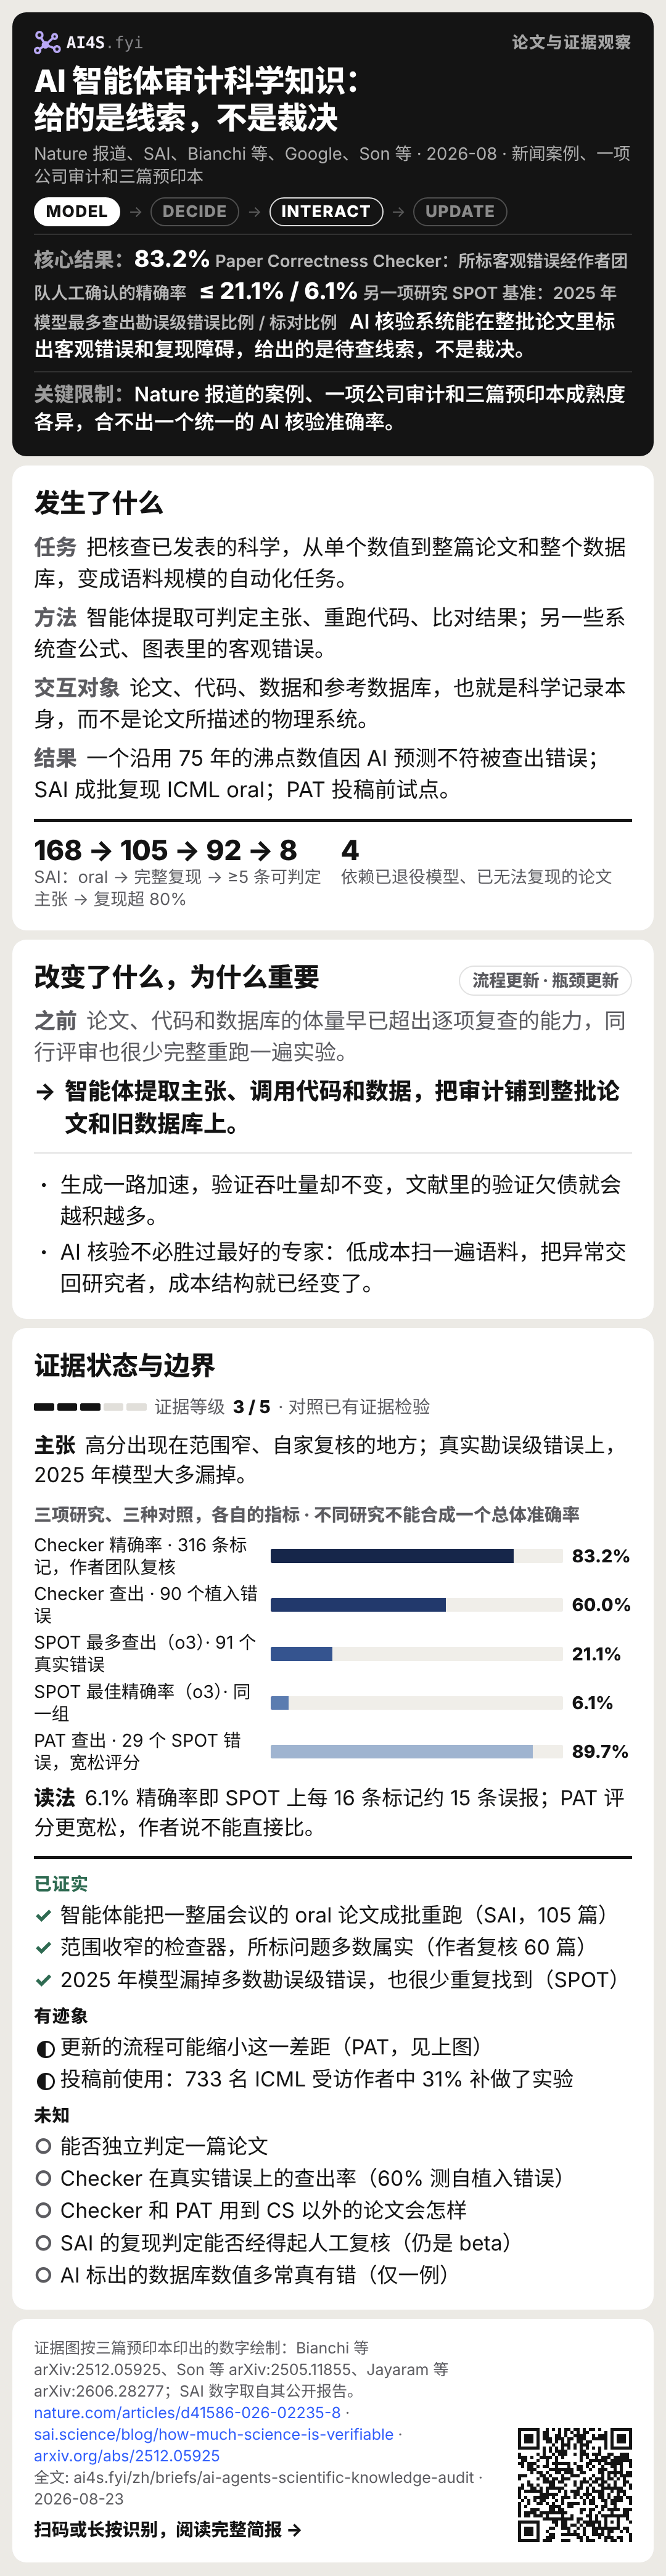
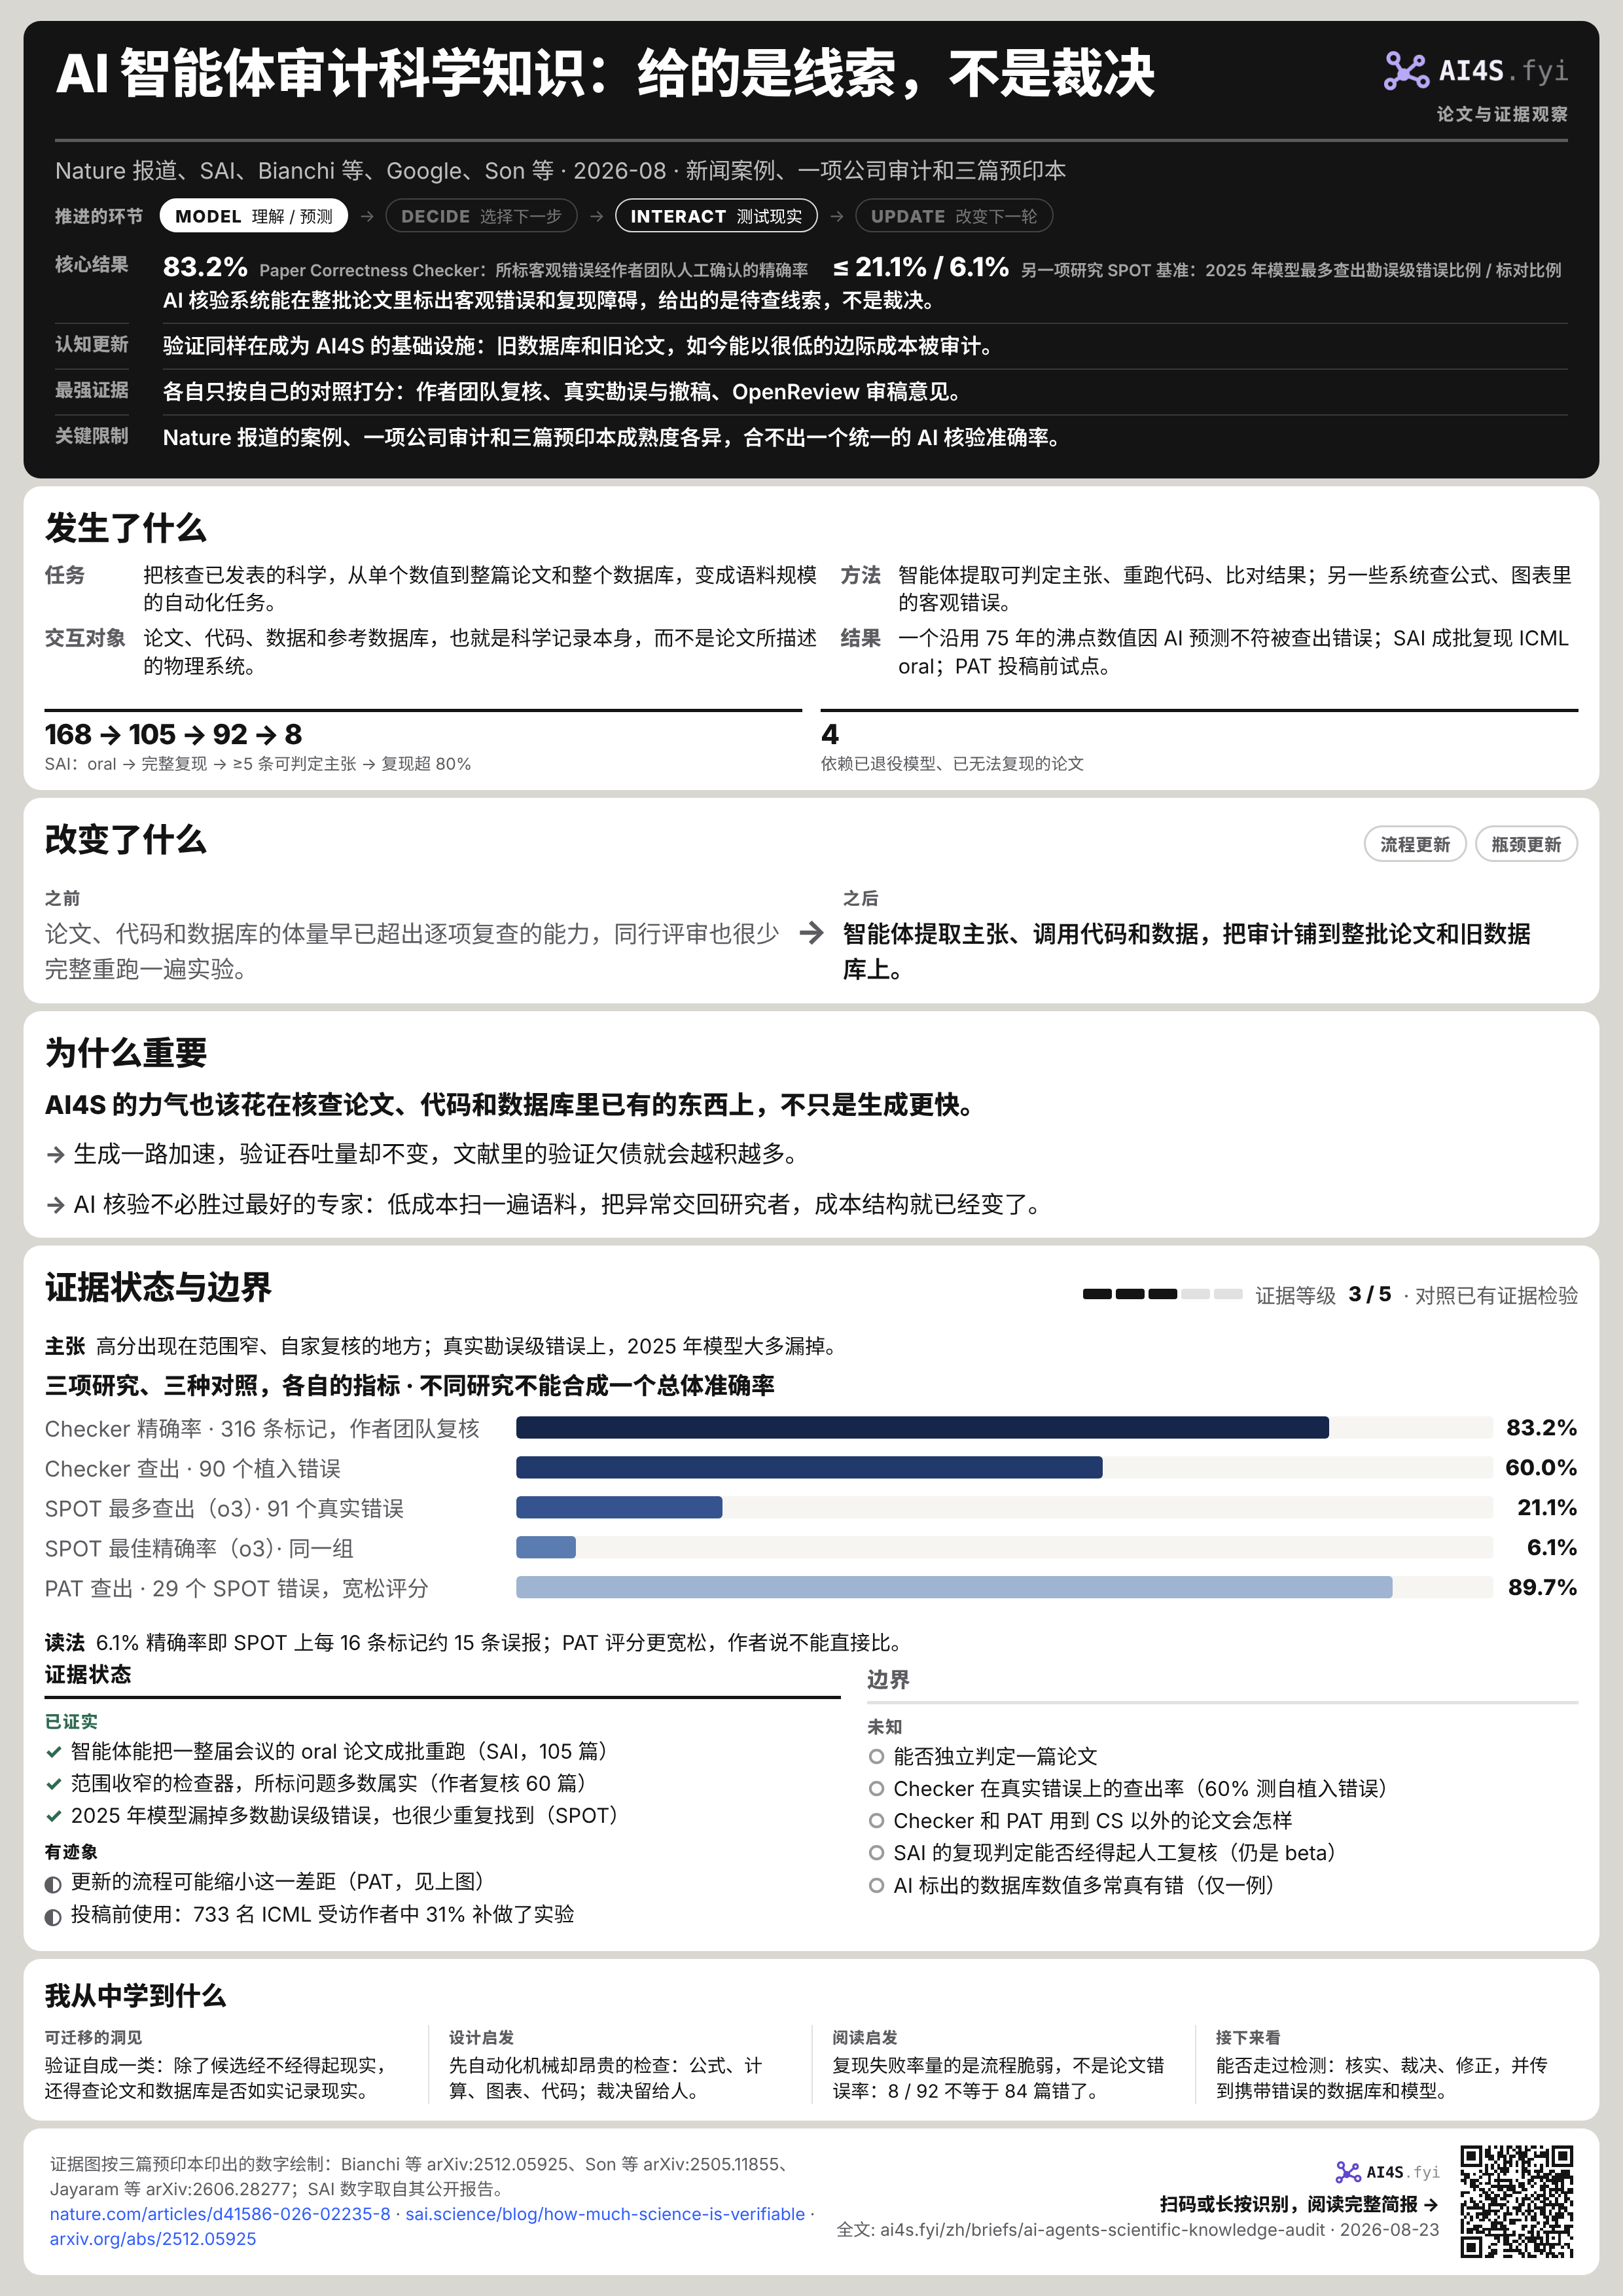
83.2%Paper Correctness Checker:所标客观错误经作者团队人工确认的精确率
≤ 21.1% / 6.1%另一项研究 SPOT 基准:2025 年模型最多查出勘误级错误比例 / 标对比例
AI 核验系统能在整批论文里标出客观错误和复现障碍,给出的是待查线索,不是裁决。
- 认知更新
- 验证同样在成为 AI4S 的基础设施:旧数据库和旧论文,如今能以很低的边际成本被审计。
- 最强证据
- 各自只按自己的对照打分:作者团队复核、真实勘误与撤稿、OpenReview 审稿意见。
- 关键限制
- Nature 报道的案例、一项公司审计和三篇预印本成熟度各异,合不出一个统一的 AI 核验准确率。
01发生了什么
- 任务
- 把核查已发表的科学,从单个数值到整篇论文和整个数据库,变成语料规模的自动化任务。
- 方法
- 智能体提取可判定主张、重跑代码、比对结果;另一些系统查公式、图表里的客观错误。
- 交互对象
- 论文、代码、数据和参考数据库,也就是科学记录本身,而不是论文所描述的物理系统。
- 结果
- 一个沿用 75 年的沸点数值因 AI 预测不符被查出错误;SAI 成批复现 ICML oral;PAT 投稿前试点。
168 → 105 → 92 → 8SAI:oral → 完整复现 → ≥5 条可判定主张 → 复现超 80%
4依赖已退役模型、已无法复现的论文
浙江实验室的理论化学家 Sebastian Pios 用 AI 预测分子沸点时,结果与一套沿用了 75 年的参考数据库对不上。他起初怀疑的是模型,回查原始文献后才确认:至少在这个案例里,错的是数据库。Nature 还报道了两桩类似的发现:一处旧论文里的排版错误,以及一批一个多世纪前测错、后来进了参考资料的沸点数据。[S1]
靠得住的做法不是“相信 AI”,而是把冲突当成异常信号:模型与参考数据对不上,研究者回到原始文献,最后才定位到错误。AI 没有推翻旧科学,只是让一处本会继续沉睡的矛盾重新显眼到值得去查。[S1]
与此同时,核查的对象也从单个数值扩大到整篇论文。SAI 的智能体会提取论文的核心主张,获取代码和数据,条件允许时重跑实验,再把结果与论文所报告的逐项对照。Google 的 Paper Assistant Tool 和斯坦福团队的 Paper Correctness Checker 则把核验放在两个不同位置:投稿之前,和发表之后。[S2][S4][S3]
从一个异常数值,到成批重跑论文
SAI 分析了 168 篇 ICML 2026 的 oral 论文,并对其中 105 篇做了完整复现尝试。它当前的公开报告写明:这 105 篇里有 92 篇至少含 5 条可判定的主张;其中 34 篇复现了超过 40% 的已尝试主张,只有 8 篇超过 80%。[S2][S1]
8 / 92 是这里最容易被误用的数字,它并不等于“只有 8 篇论文是对的”。自动复现要一连做完主张提取、材料获取、环境重建、代码执行和结果匹配;代码缺文件、依赖失效、数据或 checkpoint 不公开,甚至 agent 自己跑错,都会把分数压下来。[S2][S1]
即便如此,流程跑不通本身也有信息量。SAI 报告列出的常见问题包括:代码按发布时的状态跑不起来、实验描述不够详细、运行结果与论文对不上;还有四篇论文依赖已经退役的模型。这次审计首先量到的,是一篇论文从行文走到可验证结果,这条路有多脆弱。[S2]
02改变了什么
流程更新瓶颈更新论文、代码和数据库的体量早已超出逐项复查的能力,同行评审也很少完整重跑一遍实验。
智能体提取主张、调用代码和数据,把审计铺到整批论文和旧数据库上。
先查那些答案相对明确的错误
Federico Bianchi、James Zou 等人有意把 Paper Correctness Checker 的任务收窄:只查公式、推导、计算、图和表里的客观错误,不评判新颖性、重要性或写作质量。研究团队从标出至少一处实质错误的论文里随机抽了 60 篇,由论文作者们逐条人工复核这 60 篇里标出的 316 条问题,确认其中 263 条,精确率为 83.2%。召回率另用 90 个人为植入的错误测得 60.0%,真实错误上的召回率没有测。[S3]
在这项分析里,NeurIPS 论文每篇检出的平均错误数从 2021 年的 3.8 个升到 2025 年的 5.9 个,增加 55.3%。这并不能证明“AI 让论文变差了”:论文数量、复杂度、研究方式和审稿负担同期都在变。它说明的是,核验一旦能按同一标准批量跑起来,纵向审计才成为可能。论文自己把检出数当作保守的下限:召回约六成,漏掉的错误不在统计里。[S3]
核验正在往上游走,走到发表之前
Google 把 Paper Assistant Tool 开放给 STOC 和 ICML 的作者,定位是投稿前的一轮私密反馈,而不是替代正式审稿。在 733 名参与调查的 ICML 作者中,35.4% 表示它指出了需要花不少功夫才能补上的实质性理论缺口,31% 因为这些反馈补做了新实验。[S4]
于是核验系统占住了两个位置:发表之前,帮作者拦住新错误进入文献;发表之后,重新审计已经进入科学语料的论文和数据库。前者更像质量控制,后者是在偿还多年积下的验证欠债。
03为什么重要
AI4S 的力气也该花在核查论文、代码和数据库里已有的东西上,不只是生成更快。
- 生成一路加速,验证吞吐量却不变,文献里的验证欠债就会越积越多。
- AI 核验不必胜过最好的专家:低成本扫一遍语料,把异常交回研究者,成本结构就已经变了。
AI4S 过去最受关注的是生成:提出新分子、新蛋白、新材料、新假设。但科学知识不是候选数量的总和,而是一组可被检查、复现和修正的主张。生成继续提速,验证吞吐量却原地不动,验证欠债就会不断累积。[S4]
Pios 的案例还说明,文献和数据库本身就是科学基础设施。一个数值从实验走进论文、手册和数据库,再走进后来的实验和模型;传得越久,离它的原始出处往往越远。让旧知识重新可审计,省下的不只是审稿人的时间,更是在维护训练数据和科学决策的地基。[S1]
AI 核验不必取代最好的专家才算有用。只要它能以很低的边际成本扫过大量文献,稳定地找出一部分值得深究的异常,并把佐证交到研究者手里,科学核验的成本结构就已经变了。[S1]
04证据状态与边界
证据等级 3 / 5 · 对照已有证据检验 · 回顾性或模拟证据状态
已证实
- 智能体能把一整届会议的 oral 论文成批重跑(SAI,105 篇)
- 范围收窄的检查器,所标问题多数属实(作者复核 60 篇)
- 2025 年模型漏掉多数勘误级错误,也很少重复找到(SPOT)
边界
有迹象
- 更新的流程可能缩小这一差距(PAT,见上图)
- 投稿前使用:733 名 ICML 受访作者中 31% 补做了实验
未知
- 能否独立判定一篇论文
- Checker 在真实错误上的查出率(60% 测自植入错误)
- Checker 和 PAT 用到 CS 以外的论文会怎样
- SAI 的复现判定能否经得起人工复核(仍是 beta)
- AI 标出的数据库数值多常真有错(仅一例)
主张高分出现在范围窄、自家复核的地方;真实勘误级错误上,2025 年模型大多漏掉。
三项研究、三种对照,各自的指标 · 不同研究不能合成一个总体准确率
读法6.1% 精确率即 SPOT 上每 16 条标记约 15 条误报;PAT 评分更宽松,作者说不能直接比。
Nature 把成熟度不同的案例放在了一起。
沸点那桩是 Nature 报道的研究者自述,没有对应的原始论文;SAI 是公司公开的在线审计;Paper Correctness Checker、PAT 和 SPOT 则是预印本。它们凑不成一个可比的“AI 核验准确率”。[S1][S2][S3][S4][S5]
五组材料并排看:研究、对象、样本、指标、验证方式
Nature 报道的沸点案例。
对象是一套参考数据库里的单个数值;样本是一个案例;没有指标;验证方式是研究者回到原始文献。它是说明性案例,说明 AI 的分歧能把人引向错误,不衡量任何系统的准确率。[S1]
SAI 审计。
对象是 ICML 2026 全部 168 篇 oral;105 篇完整复现尝试,92 篇至少有 5 条可判定主张;指标是每篇已尝试主张的复现比例(含缩小规模的运行);验证方式是与论文报告的结果比对,另把审查意见与 OpenReview 上的人类审稿对照:两位以上审稿人都提到的意见,78% 被 SAI 覆盖。复现结果本身没有人工复核,SAI 也说它仍是 beta、会出错。[S2]
Paper Correctness Checker。
对象是 2,100 篇 ICLR、NeurIPS 论文和 400 篇 TMLR 论文里的客观错误;指标是精确率 83.2%(60 篇、316 条标记,作者团队复核)和召回率 60.0%(90 个植入错误)。[S3]
Google PAT。
对象是 STOC(124 名受访作者)和 ICML(733 名)投稿前的论文;指标是作者自报,比如 ICML 作者中 35.4% 说它指出了要花一小时以上才能补的理论错误、31% 补做了新实验;另在 SPOT 的 29 个错误上测召回,每个评分由作者之一人工核对。[S4]
SPOT 基准。
对象是十个学科的 83 篇已发表论文、91 个引发过勘误或撤稿的错误,经原作者和标注者交叉确认;指标是召回率、精确率和 8 次运行的一致性;它测的是通用大模型,不是上面某个专门系统。[S5]
复现失败率不是论文错误率。
在 92 篇至少含 5 条可判定主张的论文里,34 篇复现了超过 40% 的已尝试主张,8 篇超过 80%。8 / 92 这个结果同时取决于论文附带的材料、环境依赖、资源可得性、评测口径和 agent 本身的能力。它说明的是端到端自动验证很难,不能改写成“84 篇论文是错的”。[S2]
核验系统自己也得先被验证。
SPOT 收集了十个学科的 83 篇论文和 91 个严重到足以引发勘误或撤稿的错误。在它 2025 年 5 月的评测中,没有模型的召回率超过 21.1%、精确率超过 6.1%(都是 o3),8 次独立运行也很少重复找到同一处错误。一年后 Google 的 PAT 论文从中挑出 26 篇数学/CS 论文的 29 个公式与证明错误,PAT 召回 89.7%、Gemini 3.1 Pro 单次调用 55.2%;但它用的是判断逻辑等价的宽松评分器,作者自己说与 SPOT 原数字不能直接比。就今天而言,合适的角色是分诊,不是裁决。[S5][S4]
查客观错误和评判科学价值,是两回事。
公式符号、表格自相矛盾、代码能否重跑、数据出处,这些通常有相对明确的判据;新颖性、重要性和解释则需要领域背景和价值判断。现有系统有意保留这条属于人的边界。[S3][S4]
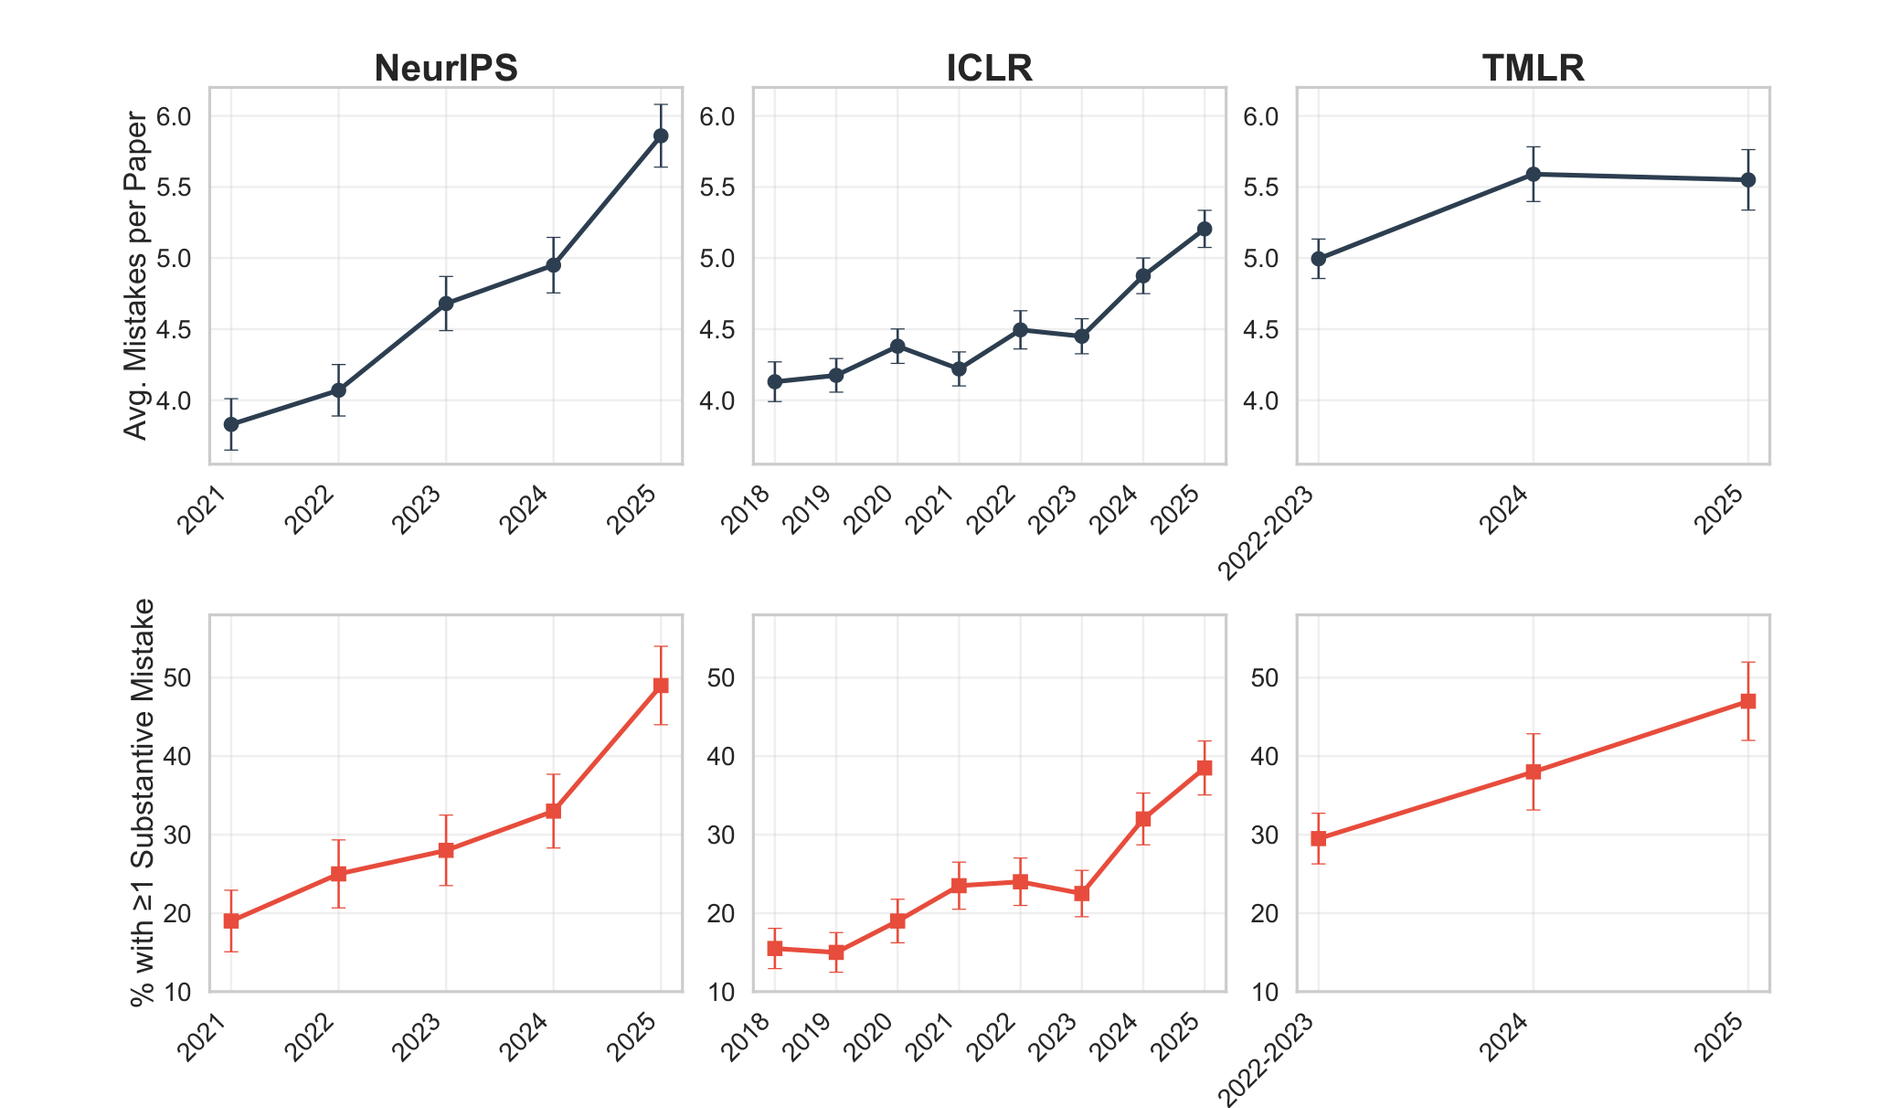
论文 Fig. 1:上排是每篇平均检出错误数,下排是含至少一处潜在实质错误的论文占比。NeurIPS 从 2021 年的 3.8 升到 2025 年的 5.9;这不能直接推出科研质量下降,同期论文数量、复杂度和审稿负担也在变,检出数也只是保守下限。Bianchi et al., arXiv:2512.05925,CC BY 4.0。 [S3]
05我从中学到什么
- 可迁移的洞见
- 验证自成一类:除了候选经不经得起现实,还得查论文和数据库是否如实记录现实。
- 设计启发
- 先自动化机械却昂贵的检查:公式、计算、图表、代码;裁决留给人。
- 阅读启发
- 复现失败率量的是流程脆弱,不是论文错误率:8 / 92 不等于 84 篇错了。
- 接下来看
- 能否走过检测:核实、裁决、修正,并传到携带错误的数据库和模型。
验证不只发生在实验室里
实验验证问的是:模型提出的候选经不经得起与现实接触。知识验证问的是:论文、数据库和手册有没有如实记录现实。两者对象不同,做的却是同一件事:不让未经核验的结果流进下一轮学习和决策。
发表不该是知识就此冻结的时刻
更健康的知识生命周期也许是:发表 → 被复用 → 定期审计 → 被修正。AI 让后两步在大规模文献上开始变得可以设想。
先把机械却昂贵的检查自动化
公式、计算、图表是否一致、代码能否跑通、引用出处核查,都很费时间,判据却往往比较明确。让 AI 把覆盖面铺开、人保留判断和裁决,比让模型直接决定接收或拒稿更符合眼下的能力。
生成扩大规模,验证也得跟着扩大
AI 把写代码、分析数据和成文的成本压下来之后,科学产出还会继续增长。验证能力若不同步扩大,后来的研究就会建在越来越难检查的地基上。
查出错误之后,瓶颈变成让修正传下去
确认一个沿用 75 年的数据库数值有误,只是第一步。修正还得追到抄录过它的数据库、引用过它的论文、依赖过它的实验,以及学过它的模型。完整的链条是:检测 → 核实 → 裁决 → 修正 → 传播。
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。
- S1AI agents are checking the scientific literature — and spotting decades-old errorsNature · Chris Stokel-Walker · 2026.08.06 · News in Focus · 案例综述
- S2How much science is verifiable? Results from replicating ICML 2026 oral papersSAI · 2026.07.22 · 公司公开的 agent 审计
- S3To Err Is Human: Systematic Quantification of Errors in Published AI Papers via LLM AnalysisBianchi et al. · arXiv · 2025.12.05 · 预印本
- S4Towards Automating Scientific Review with Google's Paper Assistant ToolGoogle Research · arXiv · 2026.06.26 · 预印本 + 会议试点
- S5When AI Co-Scientists Fail: SPOT—a Benchmark for Automated Verification of Scientific ResearchSon et al. · arXiv · 2025.05.17 · 预印本与基准测试