

论文解读
AlphaProtein Novo:从头设计的酶在选择性和条件上胜过筛来的天然酶,速率上没有
Google DeepMind 与加州理工用扩散模型按催化基序生成酶的主链与序列,再用 AlphaFold 3 的预测结构按机理筛选,五个反应共测了 3,537 个新骨架设计。两个实际问题上:合成哌啶,他们筛的 188 个天然与已改造血红素蛋白最好只到 30:70,设计做到 99:1、94% 对映体过量;降解增塑剂 DEHP,设计在室温下不如天然酶,但在 90°C 和 75% 乙腈里仍有活性,而两个天然酯酶在那里完全失活。论文自己写明:速率仍比天然酶和定向进化产物低几个数量级。
◆预印本 + 湿实验测定 + 活性位点敲除对照
当前边界:设计出的酶被合成、表达、纯化并测了动力学,敲掉催化残基后活性消失,这些测到了;但速率仍低天然酶几个数量级,哌啶那组对照是作者自己做的筛选,设计序列尚未公开,无人能独立复现
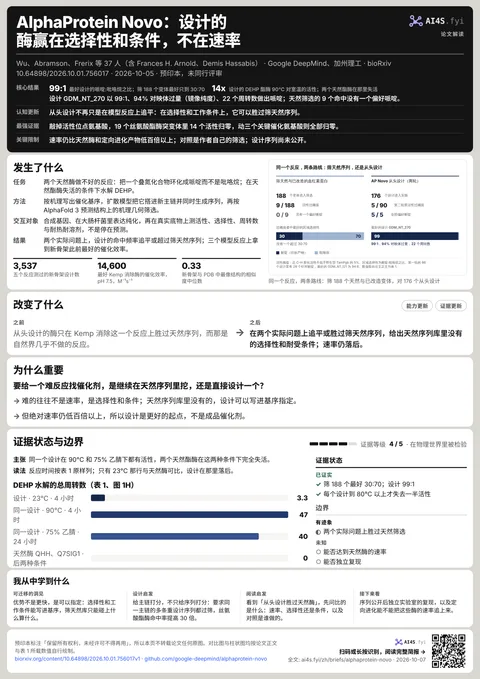
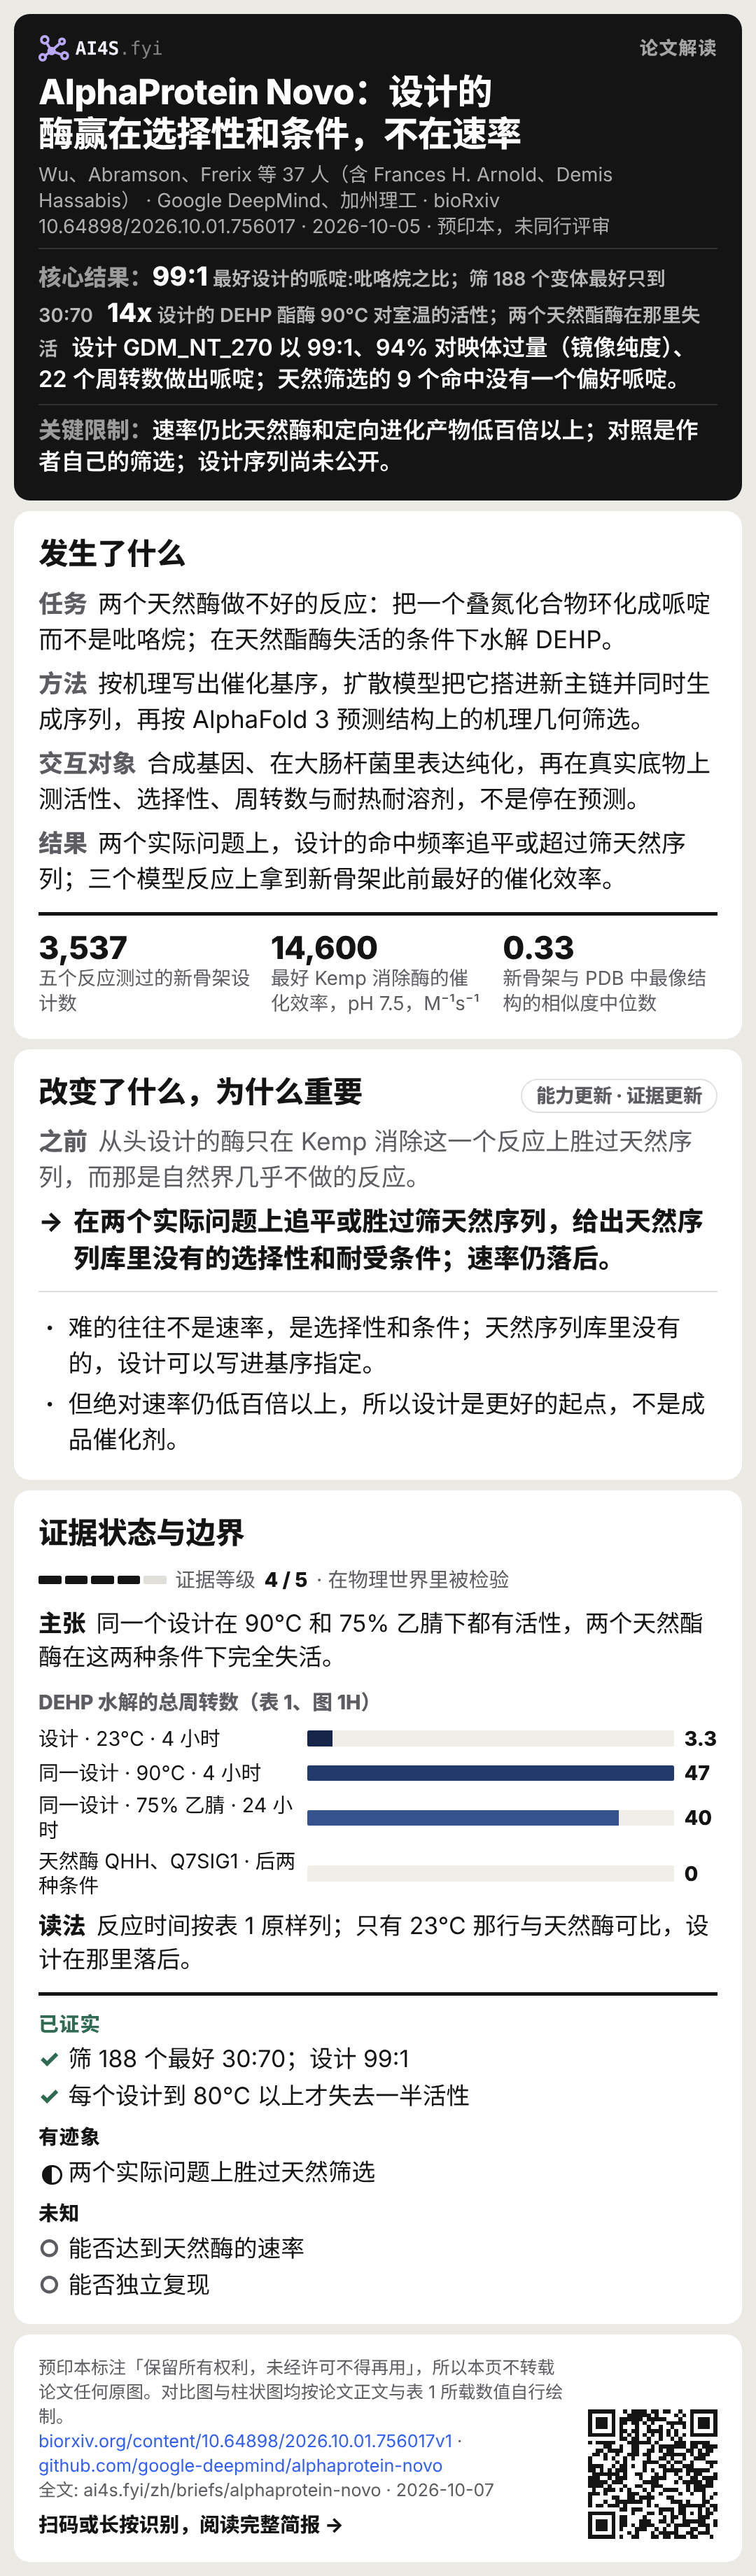
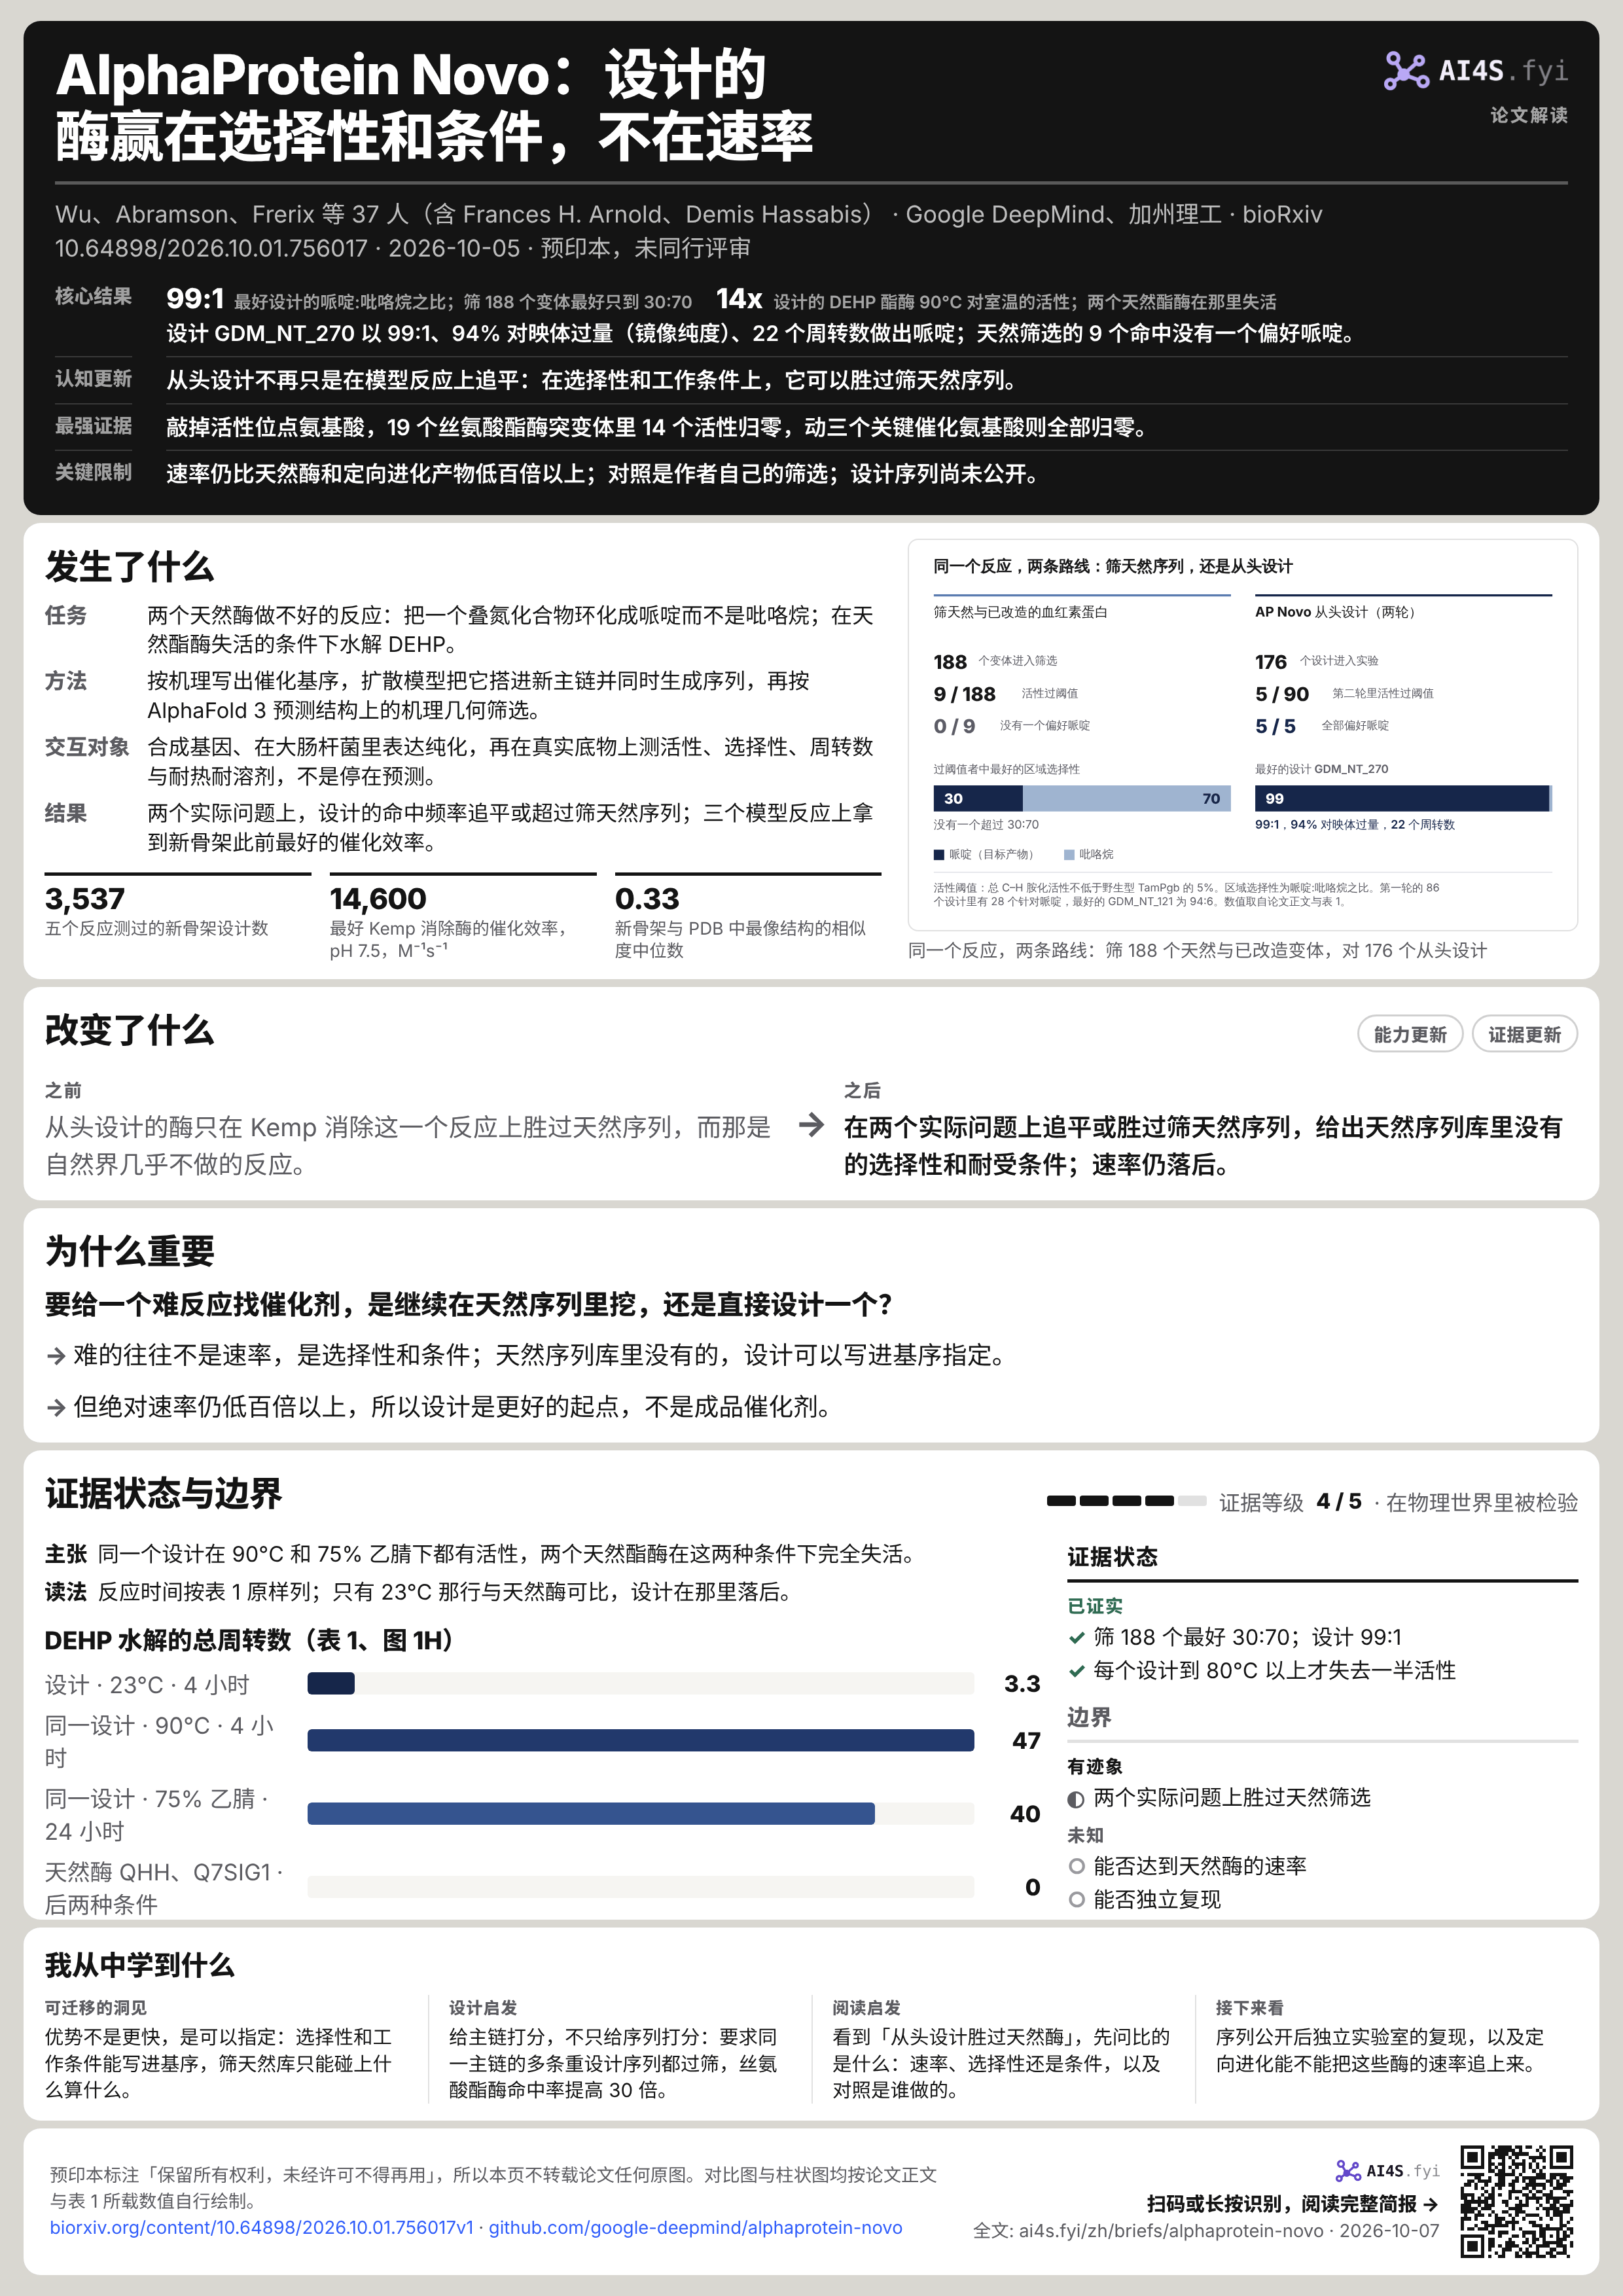
99:1最好设计的哌啶:吡咯烷之比;筛 188 个变体最好只到 30:70
14x设计的 DEHP 酯酶 90°C 对室温的活性;两个天然酯酶在那里失活
设计 GDM_NT_270 以 99:1、94% 对映体过量(镜像纯度)、22 个周转数做出哌啶;天然筛选的 9 个命中没有一个偏好哌啶。
- 认知更新
- 从头设计不再只是在模型反应上追平:在选择性和工作条件上,它可以胜过筛天然序列。
- 最强证据
- 敲掉活性位点氨基酸,19 个丝氨酸酯酶突变体里 14 个活性归零,动三个关键催化氨基酸则全部归零。
- 关键限制
- 速率仍比天然酶和定向进化产物低百倍以上;对照是作者自己的筛选;设计序列尚未公开。
01发生了什么
- 任务
- 两个天然酶做不好的反应:把一个叠氮化合物环化成哌啶而不是吡咯烷;在天然酯酶失活的条件下水解 DEHP。
- 方法
- 按机理写出催化基序,扩散模型把它搭进新主链并同时生成序列,再按 AlphaFold 3 预测结构上的机理几何筛选。
- 交互对象
- 合成基因、在大肠杆菌里表达纯化,再在真实底物上测活性、选择性、周转数与耐热耐溶剂,不是停在预测。
- 结果
- 两个实际问题上,设计的命中频率追平或超过筛天然序列;三个模型反应上拿到新骨架此前最好的催化效率。
3,537五个反应测过的新骨架设计数
14,600最好 Kemp 消除酶的催化效率,pH 7.5,M⁻¹s⁻¹
0.33新骨架与 PDB 中最像结构的相似度中位数
2026 年 10 月 5 日,Google DeepMind 与加州理工在 bioRxiv 发布预印本《Designing enzymes for new-to-nature chemistry and non-natural substrates with AlphaProtein Novo》(10.64898/2026.10.01.756017v1)。37 位作者,Zachary Wu、Josh Abramson、Thomas Frerix 等 11 人并列第一,通讯作者是 Pushmeet Kohli 和 Jue Wang;2018 年因酶的定向进化获诺贝尔化学奖的 Frances H. Arnold 在作者名单里,她在加州理工的组承担了部分湿实验;Demis Hassabis 与 Rob Fergus 署名为项目顾问。论文未经同行评审。作者声明已就用生成式扩散模型和结构预测网络做蛋白与酶的从头设计提交一份美国临时专利申请,并写明除七位作者外其余人在这项工作中有商业利益。[S1]
管线:生成主链,然后按机理筛
AP Novo 的做法是「基序支架化加筛选」。对每个反应,作者按假设的催化机理写出一个催化基序:若干侧链官能团,加上以相应中间态建模的小分子配体。基序交给扩散模型,生成一个把基序保持在指定构象上的蛋白结构;扩散过程同时跑结构坐标的高斯扩散和序列的掩码离散扩散,所以它直接给出序列,不一定需要外部的序列设计模型。实际使用中,大部分设计还是把生成的结构交给 LigandMPNN 重新设计序列。候选设计最后按 AlphaFold 3(部分用一个针对离去原子微调的变体 AF3-LA)的预测结构筛选。代码与权重已公开在 GitHub:代码为 Apache 2.0,模型权重则按单独的使用条款,仅供非商业组织的非商业用途。[S1][S2]
哌啶:天然序列库里没有的选择性
(5-叠氮戊基)苯在氮宾转移下可以环化成五元环吡咯烷或六元环哌啶。吡咯烷走的是几何上更有利的 1,5-氢原子转移,哌啶靠的是苄位 C–H 键更低的解离能。哌啶是 FDA 批准药物里最常见的含氮骨架之一,所以能偏向六元环就有实用价值。作者先按常规做法筛天然与此前改造过的血红素蛋白:188 个变体里 9 个总 C–H 胺化活性达到野生型 TamPgb 的 5% 以上,其中没有一个的哌啶:吡咯烷之比超过 30:70。随后用 AP Novo 设计含组氨酸配位血红素的新骨架,分别以氮宾中间体或两种产物之一建模,第一轮选了 86 个做实验,每个子集都出了过阈值的酶:按吡咯烷设计的 GDM_NT_141 给出 4:96,按哌啶设计的 GDM_NT_121 给到 94:6。第二轮 90 个专门针对哌啶的新骨架里,5 个过阈值且全部高选择性,最好的 GDM_NT_270 给出 22 个周转数、99:1 的区域异构比、94% 对映体过量,哌啶产物的总周转数比野生型 TamPgb 高两个数量级。[S1]
DEHP:赢的是条件,不是室温活性
DEHP 是无处不在的增塑剂和环境污染物,两条 2-乙基己基侧链的位阻让天然水解酶很难作用在它上面,而它在水里几乎不溶(约 0.3 mg/L),能让它溶解的有机助溶剂又会让大多数天然酯酶失活。作者从天然水解酶晶体结构取 Ser-His-Asp 三联体和氧阴离子洞残基做基序,把 RDKit 生成的 DEHP 构象以共价连在催化丝氨酸上的四面体中间体建模进去。第一轮 81 个设计里 4 个活性高出背景三个标准差;又两轮后,新骨架命中率(活性达到天然对照 QHH 的 2% 以上)做到 11%,回收骨架 39%。作为对照,此前一项筛 65 个天然酯酶的研究只找到 1 个有 DEHP 酶活性的。设计出的七个结构家族彼此之间、与已知天然酯酶之间的 TM-score 都低于 0.5。纯化后测活性,室温水相里设计不如天然酶:最活跃的 GDM_DEHP_378 在 4 小时后只有 QHH 产 MEHP 量的 6%、Q7SIG1 的 26%(24 小时后分别为 13% 和 34%)。但最稳健的 GDM_DEHP_376 在 90°C 下活性是室温的 14 倍,在 75% 乙腈里是无乙腈时的 2 倍,而两个天然酯酶(包括来自嗜热菌的 Q7SIG1)在这两种条件下都完全没有活性。它只有 191 个氨基酸,比 QHH 小 60%、比 Q7SIG1 小 40%,在大肠杆菌里的表达量也更高。作者自己写明,要用于真实的生物修复,还需要更高的活性和把 DEHP 完全降解到邻苯二甲酸。[S1]
02改变了什么
能力更新证据更新从头设计的酶只在 Kemp 消除这一个反应上胜过天然序列,而那是自然界几乎不做的反应。
在两个实际问题上追平或胜过筛天然序列,给出天然序列库里没有的选择性和耐受条件;速率仍落后。
变的是从头设计在流程里的位置,不是它的速度上限。此前的共识可以这样概括:对天然酶已经优化好的反应,从头设计差几个数量级;对天然界不做的反应,从头设计能做出来,但能不能比「先去数据库里找一个差不多的酶再改」更划算,没有人在同一个问题上比过。这篇论文给了那个比较,结论是分场景的:要速率,挖天然序列仍然更稳;要一个天然序列给不出的选择性,或者要在 90°C、75% 乙腈这种条件下工作,设计可以把要求直接写进目标。作者也顺手给了一条数量级的参照:此前关于从头设计的方法学结论大多建立在很少的设计和更少的骨架上,而这里一次测了 3,537 个新骨架设计,跨五个反应。[S1]
03为什么重要
要给一个难反应找催化剂,是继续在天然序列里挖,还是直接设计一个?
- 难的往往不是速率,是选择性和条件;天然序列库里没有的,设计可以写进基序指定。
- 但绝对速率仍低百倍以上,所以设计是更好的起点,不是成品催化剂。
这篇论文真正的新意不在某个催化参数,而在它第一次把两条路线放在同一个问题上直接比:同一个反应、同一套测定、同一个实验室,一边筛 188 个天然与已改造变体,一边做 176 个从头设计。此前从头设计的酶几乎只在 Kemp 消除这种模型反应上和天然序列比过,而那是一个天然界几乎不做的反应;在天然酶已经高度优化的反应上,从头设计的速率仍差几个数量级。作者选的两个问题都避开了「比速率」这个赛道:哌啶要的是区域选择性,DEHP 要的是在变性条件下还能工作。这是一个关于「该把设计用在哪里」的判断,而不是一个关于「设计已经超过自然」的判断。[S1]
对买方和建设方,这里有一条可用的分界。如果目标分子的反应天然界做得很好,设计目前买不到速度;如果要的是天然界没有的选择性,或者要在天然酶活不下去的温度、溶剂、pH 下工作,设计可以直接把这些条件写进目标里,而筛库只能碰运气。DEHP 那一组是这条分界最干净的例子:同一个设计在室温下输给天然酶,在 90°C 和 75% 乙腈下赢它一个「有活性对完全没有」。对 AI4S 的投入判断,这意味着从头设计的近期价值更可能出现在工业酶、生物修复、非天然底物这类场景,而不是替代已经被进化打磨过的代谢酶。这是本站的推断,论文没有做这个论证。[S1]
04证据状态与边界
证据等级 4 / 5 · 在物理世界里被检验证据状态
已证实
- 筛 188 个最好 30:70;设计 99:1
- 每个设计到 80°C 以上才失去一半活性
边界
有迹象
- 两个实际问题上胜过天然筛选
未知
- 能否达到天然酶的速率
- 能否独立复现
主张同一个设计在 90°C 和 75% 乙腈下都有活性,两个天然酯酶在这两种条件下完全失活。
DEHP 水解的总周转数(表 1、图 1H)
读法反应时间按表 1 原样列;只有 23°C 那行与天然酶可比,设计在那里落后。
三个模型反应上的催化参数。
为了摸索筛选方法,作者在三个模型反应上做了多轮设计-测试-学习。Kemp 消除:七轮共 1,536 个新骨架设计,最好一个子集的命中率 34%,最好的 GDM_KE_1483 在 pH 7.5 下 kcat 18 s⁻¹、kcat/KM 14,600 M⁻¹s⁻¹,是此前已发表新骨架最好值的 70 倍,但仍比经实验迭代优化过的设计低一到两个数量级;pH 10 下 kcat 升到 29.9 s⁻¹、kcat/KM 44,940。丝氨酸酯酶(底物 4MU-Ac):八轮共 1,569 个设计,最好子集命中率 44%,最好的 GDM_SE_2937 达到 kcat/KM 360,000 M⁻¹s⁻¹,这一项超过了此前经实验反馈迭代优化的最好从头设计。卡宾转移(苯乙烯环丙烷化):91 个设计,77 个结合血红素,挑 48 个做手性分析,两个对映体各自最选择的四个设计都给出设计时指定的构型,最好的非对映体比大于 99:1、对映体过量 96%(S,S)和 79%(R,R);这一轮没有任何实验反馈。[S1]
最快的那个酯酶长得像天然酶。
360,000 M⁻¹s⁻¹ 这个数字需要一行限定。作者自己检查后发现,GDM_SE_2937 的骨架和活性位点摆位与蛋白质数据库里的天然丝氨酸酯酶相近。他们因此定义了「天然丝氨酸酯酶拓扑」(对 PDB 中任一注释为丝氨酸水解酶的结构 TM-score 大于 0.45,且三联体对齐后 RMSD 小于 5 Å):这类设计占全部新骨架丝氨酸酯酶的 16.4%,却占了按 kcat/KM 排名前七里的六个。排除这类拓扑后,最好的设计 GDM_SE_2754 的 kcat/KM 是 4,900 M⁻¹s⁻¹,约为此前新骨架最好值的 4 倍。值得注意的是,即使这些「像天然酶」的设计,与天然序列的同一性通常也低于 20%。DEHP 酯酶里排名最高的几个则都不属于这类拓扑。[S1]
让命中率上去的,是给主链而不是序列打分。
作者认为最重要的方法发现是「多序列重设计打分」(multi-resequence,MR):对同一条生成的主链,用 LigandMPNN 产生多条序列,要求每一条都通过同一套筛选指标。这相当于在问,这条主链本身是否稳健地把催化基团摆在了该在的位置,而不只是这一条序列碰巧摆对了。回溯地在 50% 召回处设阈值,Kemp 消除和丝氨酸酯酶的命中率分别提高 2.5 倍和 5.4 倍;前瞻性地用上去,Kemp 消除命中率 23%(比不用高 2 倍),丝氨酸酯酶最高到 44%(比不用高 30 倍)。再加上「多部分扩散」(对已有设计加少量噪声后重新去噪,得到骨架几乎不变的另一条序列),回溯地要求 10/10 同时通过,Kemp 和丝氨酸酯酶的命中率分别到 60% 和 80%。作者据此给出一个解释:此前那些靠反复重设计加筛选的迭代管线之所以有效,可能正是因为它们隐含地在做同一件事:挑出「可接受序列空间更大」的主链。[S1]
论文自己列的限制。
结论一节写得很直白:构造基序需要相当的专业判断,而基序对结果的影响不被现有筛选指标捕捉;为一个基序找到能过筛的设计往往要生成大量样本,可能贵到做不起;怎样挑最优主链、以及给定主链怎样挑最优序列,都远未解决。最要紧的一条是作者自己写的:从头设计的催化活性仍比天然酶、以及被定向进化优化过的酶低几个数量级,而这「说明我们的模型并没有在有意义的程度上建模催化的物理」。数据方面,全部设计序列、预测结构和元数据要等论文正式发表才公开,所以在那之前没有人能独立复现这些结果。[S1]
05我从中学到什么
- 可迁移的洞见
- 优势不是更快,是可以指定:选择性和工作条件能写进基序,筛天然库只能碰上什么算什么。
- 设计启发
- 给主链打分,不只给序列打分:要求同一主链的多条重设计序列都过筛,丝氨酸酯酶命中率提高 30 倍。
- 阅读启发
- 看到「从头设计胜过天然酶」,先问比的是什么:速率、选择性还是条件,以及对照是谁做的。
- 接下来看
- 序列公开后独立实验室的复现,以及定向进化能不能把这些酶的速率追上来。
「造出来才算懂」在这里是可操作的
作者反复用的一个方法是把机理假设写成可筛选的几何指标,再看它能不能预测实际活性。比如 Kemp 消除里,催化碱对过渡态类似物 6-硝基苯并三唑 N3 原子的预测距离,回溯地在 50% 召回处筛,命中率提高 2.7 倍;前瞻性地用在下一轮,命中率提高 3 倍、最好的 kobs 从 0.49 s⁻¹ 升到 1.38 s⁻¹。这不只是提高产量:它把一个生化假设变成了可以证伪的东西。对任何做「AI 加实验」闭环的人,这是比具体数字更可迁移的东西:筛选器本身就是假设,它的提升幅度就是假设的检验结果。
两个诺奖路线在同一张作者表上
值得记一笔的是这张作者表本身:定向进化(Arnold,2018 年诺贝尔化学奖)和结构预测(Hassabis,2024 年)在同一篇论文上。这不是修辞,论文的论点正是两条路线的分工:从头设计提供天然序列库里没有的起点,定向进化把速率做上去。作者在正文里把设计出的哌啶合成酶称为「比天然序列更好的工程起点」,而不是成品催化剂。这个分工如果成立,对 AI4S 的意义是:生成模型要赢的那一局,可能不是把人类专家替换掉,而是把实验循环的入口换掉。
开放的是代码,不是设计
AP Novo 的代码以 Apache 2.0 发布,生成器权重可以下载,但按单独条款只许非商业组织作非商业用途,这和 AlphaFold 3 的做法一致,和「开源」不是一回事。更关键的是,论文里 3,537 个新骨架设计的序列和结构,要等正式发表才公开。所以今天一个外部实验室可以跑这套管线做自己的设计,却不能拿这篇论文里的具体酶去验证它的结论。这正是本站评级停在第 4 级、独立性记为「内部」的原因:实验是真做了,但做实验的和写论文的是同一批人。
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。
- S1Designing enzymes for new-to-nature chemistry and non-natural substrates with AlphaProtein NovobioRxiv 10.64898/2026.10.01.756017 · Wu, Abramson, Frerix et al. · Google DeepMind, Caltech · 2026.10.05 · 预印本,未同行评审 · 保留所有权利
- S2google-deepmind/alphaprotein-novoGitHub · Google DeepMind · 2026.10.07 · 代码 Apache 2.0;权重另有条款,仅限非商业使用,2026-10-07 读取