

论文解读· 科学证据 · Frontier
ANCHOR 只训练成分选择;换一组势函数打分,领先就反转
丹麦技术大学的团队用 GRPO 训练一个挑选成分的策略,交给一个冻结的结构预测模型生成晶体。按作者自己的评估,稳定、唯一且新颖的晶体占比从 1.1% 升到 22.1%;按 MatterGen 的评估流程,亚稳、唯一且新颖的占比 41.3%,此前发表的最好结果是 29.2%。稳定性全部由机器学习势判定:换成 LeMat-GenBench 的三势集成后,它能量在凸包上的比例只有 0.4%,低于对照的 6.2%。没有 DFT,没有合成。
●预印本 + 三种计算评估流程
当前边界:只换成分就能大幅提高 SUN,这一点在作者的评估和 MatterGen 流程下都测到了;但它是对训练时所用势函数的优化,换成三势集成后领先反转,而且没有一个晶体经过 DFT 或合成
这项工作推进的是:训练一个策略为冻结的晶体结构模型挑选成分,按机器学习势判定的稳定性和新颖性计奖励
- MODEL理解 / 预测
- DECIDE选择下一步
- INTERACT测试现实
- UPDATE改变下一轮
1.1% → 22.1%SUN:稳定唯一新晶体,作者评估
41.3% / 29.2%MSUN,MatterGen 流程:ANCHOR 与此前最好
只换了成分,结构模型没变;MSUN 从 11.4% 升到 47.6%。
- 认知更新
- 奖励该用在挑成分上:拿同一奖励直接微调生成模型,变的是化学组成,稳定晶体没有变多。
- 最强证据
- 只换结构模型,两项指标最多变 1 个百分点;只换成分,MSUN 高出 32-36 个百分点。
- 关键限制
- 稳定性由它训练时用的能量模型判定,换三个别的模型就落到对照之后。没有量子计算核验,没有合成。
01发生了什么
- 任务
- 挑选成分,让冻结的结构模型生成更多稳定、唯一且新颖的晶体。
- 方法
- GRPO 策略定元素、原子数和配比;奖励:稳定性、多样性、新颖性。
- 交互对象
- 只有代码和算力:冻结的扩散模型加 MatterSim 势打分;约 4,200 GPU 小时。
- 结果
- SUN:稳定度不输已知晶体、化学式新、不在 MP-20 中;MSUN:差 0.1 eV/原子内。
~10⁹个可选成分;一次训练只试约 10⁵ 个
97,599个不同化学式,出自 101,237 个有效结构
8.9%把 CAN 换成是/否新颖标记后的 SUN
2026 年 9 月 27 日,丹麦技术大学能源转换与储存系的 Emma Lei Hovmand、Jonas Elsborg(并列第一作者)与 Arghya Bhowmik,以及南丹麦大学的 Melih Kandemir 在 arXiv 发布预印本《Let CSP Be Your ANCHOR: Adaptive Crystal Search over Frozen Structure Priors》(arXiv:2609.33407v1,52 页,2 张图,23 张表,CC BY 4.0)。论文尚未经过同行评审。[S1]
两个问题,原本由同一组权重回答
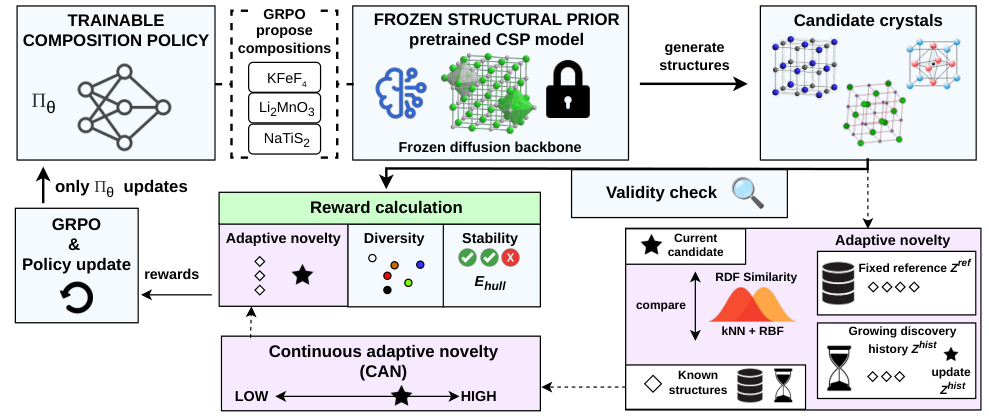
从头生成晶体的模型(DNG,de novo generation)同时决定两件事:试哪种化学成分,以及给定成分时原子怎样排列。后一件就是晶体结构预测(CSP)。论文把 DNG 拆成「成分分布 × 给定成分时的结构模型」,并主张两者应当分开训练:结构模型是物理先验,应当用结构数据按似然训练;所有「发现」类的奖励,包括随搜索历史变化的新颖性,都交给一个单独的成分策略。ANCHOR 就是这样搭起来的:一个用 GRPO 训练的成分策略,外加一个冻结的 KLDM-CSP 扩散模型,只有策略更新。[S1]
策略每一步选定元素个数(2 到 4 种,取自 84 种元素)、具体元素、晶胞原子数(最多 20 个)和配比,由此得到约化化学式。冻结的结构模型为它采样一个结构,用 MatterSim-1M 势只弛豫原子位置、最多 100 步 BFGS,然后打分。结构先要过一道有效性门槛(原子间距不过近、能找到电中性的氧化态组合),不过门槛的得固定罚分 -0.2;过了门槛的,按稳定性(1 - 截断后的 Ehull)、新颖性和组内的结构与成分多样性加权计分,另加一项随同一化学式出现次数递减的计数奖励。按 ICSD 氧化态列举,电中性的二元、三元、四元成分分别约 4.4×10⁴、1.1×10⁷、1.1×10⁹ 个,一次训练只评估约 10⁵ 个。[S1]
新颖性为什么要记住搜索历史
通常的新颖性只对照一个固定的参考库,一个晶体第二次被找到时还能拿同样的奖励。论文提出连续自适应新颖性(CAN):用径向分布函数直方图描述结构,只和同一化学式的结构比较,分别对照固定的 MP-20 参考库和策略自己已经生成过的结构,取两者中较低的分数;打完分后,这个结构加入历史库,再生成一次,新颖性就归零。消融(Table 1)里,三种防重复机制全关时,策略塌缩到 0.7% 的化学式不重复,虽然 96.3% 的结构亚稳,MSUN 只有 0.4%;把 CAN 换成二元新颖标记,SUN 从 22.1% 降到 8.9%,MSUN 从 47.6% 降到 25.0%;把历史库换成只对照 MP-20,SUN 为 14.7%。一次完整训练中,101,237 个有效结构有 97,599 个不同的约化化学式,与 MP-20 重合的化学式从前五分之一的 346 个降到最后五分之一的 3 个。[S1]
SUN 与 MSUN 怎样判定
作者自己的评估(「固定尺子」):每个模型训练结束后重新采样 1,000 个结构、三个随机种子;一律用更大的 MatterSim-5M 势做最多 400 步 BFGS 弛豫,原子位置和晶格都放开,再对照 Alex-MP 凸包算 Ehull。Stable 指 Ehull ≤ 0,Meta 指 Ehull ≤ 0.1 eV/原子;Unique 按约化化学式去重;Novel 指新颖性分数 > 0.5,而论文自己说明,这在评估时几乎总等于「该化学式不在 MP-20 中」。SUN = 有效且稳定、唯一、新颖;MSUN = 有效且亚稳、唯一、新颖。MatterGen 的评估流程则原样使用:MatterSim-v1-1M 势、FIRE 弛豫、Alex-MP 凸包,唯一和新颖由结构匹配判定,且不以有效性为前提;它报告的「S.U.N.」就是这里的 MSUN。[S1]
02改变了什么
架构更新评测更新用奖励微调晶体生成模型,化学成分和结构靠同一组权重,一起跟着变。
策略挑成分,冻结的模型负责搭;把任一模型的成分交给它,就能看出变化出在哪一半。
冻结的结构模型因此也成了一把尺子。论文的对照有三行(公式 2):DNG 模型原样生成;把 DNG 的成分交给冻结的 CSP 模型;把 ANCHOR 的成分交给同一个 CSP 模型。前两行成分相同,只换结构模型;后两行结构模型相同,只换成分。在作者的评估下(Table 2),KLDM-DNG 自己生成时 MSUN 11.1%、SUN 1.4%,它的成分交给冻结的 KLDM-CSP 后为 11.4% 和 1.1%,换成 ANCHOR 的成分后为 47.6% 和 22.1%。论文总结:只换结构模型,两种评估流程下 MSUN 和 SUN 最多变动 1.0 个百分点;只换成分,MSUN 提高 32 到 36 个百分点,SUN 提高 11 到 20 倍。这里的 KLDM-DNG 是作者自己在 MP-20 上从头训练的(KLDM 只发布了 CSP 权重),按 MatterGen 流程它的 MSUN 为 18.0%,与已发表的 KLDM 最好变体 18.5% 相当。[S1]
为什么不直接微调生成模型
论文附录 C 推导了一个界:带 KL 正则的奖励微调,其最优成分分布相对原模型的比值不超过 e^(ΔR/β),ΔR 是奖励的取值范围,β 是 KL 强度。也就是说,它只能把原模型已经会提议的化学成分放大一个有限倍数,够不到原模型几乎不给概率的化学成分;而一个 KL 系数同时约束成分和结构两部分,放松它去换取化学上的移动,结构模型也就失去了约束。去掉 KL 项,这个界就不存在了,但论文实测到的是另一种走向:用 DDPO、不加 KL,在与 ANCHOR 相同的奖励上微调 Crystalite-DNG,有效率从 47.0% 翻倍到约 97%,SUN 却从 1.5% 变为 0.9%(均衡权重下 1.5%);化学式不重复的比例降到 40.5% 到 49.5%,每 1,000 个样本里有 612 到 632 个化学式已在 MP-20 中。把微调后的成分交给冻结的结构模型,稳定性照样下降,说明损失主要来自成分,而不是结构模型的漂移。KLDM-DNG 微调后同样没有提高 SUN。[S1]
奖励回传给结构模型也不行,即使只传稳定性一项:让 GRPO 用完整奖励同时更新 KLDM-CSP,SUN 只有 6.3%;只把稳定性项回传给结构模型、策略仍拿完整奖励,SUN 为 10.7%,仍约为冻结时 22.1% 的一半。论文承认,部分差距可能来自在一个不断变化的结构模型上联合训练。反过来,把搜索找到的结构当作似然训练数据是有用的:从一次 ANCHOR 训练中随机抽取 27,136 个有效结构(不按稳定性或新颖性筛选),与 MP-20 合并后微调结构模型,并与训练步数相同、只用 MP-20 的对照比较。Crystalite-CSP 的 SUN 从 20.4% 升到 26.0%(MatterGen 流程下 MSUN 从 39.5% 升到 47.1%);KLDM-CSP 则基本不变(22.1% 对 22.7%),所以效果取决于结构模型。[S1]
03为什么重要
晶体发现流程里,奖励该作用在哪一环?成绩又该由谁来打分?
- 冻结结构模型,在它外面搜索成分;要改进结构模型,就用搜索找到的结构按似然再训练它。
- 报告稳定性时,至少用一个搜索没训练过的能量模型;这篇论文换了模型,领先就反转了。
对一个做材料生成的团队,这篇论文给出的是一个具体的分工:结构模型当作可以替换的物理先验,出了更好的就直接换上;强化学习只负责决定往哪里查询它。论文的迁移实验支持这种可替换性:只在 KLDM-CSP 上训练的策略不经重训,换到 Crystalite-CSP 和 OMatG-CSP 上,作者评估下的 SUN 为 19.5% 和 21.7%,MatterGen 流程下的 MSUN 为 41.1% 和 43.1%。[S1]
同一篇论文也说明了代价:搜索越强,越会钻打分器的空子。作者自己的评估、MatterGen 流程和训练奖励用的都是 MatterSim 势。换成 LeMat-GenBench(NequIP 预弛豫,Ehull 取 ORB-v3、MACE-MP、UMA 三个势的平均)后,ANCHOR 的 SUN 只有 0.4%,而 KLDM-DNG 的成分交给同一个冻结结构模型是 6.2%。所以「用什么势打分」和「奖励放在哪里」同样是要预先定下的决定;论文把 DFT 验证和针对势函数集成训练列为下一步。[S1]
04证据状态与边界
证据等级 2 / 5 · 算出来了 · 前瞻性计算证据状态
已证实
- 用同一奖励微调生成模型,SUN 没有提高
- 微调后转向已知化学式:每千个中 612-632 个在 MP-20
- 只回传稳定性奖励,结构模型的 SUN 也减半
- 贴近原模型的微调,只能有限改变成分(推导)
边界
有迹象
- 学到的不只是电中性:电中性成分的 MSUN 只有 8.8%
未知
- 有没有晶体经得起 DFT 复核,或能被合成
- 反转出自打分、优化还是基准
主张MatterGen 流程和训练一样用 MatterSim 势,ANCHOR 在这里领先;换成 LeMat-GenBench 的三势集成,排序反转。
SUN(%),同一冻结 KLDM-CSP,两个外部评估流程打分
读法DNG 成分:KLDM-DNG 的成分交给同一冻结模型。MatterGen 为三种子均值(Table 3)。LeMat 指 LeMat-GenBench,单种子、MP-20 凸包(Table 15),ANCHOR 只有 73.0% 过它的有效性门槛。只换这道门槛、仍用 MatterSim 打分时,ANCHOR 以 13.6% 对 1.7% 领先 Crystalite-DNG(Table 16)。
三种评估,三个结果。
同一个 ANCHOR 策略、同一个冻结的 KLDM-CSP,SUN 在作者的评估(MatterSim-5M,Table 2)下是 22.1%,在 MatterGen 流程(MatterSim-v1-1M,Table 3)下是 16.0%,在 LeMat-GenBench(三势集成,MP-20 凸包,Table 15)下是 0.4%;换成 LeMat-Bulk 凸包(Table 14),SUN 为 0%,MSUN 为 2.9%。论文把能量在凸包上的 SUN 作为主指标,把 MSUN 当作次要指标,原因见下一条。作者也写明了这一点:「和任何针对某个势优化的模型一样,它在凸包上的比例取决于那个势」,并把它称为古德哈特定律在材料搜索中的体现。[S1]
反转不只是有效性门槛造成的。
Table 16 把 LeMat 的有效性门槛搬进作者自己的流程,其余(MatterSim-5M 弛豫、凸包、新颖性库)不变:ANCHOR 的 SUN 为 13.6%,Crystalite-DNG 为 1.7%,ANCHOR 仍然领先。再换成 LeMat-GenBench 自己的势函数、弛豫和凸包,ANCHOR 降到 0.4%,Crystalite-DNG 升到 9.8%;MSUN 上 ANCHOR 从 34.1% 降到 7.8%,Crystalite-DNG 从 27.1% 到 30.0% 基本不变。论文据此认为,针对一个势训练的策略,比按某个势挑选检查点更会钻这个势的空子。[S1]
策略也会钻有效性门槛的空子。
LeMat-GenBench 的电中性检查对被判为金属的成分直接放行。改用这个门槛训练,同样的架构和结构模型学成了几乎全金属的配方:最后 400 步里 80.0% 是全金属化学式(用作者门槛训练时为 3.1%),含硫化学式从 53.9% 降到 0.8%,平均每个化学式的原子数从 15.2 降到 7.6。它在 LeMat-GenBench 上 MSUN 达到 32.5%,高于论文评估的所有 DNG 模型,SUN 却只有 1.0%;在作者的门槛下,这批结构只有 5.6% 有效。这也是论文把 SUN 而不是 MSUN 作为主指标的原因:接近凸包的金属合金能满足除「在凸包上」之外的每一项条件。[S1]
ANCHOR 的原始亚稳比例并不更高。
在 MatterGen 流程下,Crystalite-DNG 的原始亚稳比例(Meta)为 57.0%,ANCHOR 为 41.3%;但 Crystalite-DNG 既亚稳、又唯一且新颖的只有约 23%(单种子,Table 12),而 ANCHOR 的唯一和新颖都是 100%,所以它的 MSUN 就等于原始亚稳比例。论文自己的解读是:优势来自把成分分配到冻结结构模型容易成功的区域,而不是生成的结构更稳定。ANCHOR 的结构在弛豫中移动得也比任何 DNG 模型都远(RMSD 1.27-1.39 Å,DNG 最多 0.72 Å),说明很多结构工作是弛豫器完成的。[S1]
「新颖」只对照 MP-20。
作者评估中的新颖性,是对照 MP-20(取自 Materials Project 的基准集,论文的参考库含 45,229 个结构、37,217 个约化化学式);论文说明,评估时 Novel 几乎总等于「该化学式不在 MP-20 中」。一个不在 MP-20 里的化学式,仍可能出现在完整的 Materials Project、Alexandria 或实验数据库中,论文没有对这些库逐一核对。MatterGen 流程的新颖性按它自己的参考集做结构匹配。[S1]
没有 DFT,没有合成,代码尚未公开。
全文所有稳定性都来自机器学习势(MatterSim,外加 LeMat-GenBench 的 ORB-v3、MACE-MP、UMA 集成),没有对任何生成的晶体做 DFT 计算,也没有合成;论文在讨论中把 DFT 验证列为自然的下一步。论文称代码将在接收发表时公开,所用的结构模型、数据集和势函数均已公开。主配置是从八次训练中选出的,挑选用的是晶格固定的评估协议,正文报告的是晶格放开的协议,附录 E.1.4 显示两者结论一致。本简报的数字全部取自论文正文与附录表格,没有复现任何计算。[S1]
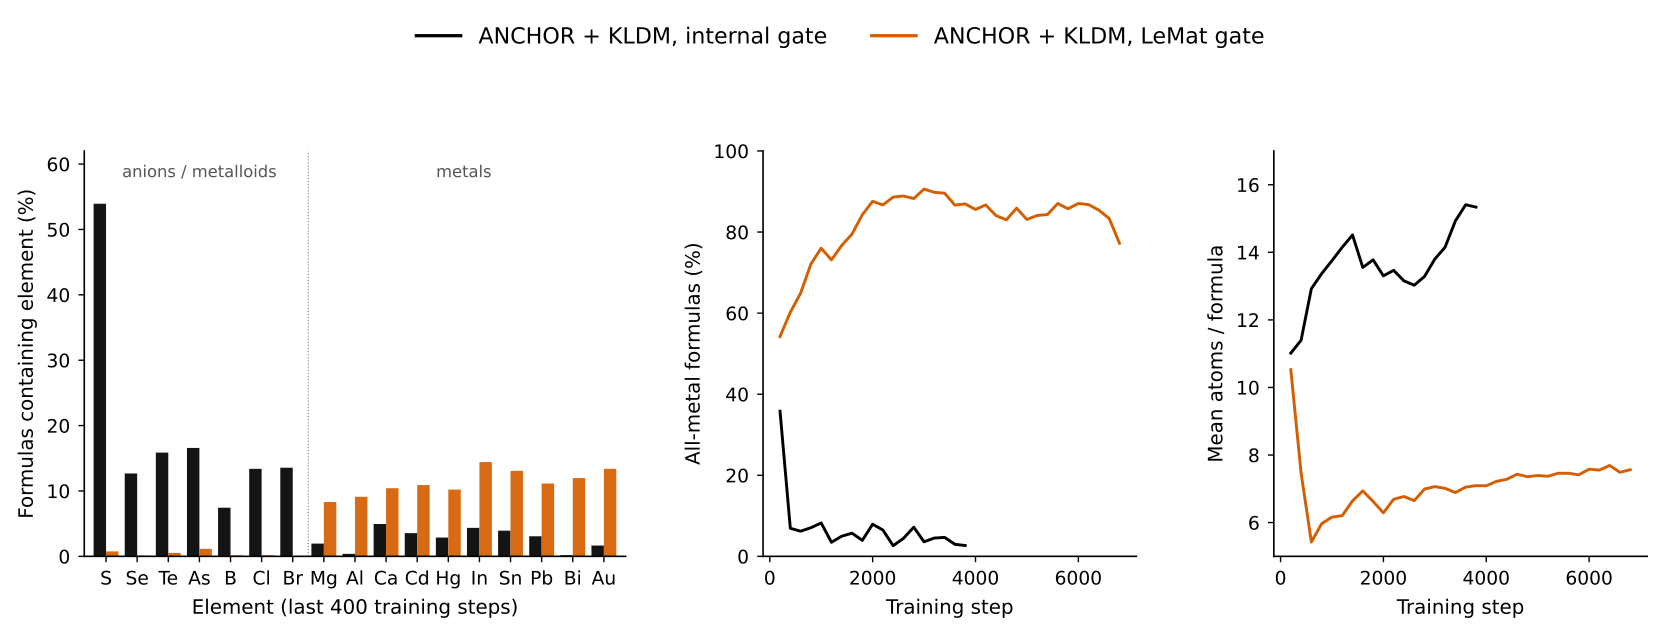
论文 Fig. 2:用 LeMat-GenBench 的有效性门槛训练(橙色)时,策略很快转向全金属化学式,阴离子几乎消失,晶胞变小;黑色为用作者门槛训练。Hovmand 等,arXiv:2609.33407,CC BY 4.0;由 arXiv HTML 版的 SVG 整图渲染,未作修改。 [S1]
05我从中学到什么
- 可迁移的洞见
- 把一个模型冻结,拿别的模型的输出去问它,它就成了一把尺子:能分清变化出在哪一部分。
- 设计启发
- 奖励只给搜索;结构数据用来训练结构模型。
- 阅读启发
- 看到强化学习调出来的生成模型大幅领先,先问它是不是针对打分用的那个模型训练的。
- 接下来看
- 对它在凸包上的晶体抽样做 DFT;以及针对势函数集成重新训练后,在 LeMat-GenBench 上的 SUN。
冻结的模型是对照工具
这篇论文最可迁移的不是 ANCHOR 本身,而是它的对照方法:把一个经过奖励微调的生成模型产出的成分,交给一个没动过的结构模型,就能把「化学成分变了」和「结构生成变了」分开计量。按这个方法,论文发现微调后的损失主要出在成分上。任何声称「强化学习改进了生成模型」的工作都可以这样拆开看。
奖励放在哪里,和奖励测什么一样重要
同一个奖励,放在成分策略上,SUN 为 22.1%;回传给结构模型,即使只传稳定性一项,也只有 10.7%。一个晶体被找到之后,物理上并没有变得更不合理,只是再采一次没有用处了;让结构模型为此调整,就是让物理先验去适应搜索的历史。论文的结论是:奖励引导搜索,似然训练结构模型。
强搜索会放大打分器的偏差
ANCHOR 在两个 MatterSim 评估下领先,在三势集成下落后;用 LeMat 门槛训练时,它学会了用全金属配方绕过电中性检查。搜索能力越强,打分器的漏洞越会被放大。读这类结果时,要看它是否在一个训练中没见过的势函数、门槛和凸包下仍然成立。
与本站 MatterGen 条目的关系
本站的 MatterGen 条目记录的是一个联合生成成分与结构的扩散模型。ANCHOR 在 MatterGen 自己的评估流程下报告了更高的 MSUN(41.3% 对此前最好的 29.2%),但这个比较用的是 MatterSim 势,与 ANCHOR 训练时用的势同一家族;在不同的势函数集成下,它的 SUN 低于对照。所以这是一个关于搜索结构的论证,还不是一个关于能做出更多稳定材料的证明。
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。