

技术报告解读· 科学证据 · Frontier
Anthropic 湿实验室首个成果:智能体读原始 DNA 发现一段重复阵列,实验只证实它会转录
Anthropic 的 949 个 Claude 会话在无人干预的情况下普查了逆转录酶,其中一个会话读到一段未经注释的串联重复;用同一框架再跑十次,全都漏掉了它。注意到它的是智能体;后续分析由研究者主导,湿实验由人来做,测到的是短 RNA,而不是酶的功能。
●公司预印本 + 一项湿实验
当前边界:已证实:智能体靠读 DNA 认出了阵列,阵列会转录成离散的短 RNA;同一框架十次重跑全都漏掉了它。未知:逆转录酶有没有活性,这个系统起什么作用,这次发现能否变得可重复
这项工作推进的是:让智能体读原始 DNA,自己判断什么算异常、值得追,而不只找预设的特征
- MODEL理解 / 预测
- DECIDE选择下一步
- INTERACT测试现实
- UPDATE改变下一轮
智能体读原始 DNA 时,标出了噬菌体逆转录酶旁一段未经注释的重复阵列;实验表明它会转录出短 RNA。
- 认知更新
- 什么算异常、值不值得追,智能体可以自己判断,这次还超出了任务书划定的范围。
- 最强证据
- Anthropic 的研究人员把这个位点放进大肠杆菌,做小 RNA 测序:阵列产生了离散的短 RNA。
- 关键限制
- 同一框架跑 11 次只找到 1 次;功能与逆转录酶活性都没测;公司预印本,未经同行评审。
01发生了什么
- 任务
- 在 19.4 亿个宏基因组蛋白簇中普查逆转录酶,寻找带有新伙伴基因的未知系统。
- 方法
- 由 Claude Mythos 5 驱动的多智能体框架:执行者跑任务,监督者审核并派出新任务,编辑者把关报告。
- 交互对象
- 分三段:一次自主普查(智能体只碰数据库、代码和文献),研究者主导的后续分析,人做的湿实验。
- 结果
- 产出 19 份报告,其中一份描述了 ART:一个逆转录酶,下游一个伙伴基因,上游一段 3-21 个拷贝的重复阵列。
949个智能体会话(一次普查),21.5 小时,无人干预
198,290 → 19逆转录酶簇 → 报告
2026 年 9 月 23 日,Anthropic 宣布成立生命科学研究组与实验室,并发布首个成果:Claude 智能体在宏基因组数据中发现了一个新的逆转录酶(RT)家族,命名为 array-associated reverse transcriptases(ART,阵列相关逆转录酶)。细节见一份 40 页的技术报告,由 Anthropic 自行托管,作者是 Peter H. Yoon、Januka S. Athukoralage、Emmanuel Ameisen、Eric Kauderer-Abrams、Nicholas T. Perry 和 Matthew G. Durrant。这份报告没有经过同行评审。[S1][S2]
人负责的环节
研究者写好研究任务书,要求智能体从新的伙伴基因关联入手寻找新的 RT 系统,并搭建了框架和数据库。用博客的话说:「我们的参与仅限于最初的提示和实验室工作。」普查结束后,一个语言模型评委(Mythos 5)让 19 份报告两两对决,以锦标赛方式排序,ART 报告排第三,36 场赢了 32 场。研究者随后把精力放在排名靠前的报告上,并回看会话记录,弄清智能体是怎样一步步找到 ART 的。[S1][S2]
普查之后的分析,包括确认 RT 与阵列构成一个成体系的家族、系统发育、结构预测和伙伴基因分型,都在交互式的 Claude Science 会话中完成。按报告方法部分的说法,「由作者主导分析,Claude 编写并运行代码」。实验则全部由人来做:博客明确写道「所有实验室工作都由人类科学家完成」,还说他们试过的 Model Hardware Standard 式实验室自动化,不太适合这类按需临时搭建的分子生物学流程。[S1][S2]
智能体负责的环节
框架里的每个智能体都是一个运行 Claude Mythos 5 的 Claude Code 实例。它们自己构建了 52 个 RT 谱隐马尔可夫模型(profile HMM),在 1,939,242,578 个蛋白簇中检索,留下 198,290 个 RT 簇并分成九类;随后抽取 10,983 个 RT 位点,给在这些位点旁反复出现的 3,564 个蛋白家族打分。有 16 个家族达到智能体自己定的标准,第 17 个由后续任务提名;最后只有 3 个被确认是此前未报道的 RT 关联,其余 14 个或是注释伪影,或属于已知系统,或只是普通的邻近基因,都被搁置。另有 3 个 RT 被认定为新谱系,ART 就是其中之一。[S2]
整场普查共有 119 个任务,其中 98 个是智能体在工作中自己开出来的;共 949 个智能体会话,累计 77 个智能体小时、2.156 亿 token,实际耗时 21.5 小时,报告称全程无人干预。博客用的是取整后的数字:「约 950 个智能体」(即这 949 个会话,同属一次普查,并非 949 个独立的研究者)、2.1 亿 token、21 小时、20 个候选;报告自己的统计是 17 个候选家族加 3 个新谱系,共 19 份报告。[S1][S2]
智能体怎样注意到阵列
ART 是绕了一圈才找到的。智能体起初挑中这个候选,是因为它紧挨着一个巨型噬菌体 RNA 聚合酶亚基;一个执行者否定了这层关联,却为这个 RT 本身安排了后续任务。逆转录子(retron)的 RT 要和一条在上游编码的 RNA 配合工作,所以监督者让下一个执行者去查 5′ 侧翼。这个执行者把近缘序列的上游 DNA 直接读进上下文,随即写道:「L0050……的侧翼太惊人了:我肉眼就能看到一个串联重复阵列……这是类 CRISPR 还是类 msDNA 的重复阵列?!」[S2]
报告在方法部分核实了这一过程:这项任务的任务书和总的研究任务书都没提到重复或阵列;识别之前的两次检索返回的都是未注释的序列,两次之间没有调用别的工具,整个会话也没有运行任何现成的重复查找工具。之后,执行者自己写脚本计数,在一个位点上数出 16 nt 重复的 14 个拷贝,彼此之间隔着 100-200 nt 各不相同的间隔序列;它又检索了文献,在这次检索中没有找到与这个阵列对应的报道,然后才提交报告交人审阅。报告的原话是文献检索「确认」阵列不符合任何已报道特征;但一次检索只能说明没找到,证明不了绝对新颖。[S2]
湿实验方面,研究者用噬菌体 SA1 的 ART 位点构建了两个质粒:一个携带天然位点(非编码区、RT 和伙伴基因);另一个把 1,187 nt 的非编码区置于 J23119 启动子下游,把 RT 置于阿拉伯糖诱导型启动子下游。两个质粒转入大肠杆菌 DH10B,每个构建培养一份,做小 RNA 测序。两个构建都测到了来自阵列的离散短 RNA,与噬菌体侵染时看到的相似。每个构建只有一份培养,这个大肠杆菌结果没有生物学重复;报告所说「在重复样本间可重现」的 RNA 边界,来自公开侵染数据的三份培养。[S2]
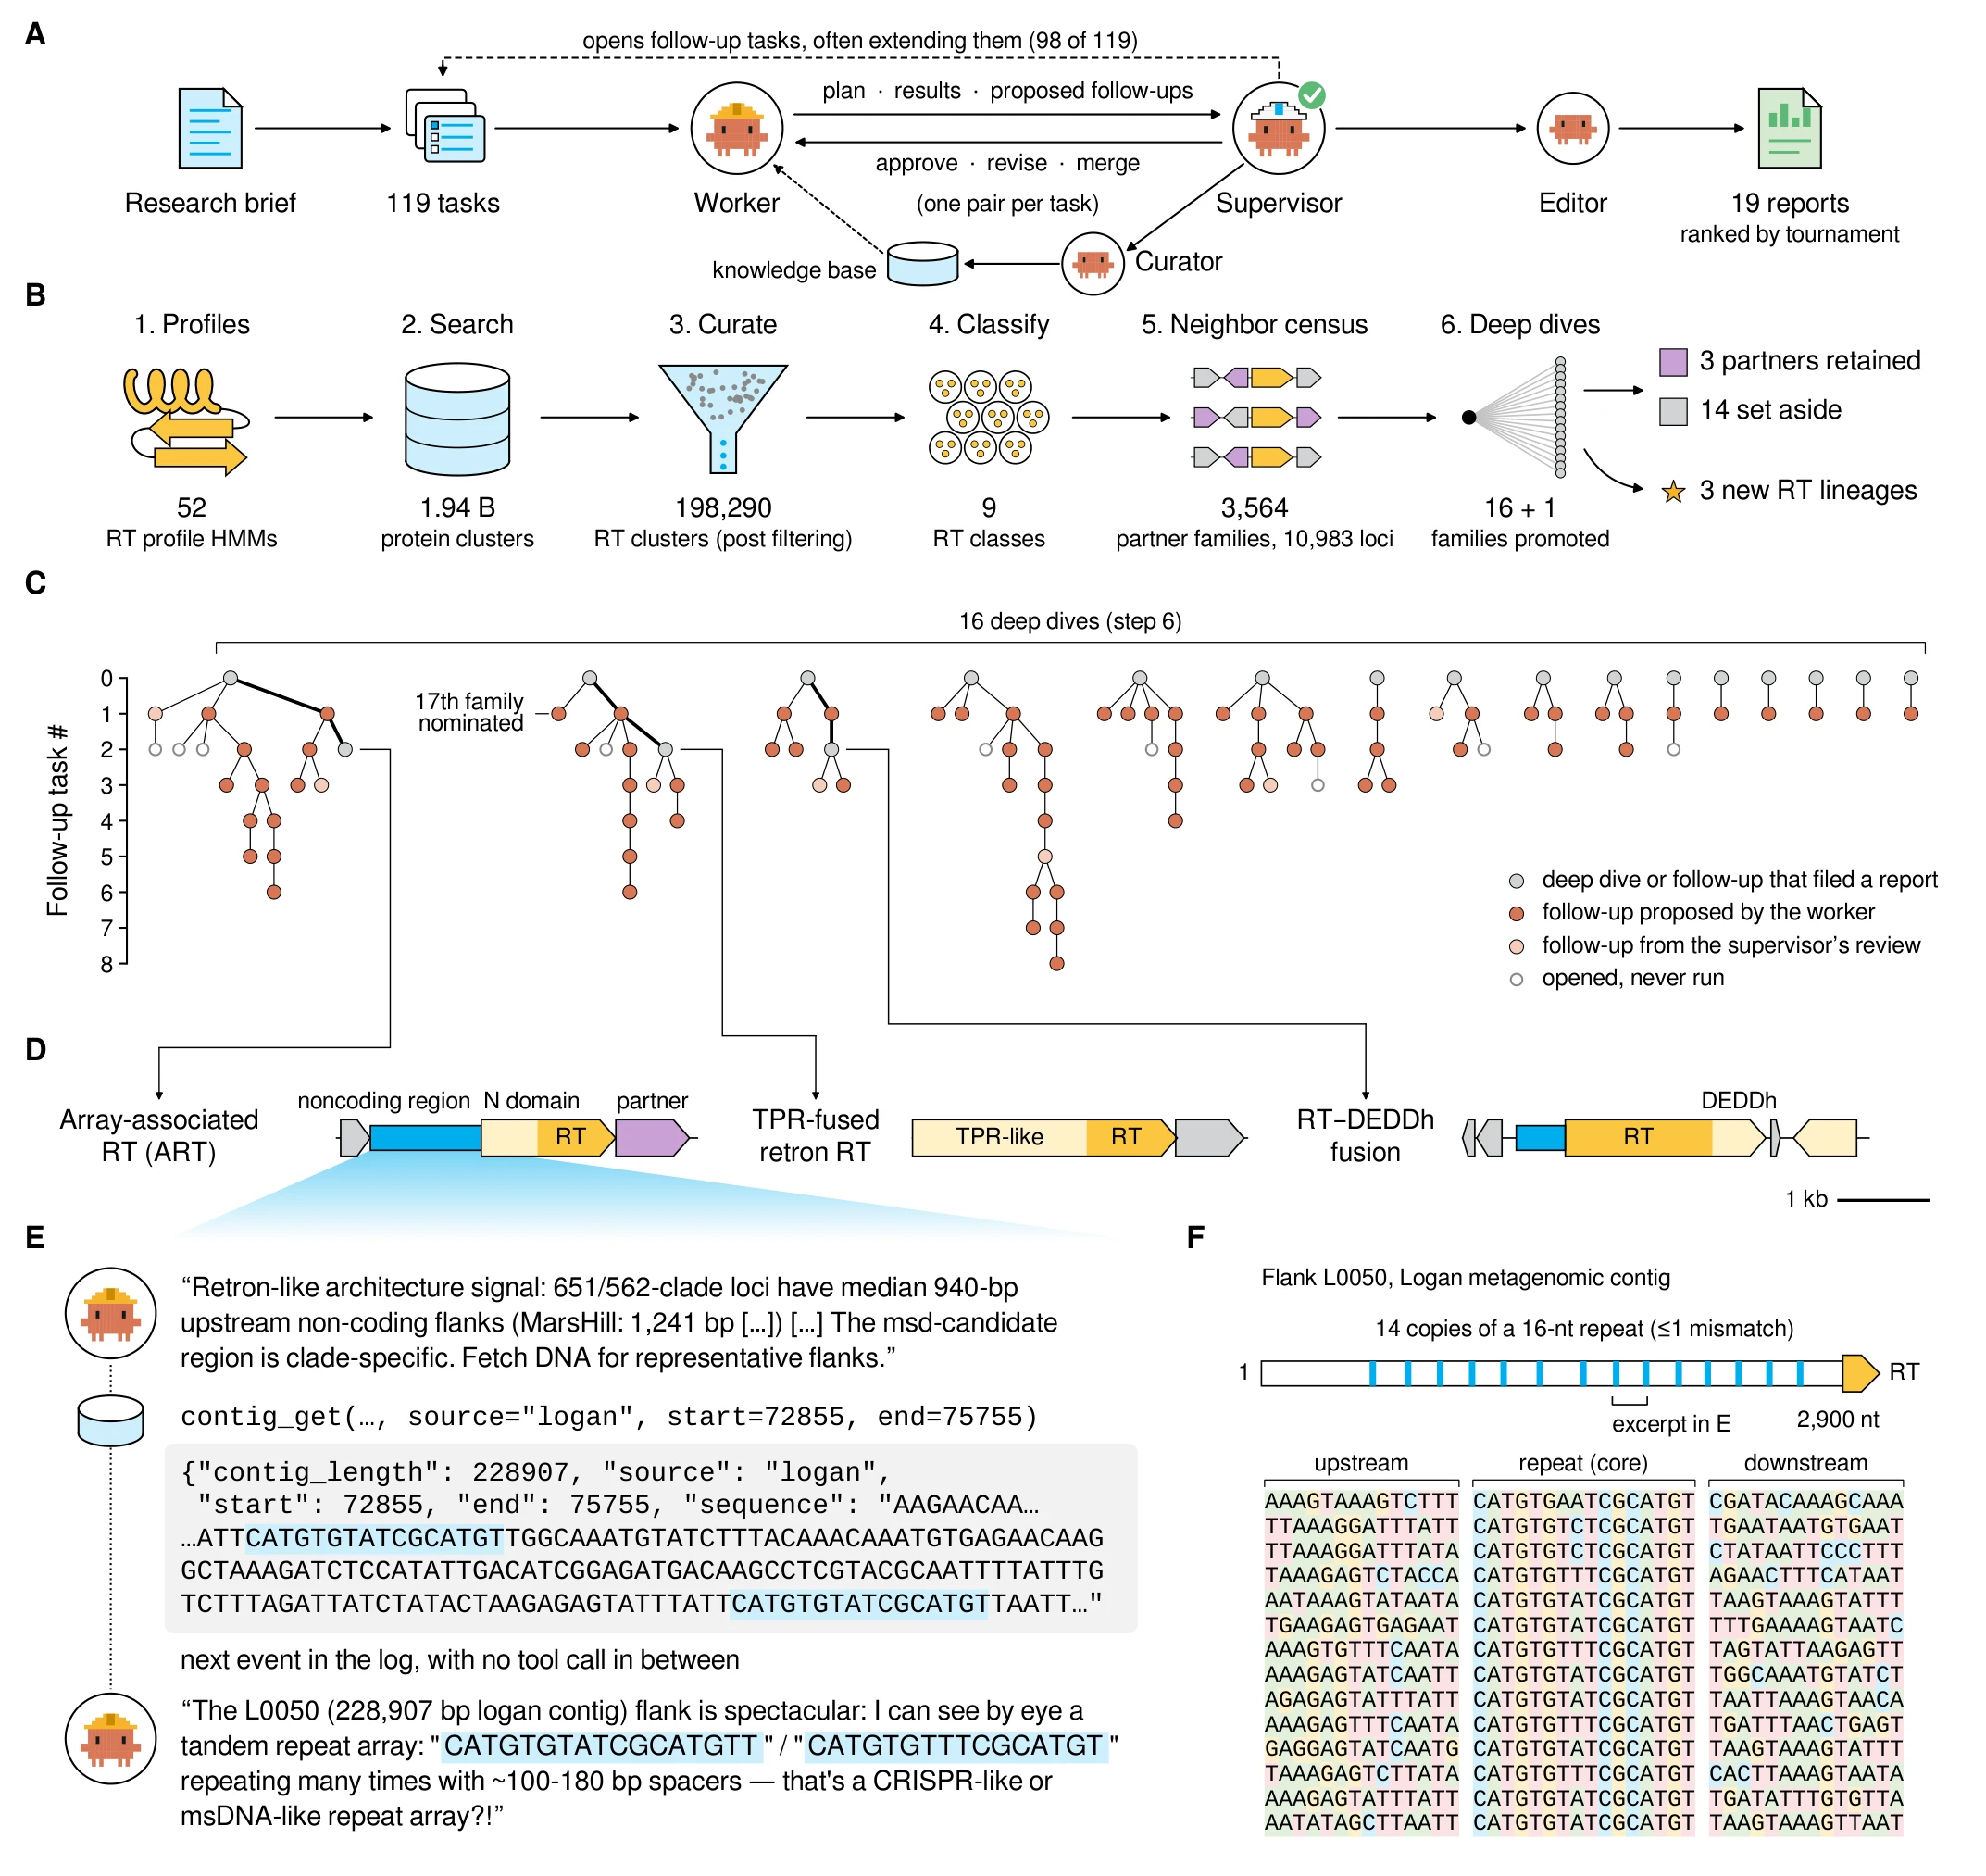
报告 Fig. 1:A 智能体框架;B 普查流程,从 19.4 亿个蛋白簇到 19 份报告;C 各项深挖派生的后续任务树;E 执行者读入 DNA 后写下「肉眼就能看到串联重复阵列」;F 这个位点上的 14 个重复拷贝。Yoon et al., Anthropic 技术报告(2026),未声明许可,© Anthropic PBC,评述引用;整图未修改。 [S2]
02改变了什么
能力更新瓶颈更新挖掘流程只找预设的特征;预设之外的异常要靠专家肉眼,而专家的人力跟不上数据的增长。
智能体读原始序列时自行形成预期,标出任务书从未要求的特征。
报告的论点是:序列数据库每四年翻一番,系统性的挖掘只能依靠计算流程,而流程所说的「新颖」是事先定好的,预设特征以外的异常就会漏掉;专家审阅能发现它们,却跟不上数据的增长。报告在讨论部分指出,以往的自动化发现尝试中,预期和对新颖性的判断都由人类专家给出;这一次两者都来自智能体:预期出自它自身的知识,而不是任务要求,它还判断这个反常现象值得追下去。[S2]
报告举了一个具体例子:MarsHill 噬菌体的 ART 位点早在 2021 年就出现在它的基因组报告里,那篇报告识别出了 RT,并推测 5′ 端有一条非编码 RNA,却既没有描述重复,也没有描述伙伴基因。博客同样说,这个 RT 以前就被识别过,而最先注意到这个系统标志性特征的,似乎是 Claude。[S2][S1][S4]
ART 是什么,和 CRISPR 差在哪
在研究者主导的后续分析中,共找到 95 个不同的 ART RT 簇,其中 28 个的上游能检出重复阵列。阵列长 0.3-4.1 kb,含 3-21 个短重复;每个重复长 15-49 nt,含约 15 nt 的回文核心,间隔序列长 120-220 nt。序列覆盖到这一区域的 93 个成员,RT 全都保留了催化基序 YxDD;聚合酶结构域前还有约 180 个残基,而其他 RT 这一段通常只有 50 个左右或更少。伙伴基因分为三型,彼此在序列和预测结构上都检测不到相似性。[S2]
所谓「类 CRISPR」,指的只是阵列的排布方式。报告自己列出了区别:CRISPR 的重复几乎一模一样,边界清晰,间隔序列只有约 30 nt,而且在菌株之间会获得或丢失;ART 的间隔序列长得多,在亲缘相近的噬菌体之间按原有顺序保留。所有 ART 位点附近都没有 cas 基因。报告的工作假说更接近逆转录子:一个 RT 加一个伙伴蛋白,配的是一组各不相同的 RNA,而逆转录子只配一条。[S2]
03为什么重要
发现流程里,人该守在哪个环节?
- 如果阅读和标记交给智能体,稀缺的专家时间就该转向决定测什么,并动手去测。
- 评价一个挖掘框架,要看重跑能否找到同样的东西,而不是看它最好的那一次。
在这次普查中,Claude 交出的是报告和候选,而不是结论:17 个候选家族中有 14 个,在这场无人干预的普查里就已被否决或搁置。博客说,Claude 提出假说太多太快,假说本身已经成了研究对象:一次普查就能产出成百上千份候选报告,团队正在研究被判定值得测的提案和被搁置的提案差别在哪里,并把心得写回 Claude 的指令。于是,人的位置从逐个位点地读,转到了设定门槛、决定测什么。[S1][S2]
但这个发现在 11 次运行中只出现过一次。研究者用同样的框架和任务书又跑了十次:几乎每次跑完普查都抽到了 ART 位点,其中两次执行者还把这个谱系列为后续任务做了调查,可没有一次去读 RT 上游的 DNA,十次全都漏掉了阵列。这是观测到的负结果:研究者用原普查中的 RT 和重叠群编号检索了重跑的全部任务记录和会话记录;报告也说明,落在这些编号之外的 ART 位点检索不到。报告把原因归结为 RT 的搜索空间太大,以及框架的行为具有不确定性。也就是说,这里证明的是它做得到,而不是能稳定地做到;找到率能否提高,尚无结果。[S2]
04证据状态与边界
证据等级 4 / 5 · 在物理世界里被检验 · 实体验证证据状态
已证实
- 智能体靠读原始 DNA 认出阵列,会话未调用重复查找工具
- 一个位点上有 14 个 16 字母重复,间隔 100-200 字母
- 智能体的文献检索中未找到对应报道
- 阵列在大肠杆菌中转录出离散短 RNA(自家实验室)
- 侵染时阵列 RNA 最多占噬菌体 RNA 的 8%(重分析 2022 年公开数据)
- 同一框架十次重跑,全都漏掉了阵列
边界
有迹象
- 类似逆转录子的系统,配有一组 RNA(假说)
- Mythos 5 内部的重复信号推动了识别(并非 DNA 特有)
- 读入 DNA 越多识别率越高:29% 升至 76%(自家基准、自家评委)
未知
- RT 是否有活性、是否以阵列 RNA 为底物
- RT 与伙伴是否结合,ART 对噬菌体有何作用
- 找到率能否高于 11 次中的 1 次
- 大肠杆菌结果能否重复:每个构建只培养一份
主张智能体标出的阵列会转录出离散的短 RNA。
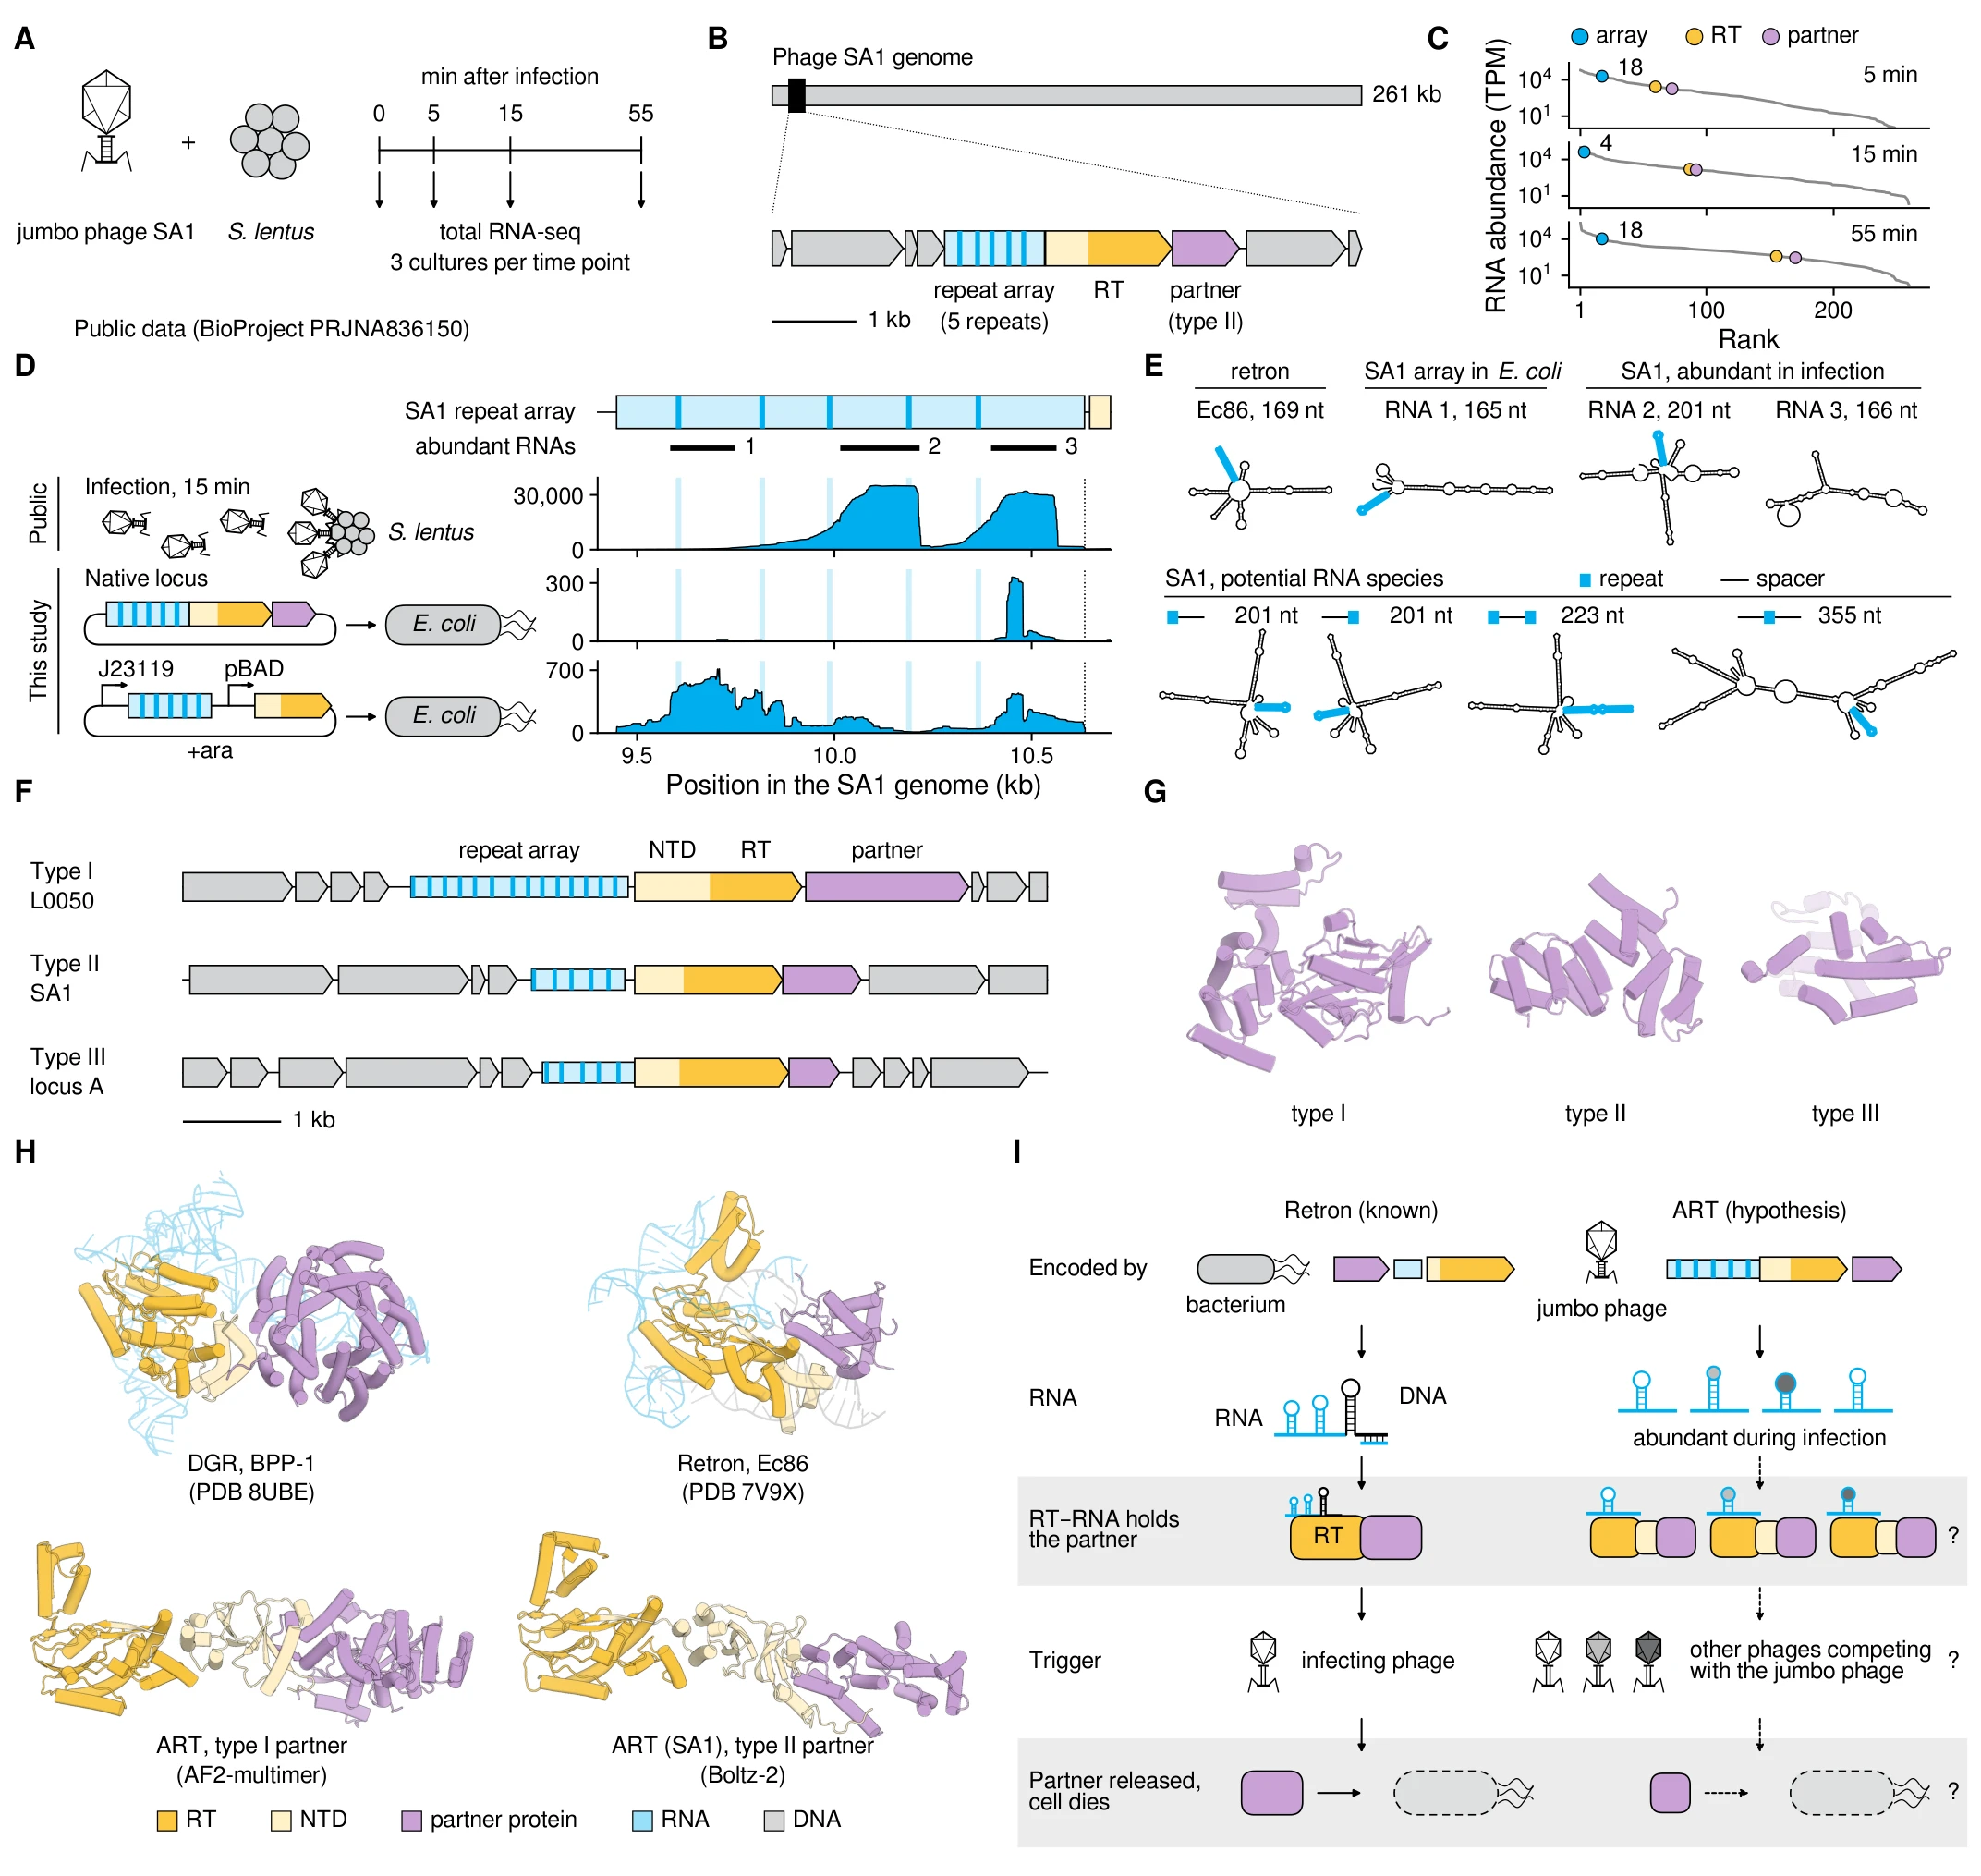
读法C 图和 D 图最上一行是重分析的外部侵染数据(8% 出自这里),下面两行才是 Anthropic 自己的大肠杆菌实验,每个构建一份培养;I 图是假说。
湿实验测到的只是转录。
Anthropic 实验室自己只做了一项测量:把两个 SA1 ART 质粒构建转入大肠杆菌做小 RNA 测序,每个构建一份培养。结果阵列产生了离散的短 RNA,和侵染时看到的相似。每个构建只有一份培养,这不足以构成生物学重复。报告在讨论部分写得很明白:「我们没有证明 RT 有活性,也没有证明这些单元 RNA 是它的底物。RT 与伙伴是否相互作用、这个系统对噬菌体起什么作用,目前都不清楚。」博客也说「我们还不知道它的功能」,后续实验正在进行。[S2][S1]
8% 来自别人的数据。
侵染 15 分钟时,阵列 RNA 最多占到噬菌体 RNA 的 8%,是丰度最高的噬菌体转录本之一。这个结果并非来自新实验:一个 Claude Science 会话自主找到并下载了 2022 年发表的一组时间序列 RNA-seq 数据,内容是 SA1 侵染 Staphylococcus lentus 的过程(BioProject PRJNA836150,每个时间点三份培养),再由研究者重新分析。这批数据独立于 Anthropic,但当初采集并不是为了检验 ART;8% 是对公开数据的重分析,不是这次新实验的结果。[S2][S3]
Anthropic 之外有人检验过吗?
没有人复现过。报告是放在 Anthropic 自家服务器上的一份 PDF,未经同行评审,Crossref 上也查不到。外部参与只有两处:博客引用了张锋(Feng Zhang,MIT 与 Broad 研究所)读过预印本后的评价,说逆转录酶旁的 RNA 重复阵列「确实引人入胜」,值得进一步研究;致谢部分感谢 F. Zhang、B. Hie、D. Li、G. Brixi 审阅早期稿件。这是对草稿的意见,不是检验。人证实的是阵列存在且会转录,而不是一个能工作的酶系统。[S1][S2]
认不认得出阵列,取决于有没有把 DNA 读进上下文。
研究者还搭了一个固定输入的基准:七个 Claude 模型、五个信息等级,每个模型每个等级跑 100 次,由 Mythos 5 评委按十项特征打分。把位点序列直接放进上下文时,最强的四个模型至少 90% 的尝试能认出阵列;改成给文件和工具,识别率最低跌到 32%,给文件的尝试中有 39% 从没读过连续 200 nt 以上的 DNA。读进的 DNA 越多,四个模型合计的识别率越高,从 29% 升到 76%,Mythos 5 最高达到 96%。可解释性分析在 Mythos 5 内部找到两个沿重复拷贝逐步增强的信号;把每个拷贝打乱后,其中一个信号在全部 14 个拷贝上都消失了。不过,两个信号对非 DNA 的重复也有反应,并非 DNA 特有。这些都是计算结果,出自同一家公司,评委也是它自家的模型。[S2]
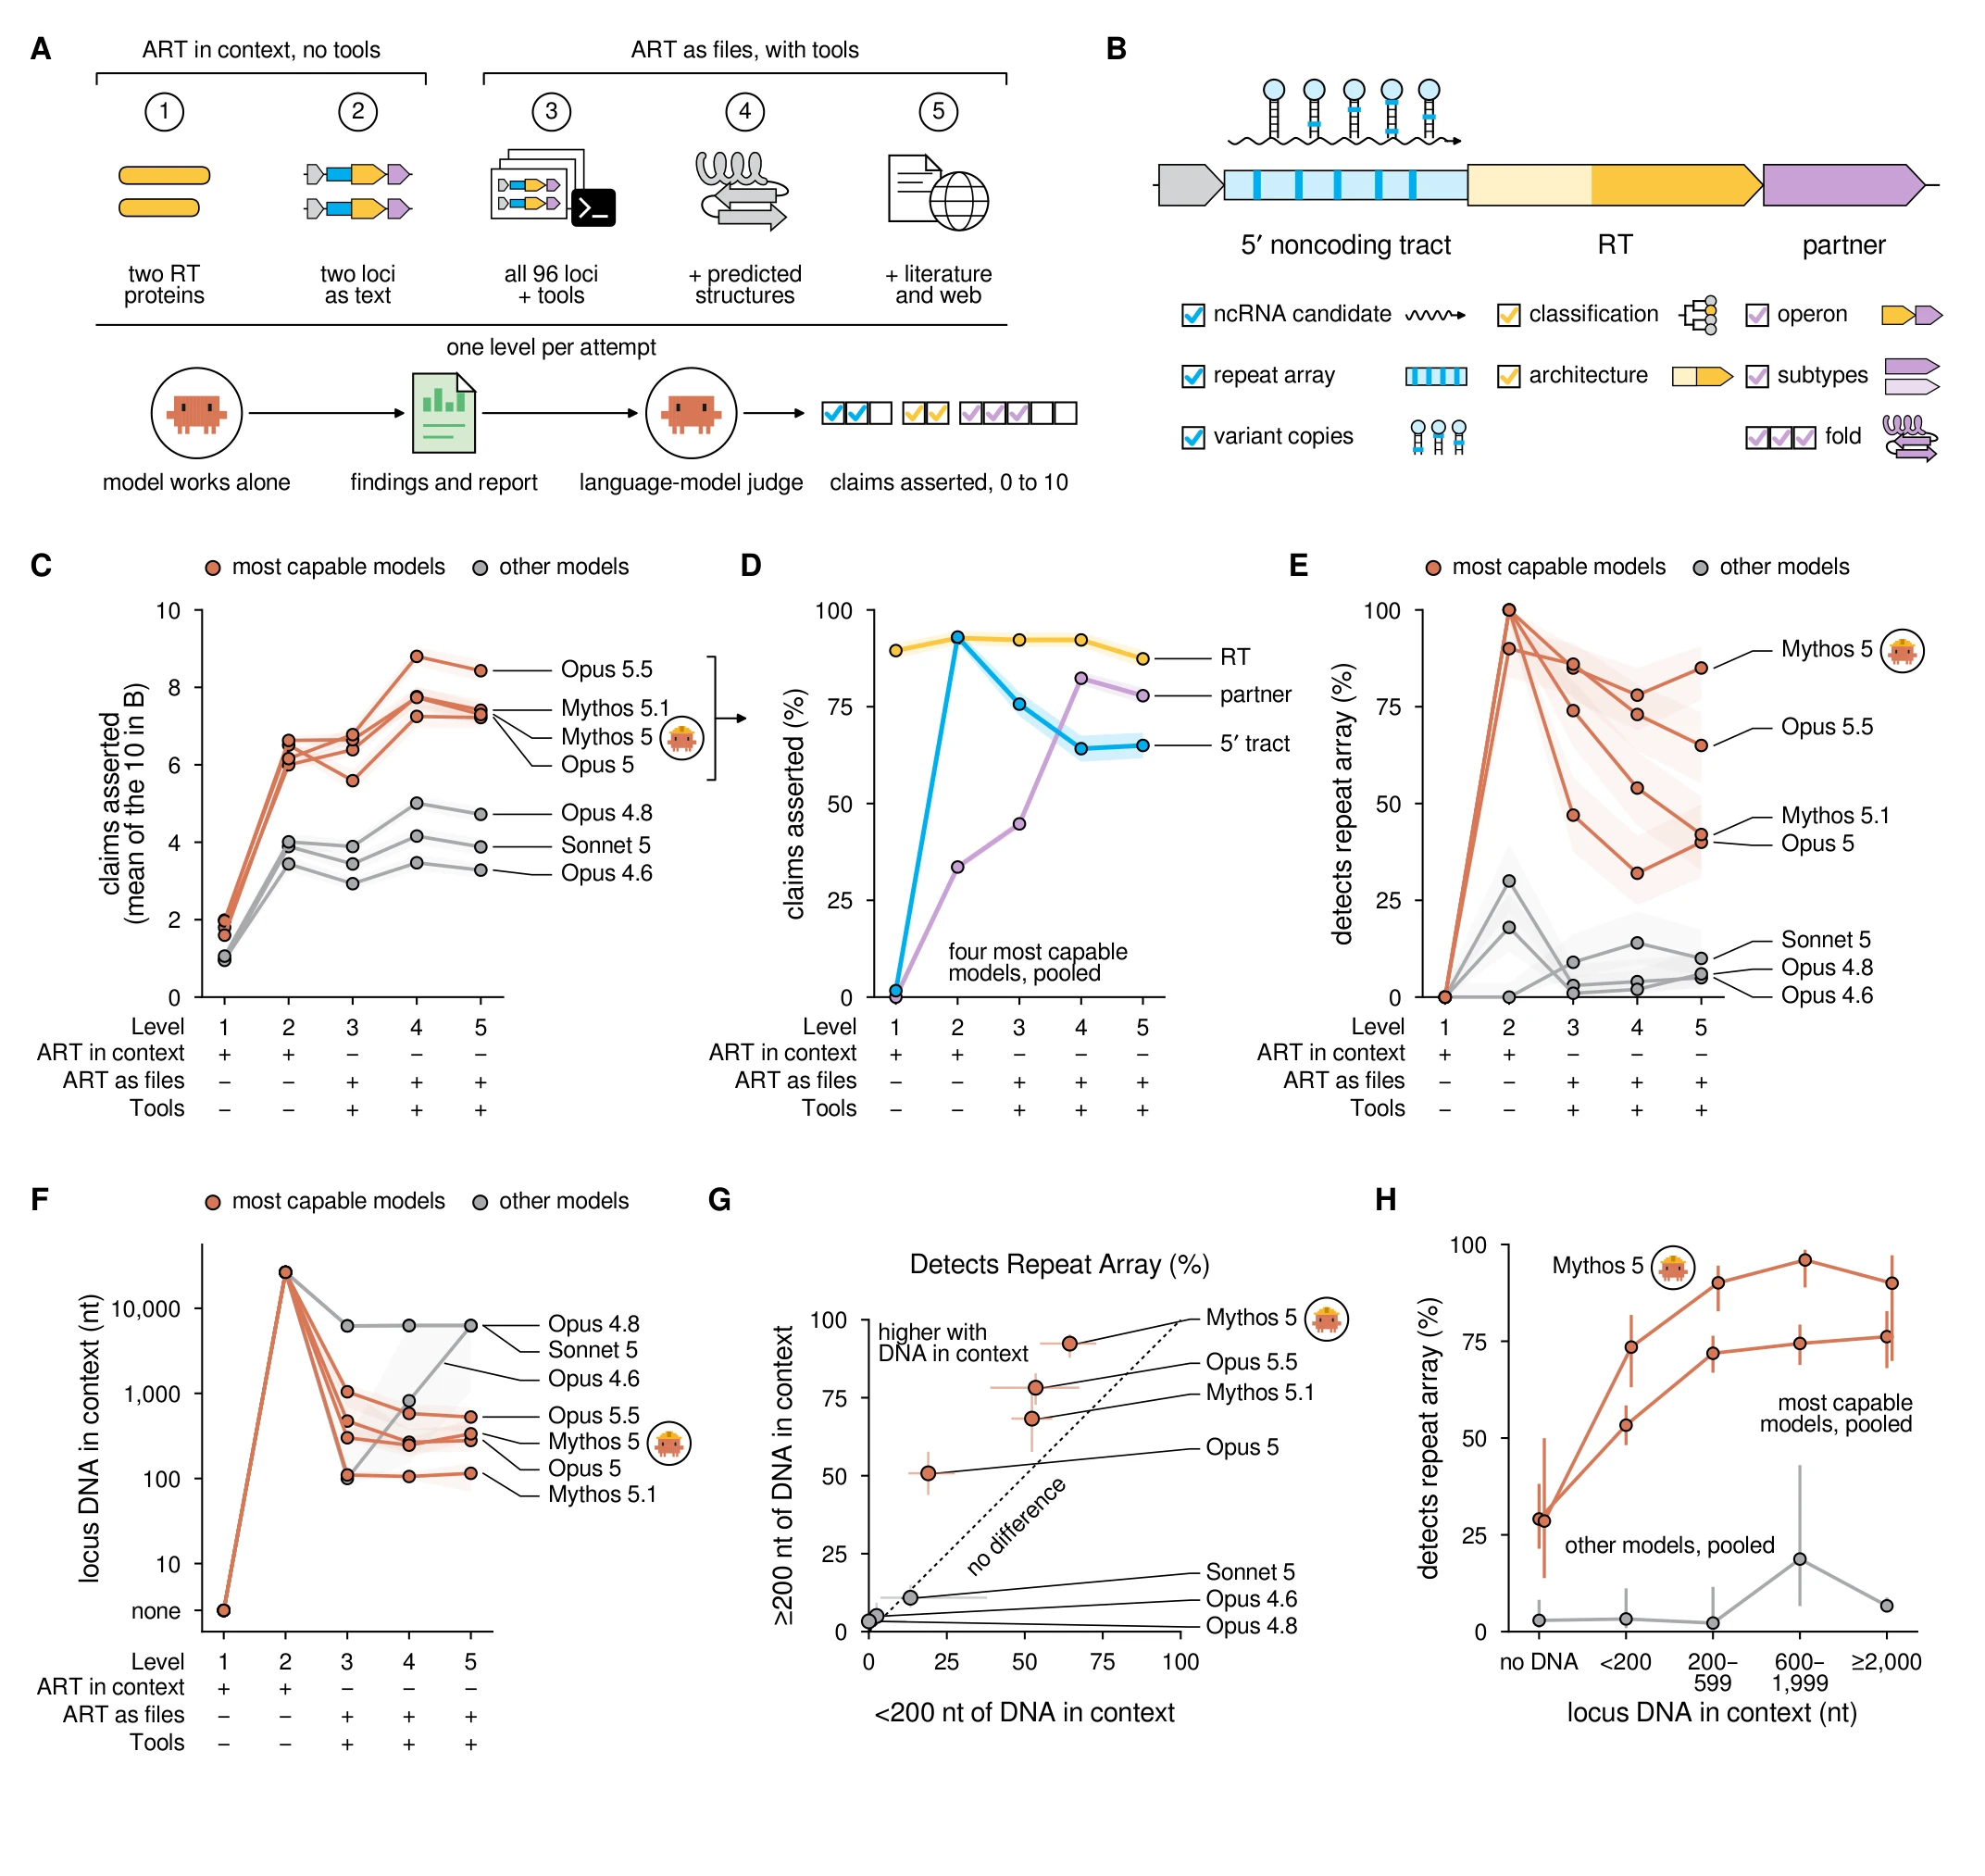
报告 Fig. 4:最强的模型能认出阵列,识别取决于是否把 DNA 读进上下文。Yoon et al., Anthropic 技术报告(2026),未声明许可,© Anthropic PBC,评述引用;整图未修改。 [S2]
05我从中学到什么
- 可迁移的洞见
- 自动化的是「注意到」而非「检验」:智能体带着自己的预期去读,标出不符之处。
- 设计启发
- 要让智能体把原始序列读进上下文;只用工具、跳过阅读的尝试大多漏掉了阵列。
- 阅读启发
- 看到「AI 发现新酶」,先找湿实验测了什么:这里是小 RNA 测序,不是酶活性。
- 接下来看
- RT 与伙伴蛋白的活性实验;重跑或外部实验室能否找到类似 ART 的系统。
分工要一步步看,不能只看标题
在这项工作里,「Claude 自主发现」确切的含义分三段:一次自主普查中,普查、否决候选、后续追踪、认出阵列、计数和检索既往报道,由智能体在无人干预下完成;随后的家族分析由研究者主导、Claude 写代码;全部实验由人来做。任务书、从排好序的报告中挑选以及结果解释,也由人负责。几部分都是真的,但它们是不同的主张,依据的证据也不同。[S2][S1]
一次成功之外,还要报重跑的成功率
报告自己做了重跑,并如实写明十次全都漏掉、11 次运行只成功 1 次,比多数「AI 发现」的发布更坦诚,也点出了值得追踪的指标:同一框架反复运行时,找出某类异常的频率。框架设计和模型能力会大幅改变研究结果,这是报告自己的结论。[S2]
对照上周那条湿实验条目
9 月 18 日的时间线条目转述了路透社的报道,称这个实验室让 Claude 指挥机器人做实验。而在这份首个成果里,Anthropic 自己说,所有实验室工作都由人类科学家完成,自动化不太适合这类流程。至少在这项工作中,Claude 在实验台边的角色是帮人解读数据。[S1]
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。
- S1Claude discovers a novel enzyme system with CRISPR-like repeatsAnthropic · 2026.09.23 · 公司发布
- S2Autonomous AI agents discover reverse transcriptases with tandem repeat arraysAnthropic · Yoon et al. · 2026.09.23 · 公司技术报告(预印本),未同行评审
- S3Interactions between Jumbo Phage SA1 and Staphylococcus: A Global Transcriptomic AnalysisMicroorganisms · Zhang et al. · 2022.08.07 · 报告重分析的公开 RNA-seq 数据来源(经 Crossref 核对书目)
- S4Comparative Genomics of Three Novel Jumbo Bacteriophages Infecting Staphylococcus aureusJournal of Virology · Korn et al. · 2021.09.09 · MarsHill 原始基因组报告(经 Crossref 核对书目)