

证据地图· 科学证据 · Frontier
把湿实验放进回路:智能体三轮设计核酸适配体,命中率从 0 到 42%
Google Research、斯坦福大学与 Google DeepMind 的 Cutts、Coller 等人让智能体设计核酸适配体:每轮约 1,000 条设计被合成、测量、回传,智能体据此改策略。凝血酶上的命中率从 0 升到 42.1%,肌红蛋白上先从 10.2% 掉到 3.7%,再回到 33.5%,中间那次下跌是智能体自己诊断出来的。
●预印本,未经同行评审;每条设计都被合成并测量,作者自己的检测
这项工作推进的是:让智能体在三轮真实实验之间改自己的设计策略
- MODEL理解 / 预测
- DECIDE选择下一步
- INTERACT测试现实
- UPDATE改变下一轮
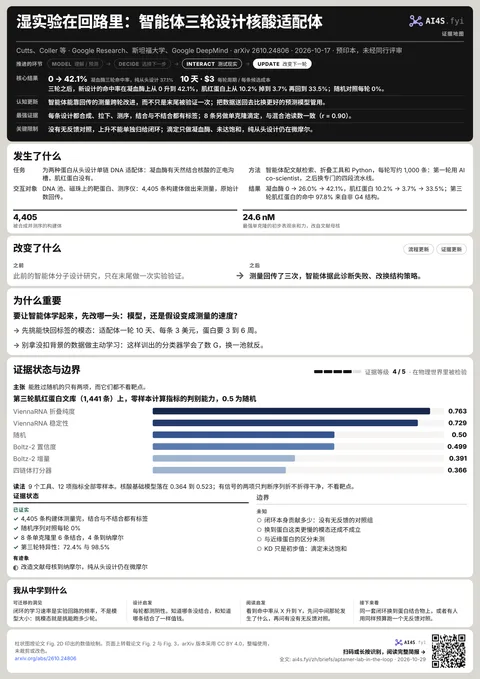
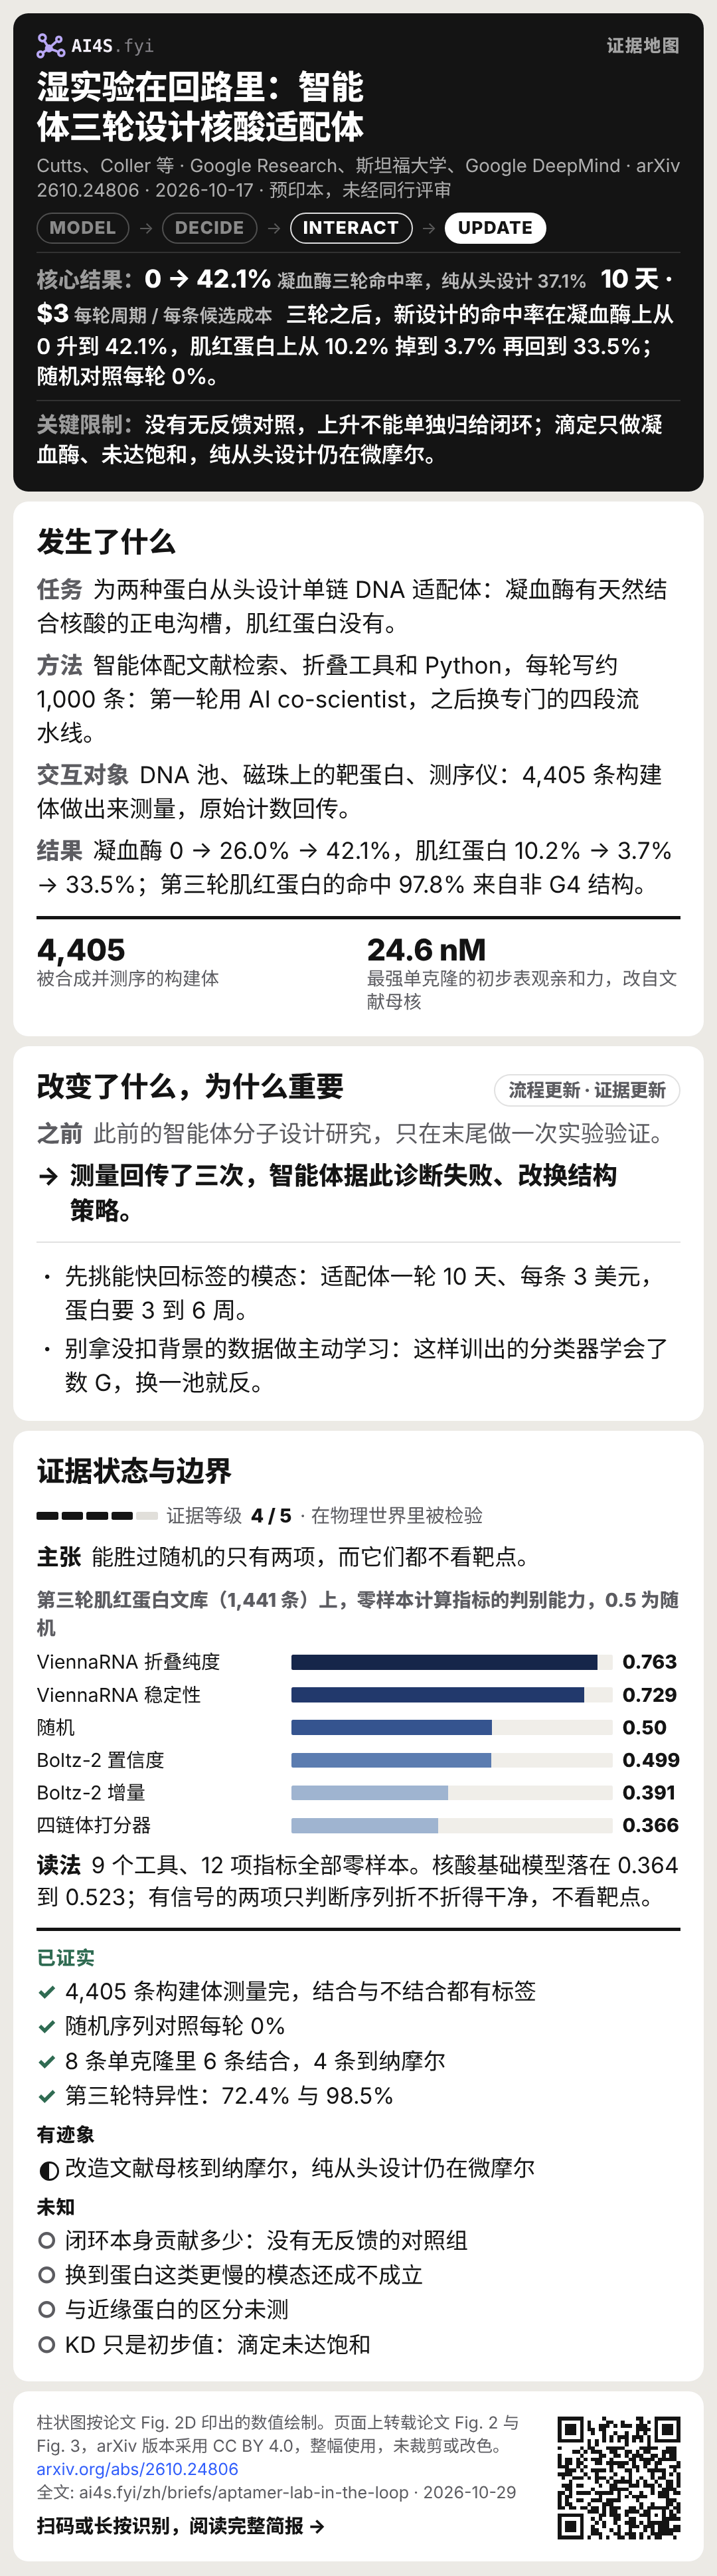
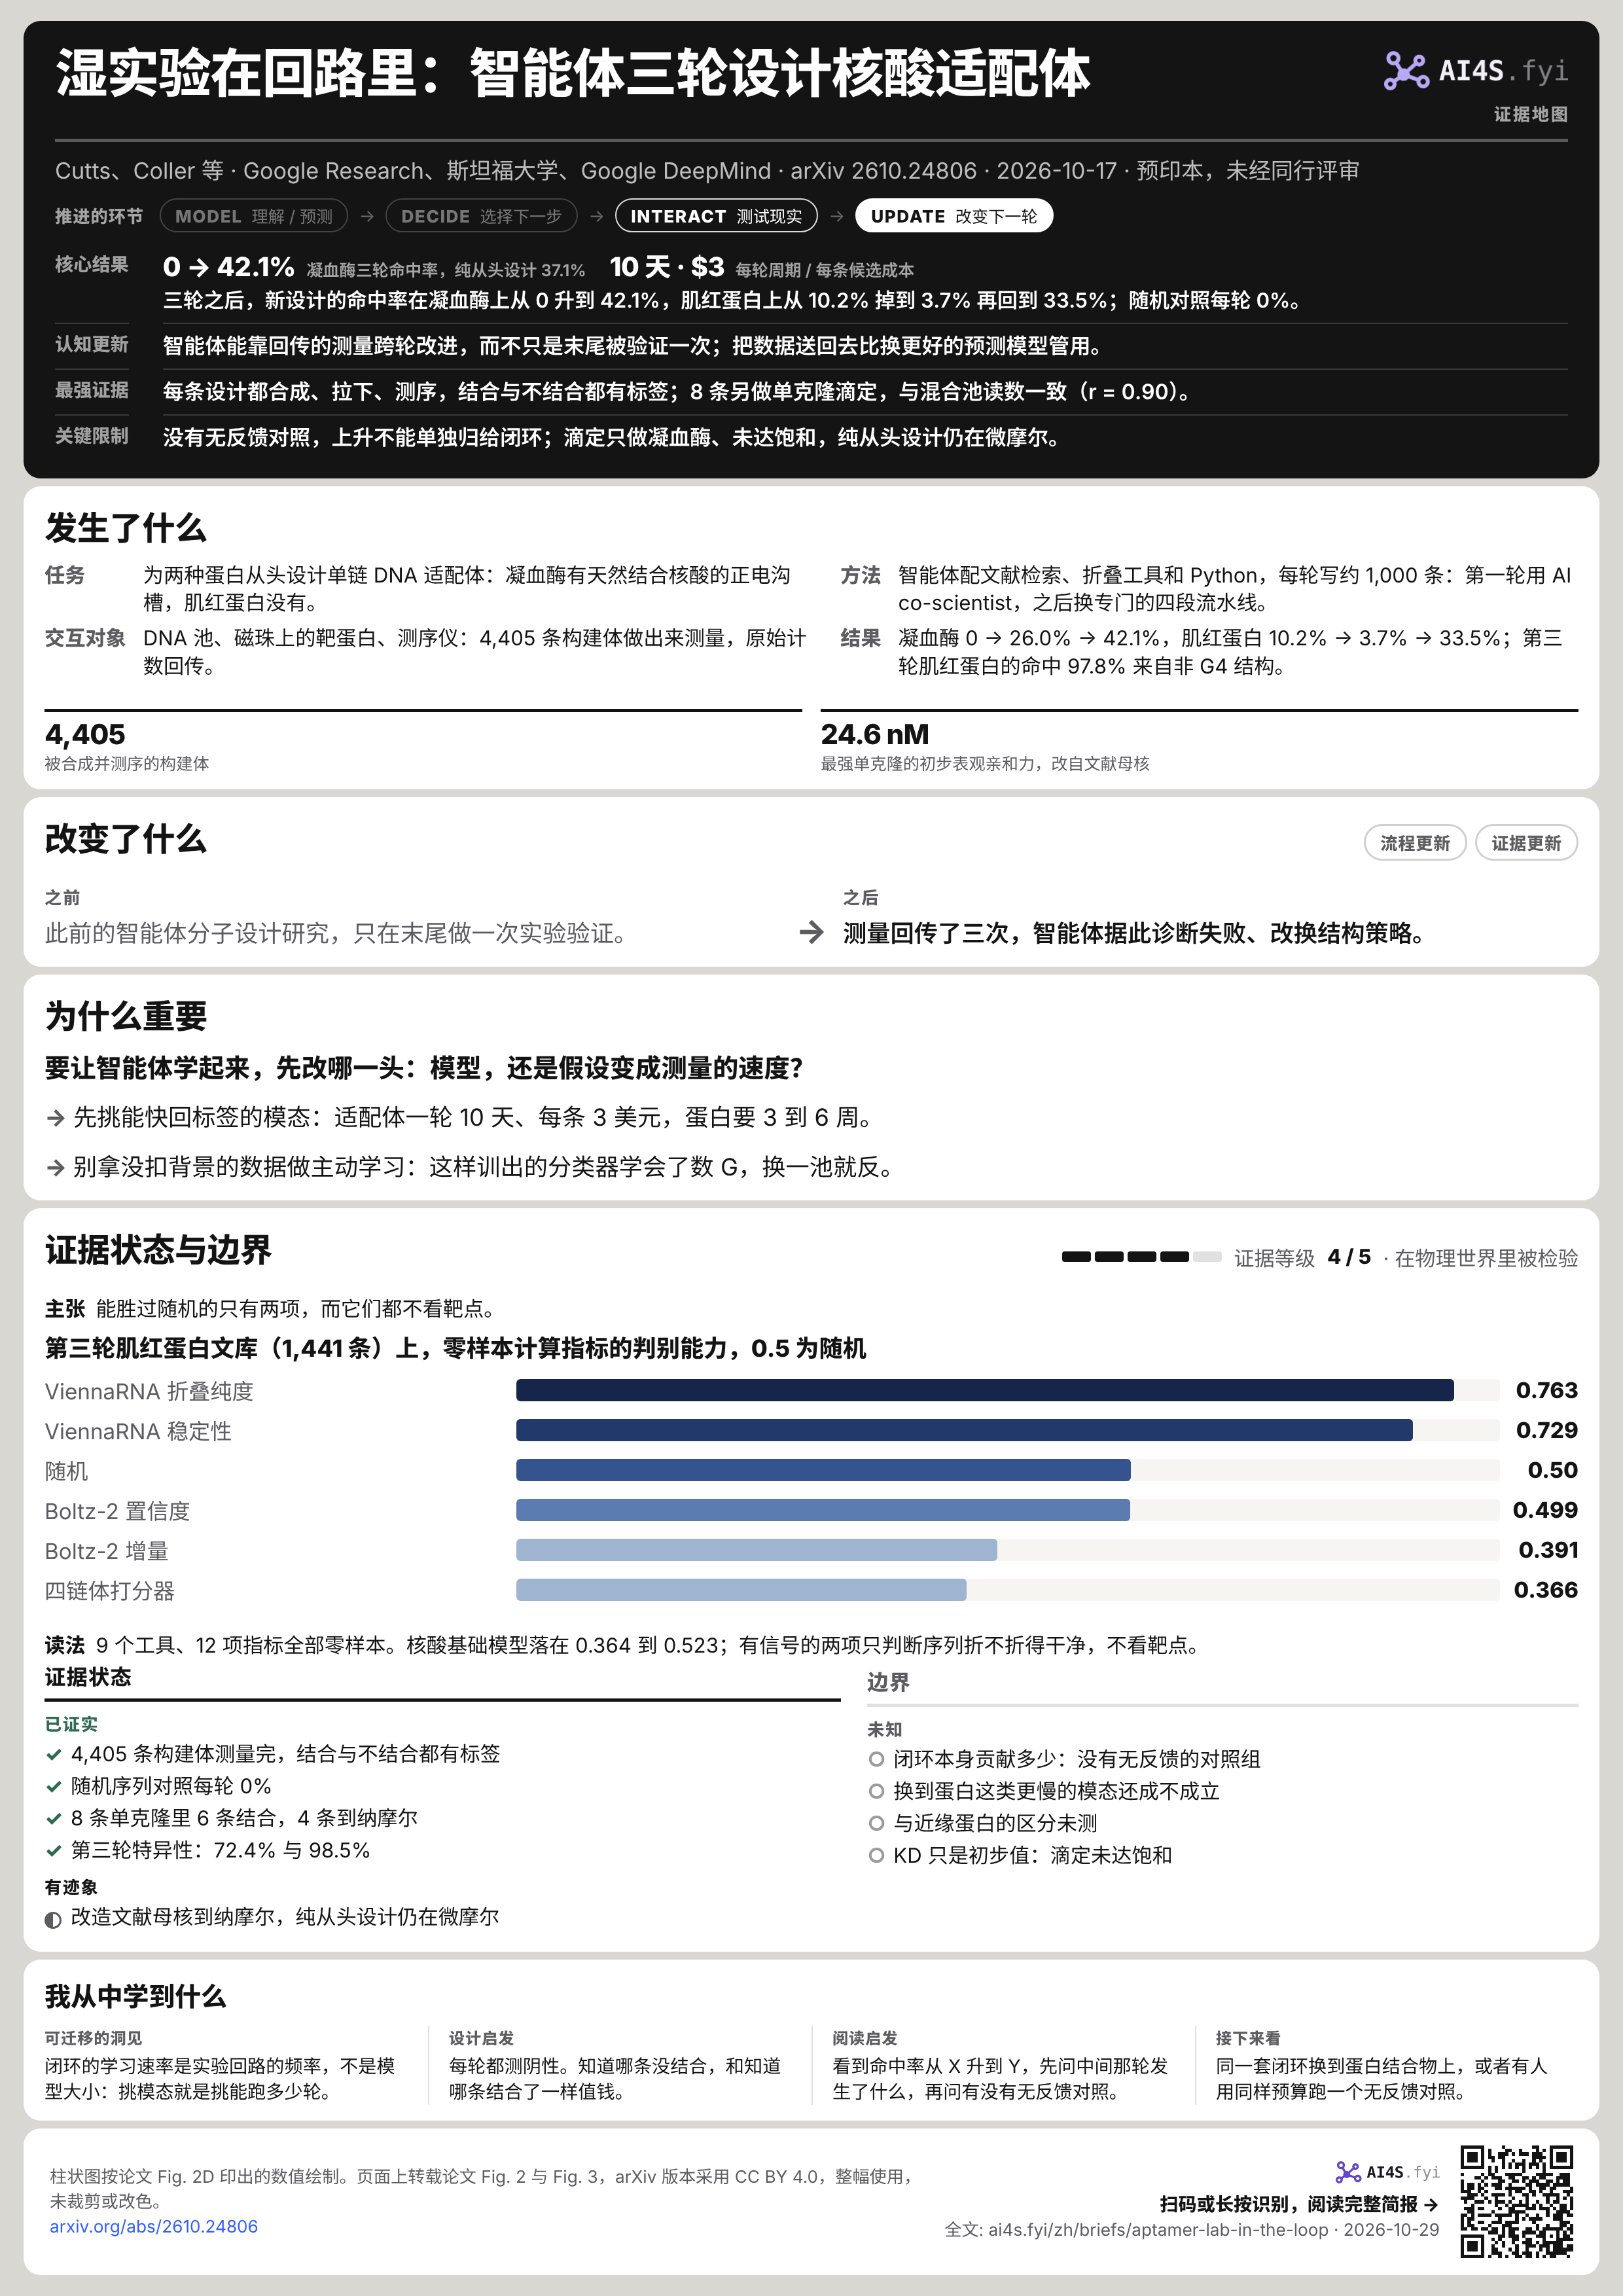
0 → 42.1%凝血酶三轮命中率,纯从头设计 37.1%
10 天 · $3每轮周期 / 每条候选成本
三轮之后,新设计的命中率在凝血酶上从 0 升到 42.1%,肌红蛋白上从 10.2% 掉到 3.7% 再回到 33.5%;随机对照每轮 0%。
- 认知更新
- 智能体能靠回传的测量跨轮改进,而不只是末尾被验证一次;实验反馈暴露出计算预测没看出来的失败,但它本身贡献多大,这个设计分不出来。
- 最强证据
- 每条设计都合成、拉下、测序,结合与不结合都有标签;8 条另做单克隆滴定,与混合池读数一致(r = 0.90)。
- 关键限制
- 没有无反馈对照,上升不能单独归给闭环;滴定只做凝血酶、未达饱和,纯从头设计仍在微摩尔。
01发生了什么
- 任务
- 为两种蛋白从头设计单链 DNA 适配体:凝血酶有天然结合核酸的正电沟槽,肌红蛋白没有。
- 方法
- 智能体配文献检索、折叠工具和 Python,每轮写约 1,000 条:第一轮用 AI co-scientist,之后换专门的四段流水线。
- 交互对象
- DNA 池、磁珠上的靶蛋白、测序仪:4,405 条构建体做出来测量,原始计数回传。
- 结果
- 凝血酶 0 → 26.0% → 42.1%,肌红蛋白 10.2% → 3.7% → 33.5%;第三轮肌红蛋白的命中 97.8% 来自非 G4 结构。
4,405被合成并测序的构建体
24.6 nM最强单克隆的初步表观亲和力,改自文献母核
为什么是核酸适配体
作者挑这一类分子,是因为序列本身就是那个分子。蛋白或抗体从一条设计走到一个结合读数,要经过基因合成、克隆、转化、细胞培养表达、裂解、柱纯化,再做结合检测,七步、每轮 3 到 6 周,而且表达、折叠、溶解、纯化每一步都会掉人。传统的 SELEX 不用克隆,但靠的是从 10^13 到 10^15 条随机序列里盲目富集,重复 8 到 15 轮六步循环才测序,谁成谁败说不出原因。这里是三步:寡核苷酸池合成、磁珠拉下、测序,一轮约 10 天,每条候选约 3 美元。[S1]
每轮都测了输入文库和三次重复的靶蛋白、空磁珠拉下,所以合成出来却没富集的序列是真的没结合,而不是没做出来。正负标签齐全,这是整个闭环能学起来的前提:蛋白筛选里 60% 到 80% 的设计根本表达不出来或折不对,失败原因混在一起。[S1]
三轮之间发生了什么
第一轮由 AI co-scientist 零样本出题,642 条。凝血酶上全军覆没(0/167):固定的 PCR 引物与结合母核发生了杂交,设计出的折叠在完整构建体里根本不成立。肌红蛋白上有 10.2%(20/196)。第二轮换成专门的四段流水线(分析、策略、并行设计、打分),把第一轮的核心用 5′ 和 3′ 双链夹住,凝血酶命中率升到 26.0%(54/208)。[S1]
同一轮里肌红蛋白反而掉到 3.7%(9/244)。原因在反向筛选:第二轮把 G-四链体(四条鸟嘌呤链叠成的紧凑结构)的比例做到六成,而这类结构带大量负电,对没有核酸沟槽的肌红蛋白来说只是黏在带电表面上。分析智能体从原始计数里查出,交叉反应的结合物里 97% 是 G-四链体,肌红蛋白的靶向特异性因此从 75.0% 崩到 19.1%。[S1]
第三轮智能体把没夹住的 G-四链体从 20.4% 压到 1.3%,把 72.3% 的池子换成非 G4 结构。回来的数据支持这个判断:留下的 G4 命中率 0% 到 2.4%,而 H 型假结拿到 80.4%(37/46)、延长回文发夹 61.8%(47/76)、鼓包发夹 45.9%(67/146),第三轮肌红蛋白 184 个命中里 180 个出自非 G4,脱靶为零,特异性回到 72.4%。凝血酶那边第三轮 69.1% 用非 G4 结构,特异性 98.5%。[S1]
单克隆滴定
混合池里的富集可能来自 PCR 偏倚或竞争,所以作者另外单独合成了 8 条带荧光标记的凝血酶候选(T01 至 T08,75 到 85 个碱基),做 0 到 1,000 nM 的五点平衡滴定。8 条里 6 条有浓度依赖的结合,1 µM 处的端点荧光与第三轮混合池富集跨近四个数量级一致(Pearson r = 0.90,p = 0.0021)。四条高富集的(T01 至 T04)给出纳摩尔曲线,初步表观 KD 在 24.6 到 133 nM;纯从头的骨架在 1 µM 才开始显出结合。作者强调这些 KD 是初步值,因为荧光在 1 µM 以内没有到达饱和平台。[S1]
值得分开读的是这些纳摩尔结合物的来源:T01 到 T04 都是智能体在已发表的凝血酶母核(TBA、NU172)外面重做茎环得到的,不是凭空设计。纯从头的设计这一轮停在微摩尔。作者也给了对照的量级:此前用近百万条物理筛选数据训练深度网络的方法,做到过 1.5 nM。[S1]
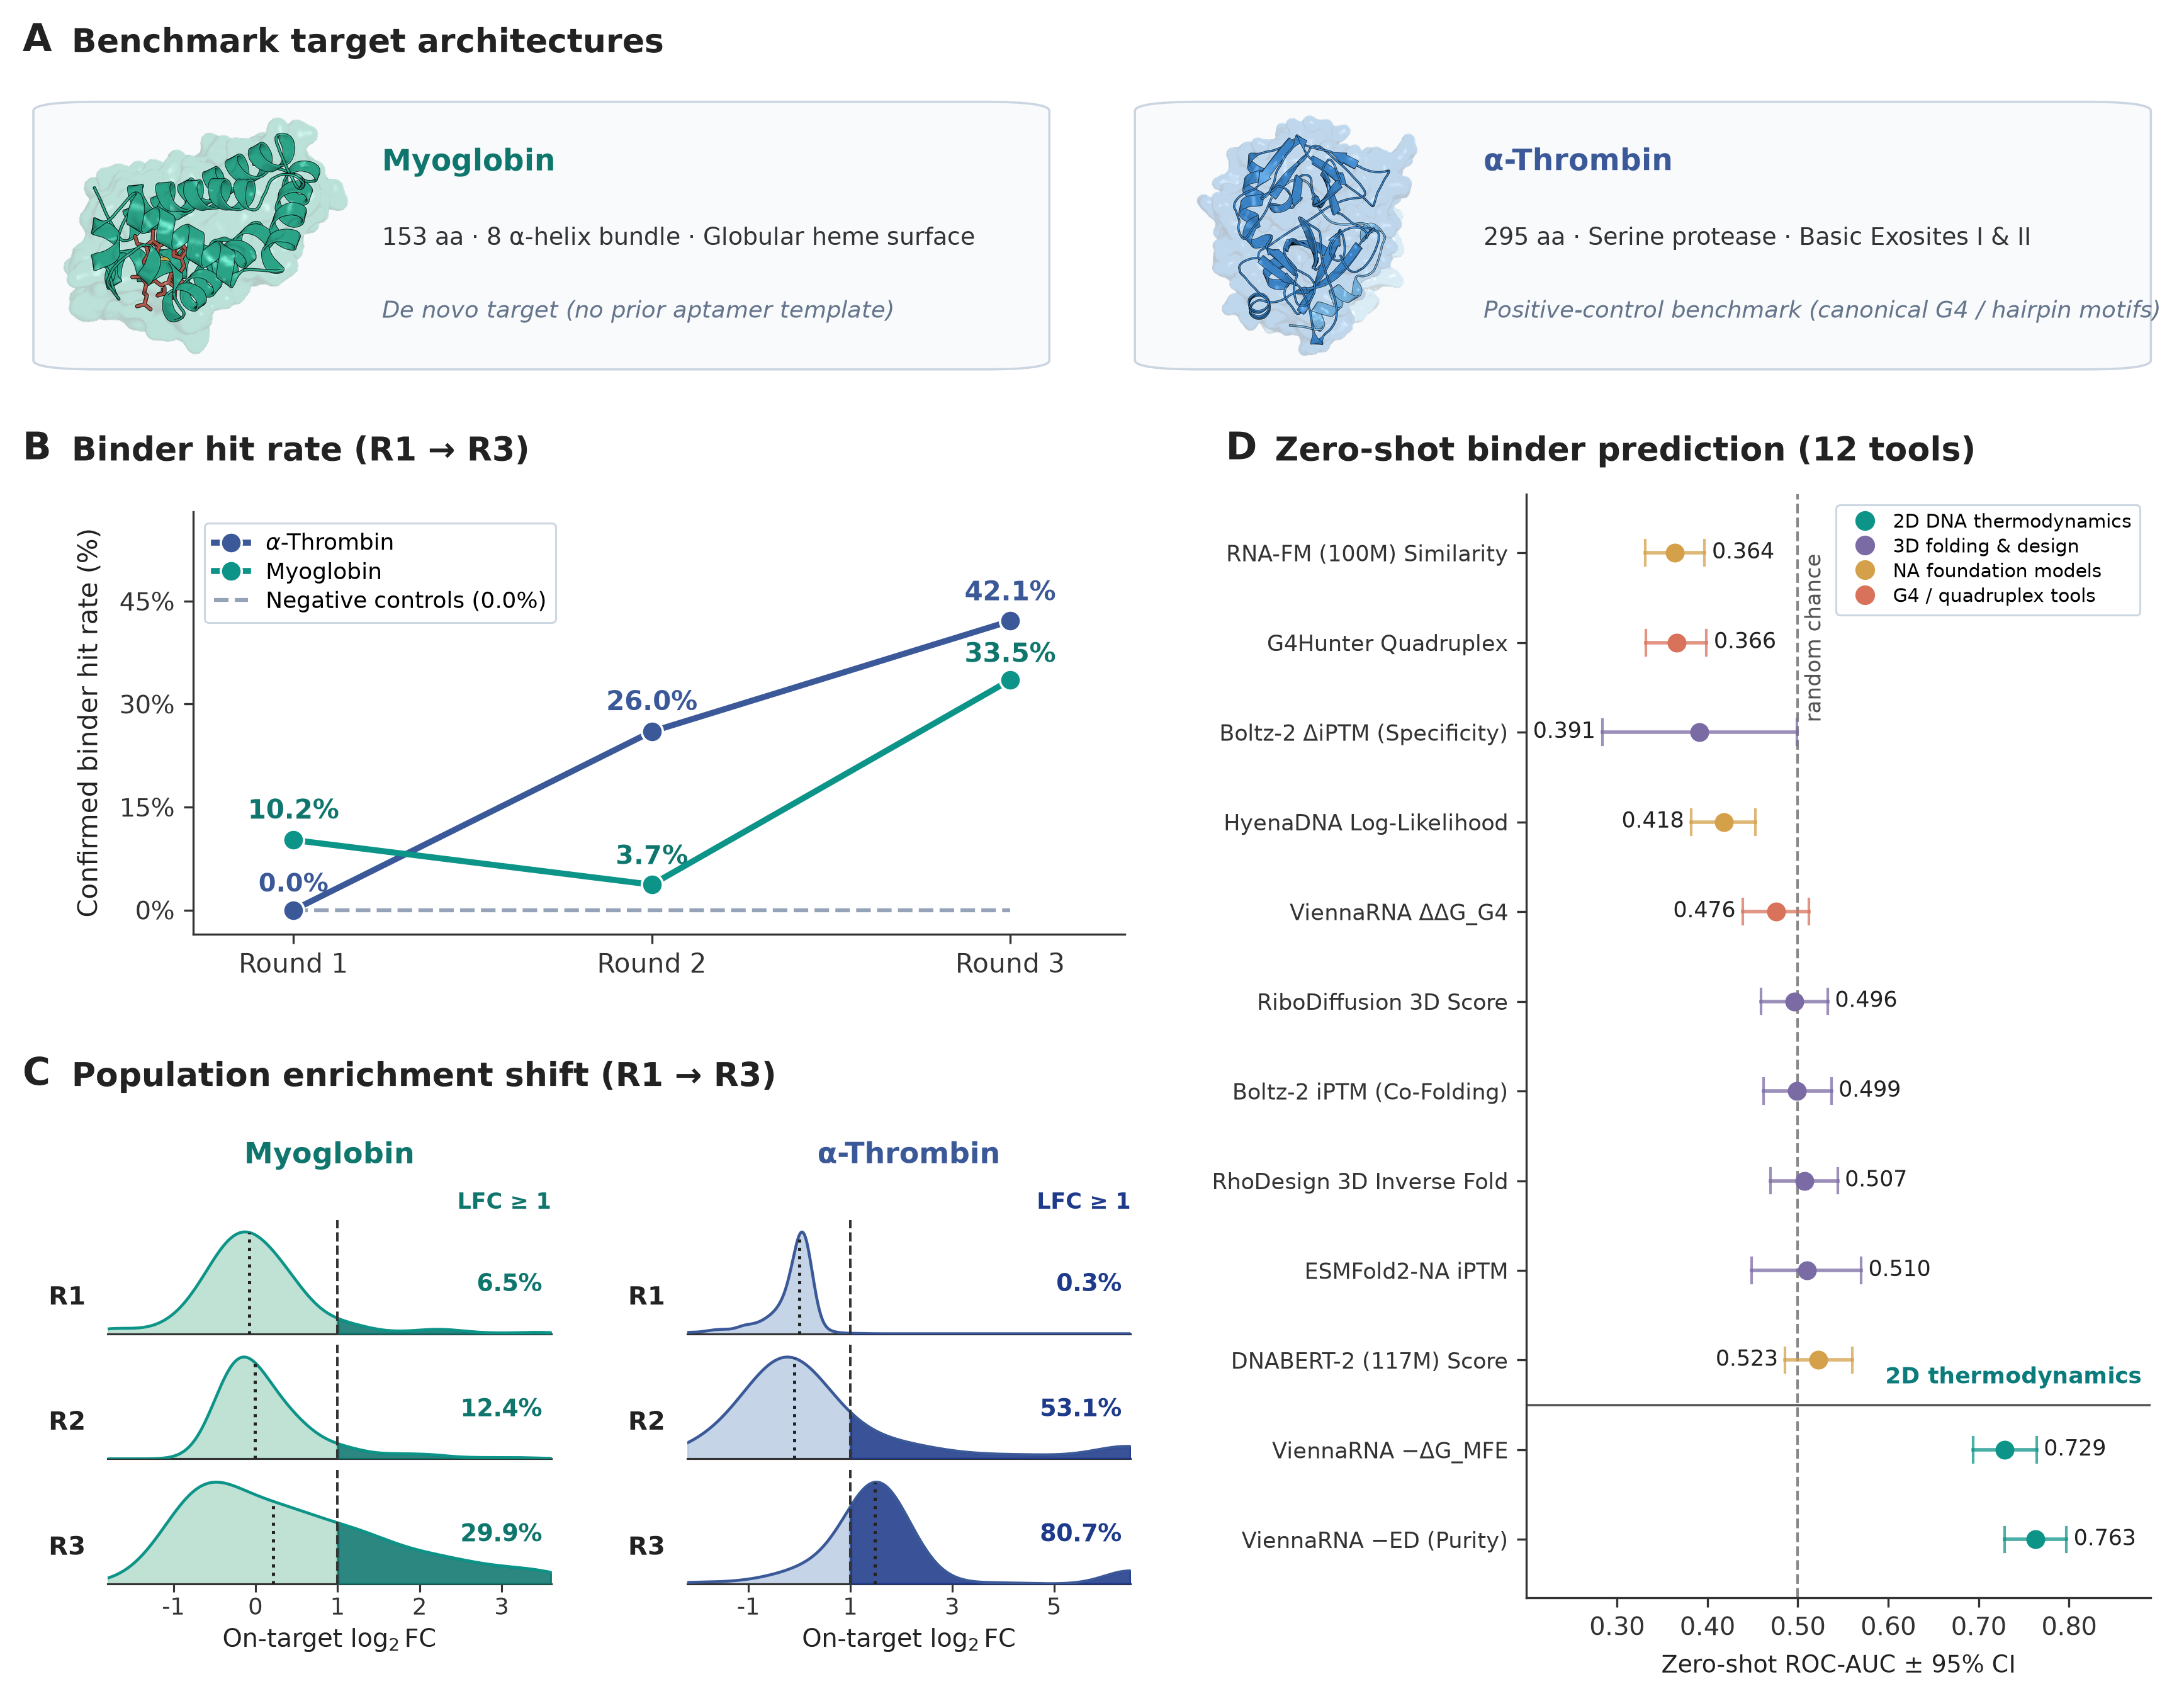
B 是三轮命中率,C 是扣背景前的原始富集分布(凝血酶池中富集两倍以上的比例从 0.3% 到 53.1% 再到 80.7%),D 是本页证据栏柱状图的来源。来源:Cutts 等,arXiv 2610.24806,CC BY 4.0。 [S1]
02改变了什么
流程更新证据更新此前的智能体分子设计研究,只在末尾做一次实验验证。
测量回传了三次,智能体据此诊断失败、改换结构策略。
03为什么重要
要让智能体学起来,先改哪一头:模型,还是假设变成测量的速度?
- 先挑能快回标签的模态:适配体一轮 10 天、每条 3 美元,蛋白要 3 到 6 周。
- 别拿没扣背景的数据做主动学习:这样训出的分类器学会了数 G,换一池就反。
这篇最可迁移的一点不在适配体,而在选题:作者是先挑了一个「假设到测量」最短的模态,再去问智能体能不能学。闭环的学习速率等于实验回路的频率,而不是模型的参数量。同一套推理放在蛋白结合物上,一年也就跑十来轮。[S1]
第二条是给想用模型省掉实验的人看的。作者在第三轮肌红蛋白文库(1,441 条)上零样本跑了 9 个工具的 12 项指标,3D 共折叠、反向折叠、核酸基础模型、G4 打分器全都在随机线附近或以下;唯一有信号的两项来自 ViennaRNA 的二级结构计算,而它们根本不看靶点,只判断序列能不能折成干净结构。Boltz-2 的界面置信度甚至与特异结合反相关,因为它偏好紧凑的 G-四链体,而那正是非特异黏附的那类结构。[S1]
还有一条写在讨论里、容易被跳过:闭环的好处不只是迭代,而是可以分层加压。第一轮先要亲和力,第二轮加反向筛选要特异性,再往后可以要血清里的稳定性或细胞摄取。一次性筛选必须同时满足所有约束,闭环可以一轮加一条。[S1]
04证据状态与边界
证据等级 4 / 5 · 在物理世界里被检验 · 闭环实验证据状态
已证实
- 4,405 条构建体测量完,结合与不结合都有标签
- 随机序列对照每轮 0%
- 8 条单克隆里 6 条结合,4 条到纳摩尔
- 第三轮特异性:72.4% 与 98.5%
边界
有迹象
- 改造文献母核到纳摩尔,纯从头设计仍在微摩尔
未知
- 闭环本身贡献多少:没有无反馈的对照组
- 换到蛋白这类更慢的模态还成不成立
- 与近缘蛋白的区分未测
- KD 只是初步值:滴定未达饱和
主张能胜过随机的只有两项,而它们都不看靶点。
第三轮肌红蛋白文库(1,441 条)上,零样本计算指标的判别能力,0.5 为随机
读法9 个工具、12 项指标全部零样本。核酸基础模型落在 0.364 到 0.523;有信号的两项只判断序列折不折得干净,不看靶点。
本站把这条记在证据阶梯第 4 级:设计出的序列被合成出来,在磁珠和测序仪上测过,不是在已有数据上回算。强度还来自两点:每轮都测了阴性,所以 42.1% 的分母是真实的;以及单克隆滴定把混合池读数校准到了物理结合上。[S1]
最该克制的地方是归因。这场实验没有设无反馈的对照组,也没有和进化算法、贝叶斯优化或监督学习做同预算的正面比较;第一轮的 0% 是构建体缺陷,第二轮换了 harness,所以「从 0 到 42%」这条曲线里,混着修 bug、换系统和真正从数据里学到的东西。作者自己把这一点写进了讨论,并说后续需要匹配预算的对照组。[S1]
第二处边界是亲和力。拿到纳摩尔的四条都是在已发表的凝血酶母核外面重做茎环,纯从头的设计这一轮停在微摩尔起步;而且滴定只做了凝血酶,封顶 1 µM,没有到饱和平台,所以 24.6 到 133 nM 是初步值。近缘蛋白的区分(肌红蛋白对血红蛋白、凝血酶对凝血酶原)也没有测,作者说这是反向筛选的下一步。[S1]
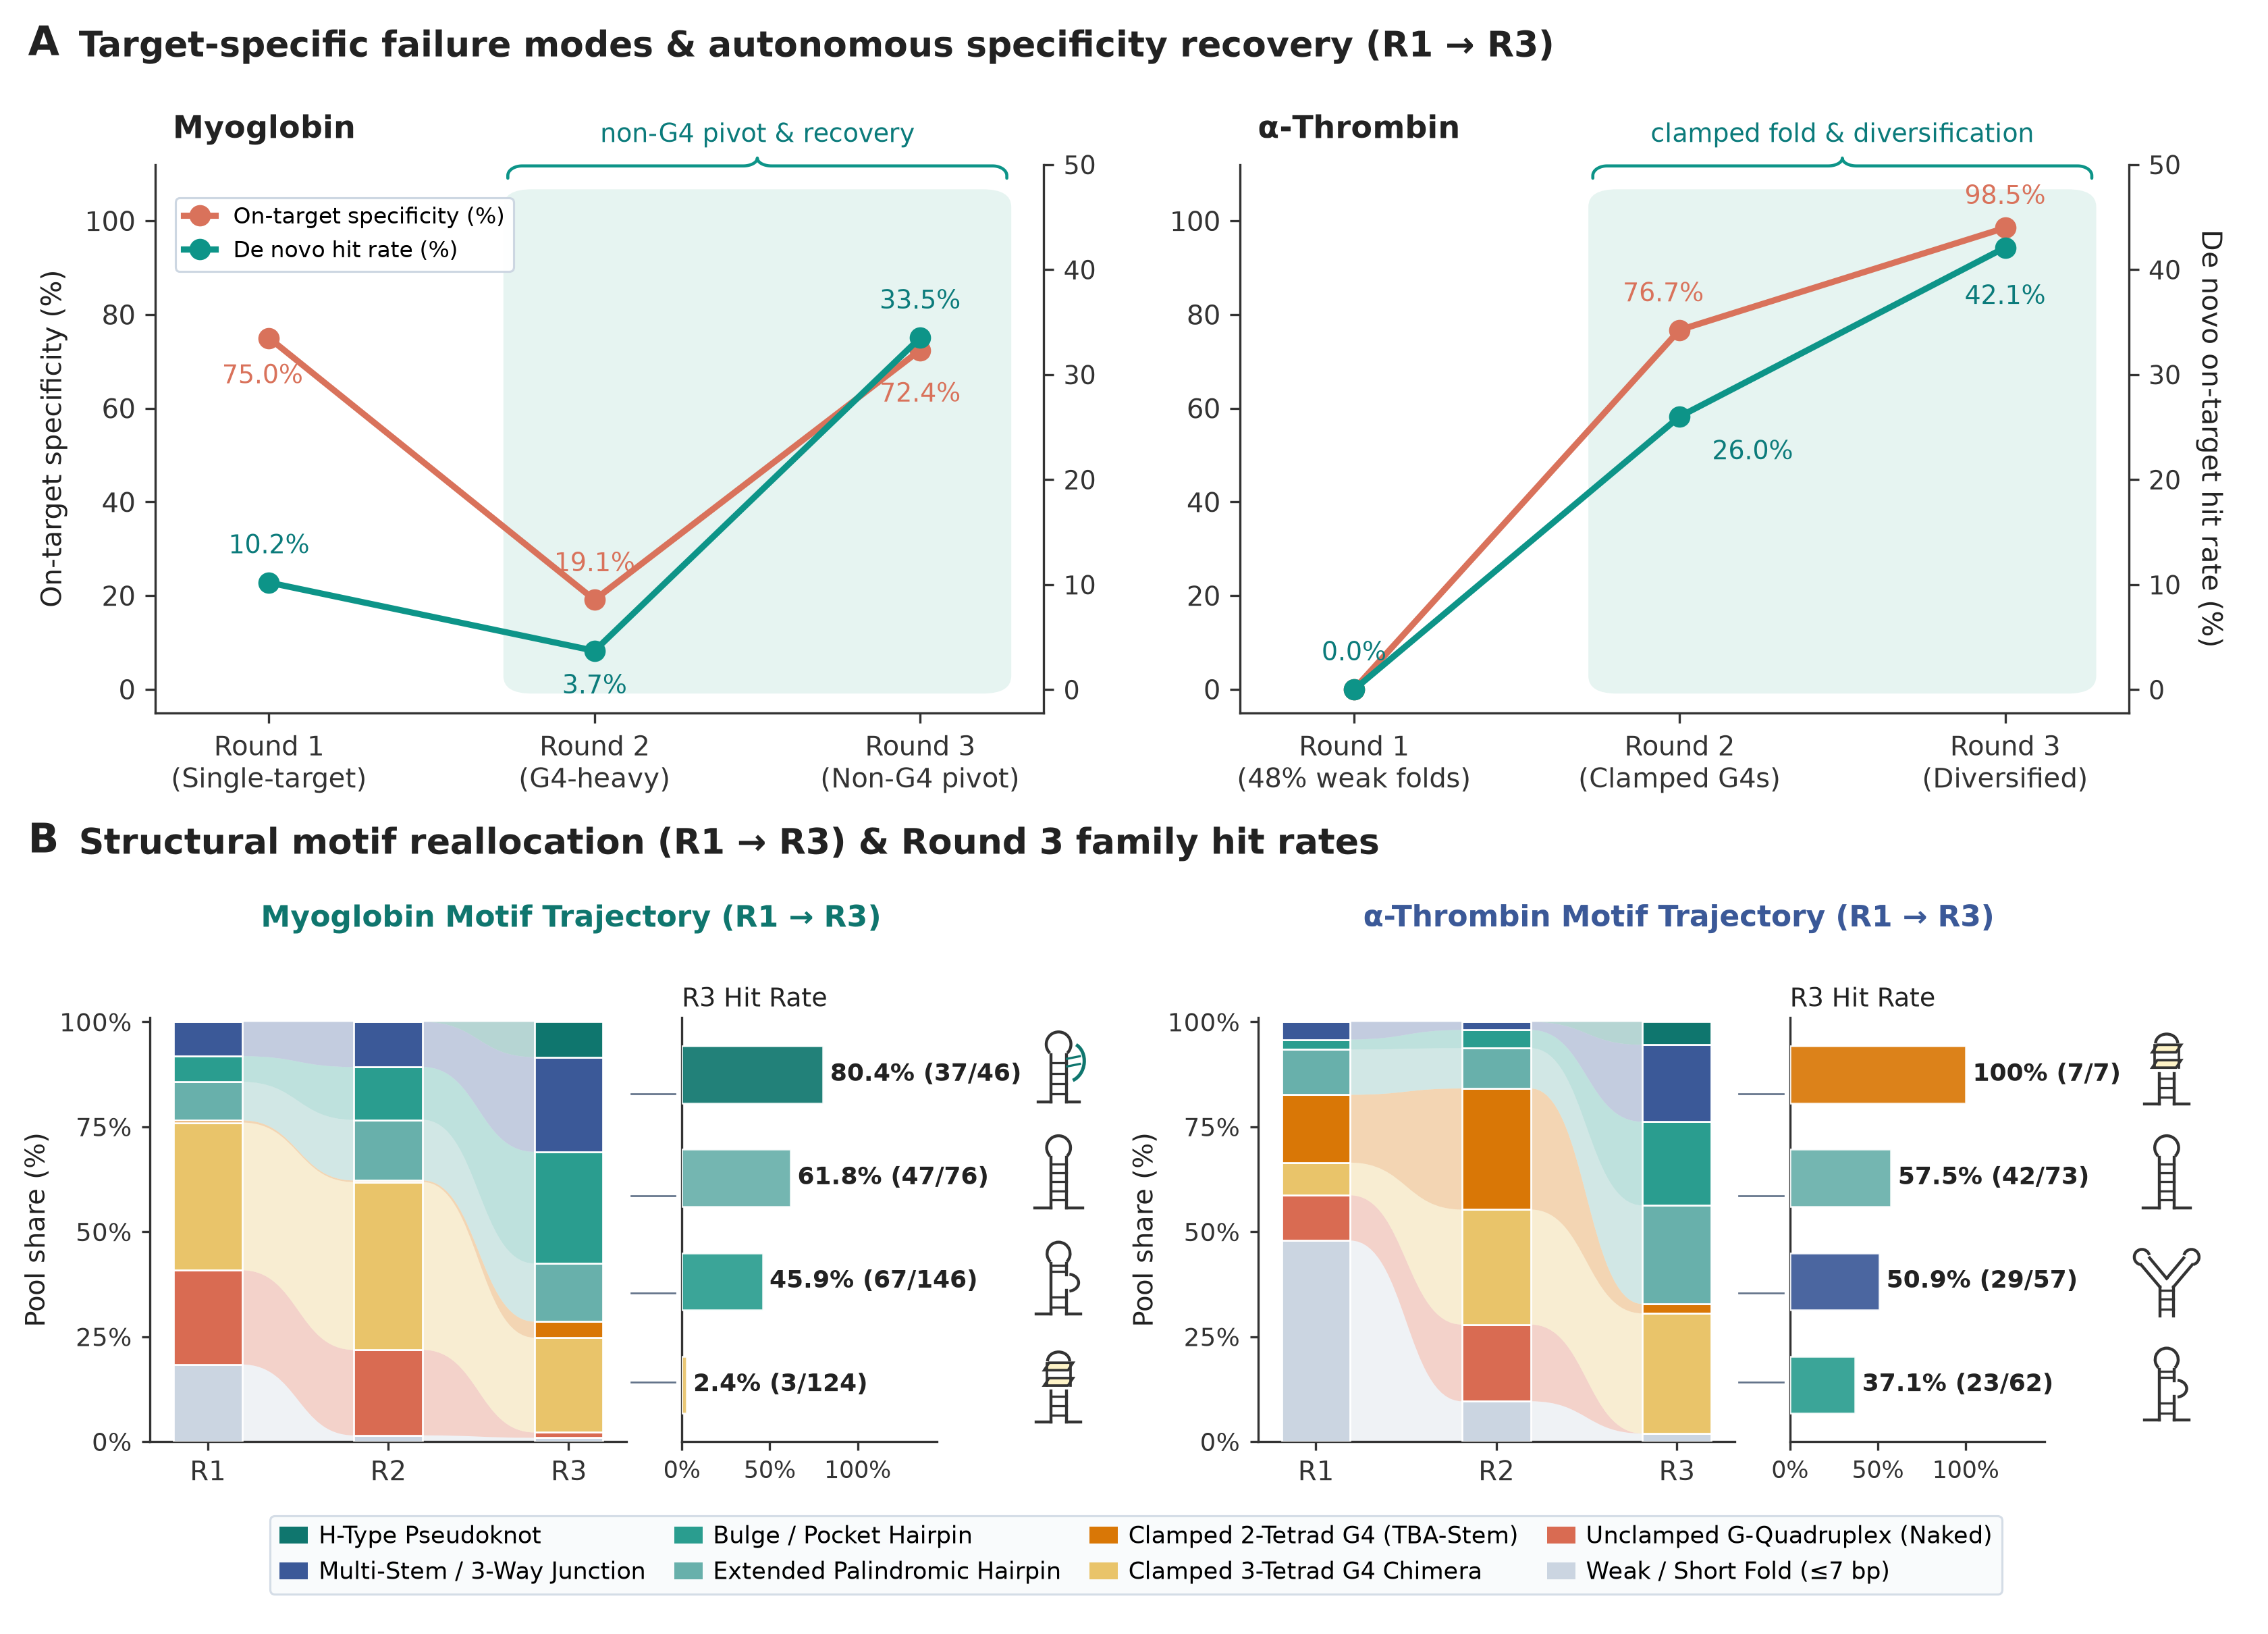
A 图左半是肌红蛋白的特异性崩塌与恢复(75.0% → 19.1% → 72.4%),右半是凝血酶(0% → 76.7% → 98.5%);B 图是结构家族的重新分配与第三轮各家族命中率。来源:Cutts 等,arXiv 2610.24806,CC BY 4.0。 [S1]
05我从中学到什么
- 可迁移的洞见
- 闭环的学习速率是实验回路的频率,不是模型大小:挑模态就是挑能跑多少轮。
- 设计启发
- 每轮都测阴性。知道哪条没结合,和知道哪条结合了一样值钱。
- 阅读启发
- 看到命中率从 X 升到 Y,先问中间那轮发生了什么,再问有没有无反馈对照。
- 接下来看
- 同一套闭环换到蛋白结合物上,或者有人用同样预算跑一个无反馈对照。
中间那一轮才是这篇的看点
肌红蛋白第二轮掉到 3.7%,不是失败而是这篇最硬的证据:下跌来自加了反向筛选、把黏在磁珠上的序列减掉,而智能体从原始计数里把原因找了出来,并在下一轮换掉了整类结构。一条只升不降的曲线,反而说明没人在中途检查过。[S1]
便宜的实验改变了该怎么做评测
每条候选 3 美元、每轮 10 天,意味着可以把失败也买下来:4,405 条里大部分不结合,而正是这些阴性让后面的统计过滤和模型训练站得住。当实验贵的时候,人们只报成功,评测也就只看成功。[S1]
判断会在两种情况下加强:有人用同样预算跑一个不回传数据的对照组,而闭环仍然明显更好;或者同一套方法在另一个没有文献母核的靶点上,把纯从头设计做到纳摩尔。会在两种情况下减弱:无反馈对照跑出相近的曲线;或者单克隆复测显示混合池的富集被 PCR 偏倚放大了。
和本站记录里另外两条放在一起读更有意思:AIntibody 的盲测说明,没有基线的命中率读不出什么;这一篇则给出了基线(随机序列每轮 0%),但缺了另一种对照(不回传数据的同预算组)。评测要的两种对照,各有一篇做到了一半。
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。