

预印本与基准
ChefNMR2 从一维核磁谱推出小分子结构,2031 个测试分子里 82% 排在第一
普林斯顿的 Ziyu Xiong、Ellen D. Zhong、Mohammad R. Seyedsayamdost 与 Edison Scientific 的合作者训练了一个生成模型:给它分子式和一维氢谱、碳谱的峰表,它反复抽样出候选结构,出现的频率就是置信度。在五个测试集上它比检索方法和前沿语言模型都更常把正确结构排第一;配上会推理、会查文献的智能体,它解出了四个结构此前未报道的天然产物。只解平面结构,这是预印本。
●预印本 + 基准 + 新结构
当前边界:只给平面结构、需要分子式;新结构没有晶体结构或合成确认;外部实验室的使用结果还没有
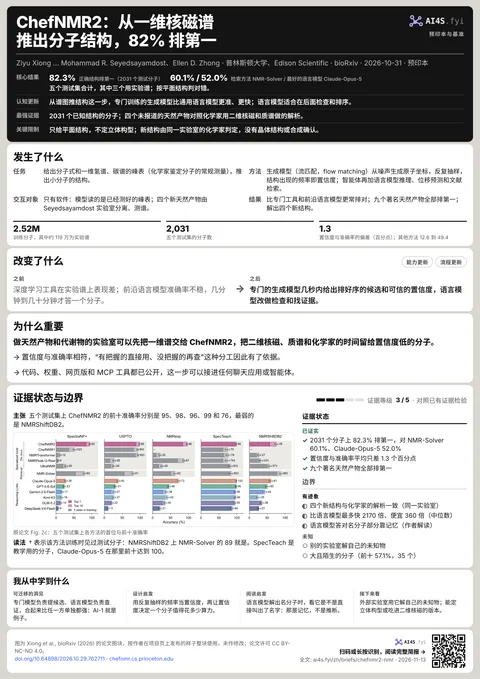
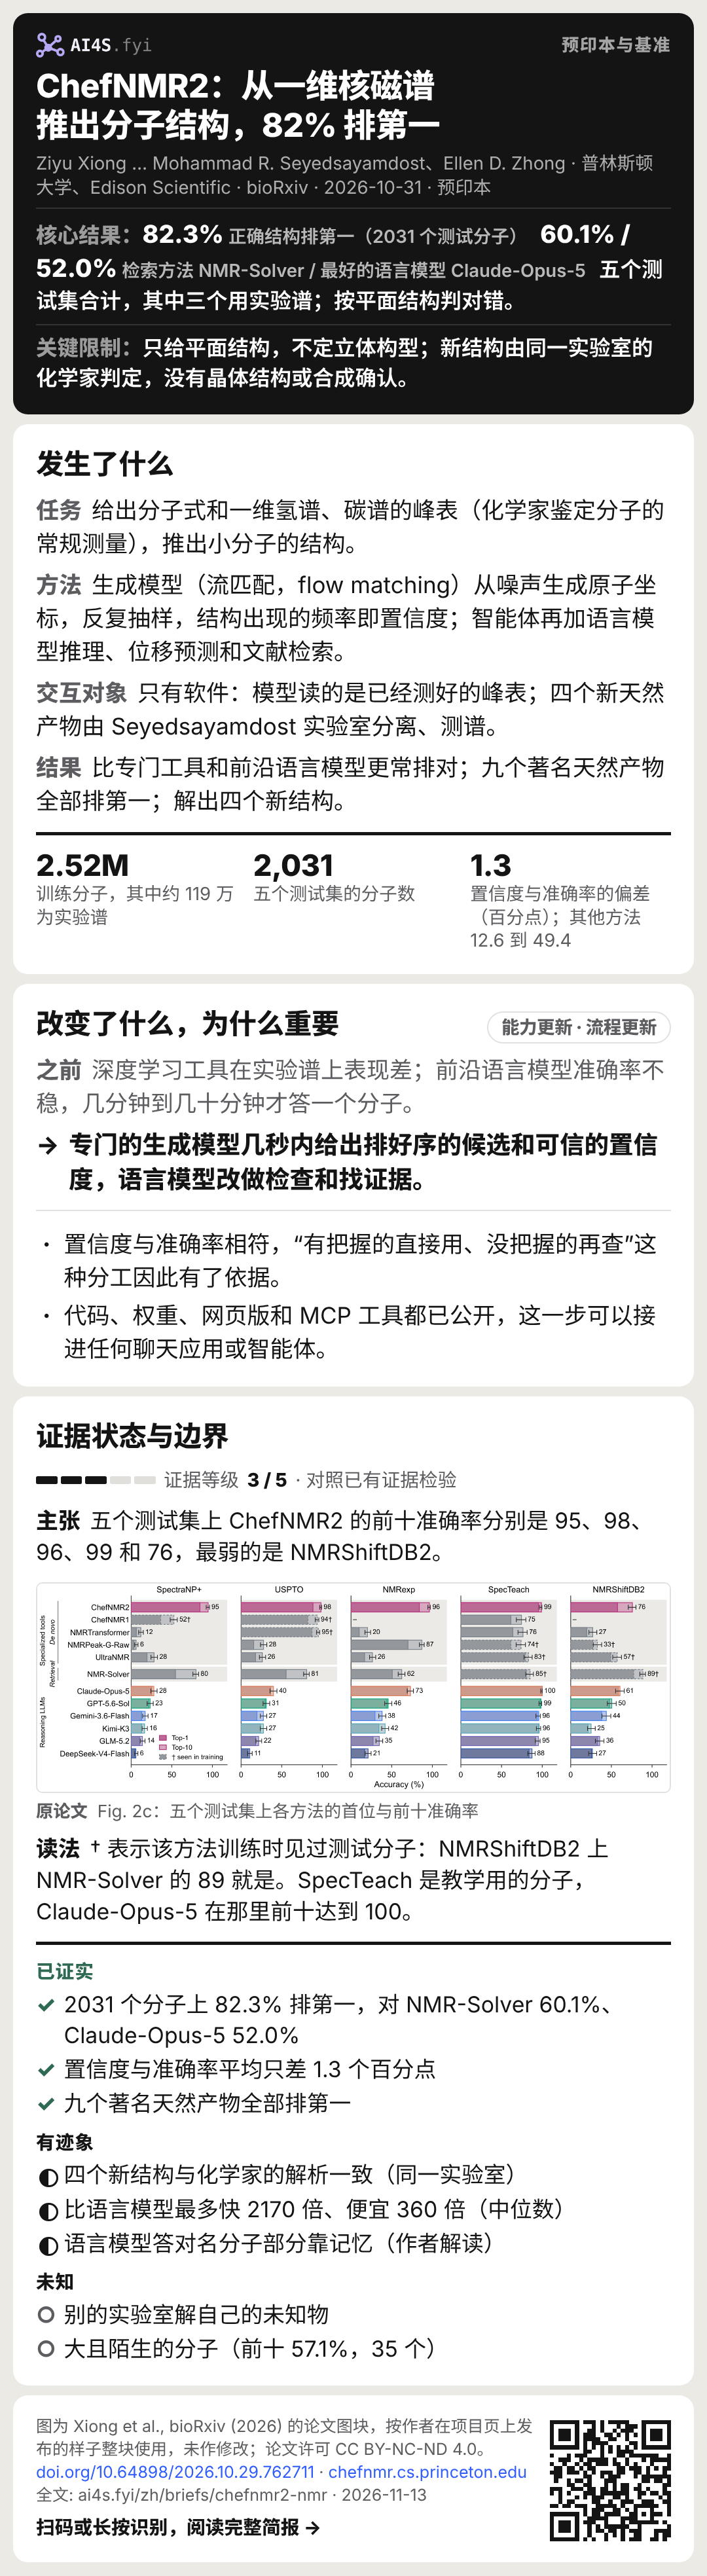
82.3%正确结构排第一(2031 个测试
60.1% / 52.0%检索方法 NMR-Solver / 最好的语言模型
五个测试集合计,其中三个用实验谱;按平面结构判
- 认知更新
- 从谱图推结构这一步,专门训练的生成模型比通用语言模型更准、更快;语言模型适合在后面检查和
排序。 - 最强证据
- 2031 个已知结构的分子;四个未报道的天然产物对照化学家用二维核磁和质谱做的
解析。 - 关键限制
- 只给平面结构,不定立体构型;新结构由同一实验室的化学家判定,没有晶体结构或合成
确认。
01发生了什么
- 任务
- 给出分子式和一维氢谱、碳谱的峰表(化学家鉴定分子的常规测量),推出小分子的
结构。 - 方法
- 生成模型(流匹配,flow matching)从噪声生成原子坐标,反复抽样,结构出现的频率即置信度;智能体再加语言模型推理、位移预测和文献
检索。 - 交互对象
- 只有软件:模型读的是已经测好的峰表;四个新天然产物由 Seyedsayamdost 实验室分离、
测谱。 - 结果
- 比专门工具和前沿语言模型更常排对;九个著名天然产物全部排第一;解出四个新
结构。
2.52M训练分子,其中约 119 万为
2,031五个测试集的
1.3置信度与准确率的偏差(百分点);其他方法 12.6
论文 2026 年 10 月 31 日挂在 bioRxiv,许可为 CC BY-NC-ND 4.0,共 12 位作者。通讯作者是普林斯顿计算机系的 Ellen D. Zhong 和化学系的 Mohammad R. Seyedsayamdost,第一作者 Ziyu Xiong;Zane Koch、Samuel G. Rodriques 和 Andrew D. White 是 Edison Scientific 的员工,这是论文唯一的利益声明。代码在 GitHub(ml-struct-bio/chefnmr2),权重在 Hugging Face,项目页还提供网页版和可接入聊天应用的 MCP
模型由一个峰表编码器和一个多模态扩散变换器组成,峰和原子在注意力里互相看见。推理时它把随机噪声变成原子坐标,再连键得到候选结构。先抽 100 个样本,按置信度决定要不要多抽:有把握的分子很快返回,没把握的多花时间。智能体(ChefNMR2-Agent)在此之上加了解析和校验峰表、调用语言模型提出候选、查数据库、枚举结构变体、预测化学位移、检索文献,最后综合证据排序并写出理由。论文里智能体运行在 Edison 的 Kosmos 平台上,底层语言模型是 Claude-Opus-5.5 和 GPT-6-Astra
训练数据共 2,524,941 个分子:NMRexp 的 1,187,838 个来自已发表论文附录里的实验峰表;SpectraNP+ 的 674,761 个天然产物(取自 COCONUT、NPAtlas、NP-MRD)和 USPTO 的 662,342 个专利分子用的是模拟谱。训练分子限定在 200 个原子以内(含氢)和一组固定
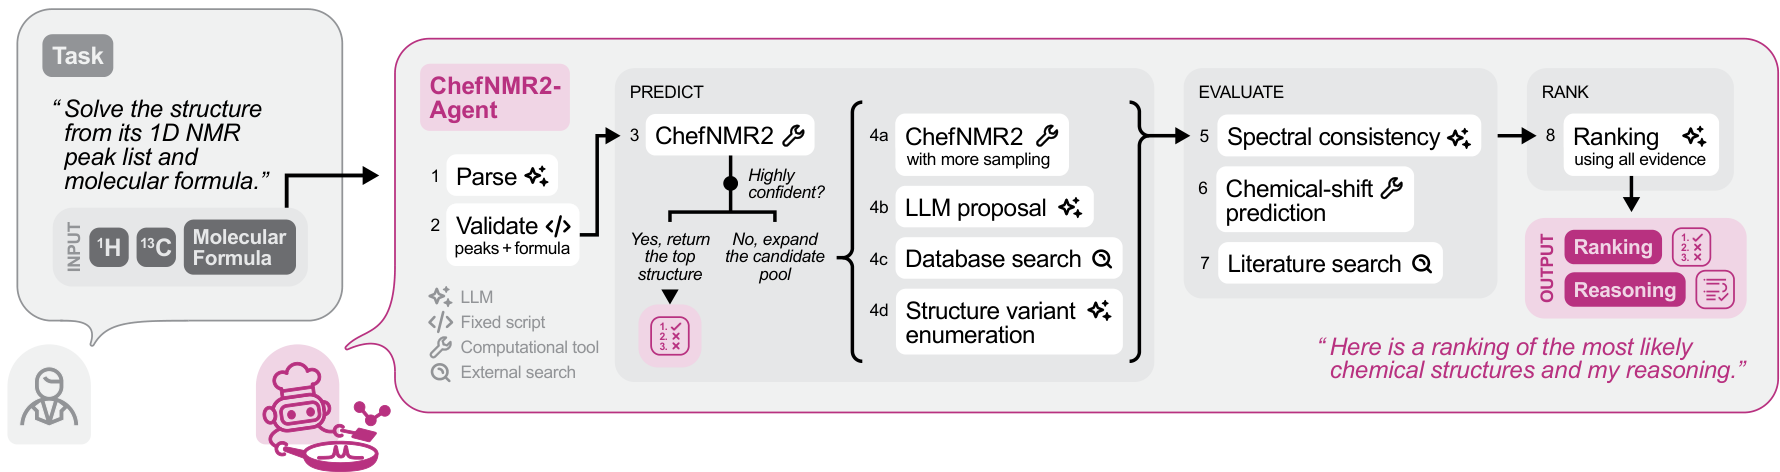
Fig. 1f:智能体先解析和校验峰表,调用 ChefNMR2;有把握就直接返回,没把握就扩大候选池(多抽样、语言模型提议、数据库检索、枚举结构变体),再用谱图一致性、化学位移预测和文献检索评估,最后综合排序并写出理由。 [S1]
02改变了什么
能力更新流程更新深度学习工具在实验谱上表现差;前沿语言模型准确率不稳,几分钟到几十分钟才答一个
专门的生成模型几秒内给出排好序的候选和可信的置信度,语言模型改做检查和找
速度和成本:快两到三个数量级
论文报告 ChefNMR2 每个分子的中位运行时间比测试的语言模型最多低 2170 倍、中位成本最多低 360 倍。ChefNMR2 和其他专门工具在 H100 上跑,按 Modal 每 GPU 小时 3.95 美元计价;语言模型按请求时长和公开的 token 价格计。论文没有写“最多”对应的是哪个
语言模型答对名气大的分子,可能是记得而不是推出来的
九个著名天然产物(青蒿素、银杏内酯 C、巨大戟醇、麦角酸、吗啡、青霉素 G、雷帕霉素、紫杉醇、万古霉素苷元)ChefNMR2 全部排第一,NMRTransformer 对三个,NMRPeak-G-Raw 一个也没对;GPT-5.6-Sol 对八个,Claude-Opus-5 对七个。作者指出语言模型每个答对的回答都叫出了化合物的名字。七个结构相近的紫杉烷类化合物上,ChefNMR2 有五个把正确结构放进前十;GPT-5.6-Sol 和 Claude-Opus-5 各对四个,每个分子要 6 到 25 分钟,而 Claude-Opus-5 认出紫杉醇只用了约一分钟。作者把这看作熟悉程度影响了语言模型的
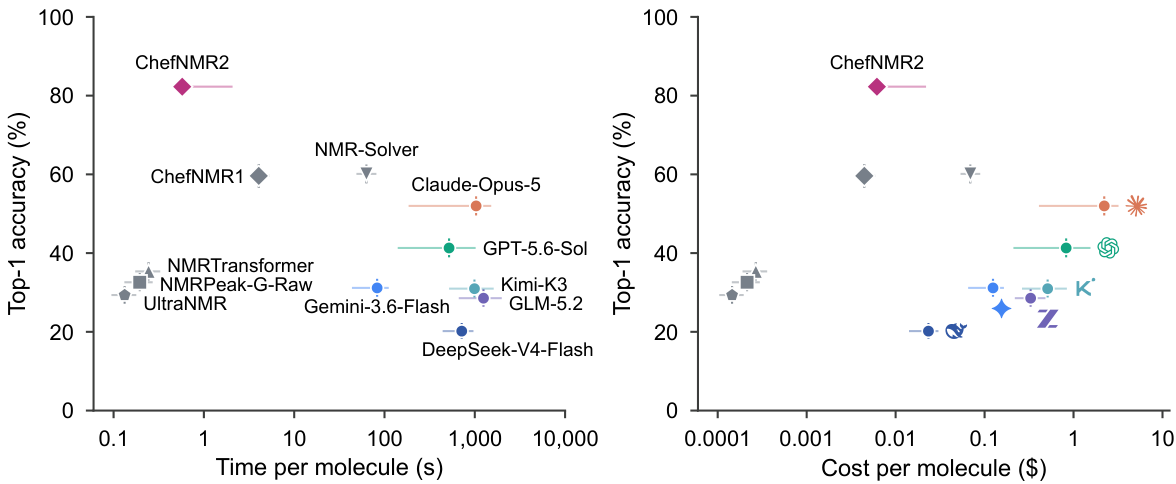
Fig. 2g、2h:横轴是每个分子的时间(秒)和成本(美元),均为对数刻度;ChefNMR2 在左上角,语言模型在右侧。 [S1]
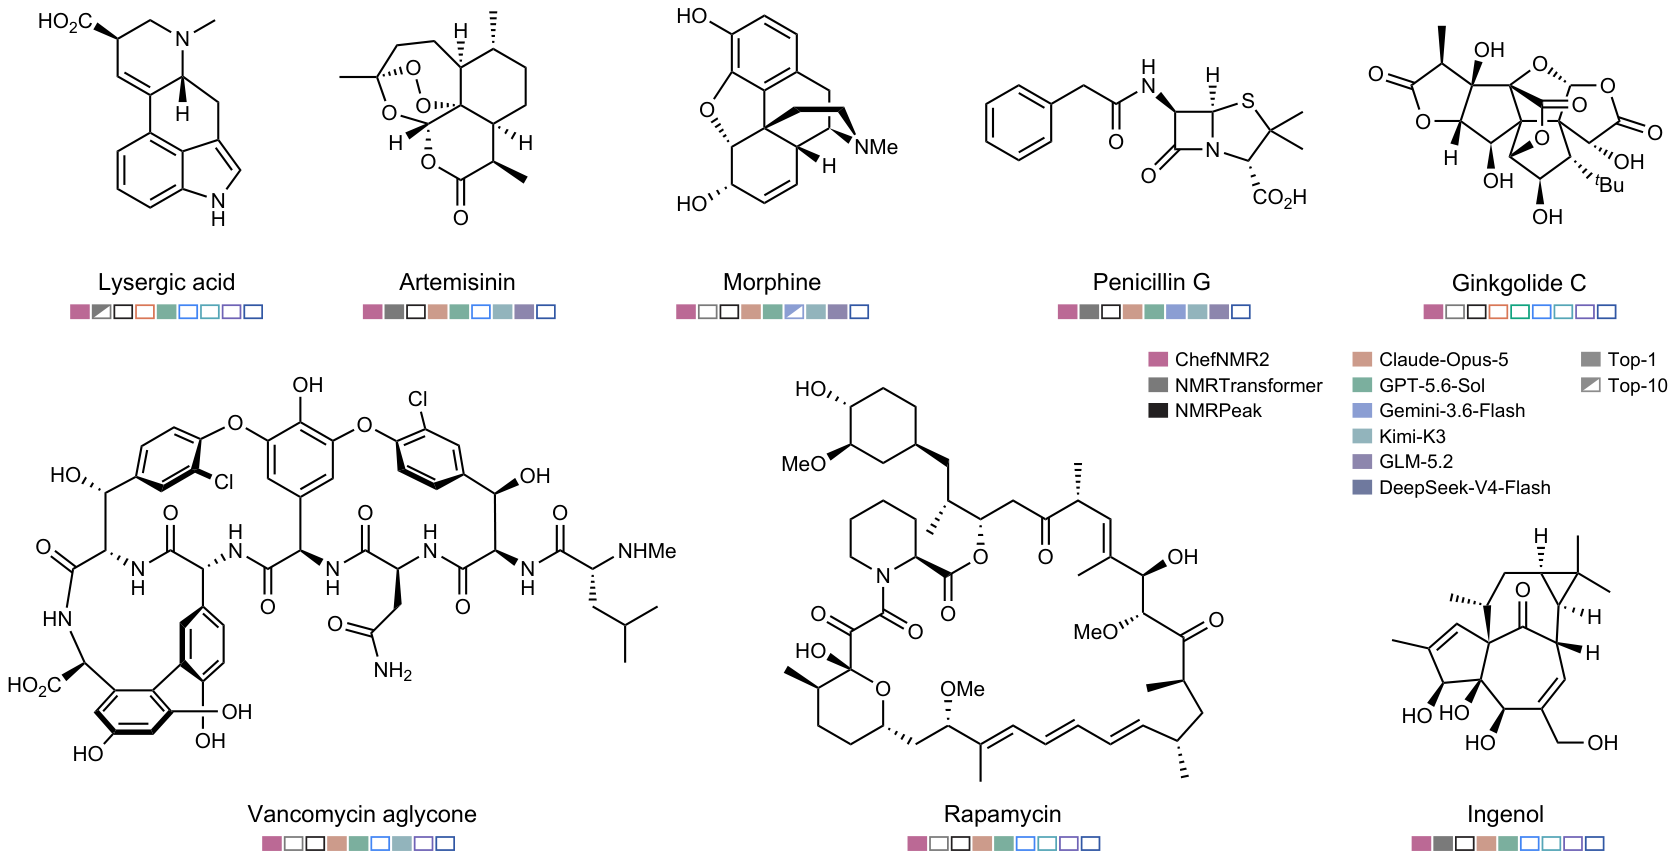
Fig. 3a:九个著名天然产物,色块标出各方法是否排第一或进前十。 [S1]
03为什么重要
做天然产物和代谢物的实验室可以先把一维谱交给 ChefNMR2,把二维核磁、质谱和化学家的时间留给置信度低的
- 置信度与准确率相符,“有把握的直接用、没把握的再查”这种分工因此有了
依据。 - 代码、权重、网页版和 MCP 工具都已公开,这一步可以接进任何聊天应用或智
能体。
04证据状态与边界
证据等级 3 / 5 · 对照已有证据检验证据状态
已证实
- 2031 个分子上 82.3% 排第一,对 NMR-Solver 60.1%、Claude-Opus-5
52.0% - 置信度与准确率平均只差 1.3 个
百分点 - 九个著名天然产物全部
排第一
边界
有迹象
- 四个新结构与化学家的解析一致(同一实
验室) - 比语言模型最多快 2170 倍、便宜 360 倍(中
位数) - 语言模型答对名分子部分靠记忆(作者
解读)
未知
- 别的实验室解自己的
未知物 - 大且陌生的分子(前十 57.1%,
35 个)
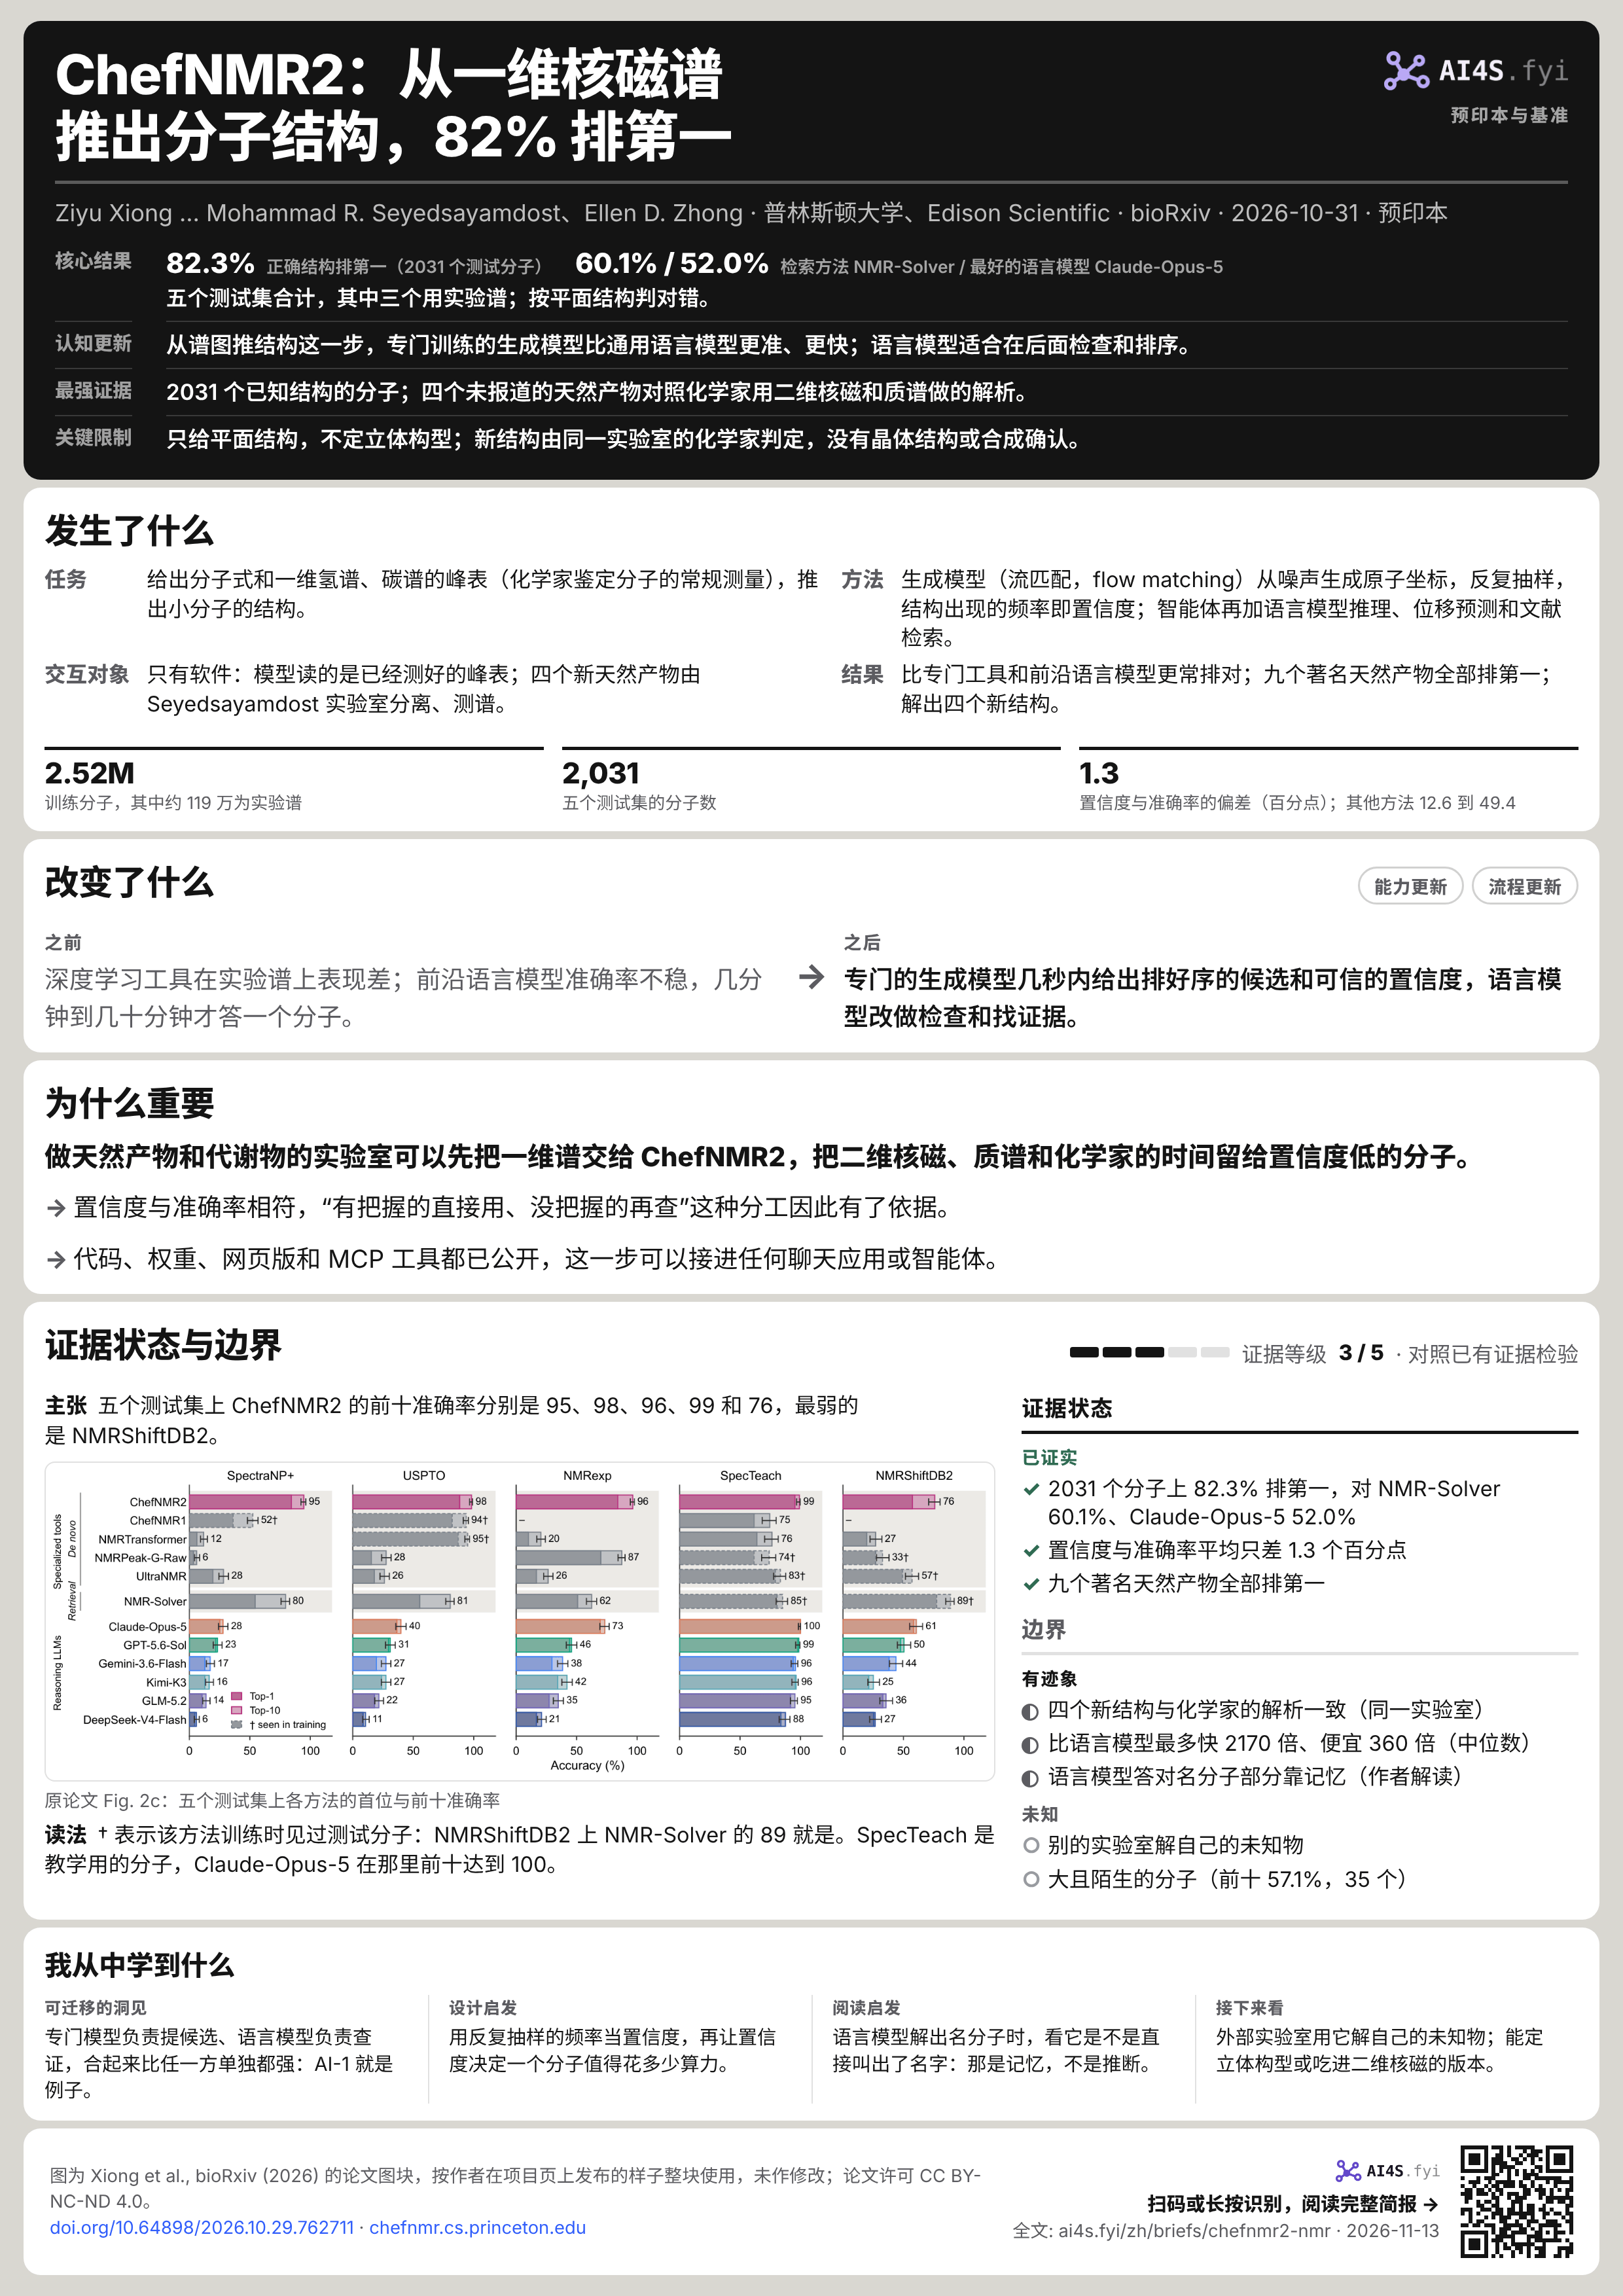
主张五个测试集上 ChefNMR2 的前十准确率分别是 95、98、96、99 和 76,最弱的是 NMRShiftDB2
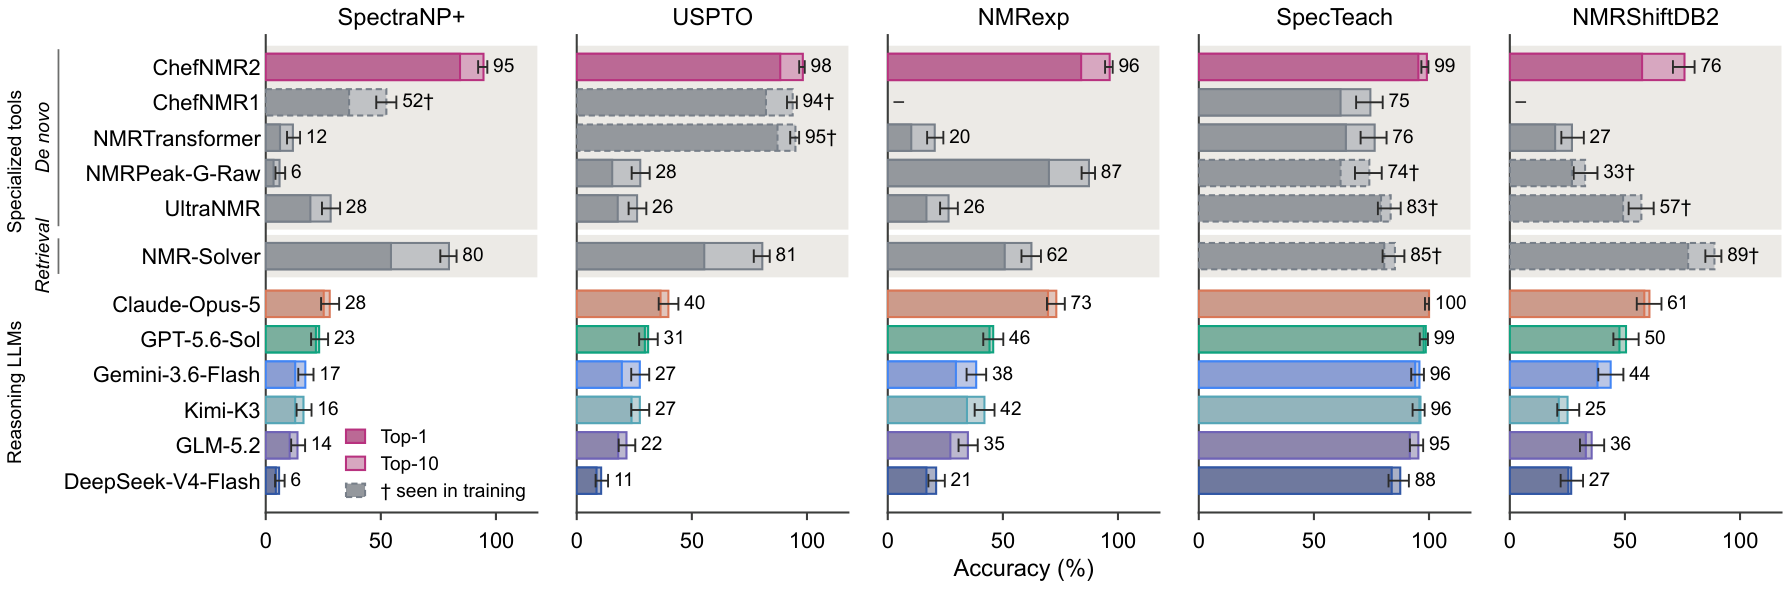
读法† 表示该方法训练时见过测试分子:NMRShiftDB2 上 NMR-Solver 的 89 就是。SpecTeach 是教学用的分子,Claude-Opus-5 在那里前十达
五个测试集。
三个各 500 个分子,取自训练数据来源的测试划分:NMRexp(实验谱)、SpectraNP+(模拟谱)、USPTO(模拟谱);SpecTeach 216 个,实验谱,峰表自动拾取;NMRShiftDB2 315 个,实验谱,峰已归属。论文正文没有逐个测试集印出首位准确率,这里只引图中印出的前十数字。按分子大小和与训练集的相似度分组,超过 30 个重原子的分子前十为 87.5%,最近训练邻居相似度低于 0.6 的为 84.8%,两者兼有的 35 个分子为
四个新天然产物是怎么判对的。
两个 nocobactin 来自 Nocardia transvalensis,两个 hybridamide 来自 Streptomyces sp. HPH0547。nocobactin AI-1 在本研究中分离(2.1 毫克),由化学家用一维和二维核磁解析;AI-2(4.5 毫克)由化学家用二维核磁和串联质谱解析,模型用的是未经人工修正的自动峰表;hybridamide A 由化学家在另一项研究中解析。论文没有描述晶体结构或合成确认。AI-1 上 ChefNMR2 单独把正确结构排在第四或第五,智能体五次运行有三次排到第一,不带 ChefNMR2 的智能体通常解不出;AI-2 上模型以 42% 的抽样频率排第一,智能体五次都保持第一;hybridamide B 上模型把一个错误的异构体排第一、正确的排在第四到第七,智能体得到了正确结构,论文没给运行
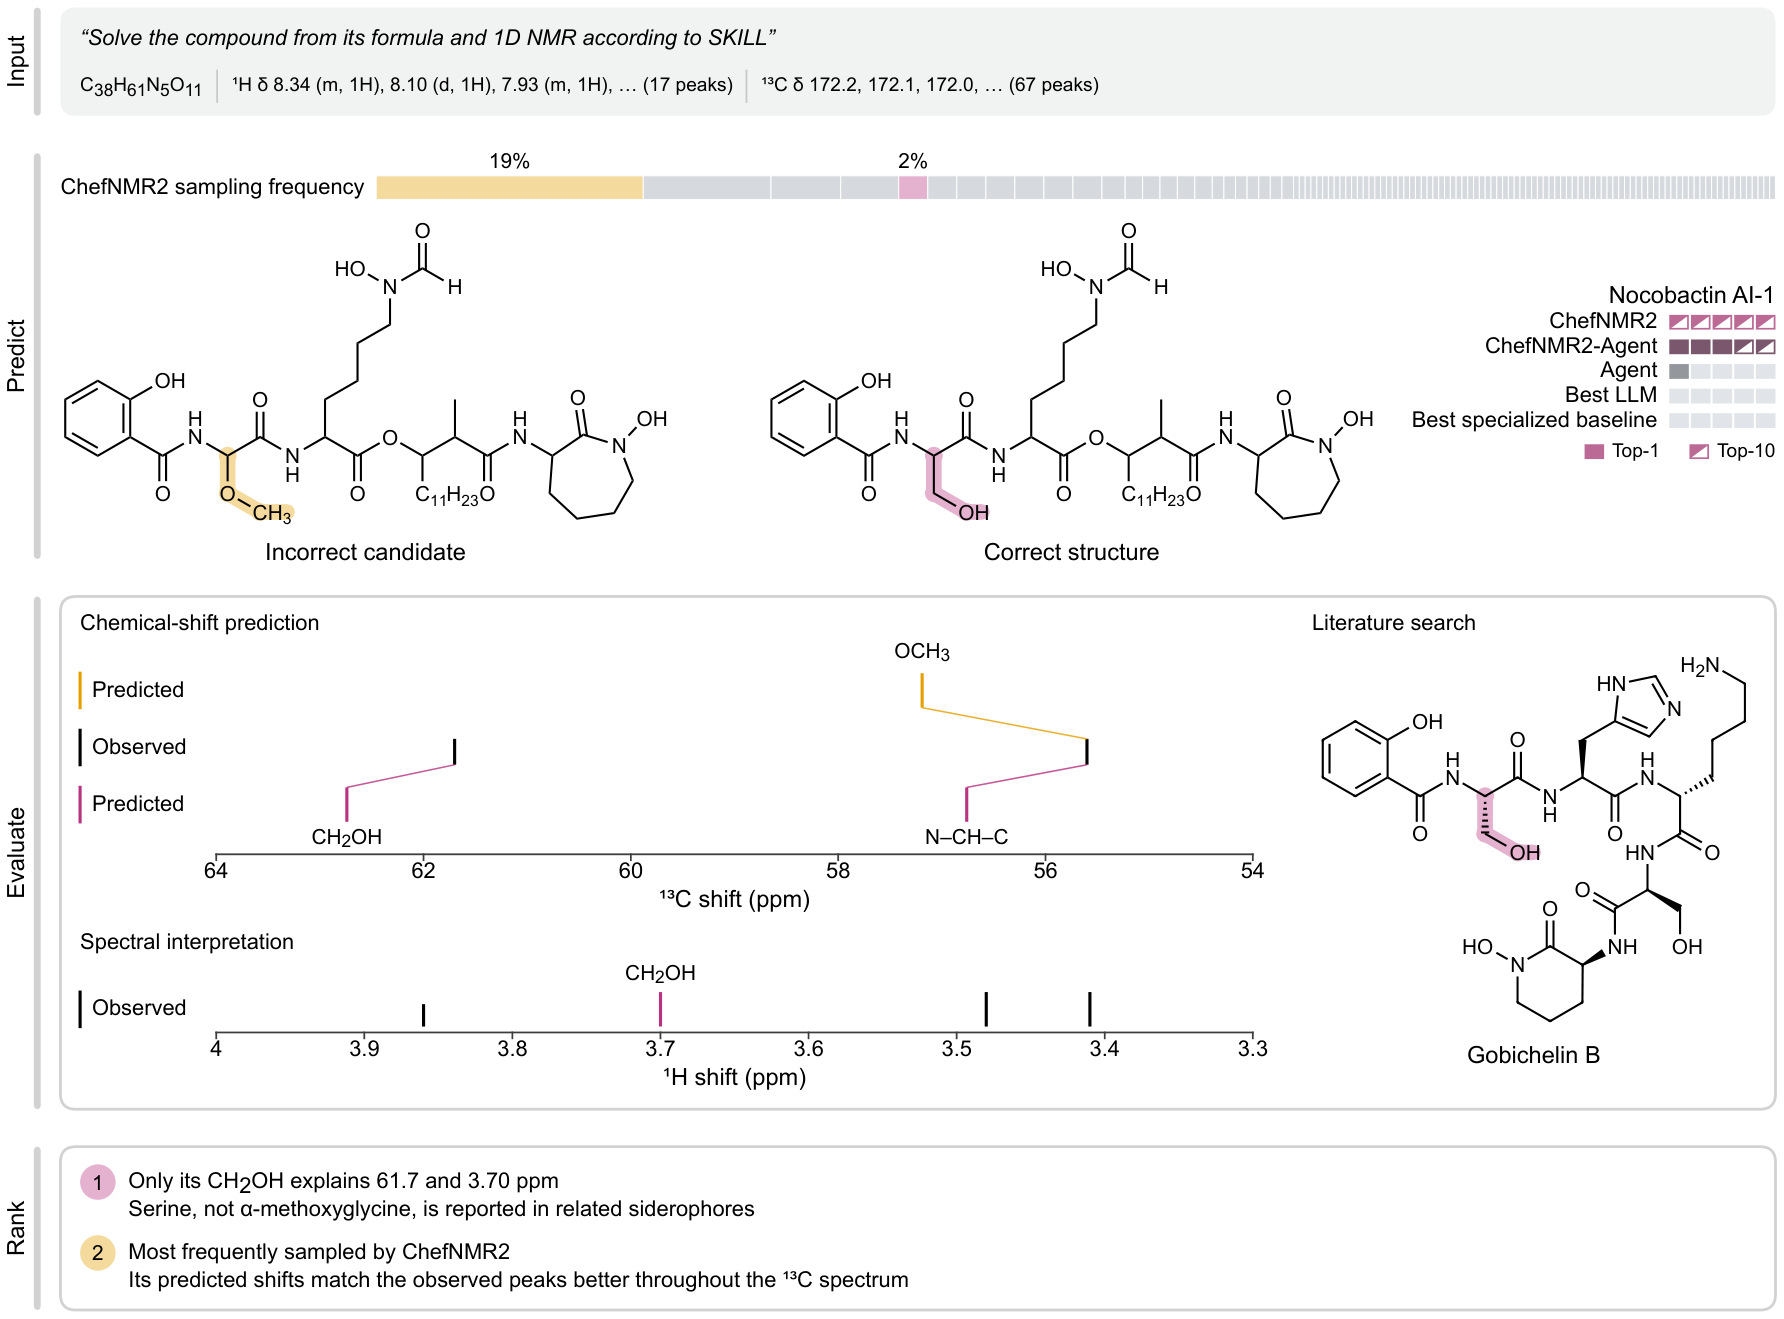
Fig. 4a:nocobactin AI-1。ChefNMR2 最常抽到的是错误候选(19%),正确结构只占 2%;智能体用化学位移预测、谱图解读和文献里的相关铁载体把它排到第一。 [S1]
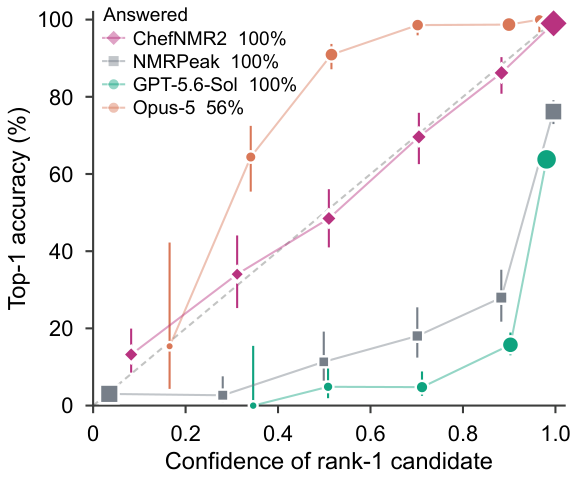
Fig. 2f:横轴是首位候选的置信度,纵轴是实际准确率;ChefNMR2 的曲线贴着对角线。图例里的百分比是各方法给出答案的比例,Opus-5 为 56%。 [S1]
05我从中学到什么
- 可迁移的洞见
- 专门模型负责提候选、语言模型负责查证,合起来比任一方单独都强:AI-1 就是
例子。 - 设计启发
- 用反复抽样的频率当置信度,再让置信度决定一个分子值得花多少
算力。 - 阅读启发
- 语言模型解出名分子时,看它是不是直接叫出了名字:那是记忆,不是
推断。 - 接下来看
- 外部实验室用它解自己的未知物;能定立体构型或吃进二维核磁的
版本。
作者自己写下的边界
讨论部分写明:模型需要分子式作为辅助输入;只预测平面结构,不定立体构型,因为一维核磁一般不足以区分立体异构体;要用上更多信息,需要更丰富的实验数据重新训练;化学家可以再用串联质谱或二维核磁在排前的几个结构里挑。论文还说明,四个基准分子(两个紫杉烷、紫杉醇和青霉素 G)以模拟谱的形式出现在训练数据里,但没有一个基准分子以测试用的谱图被模型
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。