

论文解读
ChronoSyn:把材料被发现的先后顺序当作可合成性的监督信号
Park 与 Walsh 让一个只看组成的可合成性模型同时学会给已知材料按首次报道年份排序。打乱年份的对照说明,大部分收益来自顺序本身;检验全部在已有数据库上完成。
◐预印本 + 对照已有实验记录检验
当前边界:组成层面、在已有数据库上的收益有对照支持;能否帮实验室更快做出新材料、会不会压低冷门化学体系的分数,都还没有检验
0.470 → 0.524留出测试中找回的已报道材料比例
0.484年份打乱后的同一模型
约 1 万个留出的已报道组成上,三者阈值相同,随机为 0.081;打乱年份只多出 0.014。
- 认知更新
- 材料被报道的先后顺序本身带有可合成性的信息,可以当作免费的额外标签。
- 最强证据
- 只用截至 2018 年的材料训练,前 100 名里有 7 个后来被报道,基线 3 个。
- 关键限制
- 作者说,学历史可能偏向已被研究的化学,压低冷门体系;没有合成任何新材料。
01发生了什么
- 任务
- 只看化学式,判断一种假想材料能否做出来。
- 方法
- 给 Jang 等 2024 年的模型加一个输出,按首次报道年份给已知材料排序。
- 交互对象
- 只有数据库:Materials Project、OQMD 和 ICSD 的实验记录,没有合成。
- 结果
- 找回基线漏掉的 1,021 个留出材料,丢掉 468 个,净增 553 个。
2026 年 10 月 26 日,帝国理工学院材料系的 Junkil Park 和 Aron Walsh 在 arXiv 上发布 ChronoSyn。论文只署帝国理工一个单位。Walsh 自 2026 年 1 月起兼任材料 AI 公司 CuspAI 的首席科学官,但论文没有提到 CuspAI。[S1][S4]
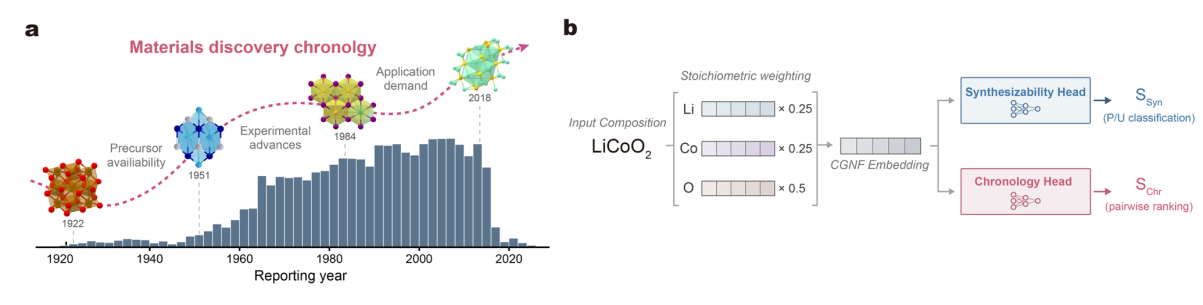
可合成性预测通常用正例-无标签学习:在 ICSD 里有实验报道的组成算正例,其余算无标签,因为其中可能藏着还没人做出来的材料。ChronoSyn 沿用 Jang 等 2024 年在 Matter 上发表的组成模型:把组成编码成 90 维特征,经五层全连接网络,一个输出头区分正例和无标签。新加的第二个输出头只在正例之间训练,学习谁比谁更早被报道,用的是成对排序损失。两部分损失相加,排序部分权重为 3。[S1][S2]
训练数据有两套。只用 Materials Project 的一套有 104,837 个组成(51,010 个正例);加入 OQMD 后有 408,638 个(51,651 个正例)。每个正例取其 ICSD 条目里最早的发表年份,范围从 1905 年到 2024 年。ICSD 用的是 2025 年 7 月的快照;2020 年代的正例数量骤降,作者认为是数据库覆盖滞后,而不是发现变少。每个模型是 100 个子模型的集成,训练与测试按 80/20 划分。[S1]
02改变了什么
证据更新架构更新已报道的材料被当作一堆同等的正例,什么时候被发现的信息被丢掉。
首次报道的年份成了额外的训练信号,模型借此区分研究成熟的化学区域和正在兴起的区域。
对照是这篇论文的关键
多加一个输出头,本身就可能让网络学得更好,与年份无关。作者因此训练了两个结构完全相同的对照:一个把训练正例的年份随机打乱,一个改为按平均原子质量排序。只用 Materials Project 时,找回比例分别是:基线 0.470,ChronoSyn 0.524,打乱年份 0.484,原子质量 0.466;加入 OQMD 后为 0.831、0.873、0.844、0.838。打乱年份自己就比基线多出 0.014,所以真正归于年份顺序的约是 0.040。测试集约有 1 万个正例,标准误小于 0.005,ChronoSyn 与基线之差的 McNemar 检验 p 小于 10⁻⁴⁶。[S1]
这里的比例是在正例-无标签设定下校准过的:阈值定在让 8.1% 的无标签组成被判为可合成,这样各模型在同一个预测比例下比较,找回比例与估计的精确率几乎相同,随机分类器为 0.081。作者把 8.1% 换成 1% 到 50% 之间的其他值重算,ChronoSyn 在整个范围内都最高。[S1]
基线漏掉、ChronoSyn 找回的测试正例有 1,021 个,反方向有 468 个,净增 553 个。被找回的组成里含 f 区元素的比例比没被找回的高 15.5 个百分点,是其他元素类别的两倍多。作者把这归于稀土永磁、铜氧化物超导体和庞磁阻锰氧化物这类家族的报道集中在一段时期,顺序信息因此更有用。[S1]
03为什么重要
生成模型提出的候选远多于实验室能做的,先做哪个?
- 可合成性模型决定实验预算花在哪:多找回 5 个多百分点,就是同样预算下少做一些白工。
- 历史数据里还有被扔掉的信号:年份不要钱,任何用 ICSD 的模型都能加。
论文开头的判断是:高通量计算和生成模型提出候选材料的速度,已经远超实验室能合成的速度,所以找出哪些假想材料能被做出来变得越来越重要。Walsh 参与的、由弗里茨·哈伯研究所主导的一项 2025 年工作估计,GNoME 公开的 55 万多个组成里有 80%-84% 很可能形成无序结构,与数据库里写的有序晶体不同。两项工作都在回答同一个问题:大批预测出来的材料里,哪些值得进实验室。[S1][S3]
作者认为这个思路不限于组成模型:年代排序目标可以直接加到基于结构的可合成性模型或基于大语言模型的方法上,也可能用到药物发现和催化这类同样有长发现记录的领域。论文附录里与一个大语言模型方法做了粗略比较,ChronoSyn 精确率更高,但作者称两者是互补而非竞争。[S1]
04证据状态与边界
证据等级 3 / 5 · 对照已有证据检验证据状态
已证实
- 两套数据上都胜过基线
- 打乱年份和原子质量两种对照都低于 ChronoSyn
- MP 外 1,990 个已报道三元组成:找回 867 对 795
边界
有迹象
- 收益来自年份顺序本身(据打乱年份对照推断)
未知
- 按它的排序去合成,命中率是否更高
- 会不会压低从未被研究过的化学体系
- 加入晶体结构后是否还有收益
主张只学截至截止年的材料,也能把后来被报道的材料排到前面。
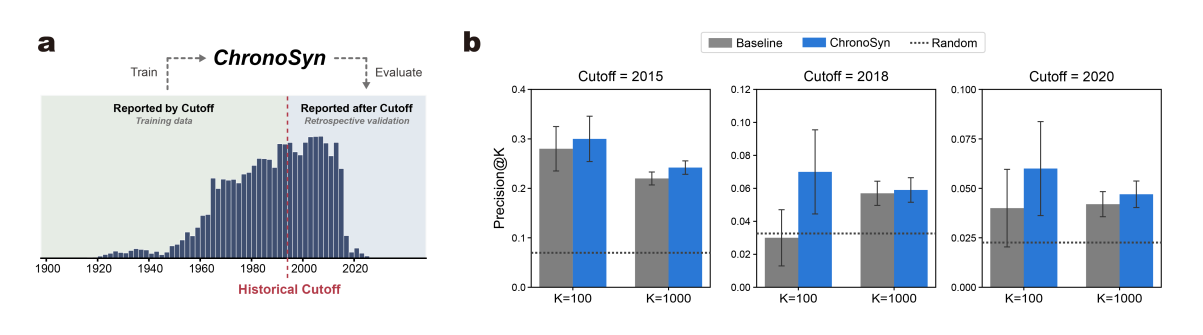
读法每个截止年、每种名单长度都高于基线。2018 年、前 100 名:ChronoSyn 0.07,基线 0.03,随机 0.033;作者说前 100 名的差距统计不确定性更大。
回溯测试最接近真实用途,但差距主要在最前面。
作者分别以 2015、2018、2020 年为截止,只用截至截止年报道的材料训练两个输出头,再看模型能否把截止后报道的组成排到前面。候选池是截止后报道的正例(分别 807、363、249 个)加上固定的 10,765 个留出无标签组成。ChronoSyn 在三个截止年和前 100、前 1000 两种名单长度上都高于基线,也都高于随机。作者说,相对差距最大的是较晚截止年的前 100 名,但统计不确定性也更大。2018 年前 100 名是论文给出数字的例子:基线 0.03,与随机的 0.033 相当,ChronoSyn 0.07,也就是 7 个对 3 个。[S1]
在数据库之外打分时,有一组独立的参照。
作者按 Park、Onwuli、Butler 与 Walsh 2025 年的框架,枚举 89 种元素的二元和三元组成,约 5000 万个,用电荷中性检验和是否在 Materials Project 里分成四类,其中符合电荷中性但不在 MP 里的称为 Missing(二元 7,485 个,三元 8,037,364 个)。Missing 里有 101 个二元和 1,990 个三元组成其实在 ICSD 有实验报道,作为参照集:ChronoSyn 找回 38 个和 867 个,基线 32 个和 795 个。作者注明,ChronoSyn 判为可合成的三元组成总体略多(22.4% 对 21.1%),可能解释部分差距;把阈值调到同样的比例,仍是 826 对 795。[S1]
作者列出的三条局限。
一,报道年份只是发现时间的替代指标,未必是材料第一次被合成或被认识的时间。二,年代信号反映了推动实验的实际因素,但也可能让 ChronoSyn 偏向历来受关注的化学空间,给关注少的区域里化学上可行的组成打低分,限制它发现全新材料类别的能力。三,模型只看组成,不考虑多晶型,而结构往往决定一种材料能不能做出来。[S1]
05我从中学到什么
- 可迁移的洞见
- 数据库里每条记录的时间戳也是数据:发现的顺序记录了哪些材料先变得可以做出来。
- 设计启发
- 加辅助任务时,配一个打乱标签的对照,才能分清收益来自信息还是来自多出的任务。
- 阅读启发
- 看可合成性论文,先问检验名单有多长:这里相对差距最大的是前 100 名。
- 接下来看
- 按 ChronoSyn 排序挑候选去合成的实验,尤其是冷门化学体系里的命中率。
免费的标签往往就在元数据里
ChronoSyn 没有用任何新测量,只是把 ICSD 条目里已有的发表年份拿来当监督信号。任何建立在长期积累的实验数据库上的模型,都可以先问一句:记录的时间、来源或更正历史里,有没有被扔掉的信息。
学历史的模型会继承历史的偏向
作者自己点出的第二条局限,正是这种方法的代价:如果顺序记录的是研究者的注意力流向,那么模型学到的部分是“什么会被研究”,而不只是“什么能被做出来”。要分开两者,需要在冷门化学体系里做前瞻性的合成实验。
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。