

案例研究与硬件实测· 科学证据 · Frontier
Codex 参与真实量子芯片校准:一次公开运行说明了什么
MIT EQuS 的一位研究者把接入 Codex 的 GPT-5.6 Sol 接进实验室的控制软件,由模型自己选参数、跑测量、拟合数据、决定下一步。文章称,信号清晰时它能跑完一套标准测量;信号弱或噪声大时,仍然离不开研究者。公开的证据是一篇 OpenAI 案例文章,和一次运行里一个比特上两个步骤的节选。
○厂商案例文章 + 真实硬件运行节选
当前边界:模型在真实芯片上自选参数、执行并拟合的 Rabi 和 Ramsey 测量,有数据为证;运行次数、成功率、介入率,以及与研究者相比的耗时和质量,都没有公开
这项工作推进的是:让模型经 Codex 在真实超导芯片上自己选参数、跑测量、拟合数据并决定下一步
- MODEL理解 / 预测
- DECIDE选择下一步
- INTERACT测试现实
- UPDATE改变下一轮
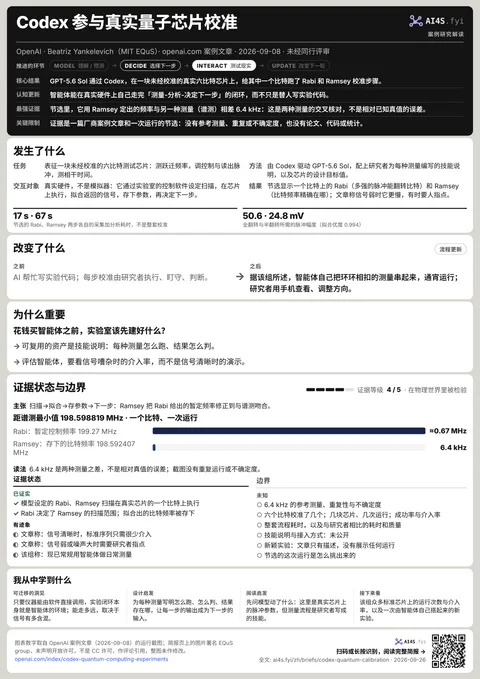
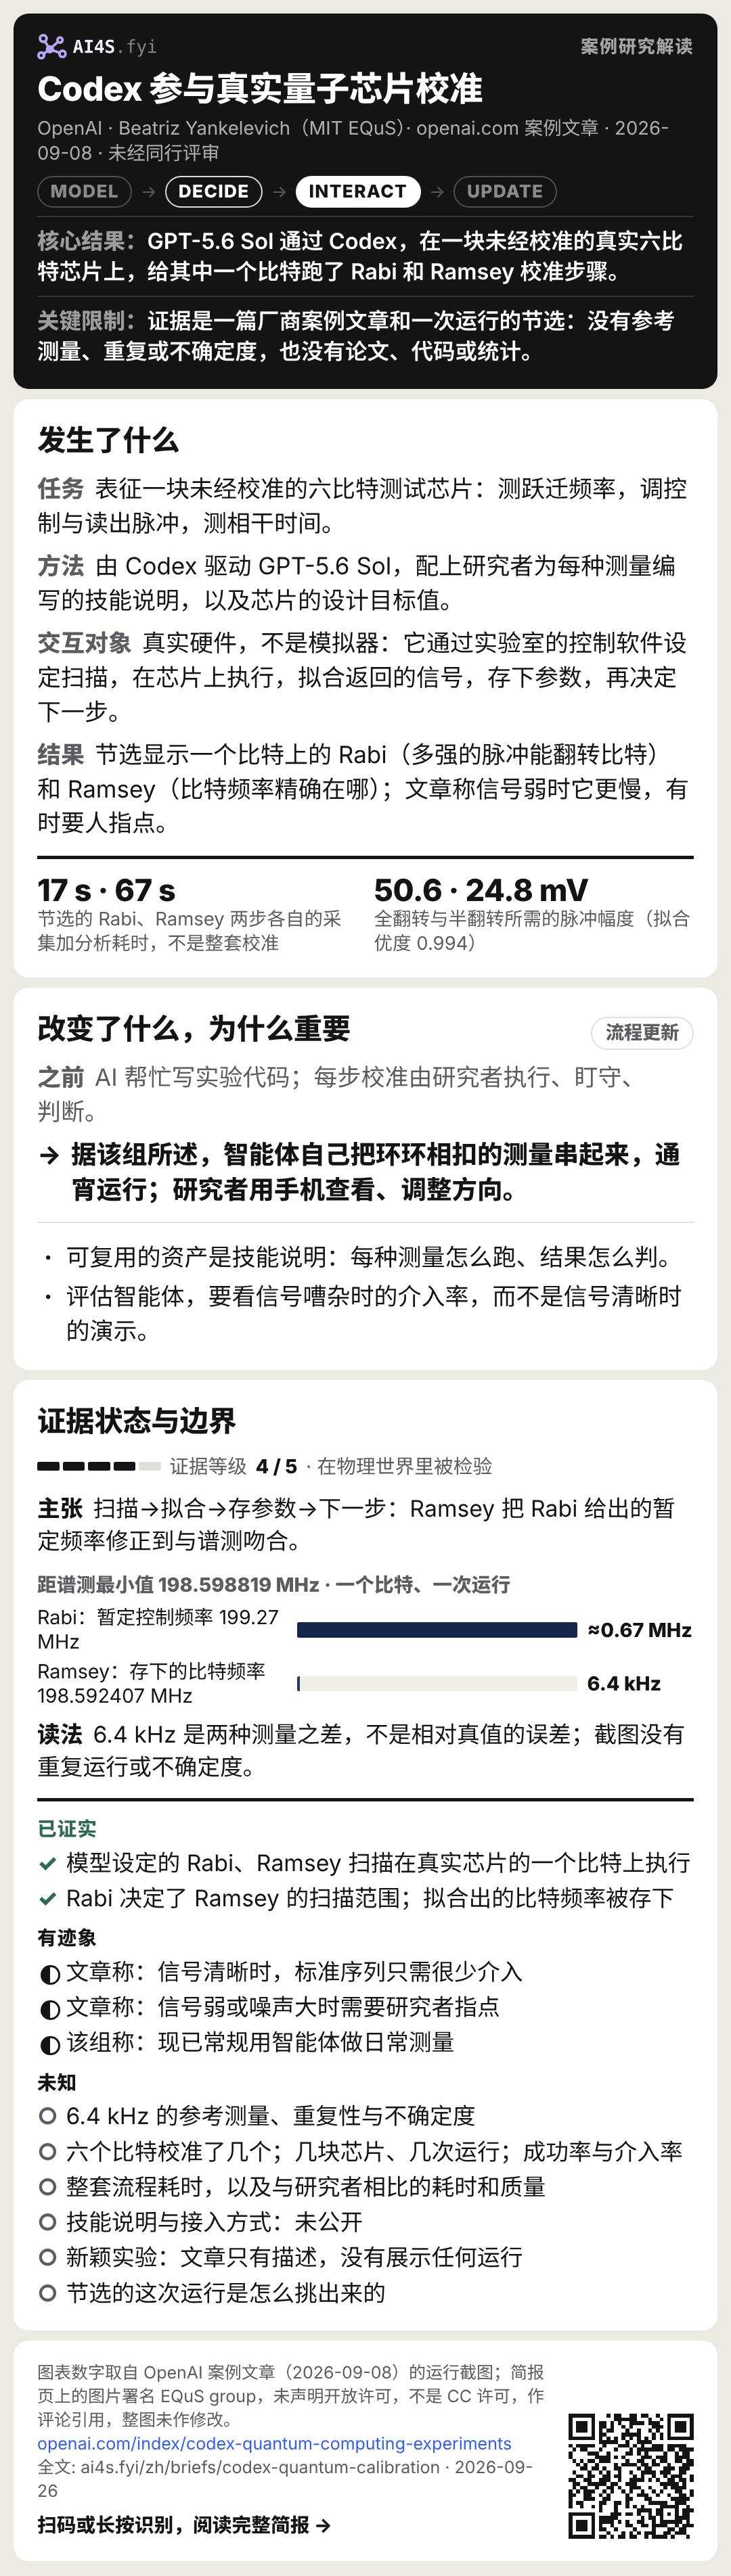
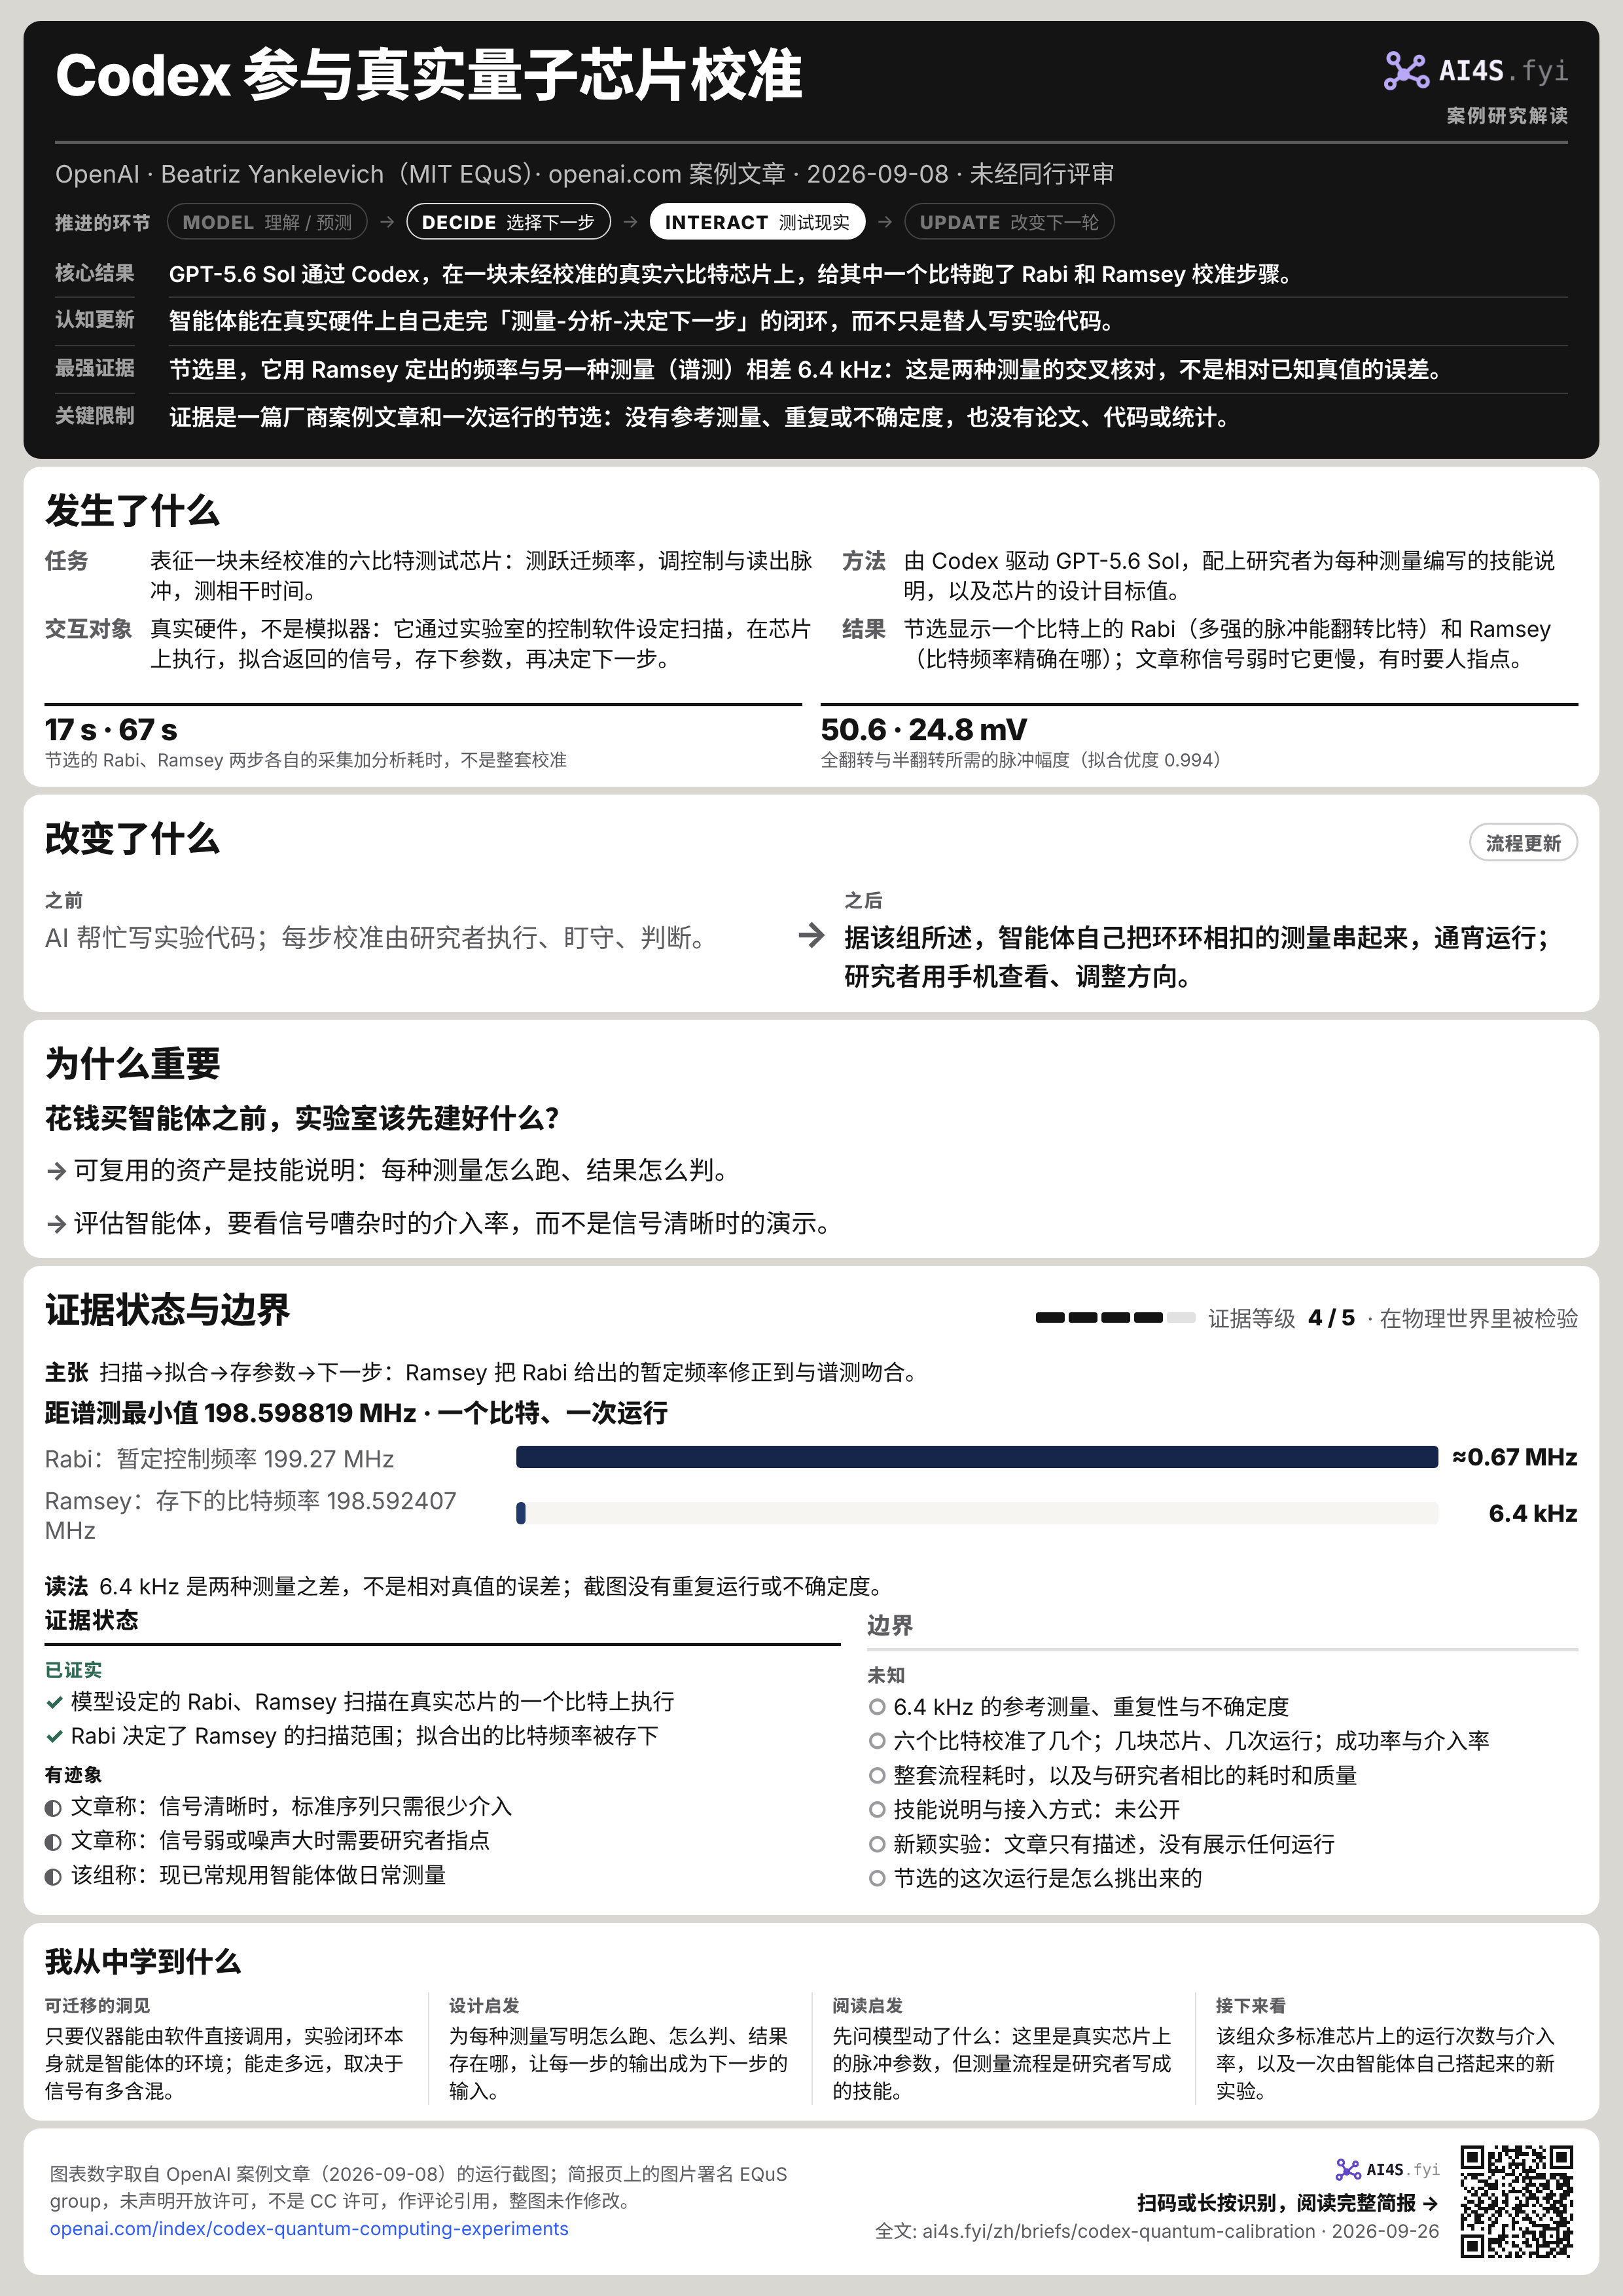
GPT-5.6 Sol 通过 Codex,在一块未经校准的真实六比特芯片上,给其中一个比特跑了 Rabi 和 Ramsey 校准步骤。
- 认知更新
- 智能体能在真实硬件上自己走完「测量-分析-决定下一步」的闭环,而不只是替人写实验代码。
- 最强证据
- 节选里,它用 Ramsey 定出的频率与另一种测量(谱测)相差 6.4 kHz:这是两种测量的交叉核对,不是相对已知真值的误差。
- 关键限制
- 证据是一篇厂商案例文章和一次运行的节选:没有参考测量、重复或不确定度,也没有论文、代码或统计。
01发生了什么
- 任务
- 表征一块未经校准的六比特测试芯片:测跃迁频率,调控制与读出脉冲,测相干时间。
- 方法
- 由 Codex 驱动 GPT-5.6 Sol,配上研究者为每种测量编写的技能说明,以及芯片的设计目标值。
- 交互对象
- 真实硬件,不是模拟器:它通过实验室的控制软件设定扫描,在芯片上执行,拟合返回的信号,存下参数,再决定下一步。
- 结果
- 节选显示一个比特上的 Rabi(多强的脉冲能翻转比特)和 Ramsey(比特频率精确在哪);文章称信号弱时它更慢,有时要人指点。
17 s · 67 s节选的 Rabi、Ramsey 两步各自的采集加分析耗时,不是整套校准
50.6 · 24.8 mV全翻转与半翻转所需的脉冲幅度(拟合优度 0.994)
2026 年 9 月 8 日,OpenAI 发布了一篇案例文章:MIT 工程量子系统组(EQuS)的研究生 Beatriz Yankelevich,把接入 Codex 的 GPT-5.6 Sol 用进了自己的实验流程。EQuS 研究的是超导量子比特:芯片放在稀释制冷机里冷却到接近绝对零度,再用微波信号来控制。[S1]
文章的出发点是:芯片一旦制造、封装、冷却完毕,研究者就完全通过软件和它打交道。把 Codex 接进统筹实验的实验室软件之后,它就能运行测量、分析结果,并决定下一步试什么。[S1]
模型实际操作了什么
测试对象是一块未经校准的六比特芯片,是 EQuS 平时用来检验制造工艺的标准型号。Yankelevich 按测量类型给 Codex 写了技能说明,讲清每个实验怎么跑、怎么评估。GPT-5.6 Sol 依据这些技能和芯片的设计目标,自己选测量参数、操作硬件、分析数据,然后要么把这次测量做得更细,要么把结果存下来留给下一次测量。[S1]
两种测量先说明一下:Rabi 测量逐步加大驱动脉冲的幅度,回答「多强的脉冲能把比特从 0 翻到 1」,由此定出 π 脉冲和 π/2 脉冲的幅度;Ramsey 测量在两个 π/2 脉冲之间插入可变的等待时间,回答「比特的频率精确地落在哪里」。文章附的运行截图能看出这种交互细到什么程度:模型通过 Jupyter 集成下发一次 0–0.4 V 的一维 Rabi 扫描,拟合出 Xπ 幅度 50.6 mV、Xπ/2 幅度 24.8 mV(R² 0.994);Rabi chevron 给出的驱动中心 199.27 MHz 比半磁通点谱测最小值高约 0.67 MHz,它据此把 Ramsey 失谐范围放宽到 ±2 MHz,按 4 ns 的硬件时间网格、开启主动复位完成测量,存下裸跃迁频率 f01 = 198.592407 MHz。两步分别标注采集加分析 17 s 和 67 s、token 消耗约 1k(模型自估)。换句话说,模型设定的是真实芯片上的扫描范围和脉冲幅度,读回的是实测信号,不是模拟器的输出。[S1]
边界也正在这里:测量类型本身(Rabi、Ramsey、谱测、相干时间)都是标准流程,怎么跑、怎么评估,由研究者写进了技能说明。模型做的是在这些流程之内选参数、判读结果、接上下一步;文章并没有说它设计了新的脉冲序列或新的实验。[S1]
信号清晰时能跑完,信号弱时还要人
信号清晰时,Codex 只需研究者少量介入,就完成了一套标准测量序列:找出比特的跃迁频率,校准控制和读出用的脉冲,并测定比特能把量子信息保持多久。信号弱或噪声大时,它要花更长时间才能找到合适的测量参数,有时还得靠有经验的研究者指点。文章的结论是:眼下的智能体能处理定义清楚的实验流程,但解读含混的物理结果仍是难题。[S1]
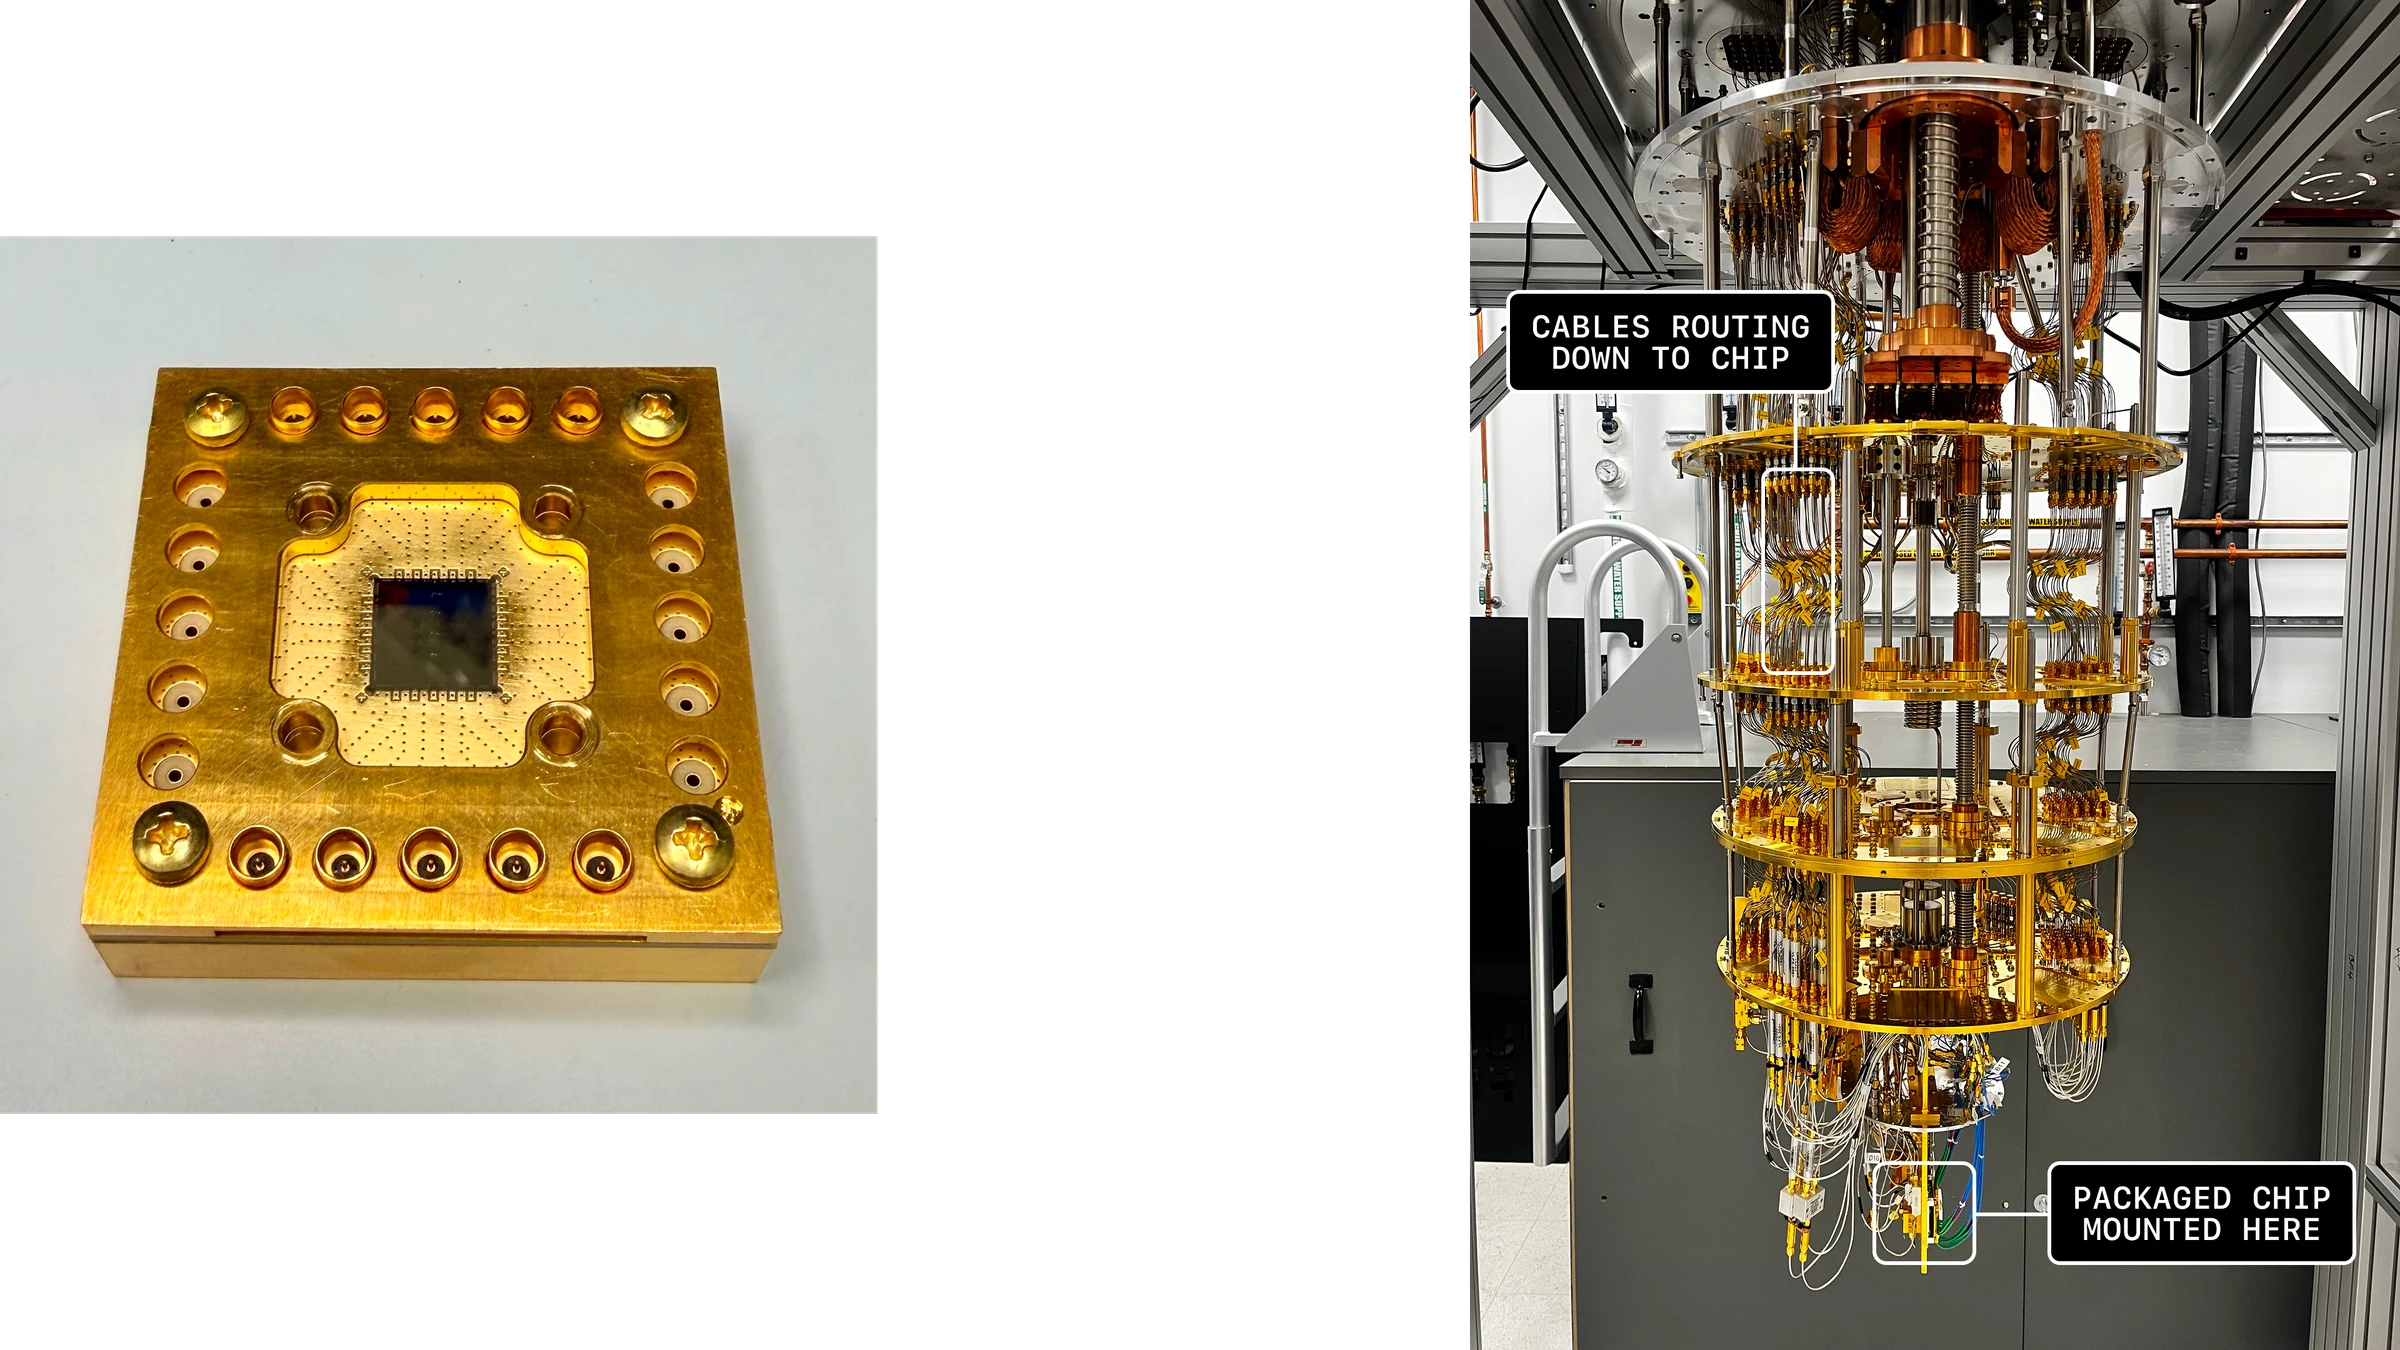
封装好的芯片(左)与打开的稀释制冷机(右)。照片证明的是设备环境,不是这次运行的证据,所以 A4 海报上不放它,把位置留给截图里的实测数字。图片出自 OpenAI 案例文章,署名 EQuS group;未声明开放许可,此处作评论引用,整图未作修改。 [S1]
02改变了什么
流程更新AI 帮忙写实验代码;每步校准由研究者执行、盯守、判断。
据该组所述,智能体自己把环环相扣的测量串起来,通宵运行;研究者用手机查看、调整方向。
文章把量子比特校准描述成一串环环相扣的测量,每个结果都决定下一步做什么;比特参数可能漂移,意料之外的物理行为会让结果前后不一致,有经验的研究者能看出来并随之调整。软件控制、重复测量加上自适应决策,三者叠在一起,使它成了适合交给智能体的场景。准备并运行量子比特实验可能要花几个月,做几百到几千次预备测量。[S1]
EQuS 制造了大量这种标准芯片,每一块都可能要研究者花好几天来表征。文章称,这个组现在经常让智能体做日常测量。用 Yankelevich 的话说:「我可以让智能体在夜里,或者在我去洁净室干活的时候,连着跑好几个小时的测量。我用手机就能查看它们做了什么,哪里需要修正、或者我想换个方向时,就去引导一下。」[S1]
文章也承认,有经验的研究者找到最佳校准设置,可能仍比现在的模型快;收益是省下了盯守每一步的时间,而不是校准得更好。[S1]
03为什么重要
花钱买智能体之前,实验室该先建好什么?
- 可复用的资产是技能说明:每种测量怎么跑、结果怎么判。
- 评估智能体,要看信号嘈杂时的介入率,而不是信号清晰时的演示。
Yankelevich 说,她「搭了一套基础设施,引导智能体完成工作中的好几块:测量、理论和芯片设计,现在真的开始见效了」。这个案例里出力的不只是模型:按测量类型写好的技能说明、芯片的设计目标,再加上一个能把每次结果存下来交给下一步的接口,一串环环相扣的测量才能在无人值守的情况下推进。[S1]
做新颖实验时,她给智能体定的目标更窄,更多借助它编写、修改和测试控制、分析与仿真代码的能力;智能体直接接入实验室,团队就能改代码、拿真实测量来检验,并让智能体自主完成更长的工作段。这部分文章没有给出任何运行记录,所以只是描述,不是证据。[S1]
信号清晰时的标准校准,恰恰是最容易演示的部分;文章自己点出的难点,即弱信号、噪声和含混的物理结果,才决定智能体在实验室里究竟能替人省下多少盯守。
04证据状态与边界
证据等级 4 / 5 · 在物理世界里被检验 · 闭环实验证据状态
已证实
- 模型设定的 Rabi、Ramsey 扫描在真实芯片的一个比特上执行
- Rabi 决定了 Ramsey 的扫描范围;拟合出的比特频率被存下
边界
有迹象
- 文章称:信号清晰时,标准序列只需很少介入
- 文章称:信号弱或噪声大时需要研究者指点
- 该组称:现已常规用智能体做日常测量
未知
- 6.4 kHz 的参考测量、重复性与不确定度
- 六个比特校准了几个;几块芯片、几次运行;成功率与介入率
- 整套流程耗时,以及与研究者相比的耗时和质量
- 技能说明与接入方式:未公开
- 新颖实验:文章只有描述,没有展示任何运行
- 节选的这次运行是怎么挑出来的
主张扫描→拟合→存参数→下一步:Ramsey 把 Rabi 给出的暂定频率修正到与谱测吻合。
距谱测最小值 198.598819 MHz · 一个比特、一次运行
读法6.4 kHz 是两种测量之差,不是相对真值的误差;截图没有重复运行或不确定度。
它确实动到了真实硬件。
截图里的色图和拟合曲线都来自芯片上一个比特(图中标为 q1)的实测信号:驱动中心在 199.27 MHz 的 Rabi chevron、一维 Rabi 振荡、Ramsey chevron 及其线性分支拟合。模型存下的裸频率 198.592407 MHz,与半磁通点谱测的最小值 198.598819 MHz 相差 6.4 kHz。这是两种不同测量之间的交叉核对,也是这个案例里最接近定量验证的地方;但它只是两个测量结果之差,不是相对一个独立真值的校准误差。截图没有给出参考测量、重复运行或不确定度,所以 6.4 kHz 本身算不算吻合得好,从公开材料里判断不了。按本站的证据阶梯,它够得上第 4 级:真实硬件上执行了新的测量,而测什么是模型选的。[S1]
但证据是一篇厂商案例文章。
来源是 OpenAI 自家网站,截图则是「从一次校准运行中节选的 GPT-5.6 Sol 思维链」。截图实测到的,是一个比特上的两步;六比特芯片不等于六个比特都校准完了,17 s 和 67 s 也只是这两步各自的耗时,不是整套流程。没有论文,没有代码,没有公开技能说明,也没有任何统计:用了几块芯片、跑了几次、六个比特校准了几个、研究者介入了多少次、比研究者快多少,全都没有数字。「信号清晰时只需很少介入」和「组里现在常规用智能体做日常测量」是文章和研究者的说法,不是截图里的测量结果,所以放在「有迹象」一栏。[S1]
文章没有说校准得「更好」。
文章明说,有经验的研究者可能更快找到最佳设置。它主张的是省下了盯守的时间,而不是校准质量胜过人。[S1]
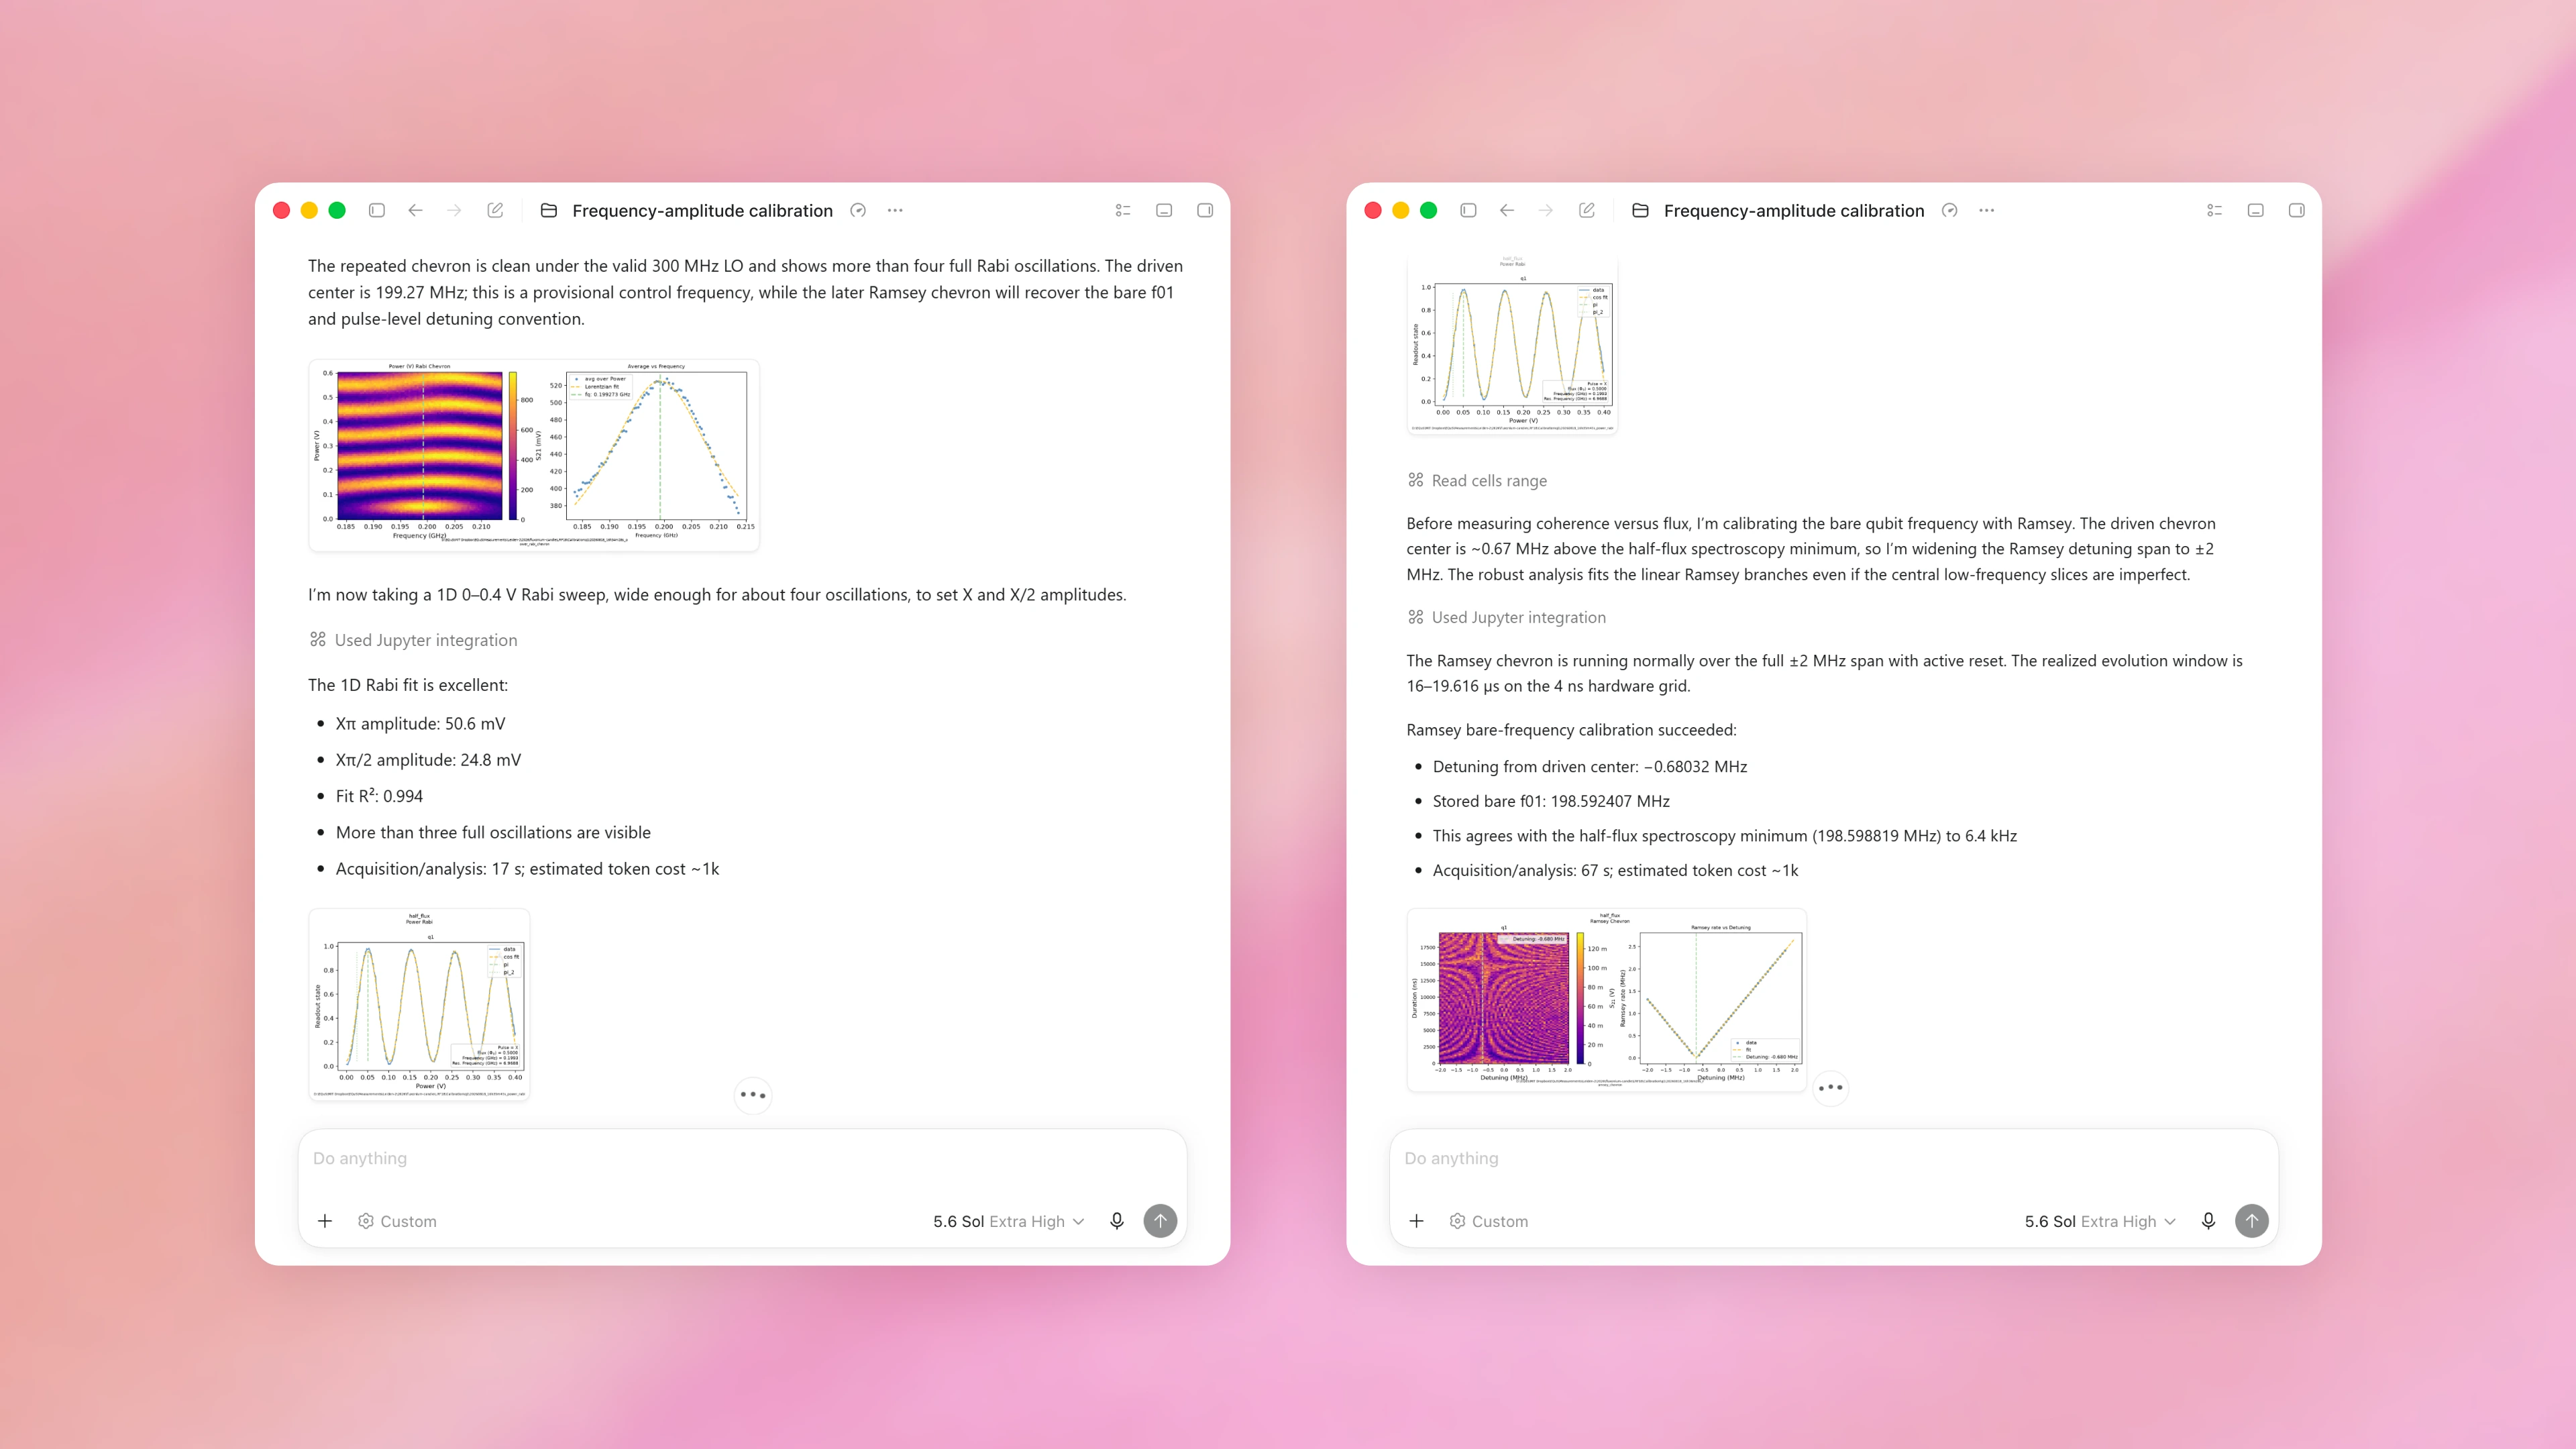
OpenAI 称之为「从一次校准运行中节选的 GPT-5.6 Sol 思维链」。左:Rabi chevron 与一维 Rabi 拟合(Xπ 50.6 mV、Xπ/2 24.8 mV、R² 0.994,采集加分析 17 s);右:±2 MHz Ramsey,存下 f01 = 198.592407 MHz,与谱测最小值相差 6.4 kHz(67 s)。这只是发布方挑出的一次运行。图片出自 OpenAI 案例文章,署名 EQuS group;未声明开放许可,此处作评论引用,整图未作修改。截图上的文字在 A4 海报上看不清,所以只放在本页。 [S1]
05我从中学到什么
- 可迁移的洞见
- 只要仪器能由软件直接调用,实验闭环本身就是智能体的环境;能走多远,取决于信号有多含混。
- 设计启发
- 为每种测量写明怎么跑、怎么判、结果存在哪,让每一步的输出成为下一步的输入。
- 阅读启发
- 先问模型动了什么:这里是真实芯片上的脉冲参数,但测量流程是研究者写成的技能。
- 接下来看
- 该组众多标准芯片上的运行次数与介入率,以及一次由智能体自己搭起来的新实验。
这个案例的意义全在「交互」
多数「AI 做科学」的主张止步于代码和算力:模型写程序、跑模拟、给预测。这里模型下发给真实芯片的是扫描范围和脉冲幅度,读回的是稀释制冷机里的测量信号。这正是本站想让读者看清的区别,哪怕眼下证据还很薄。
难的不是执行,而是判读
文章自己划的边界,是信号弱、噪声大、结果含混的时候。标准芯片的标准校准早已写成流程,模型在流程之内做得不错;一旦物理现象不按预期出现,还是得靠人。
什么证据会改变这个判断
一份带统计的记录:多少块芯片、多少次运行、研究者介入多少次、与人工表征相比耗时和结果差多少;或者一次由智能体自己设计并跑通的新实验。有任何一项,这条记录就能从「一个案例」变成「一个可以比较的结果」。
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。