

论文解读
八个 AI 测序模型的共同短板:谱图缺了碎片,换哪个模型都读不出来
VIB-根特大学的团队在三个公开蛋白质组数据集上比较八个不查数据库、直接从质谱读序列的深度学习模型。最好的单个模型读对一半,八个合起来不到三分之二;读错的谱图,多数是因为碎片不全。
●同行评审 + 公开数据上的基准测试
当前边界:错误主要来自谱图缺碎片这一点,在一个 Orbitrap 数据集上有清楚的剂量关系;标准答案只覆盖数据库已有的肽段,数据库之外的新肽段没有被检验
50.4%最好的单个模型读对
64.2%八个模型中至少一
92% → 50%八个合起来的正确率:缺 0 处碎片
Orbitrap 数据集上,每多缺一处碎片,读对的比例就掉
- 认知更新
- 从头测序的错误大多与模型无关:谱图里没有的信息,换哪个模型也读不
出来。 - 最强证据
- 八个模型的错误答案几乎从不一致,却都在缺碎片的谱图上
失败。 - 关键限制
- 标准答案来自数据库检索,只测了数据库已有的肽段;换到 timsTOF 数据明显
变差。
01发生了什么
- 任务
- 质谱仪把肽段打碎、记下碎片质量;从这张谱图倒推氨基酸序列,不查数据库(从头测
序)。 - 方法
- 用开发者的预训练权重跑八个模型和三个后处理工具,以两个检索引擎的鉴定为标准答案;质量相同的亮氨酸和异亮氨酸互换不
算错。 - 交互对象
- 只有三个公开数据集(人、大肠杆菌、酵母混合样本,在两种质谱仪上测;一个八种肠道菌的模拟群落),没有新测
样本。 - 结果
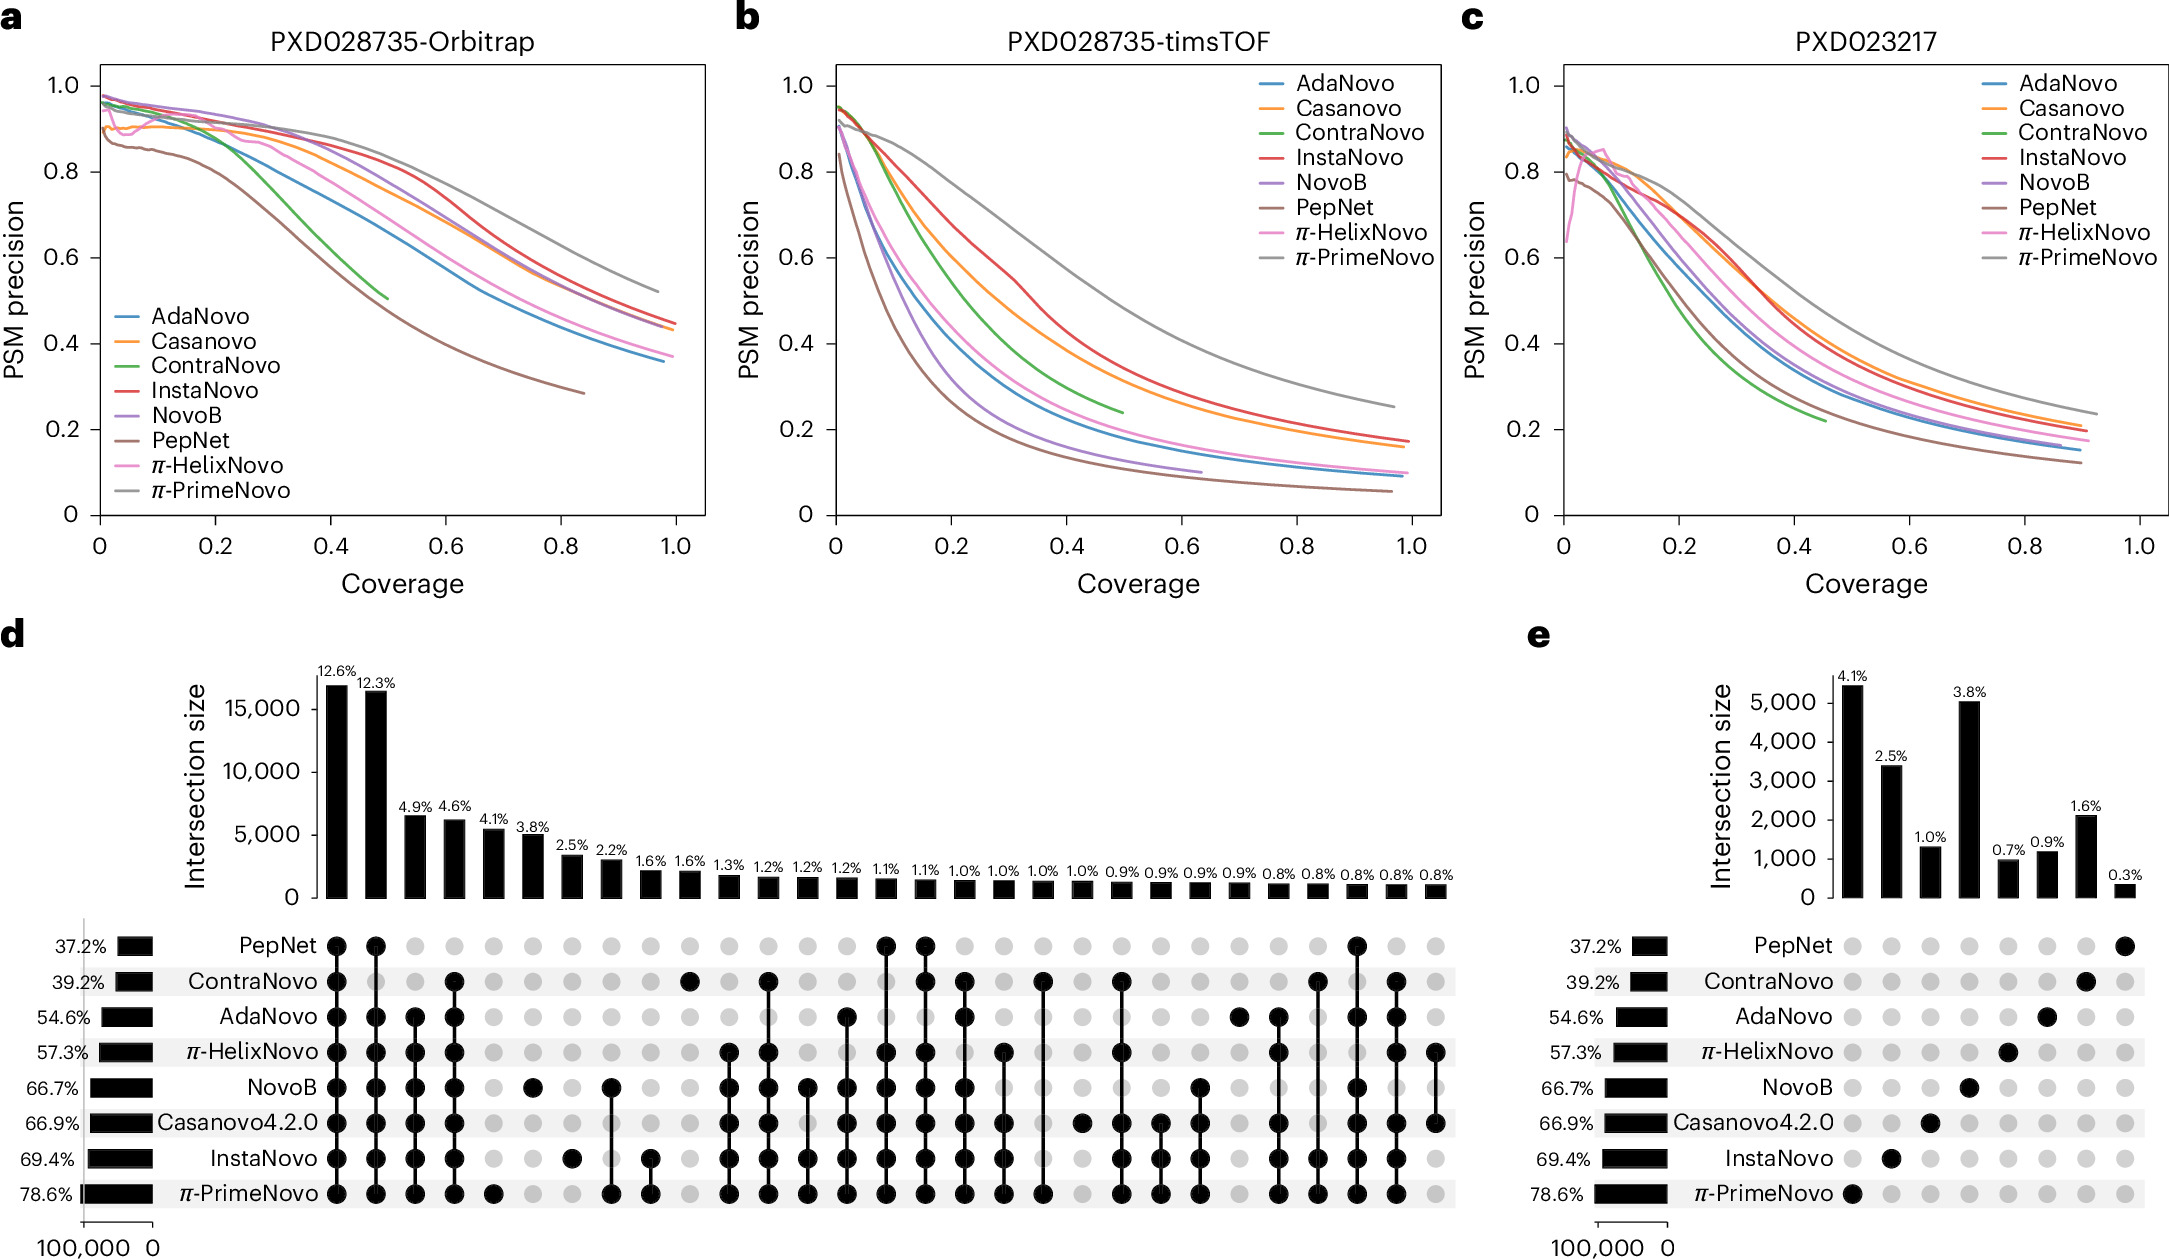
- 最好的是 π-PrimeNovo;全部八个都读对的只占读对谱图的 12.6%;后处理几乎没有提升,对最好的模型还会
改坏。
论文 2026 年 11 月 3 日以开放获取(CC BY 4.0)发表在 Nature Methods。第一作者是 VIB-根特大学医学生物技术中心的 Sam van Puyenbroeck,Tim Van Den Bossche 与 Tine Claeys 共同指导,Lennart Martens 总体指导;合作者来自柏林罗伯特·科赫研究所、图尔库大学和斯特拉斯堡大学。代码、流程和全部模型输出都已公开,大部分基准已接入社区平台 ProteoBench
蛋白质组学平时靠数据库检索认肽段:把谱图只和样本里预计会有的序列比对。这样搜索空间小、可靠,但找不到数据库里没有的蛋白或变体。从头测序不受这个限制,理论上能读出任何肽段,代价是搜索空间不再受约束,歧义全部回来。歧义有三个来源:有的氨基酸质量相同(亮氨酸和异亮氨酸),有的切割位点两侧都没测到碎片(缺一对互补离子),还有共碎裂和噪声带来的假
八个模型是 AdaNovo、Casanovo、ContraNovo、InstaNovo、NovoB、PepNet、π-HelixNovo 和 π-PrimeNovo,三个后处理工具是 InstaNovo+、MS²Rescore 和 Spectralis。标准答案来自 Sage(嵌合模式)和 MSGF+ 两个检索引擎在 q 值 0.01 以下的鉴定,每张谱图可保留多个肽段,模型命中其中任何一个就算对,亮氨酸和异亮氨酸互换不算错。比较集中在 Orbitrap 数据集上,因为所有模型在那里表现
02改变了什么
瓶颈更新评测更新从头测序的进步被当作模型之间的竞赛:新架构多读对几个百
瓶颈在谱图本身:缺碎片、噪声大的谱图,八个模型都读不出来,后处理也救不
后处理工具为什么帮不上忙
Spectralis 改动了 27.6% 到 33.3% 的预测,InstaNovo+ 改动了 8.19% 到 35.3%,但读对的数量几乎没变。对 π-PrimeNovo 和 Casanovo 这样较准的模型,改写反而让读对的变少:一部分错的被改对,更多对的被改错,改错的几乎都成了数据库里不存在的序列。真被改对的,也只差不到两个氨基酸。作为打分工具,MS²Rescore 在所有模型上都没有胜过模型自己的分数;作者的解释是,从头测序的错误答案往往比检索里的诱饵序列更像真的,所以为区分诱饵而训练的方法分不开
作者让 Casanovo 每张谱图给出十个候选。41.6% 的谱图里,十个候选都不含正确答案;正确答案在列表里时,Casanovo 有 79.7% 把它排第一。所以 Casanovo 排序本身不差,失败主要是正确序列根本没被生成出来,而这些谱图的质量系统性地更差:解释得了的信号更少,缺的碎片位点
03为什么重要
做从头测序的团队,下一笔投入该放在谱图质量和碎片之外的信息上,而不是新模型
- 实验端:换碎裂方式,或每个肽段多采几张
谱图。 - 模型端:用上保留时间和离子淌度,按谱图报告可
信度。
作者在讨论里说,现有模型在质量好的 Orbitrap 数据上表现很好,碎片阶梯完整的谱图有的模型肽段水平准确率超过 90%;但数据库检索认出的谱图里,只有大约一半能被从头测序读对,其余要么信号不够,要么有多个区分不开的候选。他们因此主张一个更现实的目标:在能确定的地方给出可靠的序列片段,并明确标注不确定性,而不是期待每张谱图都给出完整、高可信的
可信度是另一个缺口。数据库检索有成熟的目标-诱饵方法控制错误率,从头测序没有公认的对应方法,只能设一个全局分数阈值;而论文显示,π-PrimeNovo 和 π-HelixNovo 会给一些错误答案打很高的分,这样的阈值可能误导。作者提出看最优和次优候选之间的分差:差得大说明可信,差得小说明有歧义。随着模型开始预测翻译后修饰,候选更多,这个问题会更
04证据状态与边界
证据等级 2 / 5 · 算出来了证据状态
已证实
- 缺 0 到 3 处碎片,合起来读对 92%、85%、
70%、50% - 八个模型全错成同一序列的只占
0.174% - 后处理让较准的模型读对的反
而变少
边界
有迹象
- 保留时间能帮着从候选里挑对(Casanovo 上
看到)
未知
- 数据库之外的新肽段读
对多少 - 加入保留时间的模型能把上限
推多高 - 在 timsTOF 数据上微调能否补
上差距 - 怎样给每张谱图一个校准过的
可信度
主张缺多少碎片,决定了八个模型合起来的
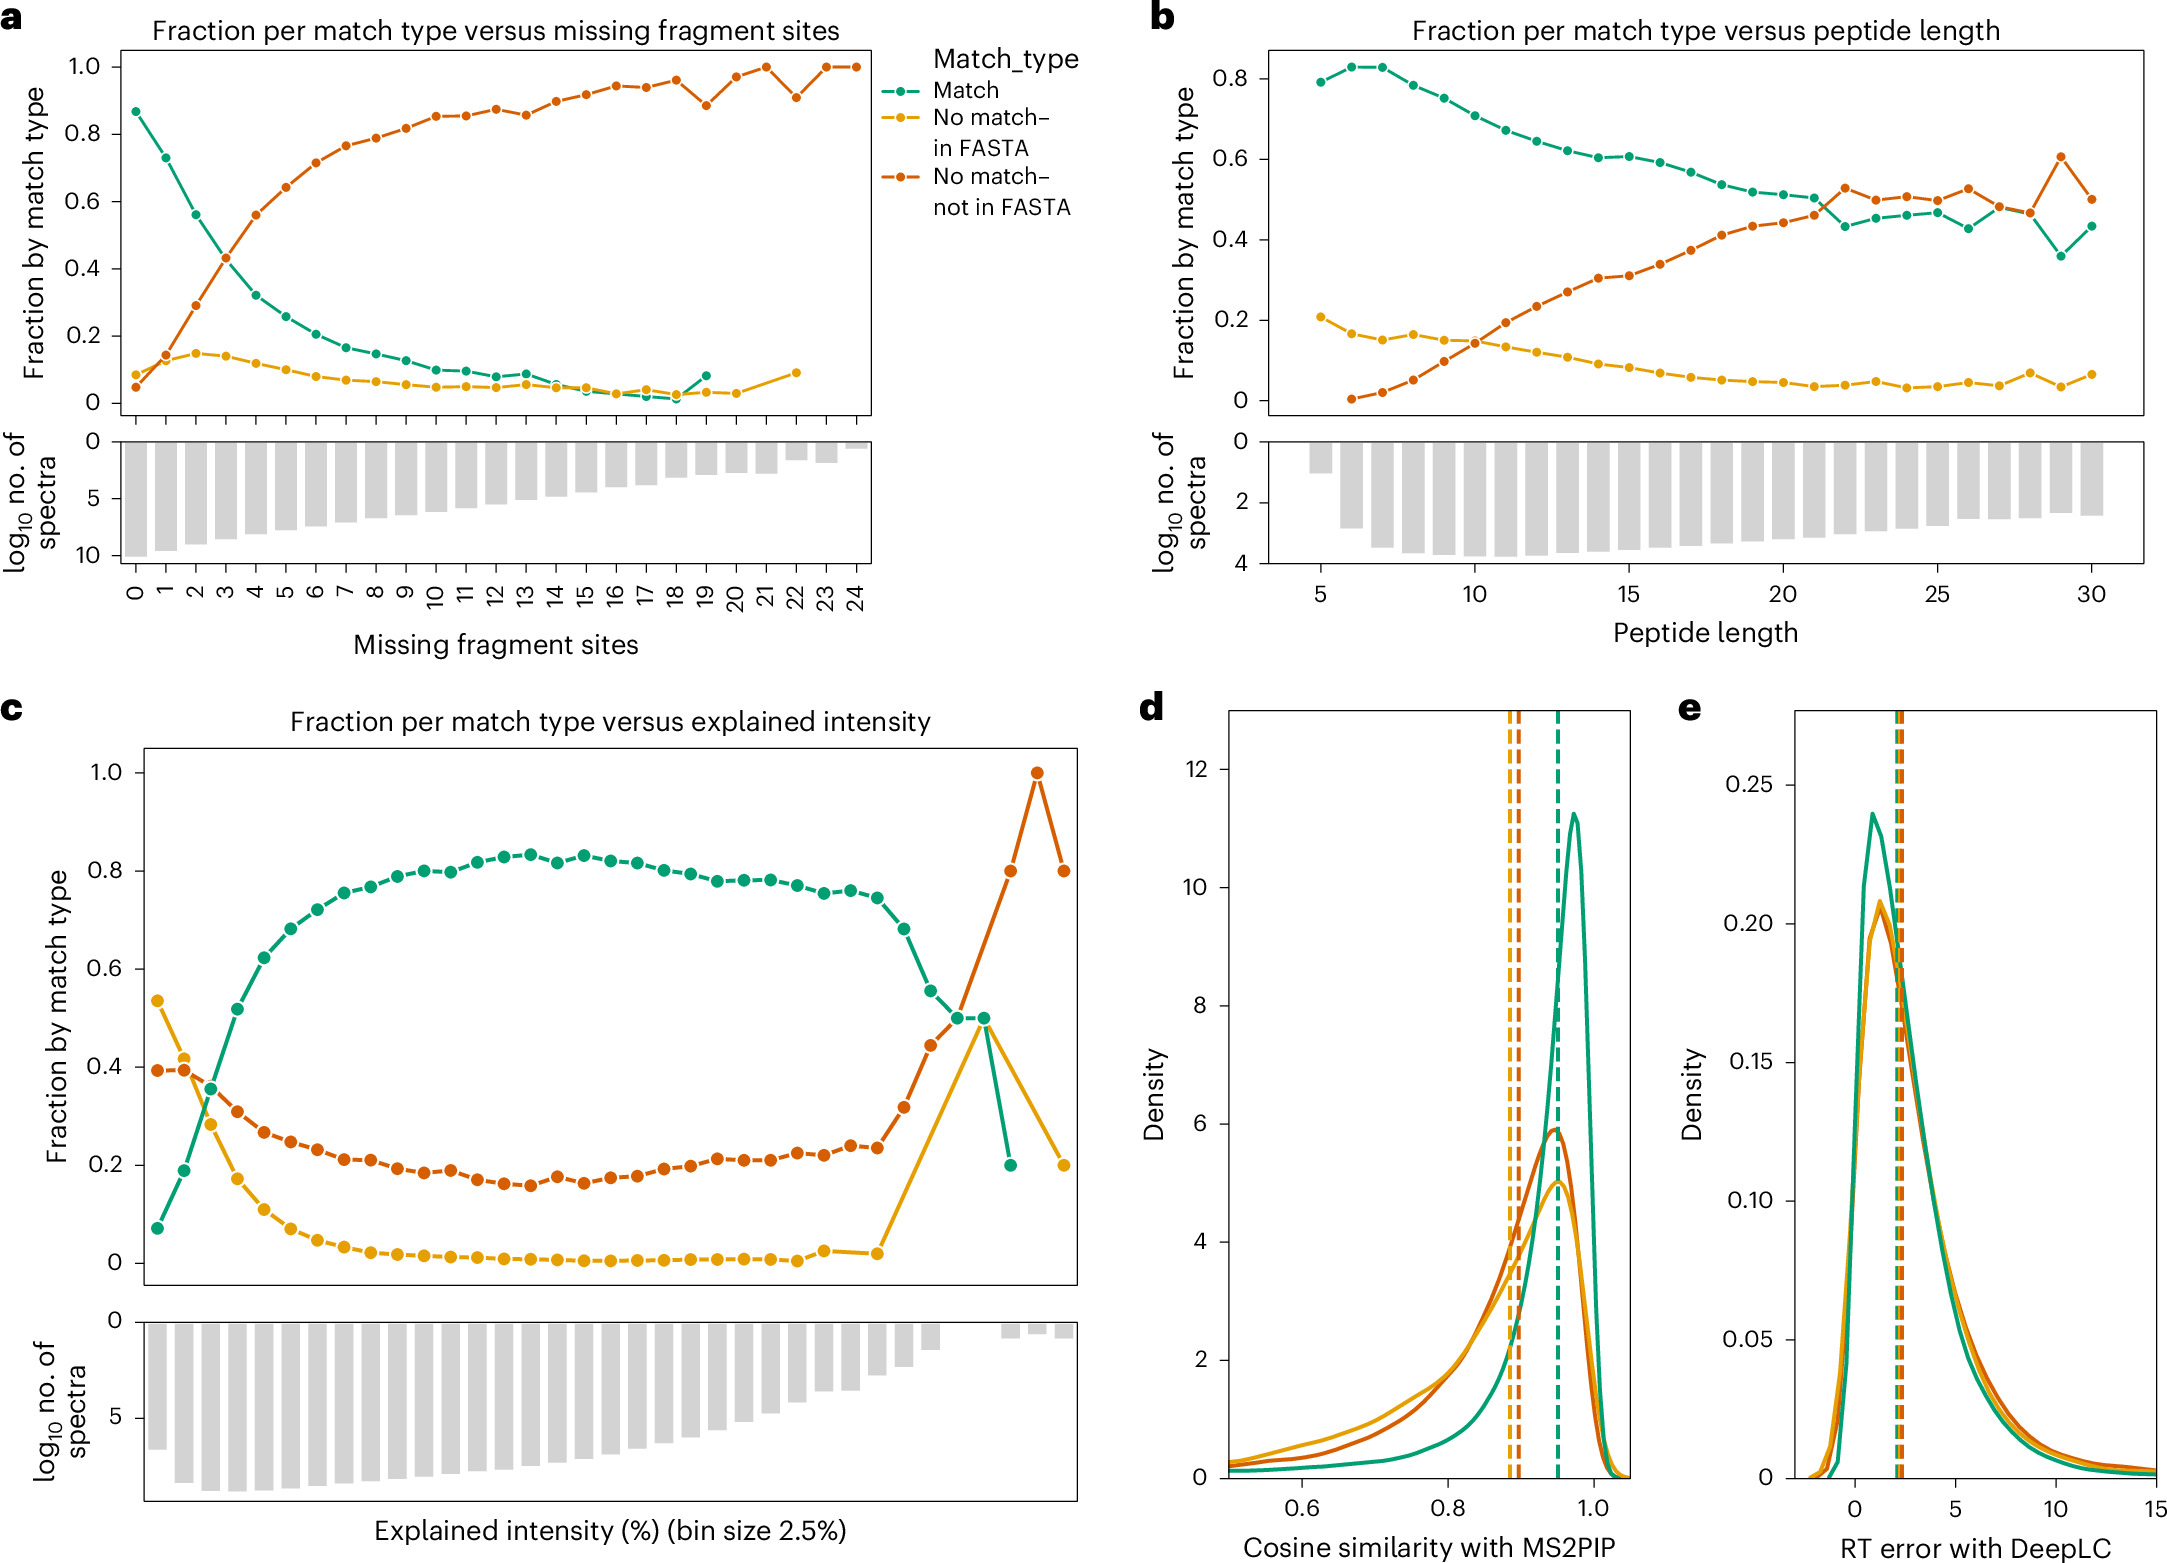
读法绿线是至少一个模型读对的比例:缺的碎片越多(a)、噪声越大(c),就
缺碎片比肽段长度更关键。
作者把八个模型合成一个理想化的“集成”:只要有一个模型读对,就算对。这个上限在所有切割位点都有碎片时是 92%,缺一、二、三对互补离子时降到 85%、70%、50%。肽段越长越容易错,但作者认为长度的影响和缺碎片纠缠在一起:肽段越长,缺碎片的可能越大,两者难以分开。谱图噪声是另一个强预测因素:能被解释的信号不到 5% 的谱图,只有 17.1% 被任一模型读对;超过 25% 时,这一比例升到八成
小范围错误多半是谱图本身分不清。
约五分之一的错误集中在一个位置。其中两个氨基酸互换位置的情况,68.5% 在两个候选之间没有任何能区分它们的碎片;质量相同的片段互换,约一半同样分不清。这些错误主要出现在肽段的 C 端,而多数模型恰好从 C 端开始构建序列。平均 20.0% 的错误答案与正确序列完全
标准答案本身的局限。
以数据库检索为标准,意味着只能测数据库里已有的肽段,而从头测序存在的理由恰恰是找数据库之外的东西。作者用两个检索引擎、允许每张谱图多个答案来减少标准本身的偏差,并检查过:多数错误预测的序列根本不在数据库里,不可能被任何检索认出;但 10.7% 的错误预测是数据库里存在的肽段,可能是另一个更好的
05我从中学到什么
- 可迁移的洞见
- 多个模型的错误互不相同、却都在同一类输入上失败,说明瓶颈在数据,不在
模型。 - 设计启发
- 评估一个领域的模型,先做“任一模型读对”的集成上限,再看它随输入质量怎
么变。 - 阅读启发
- 看从头测序论文,先问标准答案从哪来:以数据库检索为标准,测不到数据库之外的新
肽段。 - 接下来看
- 用上保留时间和离子淌度的模型,在缺碎片的谱图上能否突破八个模型合起来的
64.2%。
集成上限是判断瓶颈的便宜办法
这篇论文没有提出新模型,而是把现有模型的输出合在一起,看最理想的情况能到哪里,再看什么输入让这个上限下降。任何有多个竞争模型的领域都可以先做这一步:如果上限本身随输入质量剧降,下一个模型能多拿的分数就
可信度比准确率更难
模型给错误答案打高分,比读错本身更危险,因为下游使用者只看分数。在宏蛋白质组和抗体测序这类结果会被直接拿去解释的场景,一个能按谱图报告歧义的方法,可能比再提高几个百分点的准确率更
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。