

论文解读· 科学证据 · Frontier
从零设计的半胱氨酸蛋白酶:69 个里 13 个能切,而且在活细胞里切得动
华盛顿大学蛋白质设计研究所与苏黎世联邦理工把酵母蛋白酶 Ulp1 的催化三联体搬进全新骨架,用 RFdiffusion2 的分子界面版同时生成酶与底物。69 个设计里 13 个有活性,液质联用确认全部切在指定位点;六个晶体结构与设计模型差不到 1.2 Å,折叠与天然蛋白酶的 TM 分数低于 0.50。把一个骨架优化到 Dokki-v2 后,催化效率 413 M⁻¹s⁻¹,比无催化反应快 1.8×10⁹ 倍,但仍比天然的 Ulp1 低约三个数量级。在 HeLa 细胞里,设计的酶把报告蛋白从细胞核切了出来。
◆同行评审论文 + 湿实验测定 + 催化残基敲除 + 六个晶体结构 + 细胞实验
当前边界:设计被表达、纯化、测了动力学,敲掉催化半胱氨酸或组氨酸活性归零,六个晶体结构与模型吻合,细胞里报告蛋白确实被切:这些测到了;但最好的设计仍比天然 Ulp1 慢约三个数量级,细胞实验切的是自己设计的底物而非任何内源蛋白,也没有外部实验室复现
这项工作推进的是:把酵母蛋白酶 Ulp1 的催化三联体搬进全新骨架,和它要切的底物序列一起设计
- MODEL理解 / 预测
- DECIDE选择下一步
- INTERACT测试现实
- UPDATE改变下一轮
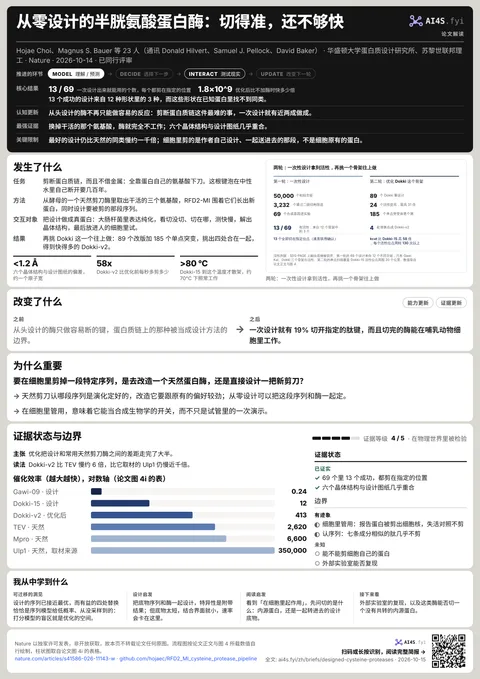
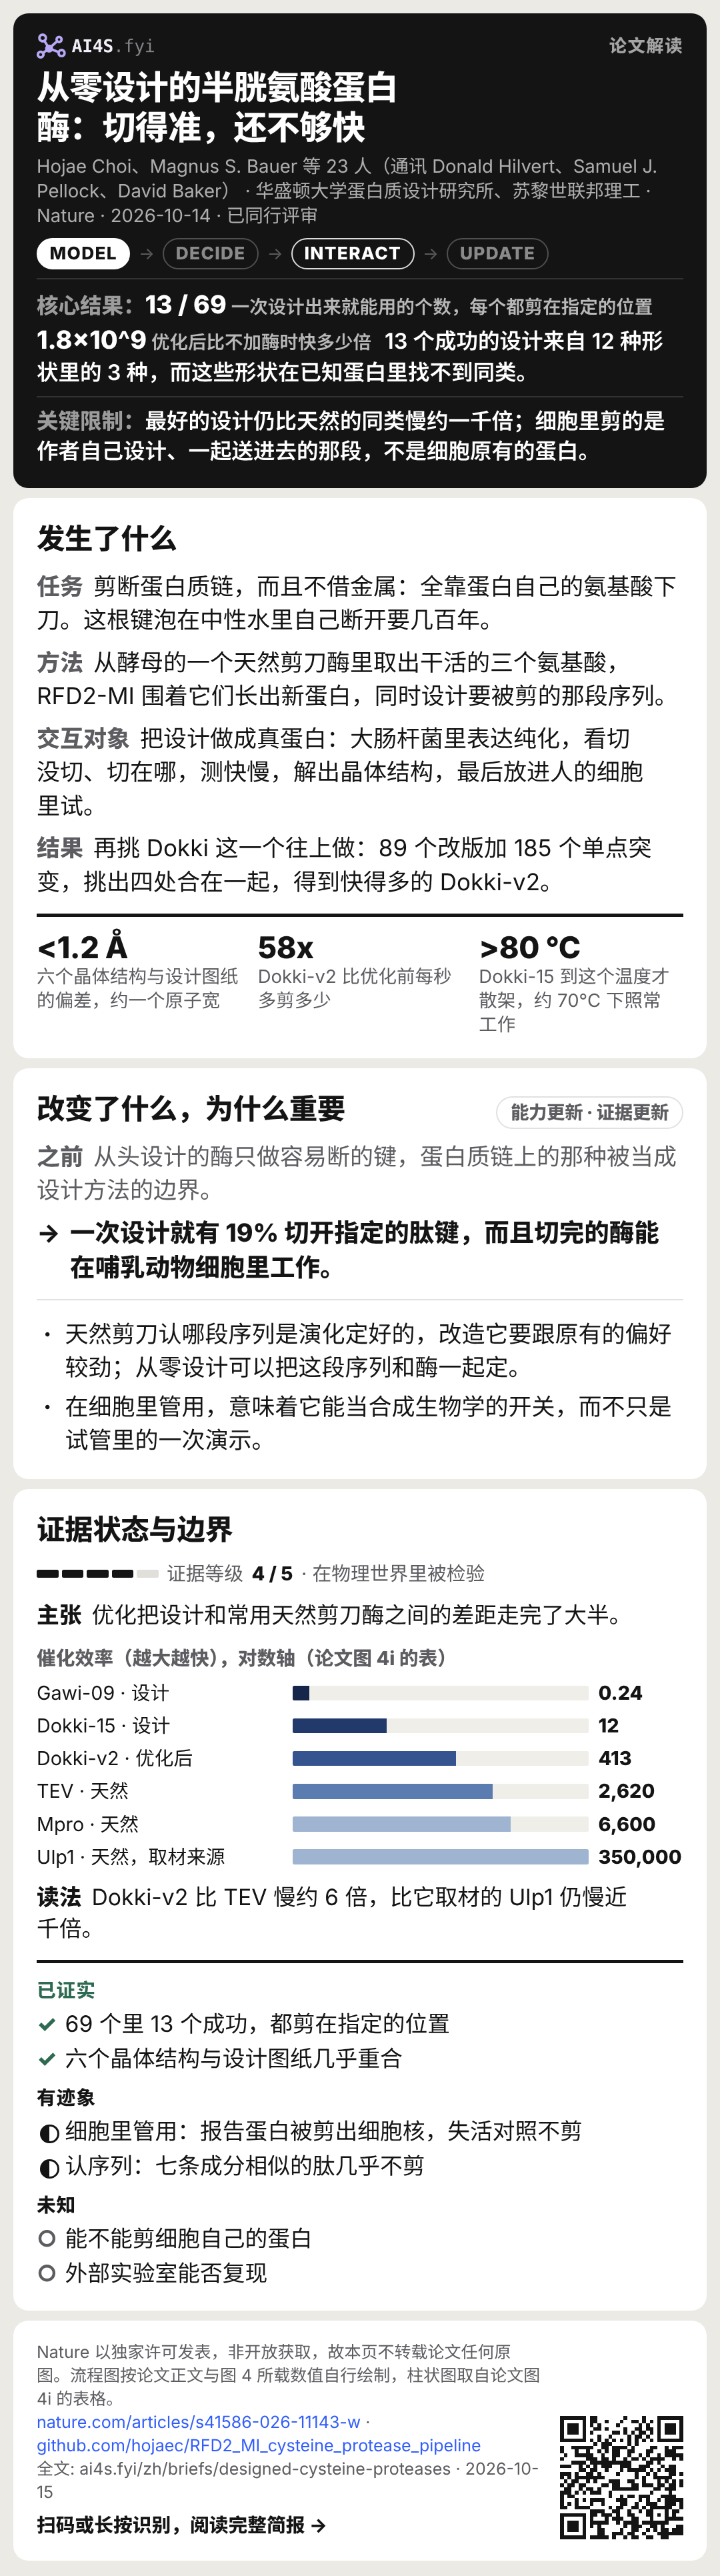
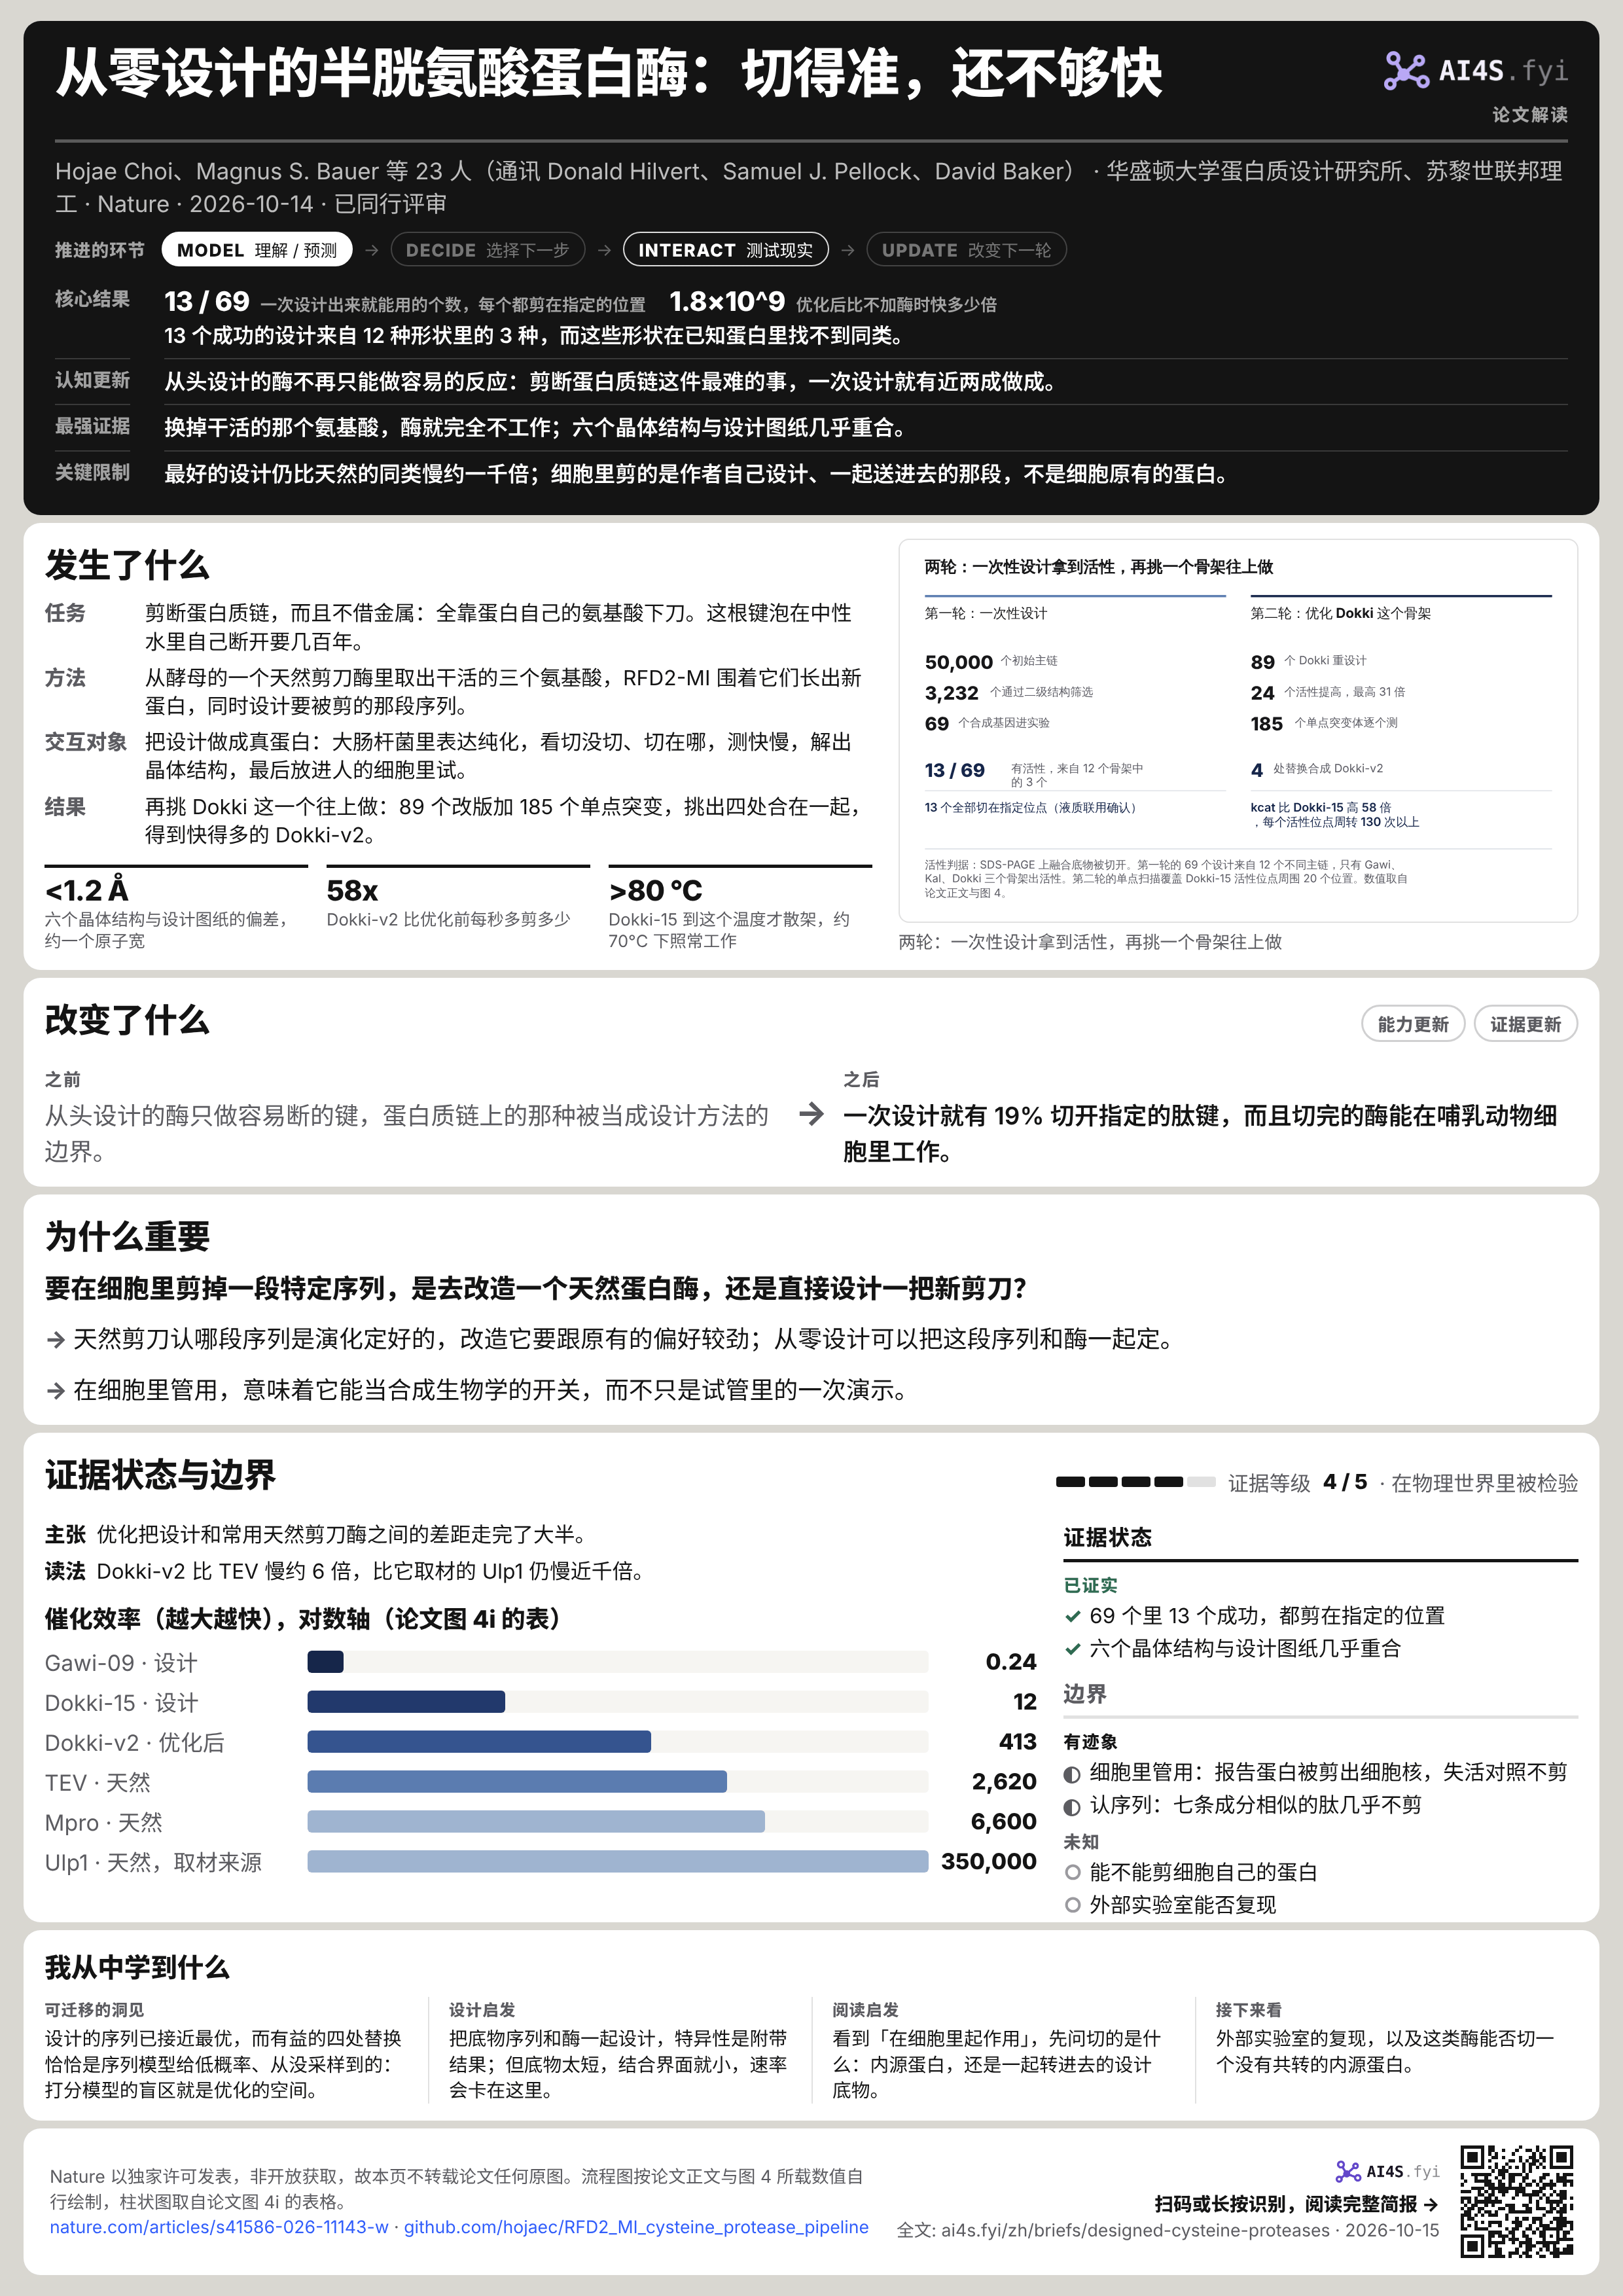
13 / 69一次设计出来就能用的个数,每个都剪在指定的位置
1.8×10^9优化后比不加酶时快多少倍
13 个成功的设计来自 12 种形状里的 3 种,而这些形状在已知蛋白里找不到同类。
- 认知更新
- 从头设计的酶不再只能做容易的反应:剪断蛋白质链这件最难的事,一次设计就有近两成做成。
- 最强证据
- 换掉干活的那个氨基酸,酶就完全不工作;六个晶体结构与设计图纸几乎重合。
- 关键限制
- 最好的设计仍比天然的同类慢约一千倍;细胞里剪的是作者自己设计、一起送进去的那段,不是细胞原有的蛋白。
01发生了什么
- 任务
- 剪断蛋白质链,而且不借金属:全靠蛋白自己的氨基酸下刀。这根键泡在中性水里自己断开要几百年。
- 方法
- 从酵母的一个天然剪刀酶里取出干活的三个氨基酸,RFD2-MI 围着它们长出新蛋白,同时设计要被剪的那段序列。
- 交互对象
- 把设计做成真蛋白:大肠杆菌里表达纯化,看切没切、切在哪,测快慢,解出晶体结构,最后放进人的细胞里试。
- 结果
- 再挑 Dokki 这一个往上做:89 个改版加 185 个单点突变,挑出四处合在一起,得到快得多的 Dokki-v2。
<1.2 Å六个晶体结构与设计图纸的偏差,约一个原子宽
58xDokki-v2 比优化前每秒多剪多少
>80 °CDokki-15 到这个温度才散架,约 70°C 下照常工作
2026 年 10 月 14 日,Nature 同日发表了蛋白质设计研究所的两篇酶设计论文,这是其中讲半胱氨酸蛋白酶的一篇(s41586-026-11143-w,2025 年 10 月 14 日投稿,2026 年 9 月 9 日接收)。第一作者 Hojae Choi 与 Magnus S. Bauer,通讯作者是苏黎世联邦理工的 Donald Hilvert、华盛顿大学的 Samuel J. Pellock 和 David Baker,共 23 位作者。作者声明没有利益冲突;设计管线与分析代码在 GitHub 上公开,六个晶体结构存入 PDB(9YNL、9YNM、9YOX、9YOY、9YOZ、9YP0)。本页所有数字读自作者提供的论文 PDF 正文与图注。[S1][S2]
管线:把 Ulp1 的活性位点搬进新骨架,底物一起设计
基序取自酵母 SUMO 蛋白酶 Ulp1 的晶体结构(PDB 1EUV):催化三联体 Cys580、His514、Asp531,加上由 Gln574 侧链和 578-579 主链构成的氧负离子洞,以及底物的四个残基。半胱氨酸比丝氨酸更适合做这件事:它的硫醇在组氨酸协助下更容易去质子,形成的高能中间体也更稳。底物怎么摆是另一半问题:作者让底物以 β 链方式与酶配对,这正是 Ulp1 结合底物的方式,用主链氢键把待切的酰胺键固定在催化机器旁边。RFD2-MI(RFdiffusion2 的分子界面版)围着这个基序生成 180-200 个残基的蛋白,配 7 个残基的底物段;关键在于它只需要指定催化原子的位置,不需要指定这些原子属于序列上的哪个残基。5 万个初始主链经二级结构筛选(剔除长环、低链含量、高卷曲)剩 3,232 个,再经 AlphaFold 3 与部分扩散的多轮迭代;序列由 ProteinMPNN 设计,酶和底物同时优化,所以每个蛋白酶配一条自己的底物序列。[S1]
筛选方式很省事:把蛋白酶和它的底物连在一条链上,后面接 mScarlet 和组氨酸标签,在大肠杆菌里表达时有活性的就会自己切开,纯化后在凝胶上看分子量。69 个设计里 13 个切开了(19%),来自 12 个不同主链中的 3 个:作者把这三个骨架命名为 Gawi、Kal、Dokki。Dokki 和 Kal 切得干净,Gawi 约 95%。液质联用确认 13 个全部切在指定的那个位点。要注意这 13 个还不是「好用的酶」:换成蛋白酶与底物分开的 FRET 测定,Gawi 家族活性低到测不出动力学,Dokki 家族的 kcat 约 10⁻⁴ s⁻¹ 量级。所以第二轮做的是优化而不是扩产:对 Gawi 和 Dokki 分别生成 21 个和 89 个重设计,其中 7 个和 24 个活性提高,幅度 1.2 到 31 倍。[S1]
02改变了什么
能力更新证据更新从头设计的酶只做容易断的键,蛋白质链上的那种被当成设计方法的边界。
一次设计就有 19% 切开指定的肽键,而且切完的酶能在哺乳动物细胞里工作。
变的是能做什么反应,以及能把它放到哪里用。论文开篇把难点说得很具体:酰胺的共振稳定让它远比酯难断,蛋白里的胺离去基团脱质子的 pKa 大于 35(典型活化酯小于 8),而肽底物柔性大、难以精确结合。此前的从头设计水解酶绕开了前两条。这篇把三条一起接下来,拿到的是 19% 的一次性命中率:在从头设计酶里这个数字相当高,作者自己也用「relatively high success rate」来形容。另一件变了的事更具体:13 个设计的折叠在 Foldseek 搜索下与已知蛋白最高只有 0.46 的 TM 分数(0.5 以上才算结构相似),结构比对显示它们确实是不同的架构,主链均方根偏差好几埃。这不是把天然蛋白改几个残基,而是在天然蛋白没有占据的结构空间里造出了能干活的酶。[S1]
03为什么重要
要在细胞里剪掉一段特定序列,是去改造一个天然蛋白酶,还是直接设计一把新剪刀?
- 天然剪刀认哪段序列是演化定好的,改造它要跟原有的偏好较劲;从零设计可以把这段序列和酶一起定。
- 在细胞里管用,意味着它能当合成生物学的开关,而不只是试管里的一次演示。
细胞实验是这篇论文最值得看清楚的部分,因为它既是真结果,也很容易被读大。做法是:把报告蛋白 H2B-sfGFP-底物-mScarlet 转进 HeLa 细胞,H2B 的核定位信号把整个融合蛋白拴在细胞核里;再共转一个设计的蛋白酶。如果酶切开了中间那段底物,mScarlet 就会从核里跑出来,显微镜下看得到红绿分离。Dokki、Dokki-15、Dokki-v2 三个都做到了,而把催化半胱氨酸换成丙氨酸的对照仍然红绿重合在核里。三次独立转染实验,每次九个视野,平均每个条件分析约 200 个细胞。所以能说的是:这些酶在哺乳动物细胞的环境里折叠正常、活性保留、切的是设计好的那段序列;不能说的是它们能切任何内源蛋白。底物是作者自己设计并一起转进去的。[S1]
特异性那一面同样具体。Dokki-15 对自己的底物 VPTLTGG/G 高度选择,而对七条氨基酸组成相似的非同源肽几乎或完全不切。作者点出,其中几条在 P4-P6 位置也带疏水残基,却仍切不动:说明识别的不只是「疏水模式」,而是序列本身。这一点对用途的影响很直接:一个只认十来个残基的特定序列的蛋白酶,可以当作合成生物学里的正交开关,在细胞里切开一个人为设计的连接子,而不去碰内源蛋白组。[S1]
04证据状态与边界
证据等级 4 / 5 · 在物理世界里被检验 · 实体验证证据状态
已证实
- 69 个里 13 个成功,都剪在指定的位置
- 六个晶体结构与设计图纸几乎重合
边界
有迹象
- 细胞里管用:报告蛋白被剪出细胞核,失活对照不剪
- 认序列:七条成分相似的肽几乎不剪
未知
- 能不能剪细胞自己的蛋白
- 外部实验室能否复现
主张优化把设计和常用天然剪刀酶之间的差距走完了大半。
催化效率(越大越快),对数轴(论文图 4i 的表)
读法Dokki-v2 比 TEV 慢约 6 倍,比它取材的 Ulp1 仍慢近千倍。
催化确实来自设计的三联体。
对每个有活性的设计,作者把催化半胱氨酸、组氨酸和氧负离子洞的谷氨酰胺/天冬酰胺逐个换成丙氨酸。Cys 或 His 换掉后活性完全消失,确认了它们在催化里不可替代;而 Gln/Asn 换掉后并没有一律失活,作者的解释是在它缺席时有序的水分子可能补上了对氧负离子中间体的稳定。六个晶体结构(分辨率 1.56 到 3.38 Å)覆盖三个骨架的无底物与结合底物状态:Kal 与底物的复合物里,催化三联体和底物结合裂隙都是设计好的构象;Gawi-09 的无底物结构里催化残基排列与模型吻合,只有组氨酸被结晶缓冲液带来的锌离子顶开;Dokki 和 Dokki-15 的无底物结构里电子密度显示催化半胱氨酸被氧化成了磺酸,这在天然半胱氨酸蛋白酶 Ulp1 上也报道过。[S1]
速率:跟什么比,还差多少。
两个代表设计的稳态动力学:Gawi-09 的 kcat 为 0.8±0.1×10⁻⁵ s⁻¹、KM 34±4 μM、kcat/KM 0.24±0.03 M⁻¹s⁻¹;Dokki-15 的 kcat 为 1.1±0.1×10⁻³ s⁻¹、KM 89±10 μM、kcat/KM 12±2 M⁻¹s⁻¹。以无催化的肽键水解速率(25°C、pH 6.8 下 3.6×10⁻¹¹ s⁻¹)为底,Dokki-15 的加速约 3×10⁷ 倍,这就是摘要里那个数字。随后作者在 Dokki-15 活性位点周围 20 个位置做了 185 个单点突变体:多数替换都降低活性,说明原设计序列已接近最优,但 Tyr41、Ser44、Pro67、Thr99 四处有益,而这四处在原来的 ProteinMPNN 设计里概率都很低,没被采样到。合成的 Dokki-v2 kcat 0.064±0.005 s⁻¹、KM 154±14 μM、kcat/KM 413±50 M⁻¹s⁻¹,每个活性位点周转 130 次以上,相对无催化反应加速 1.8×10⁹ 倍;提升全部来自 kcat 的 58 倍增长,也就是化学步骤本身变快了。横向比:Ulp1(带 SUMO 结构域的底物)kcat 6.1 s⁻¹、kcat/KM 350,000;TEV 0.16 和 2,620;Mpro 1.23 和 6,600。Dokki-v2 落在天然范围的下沿。[S1]
为什么还差这些。
作者没有把剩下的差距留成一句「有待提高」,而是去定位它。PLACER 建模给出催化循环各状态的构象系综,按天然半胱氨酸蛋白酶的几何阈值(Cys-His 小于 4.2 Å、His-Asp 小于 3.2 Å、氧负离子-Gln 小于 3.4 Å)判断「有效构象」的比例:Ulp1 在第一过渡态上是 100%,Dokki 12%,Dokki-15 20%,Dokki-v2 32%。分子动力学给出第二个原因,而且是关于底物而非酶的:Ulp1 用一个折叠的 SUMO 结构域抓住底物,把待切键顶进活性位点,而这些设计只认 P1-P7 七个残基的短肽,结合界面小、疏水接触少,底物摆得不够稳。一个直接的旁证是:Ulp1 面对不带 SUMO 结构域的多肽底物时,同样测不出活性。所以作者的结论是,下一步要做的是活性位点的预组织和更大的底物结合界面,而不是换一套催化化学。[S1]
05我从中学到什么
- 可迁移的洞见
- 设计的序列已接近最优,而有益的四处替换恰恰是序列模型给低概率、从没采样到的:打分模型的盲区就是优化的空间。
- 设计启发
- 把底物序列和酶一起设计,特异性是附带结果;但底物太短,结合界面就小,速率会卡在这里。
- 阅读启发
- 看到「在细胞里起作用」,先问切的是什么:内源蛋白,还是一起转进去的设计底物。
- 接下来看
- 外部实验室的复现,以及这类酶能否切一个没有共转的内源蛋白。
两篇同日论文,是一次能力到位的双重证据
同一天 Nature 还发了这个研究所的金属蛋白酶论文(本站另有简报):同样是切肽键这个难反应,走的却是完全不同的化学:锌活化的水,而不是活化的半胱氨酸;一次设计 135 个,36% 有活性。两套方案互不依赖,同月同日给出,这比「某个方法奏效」更像是设计能力本身跨过了一道门槛。两篇对剩余差距的诊断也指向同一处:预组织不够,催化基团和底物都没被固定在该在的位置。要注意的是两篇出自同一个实验室体系,所以它们互为旁证,不是互为独立复现。
一个被量化的「差多少」
值得单独记一笔的是 PLACER 那组数字:有效构象占比 Ulp1 100%、Dokki 12%、Dokki-15 20%、Dokki-v2 32%。它把「设计的酶为什么比天然的慢」从一句定性的话变成了一个可以追踪的量,而且这个量和实测的 kcat 排序一致。对任何做生成式设计的人,这是比命中率更有用的指标方向:结构预测的置信度说的是「折叠对不对」,而催化要的是「活性位点在反应过程中有多少时间待在该在的位置」。前者现在做得很好,后者才是剩下的工作。
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。
- S1De novo design of cysteine proteasesNature · Choi, Bauer, Hilvert, Pellock, Baker et al. · Institute for Protein Design, ETH Zurich · 2026.10.14 · 同行评审论文 · 全文与图读自作者提供的 PDF,2026-10-15
- S2hojaec/RFD2_MI_cysteine_protease_pipelineGitHub · named in the paper's code-availability statement · 2026.10.14 · 计算设计与分析代码,地址取自论文的代码可用性声明