

模型发布· 科学证据 · Frontier
LiteMol-1:面向 AI Agent 的跨分子类别生成基础模型
LiteFold 的 LiteMol-1 值得看的不只是一套权重能覆盖多类分子,更在于它想把分子生成做成 AI Agent 能低成本反复调用、编辑和优化的工具。
◐技术报告 + 计算评估
当前边界:目前更像计算概念验证,而不是已验证的药物发现系统
这项工作推进的是:低成本生成、编辑和搜索分子候选
- MODEL理解 / 预测
- DECIDE选择下一步
- INTERACT测试现实
- UPDATE改变下一轮
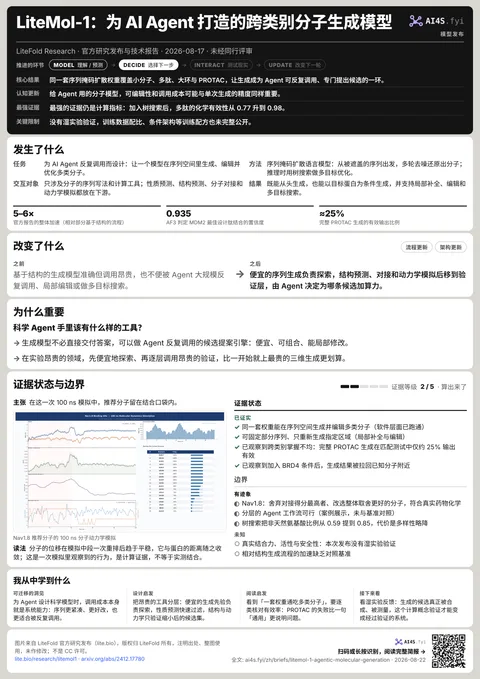
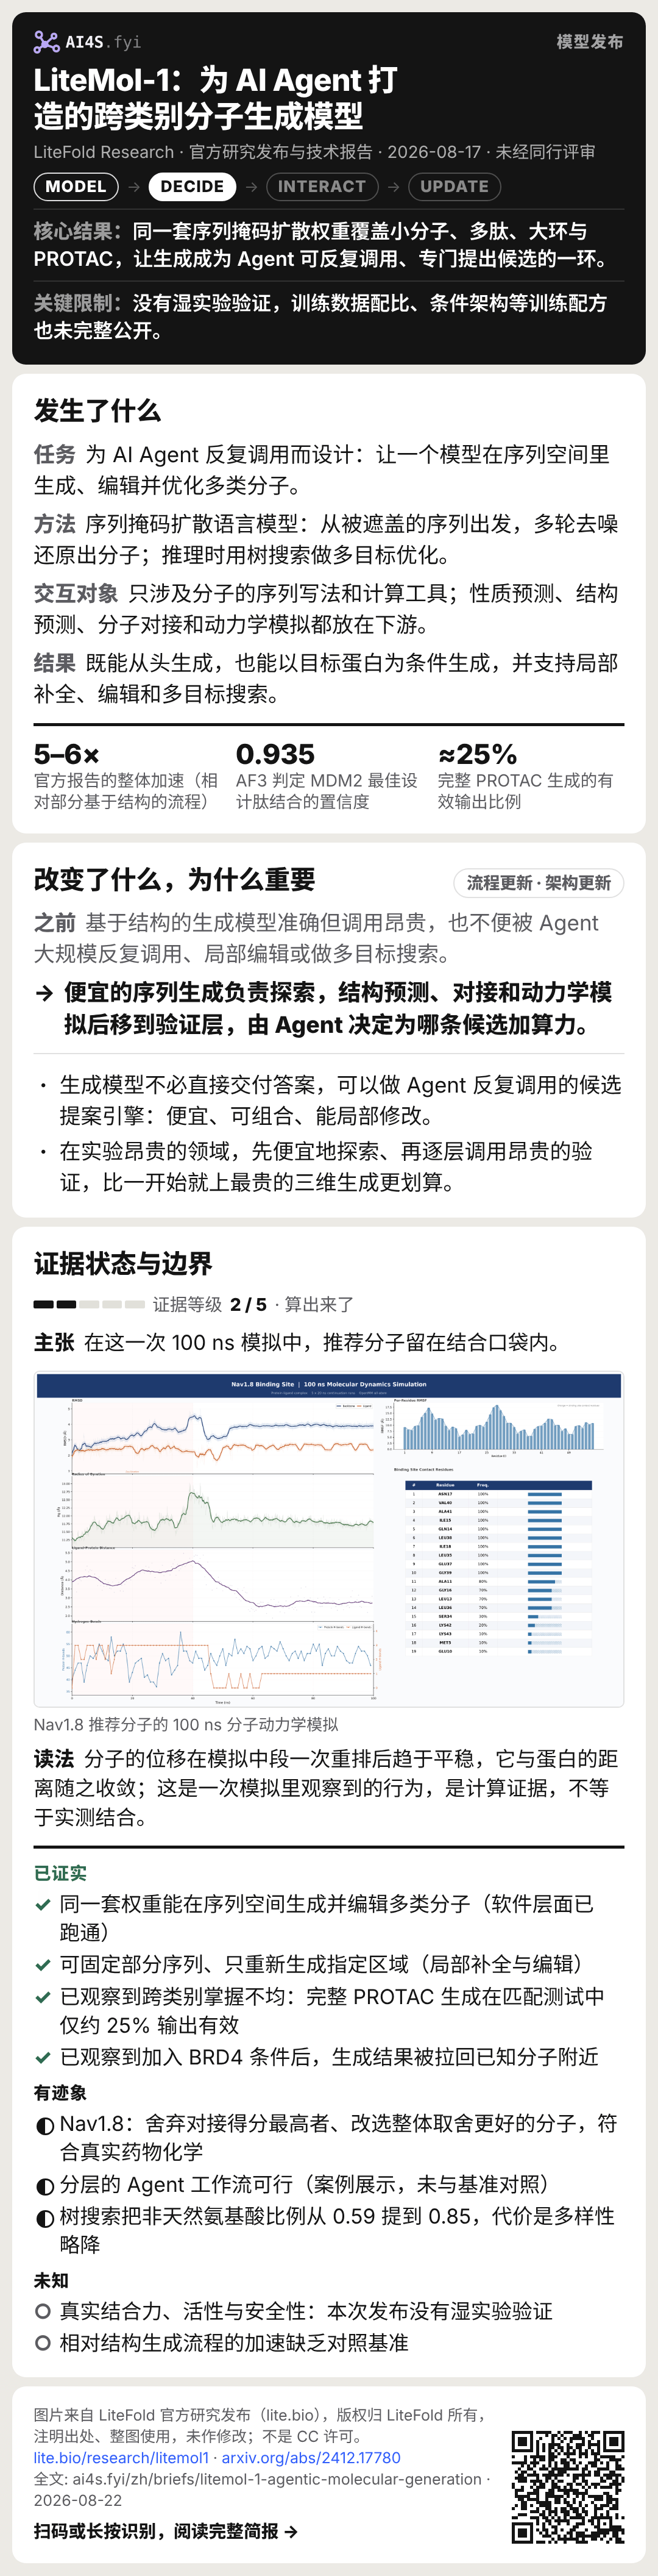
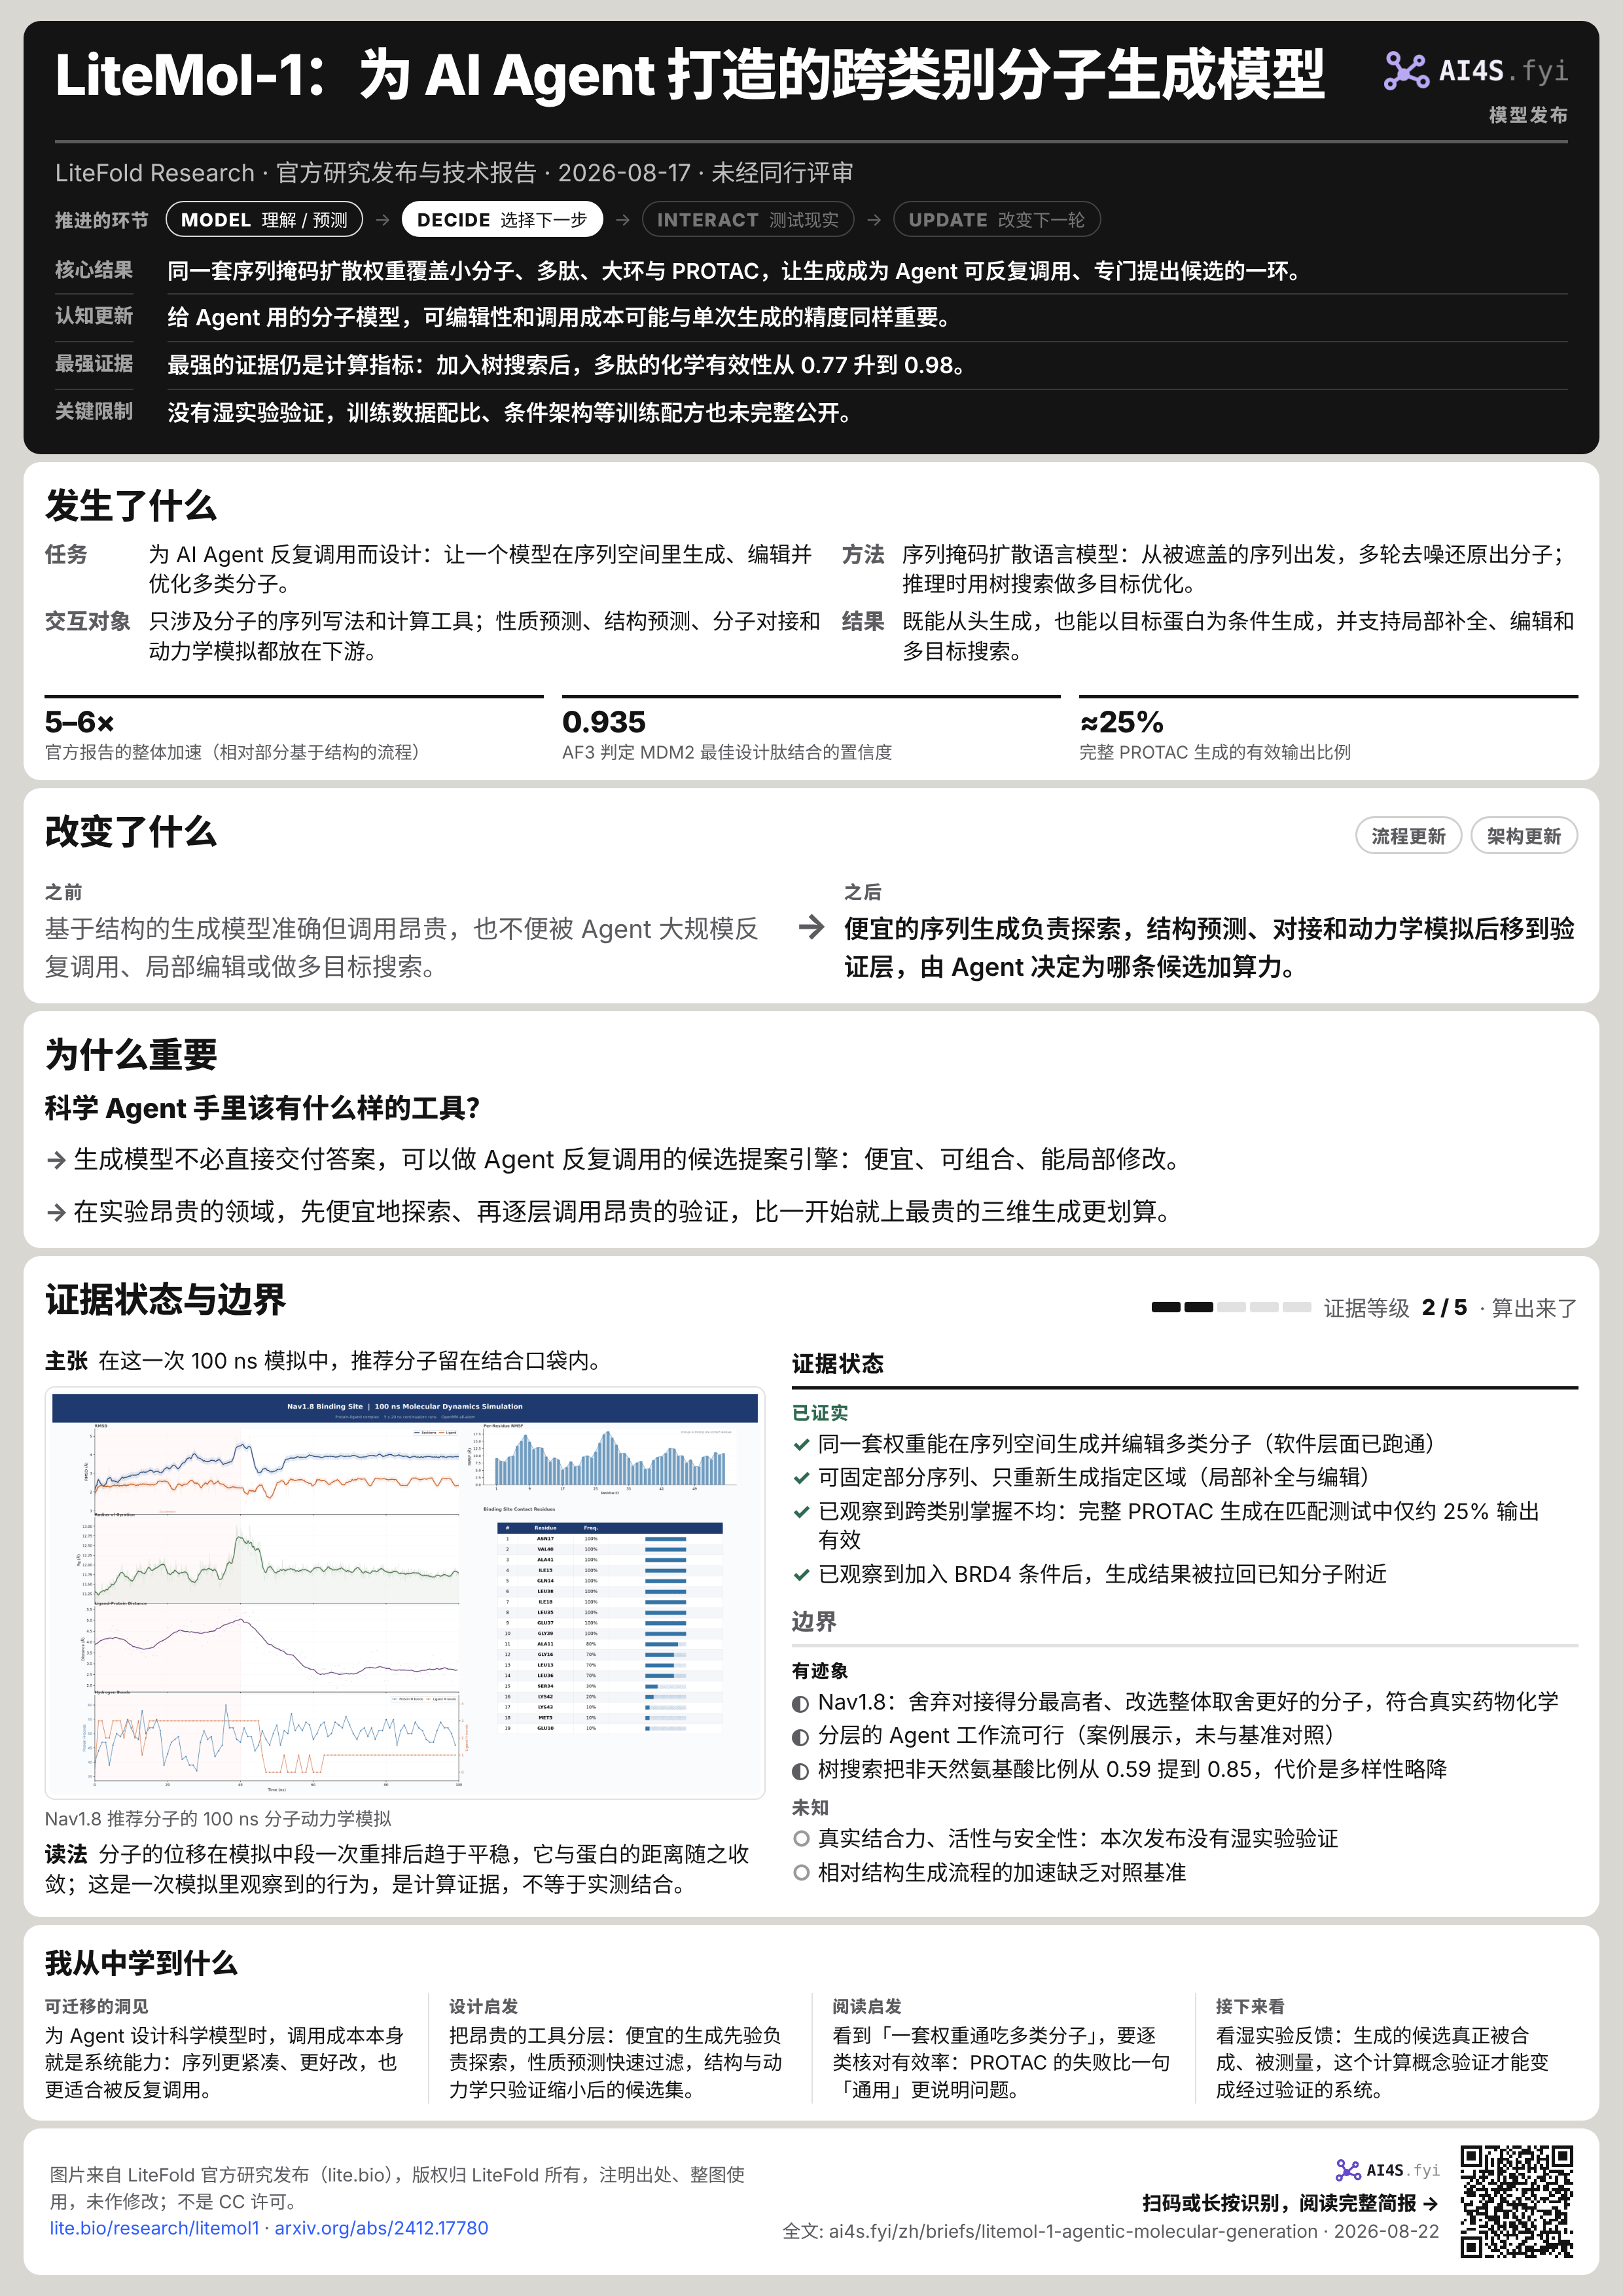
同一套序列掩码扩散权重覆盖小分子、多肽、大环与 PROTAC,让生成成为 Agent 可反复调用、专门提出候选的一环。
- 认知更新
- 给 Agent 用的分子模型,可编辑性和调用成本可能与单次生成的精度同样重要。
- 最强证据
- 最强的证据仍是计算指标:加入树搜索后,多肽的化学有效性从 0.77 升到 0.98。
- 关键限制
- 没有湿实验验证,训练数据配比、条件架构等训练配方也未完整公开。
01发生了什么
- 任务
- 为 AI Agent 反复调用而设计:让一个模型在序列空间里生成、编辑并优化多类分子。
- 方法
- 序列掩码扩散语言模型:从被遮盖的序列出发,多轮去噪还原出分子;推理时用树搜索做多目标优化。
- 交互对象
- 只涉及分子的序列写法和计算工具;性质预测、结构预测、分子对接和动力学模拟都放在下游。
- 结果
- 既能从头生成,也能以目标蛋白为条件生成,并支持局部补全、编辑和多目标搜索。
5–6×官方报告的整体加速(相对部分基于结构的流程)
0.935AF3 判定 MDM2 最佳设计肽结合的置信度
≈25%完整 PROTAC 生成的有效输出比例
2026 年 8 月 17 日,AI4Science 公司 LiteFold 发布了首个基础模型 LiteMol-1。这是一个在分子序列 token 上预训练的掩码扩散语言模型,不直接生成三维坐标。[S1]
同一套权重可以处理小分子、线性肽、环肽、含非天然氨基酸的肽、大环分子,以及 PROTAC 相关分子。它既能从头生成,也能根据目标蛋白的序列生成候选,并支持局部补全、分子编辑和多目标搜索。[S1]
更深一层的问题是:如果由 AI Agent 不停地“生成、评估、修改、再生成”,什么样的分子模型最适合放进这个循环?
掩码扩散天然适合局部修改
LiteMol-1 不是从左到右逐字写出分子。采样开始时,整条分子序列几乎都被遮住;模型经过多轮去噪,逐个位置还原,最后得到完整分子。也可以固定一部分序列、只重新生成指定区域,所以很适合做局部补全。[S1]
各个位置的遮盖节奏也不一样。沿用 PepTune 的思路,决定骨架和连接关系的关键位置会先被还原:先把骨架搭起来,再修周边细节。[S1][S2]
多目标优化不必压成一个总分
药物设计几乎从来不是单目标问题。结合力强,不代表心脏毒性、渗透性和可合成性都合适。把这些目标硬压成一个加权分数虽然方便,却会把人为偏好悄悄藏进答案里。
LiteMol-1 在推理阶段引入蒙特卡洛树搜索(MCTS):模型给出哪些续写看起来合理的先验,MCTS 决定哪些分支值得继续投入算力,最后保留一组代表不同取舍的候选,而不是硬要找一个“样样最好”的分子。[S1]
加入 MCTS 后,多肽的化学有效性从 0.77 升到 0.98,非天然氨基酸比例从 0.59 升到 0.85,多样性则略有下降。搜索在追逐目标的同时也改变了原本的生成分布,这份提升是有代价的。[S1]
02改变了什么
流程更新架构更新基于结构的生成模型准确但调用昂贵,也不便被 Agent 大规模反复调用、局部编辑或做多目标搜索。
便宜的序列生成负责探索,结构预测、对接和动力学模拟后移到验证层,由 Agent 决定为哪条候选加算力。
先在序列空间探索,再调用昂贵的结构工具
基于结构的生成模型有直观的优势:分子终究存在于三维空间,直接对结构建模更接近物理现实。但药物发现早期往往要先拿出成千上万条候选,再逐层调用结构预测、分子对接和动力学模拟。如果每次探索都从昂贵的三维生成开始,成本会迅速膨胀。[S1]
分子序列的信息没有三维结构完整,却更短、更容易比较,也方便局部删除、替换和重写。LiteMol-1 因此更像一个快速生成器:先低成本提出和修改大量候选,等范围缩小后,再把结构工具叫进来。[S1]
这不是否定结构推理,而是在给工具分层:生成模型负责便宜的探索,性质预测负责快速过滤,结构预测、分子对接和动力学模拟负责更深的验证。Agent 决定什么时候值得为哪条候选多花算力。
03为什么重要
科学 Agent 手里该有什么样的工具?
- 生成模型不必直接交付答案,可以做 Agent 反复调用的候选提案引擎:便宜、可组合、能局部修改。
- 在实验昂贵的领域,先便宜地探索、再逐层调用昂贵的验证,比一开始就上最贵的三维生成更划算。
LiteMol-1 值得关注,并不是因为它已是“最强分子生成模型”,目前的证据撑不起这个说法。它更重要的是提出了一种更现实的 Agent 工作流:先用便宜、可编辑的序列模型生成大量候选,再根据候选价值逐步调用性质预测、结构预测、分子对接和动力学模拟,最后才把少数候选送进实验。
在这种架构里,生成模型不负责直接交付最终答案,而是 Agent 可以不断调用的提案工具。科学 Agent 的能力因此不只取决于推理模型本身,也取决于它手里的工具是否便宜、可组合、能局部修改,并且能在新模拟或实验结果回来后继续下一轮。
04证据状态与边界
证据等级 2 / 5 · 算出来了 · 前瞻性计算证据状态
已证实
- 同一套权重能在序列空间生成并编辑多类分子(软件层面已跑通)
- 可固定部分序列、只重新生成指定区域(局部补全与编辑)
- 已观察到跨类别掌握不均:完整 PROTAC 生成在匹配测试中仅约 25% 输出有效
- 已观察到加入 BRD4 条件后,生成结果被拉回已知分子附近
边界
有迹象
- Nav1.8:舍弃对接得分最高者、改选整体取舍更好的分子,符合真实药物化学
- 分层的 Agent 工作流可行(案例展示,未与基准对照)
- 树搜索把非天然氨基酸比例从 0.59 提到 0.85,代价是多样性略降
未知
- 真实结合力、活性与安全性:本次发布没有湿实验验证
- 相对结构生成流程的加速缺乏对照基准
主张在这一次 100 ns 模拟中,推荐分子留在结合口袋内。
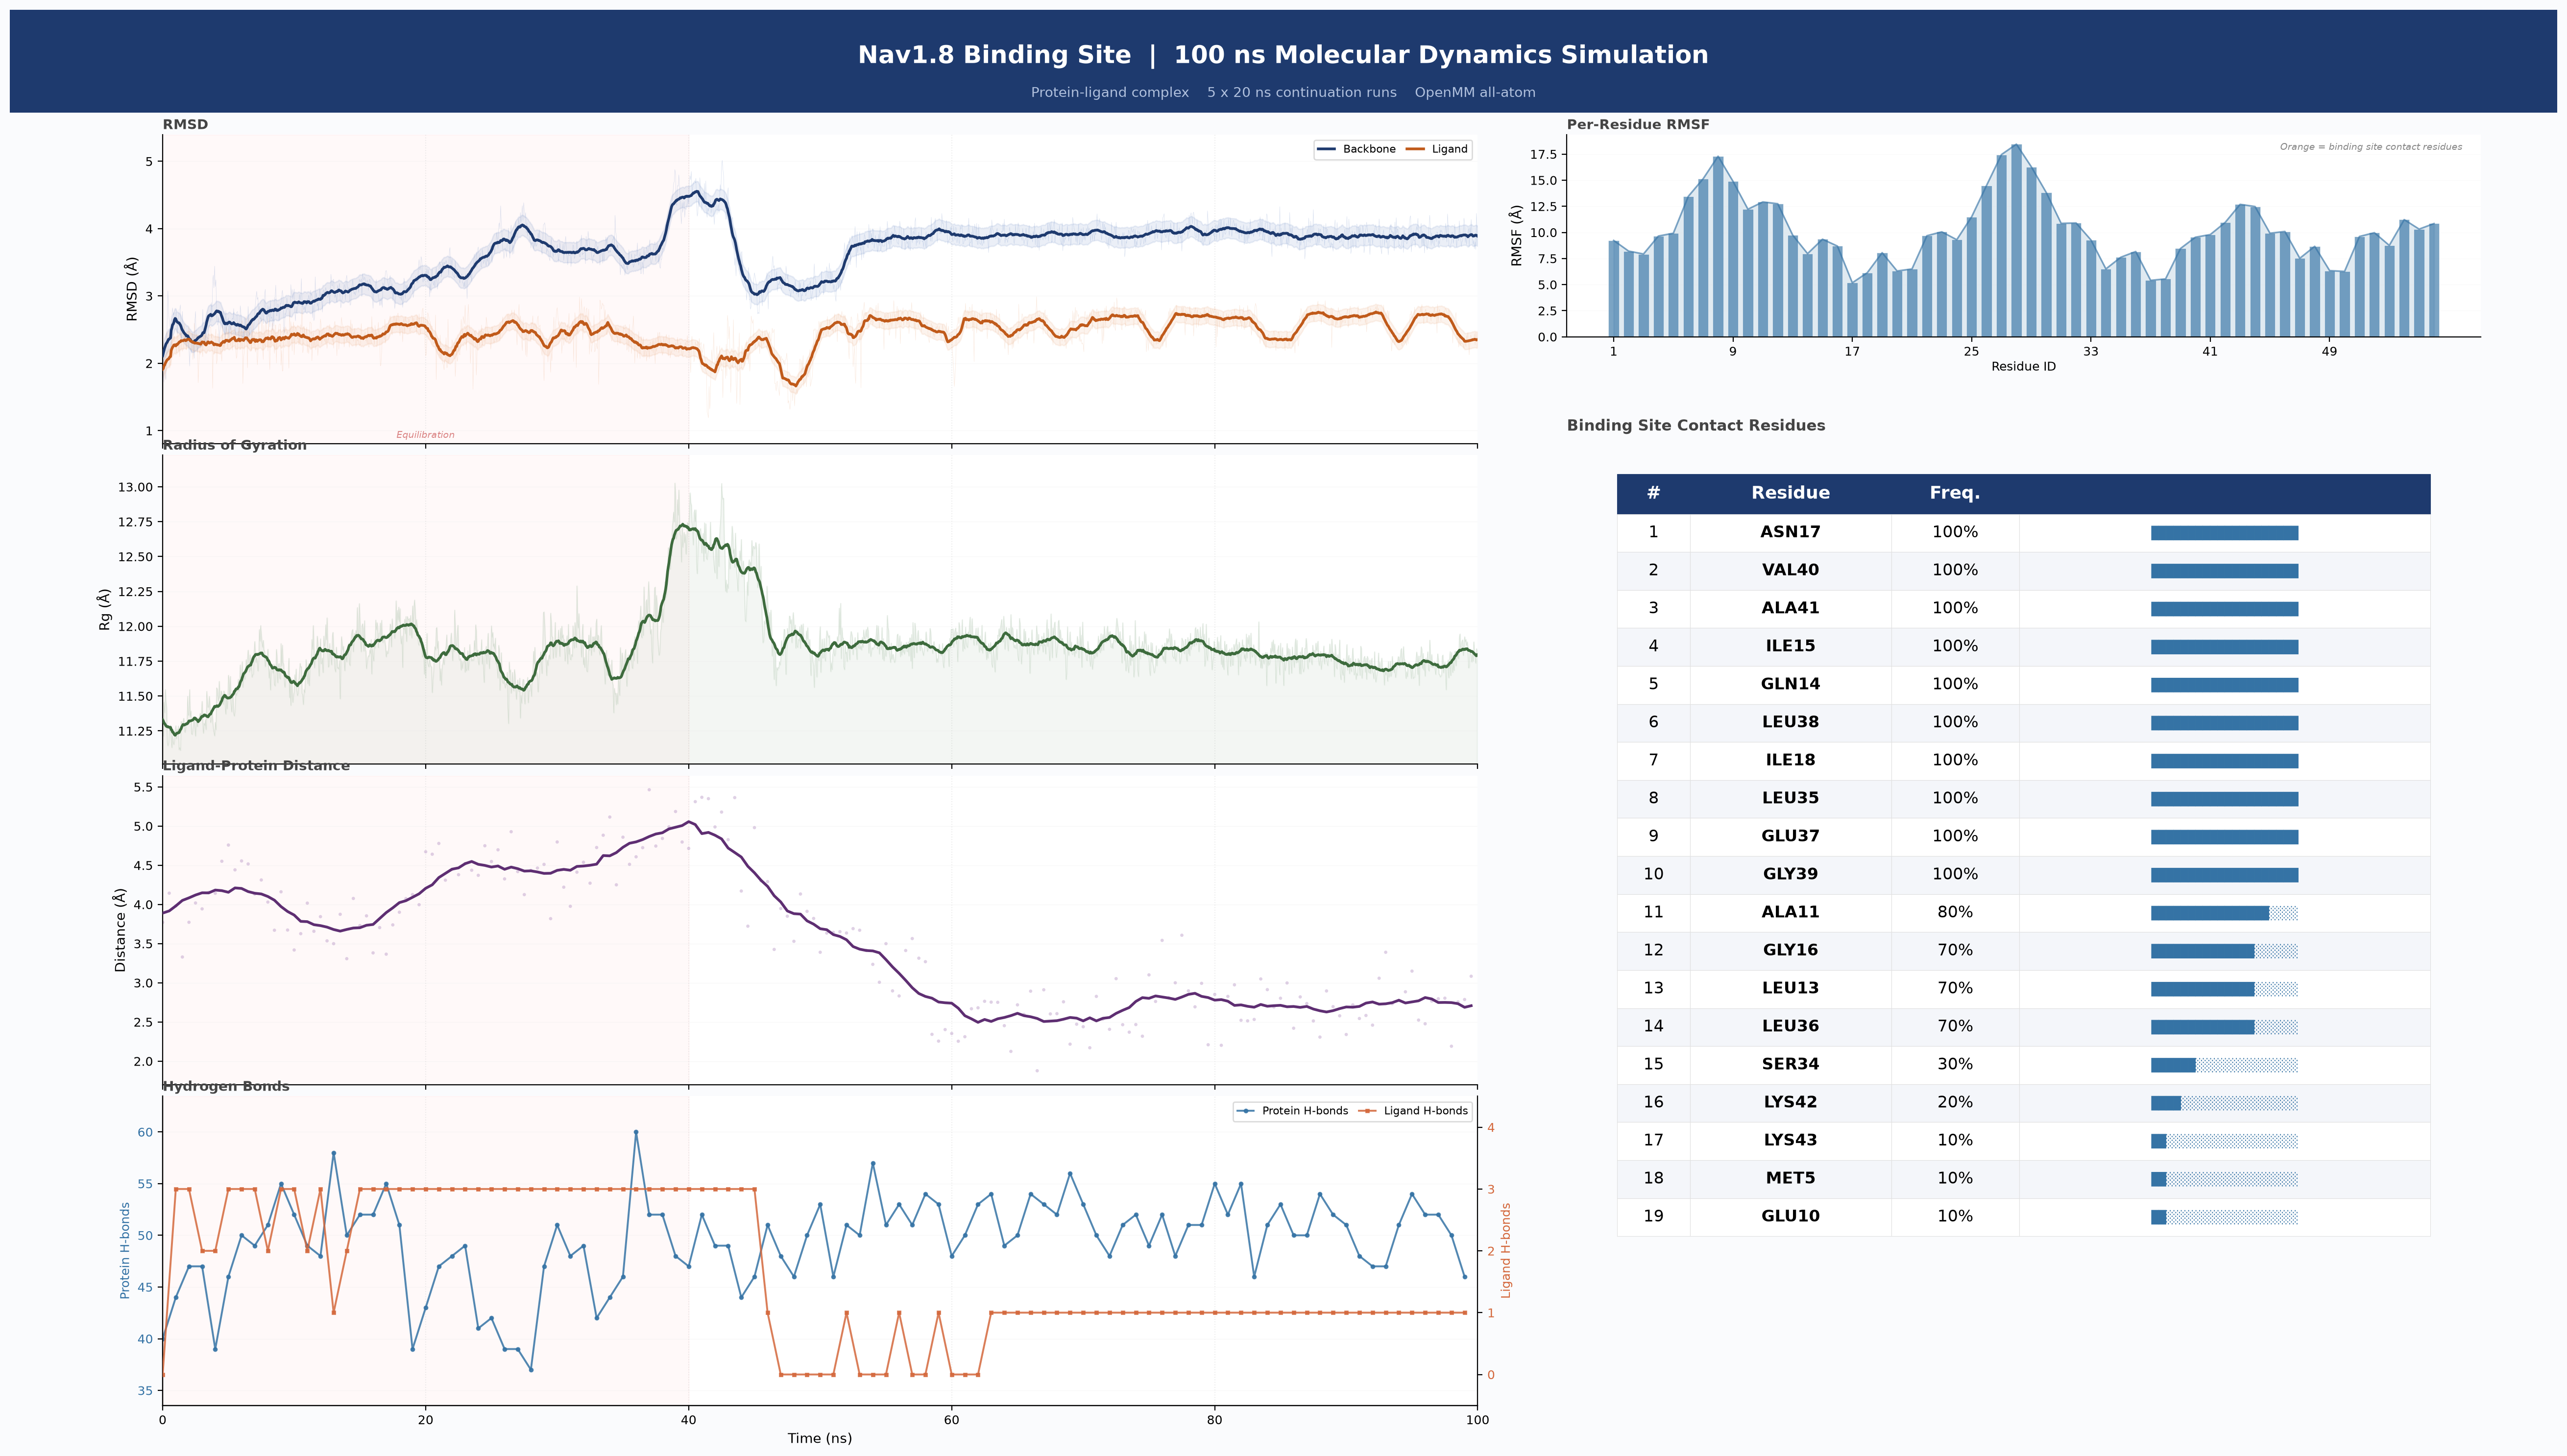
读法分子的位移在模拟中段一次重排后趋于平稳,它与蛋白的距离随之收敛;这是一次模拟里观察到的行为,是计算证据,不等于实测结合。
Nav1.8 与 PROTAC:一个展示取舍,一个暴露短板
Nav1.8 案例最能说明多目标选择。团队没有采用分子对接得分最好的候选,因为它预测的心脏毒性和血脑屏障穿透表现更差;最终推荐的分子对接得分稍弱,但整体取舍更合理,并继续做了 100 纳秒的分子动力学模拟。[S1]
这些得分只能帮助排序。分子对接、结构置信度和模拟稳定性都不是实验测出的亲和力、药理活性或临床效果。现在最多只能说,这些候选值得进入下一轮实验。
同一套权重,不代表每类分子都掌握得一样好
PROTAC 是这次发布里很有价值的失败案例。完整生成时,匹配测试中只有约 25% 的输出有效;加入 BRD4 条件后,结果还容易被拉回已知分子附近。LiteFold 目前改用分组件编辑:保留一部分,只重新生成连接体或目标结合部分。[S1]
这比把结果包装成“模型也会 PROTAC”更有信息量。LiteMol-1 目前更像 Agent 可以局部调用的分子编辑器,还不是一个端到端处理所有分子类别的通用生成器。
目前更像计算概念验证,而不是已验证的药物发现系统
第一条边界很明确:这次发布没有湿实验验证。ipTM、分子对接得分、预测的 ADMET 概率和分子动力学轨迹都属于计算代理指标,可以用于排序和提出假设,却不能等同于实验测出的亲和力、活性、毒性或降解效率。[S1]
第二条边界是可复现性。LiteFold 公开了研究页面和整体方法,但没有完整披露训练数据配比、损失权重、掩码配置和条件架构。这和 OpenBind-0 所强调的完整训练透明,不是同一种开放程度。[S1]
第三条边界来自分子类别覆盖。能用同一套权重处理多类分子,不代表每一种都掌握得同样好。PROTAC 的低有效率已经说明,LiteMol-1 离端到端的通用分子生成器还有明显距离。[S1]
05我从中学到什么
- 可迁移的洞见
- 为 Agent 设计科学模型时,调用成本本身就是系统能力:序列更紧凑、更好改,也更适合被反复调用。
- 设计启发
- 把昂贵的工具分层:便宜的生成先验负责探索,性质预测快速过滤,结构与动力学只验证缩小后的候选集。
- 阅读启发
- 看到「一套权重通吃多类分子」,要逐类核对有效率:PROTAC 的失败比一句「通用」更说明问题。
- 接下来看
- 看湿实验反馈:生成的候选真正被合成、被测量,这个计算概念验证才能变成经过验证的系统。
接口的可编辑性可能和单次生成精度一样重要
为 AI Agent 设计科学模型时,调用成本本身就是系统能力。序列更紧凑、容易修改,也更适合被反复调用。
生成模型不一定要直接交付最终答案
一个更便宜、能跑上十万次的生成先验,配合少量昂贵的验证,可能比第一步就调用最贵的工具更适合整个发现系统。
分子设计是权衡,不是单一分数最大化
Nav1.8 中分子对接得分最好的候选没有被推荐,因为其他预测风险更差。同时保留多个帕累托最优的候选假设,更接近真实的药物化学。
跨类别的“通用”必须逐类检查
支持小分子、多肽、大环和 PROTAC,不代表它们的有效率、可控性和下游可用性处在同一水平。PROTAC 的失败案例比一句“通用模型”更有信息量。
下一步需要的是湿实验反馈
SAPP/DMX 在解决怎样更快产生实验反馈,OpenBind 在问哪些实验数据最值得产生,LiteMol-1 则探索 Agent 怎样低成本生成下一批候选。把这些环节接起来,才接近 Generate → Evaluate → Experiment → Learn → Generate again。
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。