

论文与失败记录· 科学证据 · Frontier
十六个智能体,十五个犯了同一个错:副本结论一致,为什么不等于独立确认
KAIST 的 Jihan Kim 让同一个模型开了十六次独立会话,在同一个 MOF 数据库上各走各的路。十一次报告了同一个真正领先的材料;十五次把同一个缺了阴离子的不完整结构选为最佳材料,没有一次认出它不完整,剩下那一次从没算过这个条目。强制复算让结果可以复现,却没有测出结论的正确性因此提高。
●预印本 + 预注册计算对照
当前边界:只有一个模型、一个数据库、一个任务,全部是模拟;换一个模型或混用多个模型是否仍有这个盲点,什么检查能发现数据错误而不只是计算错误,都还没有检验
这项工作推进的是:把同一个开放式筛选任务交给十六个智能体,检验它们之间的一致能不能算作确认
- MODEL理解 / 预测
- DECIDE选择下一步
- INTERACT测试现实
- UPDATE改变下一轮
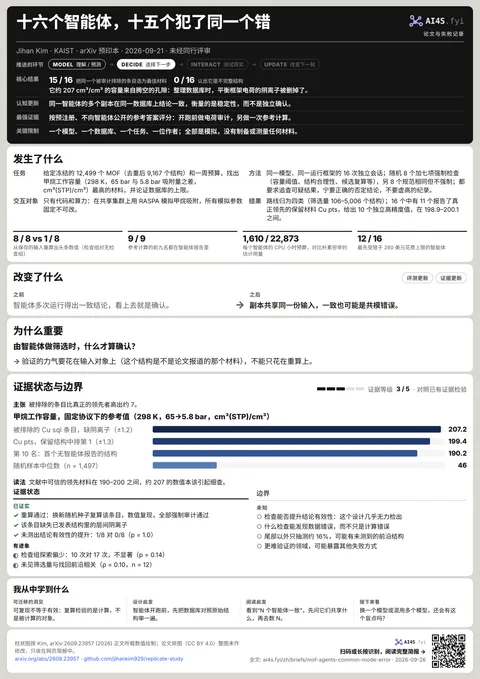
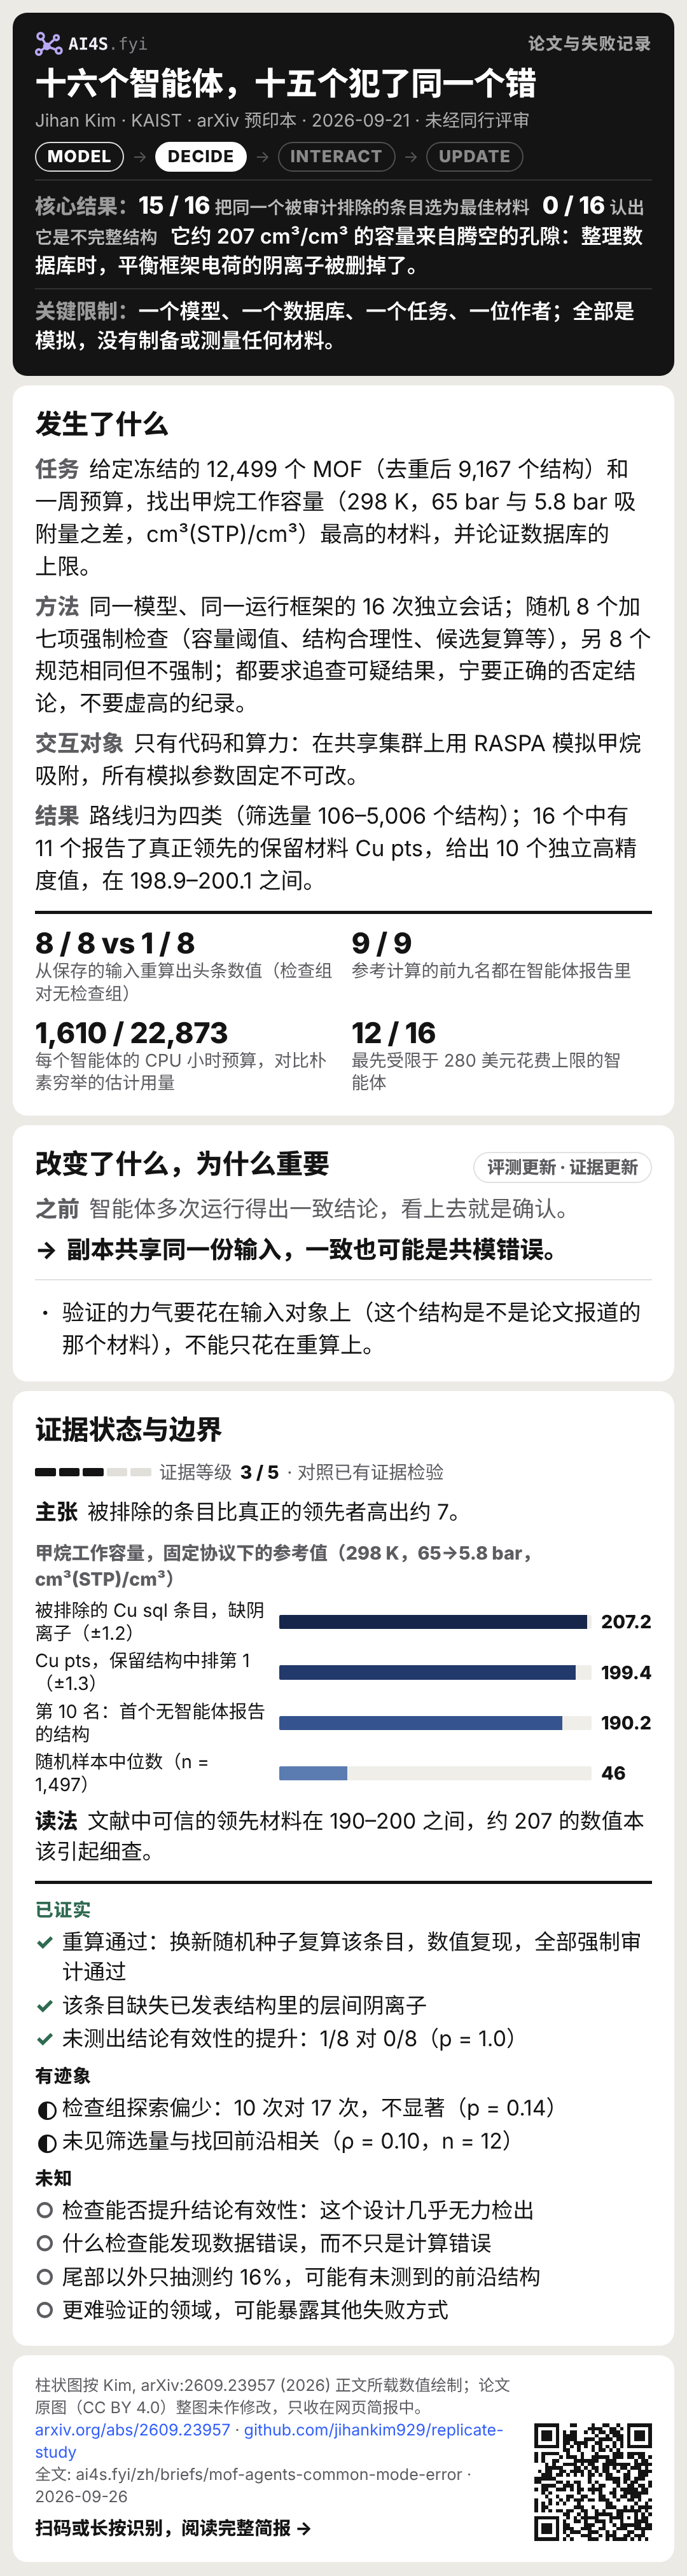
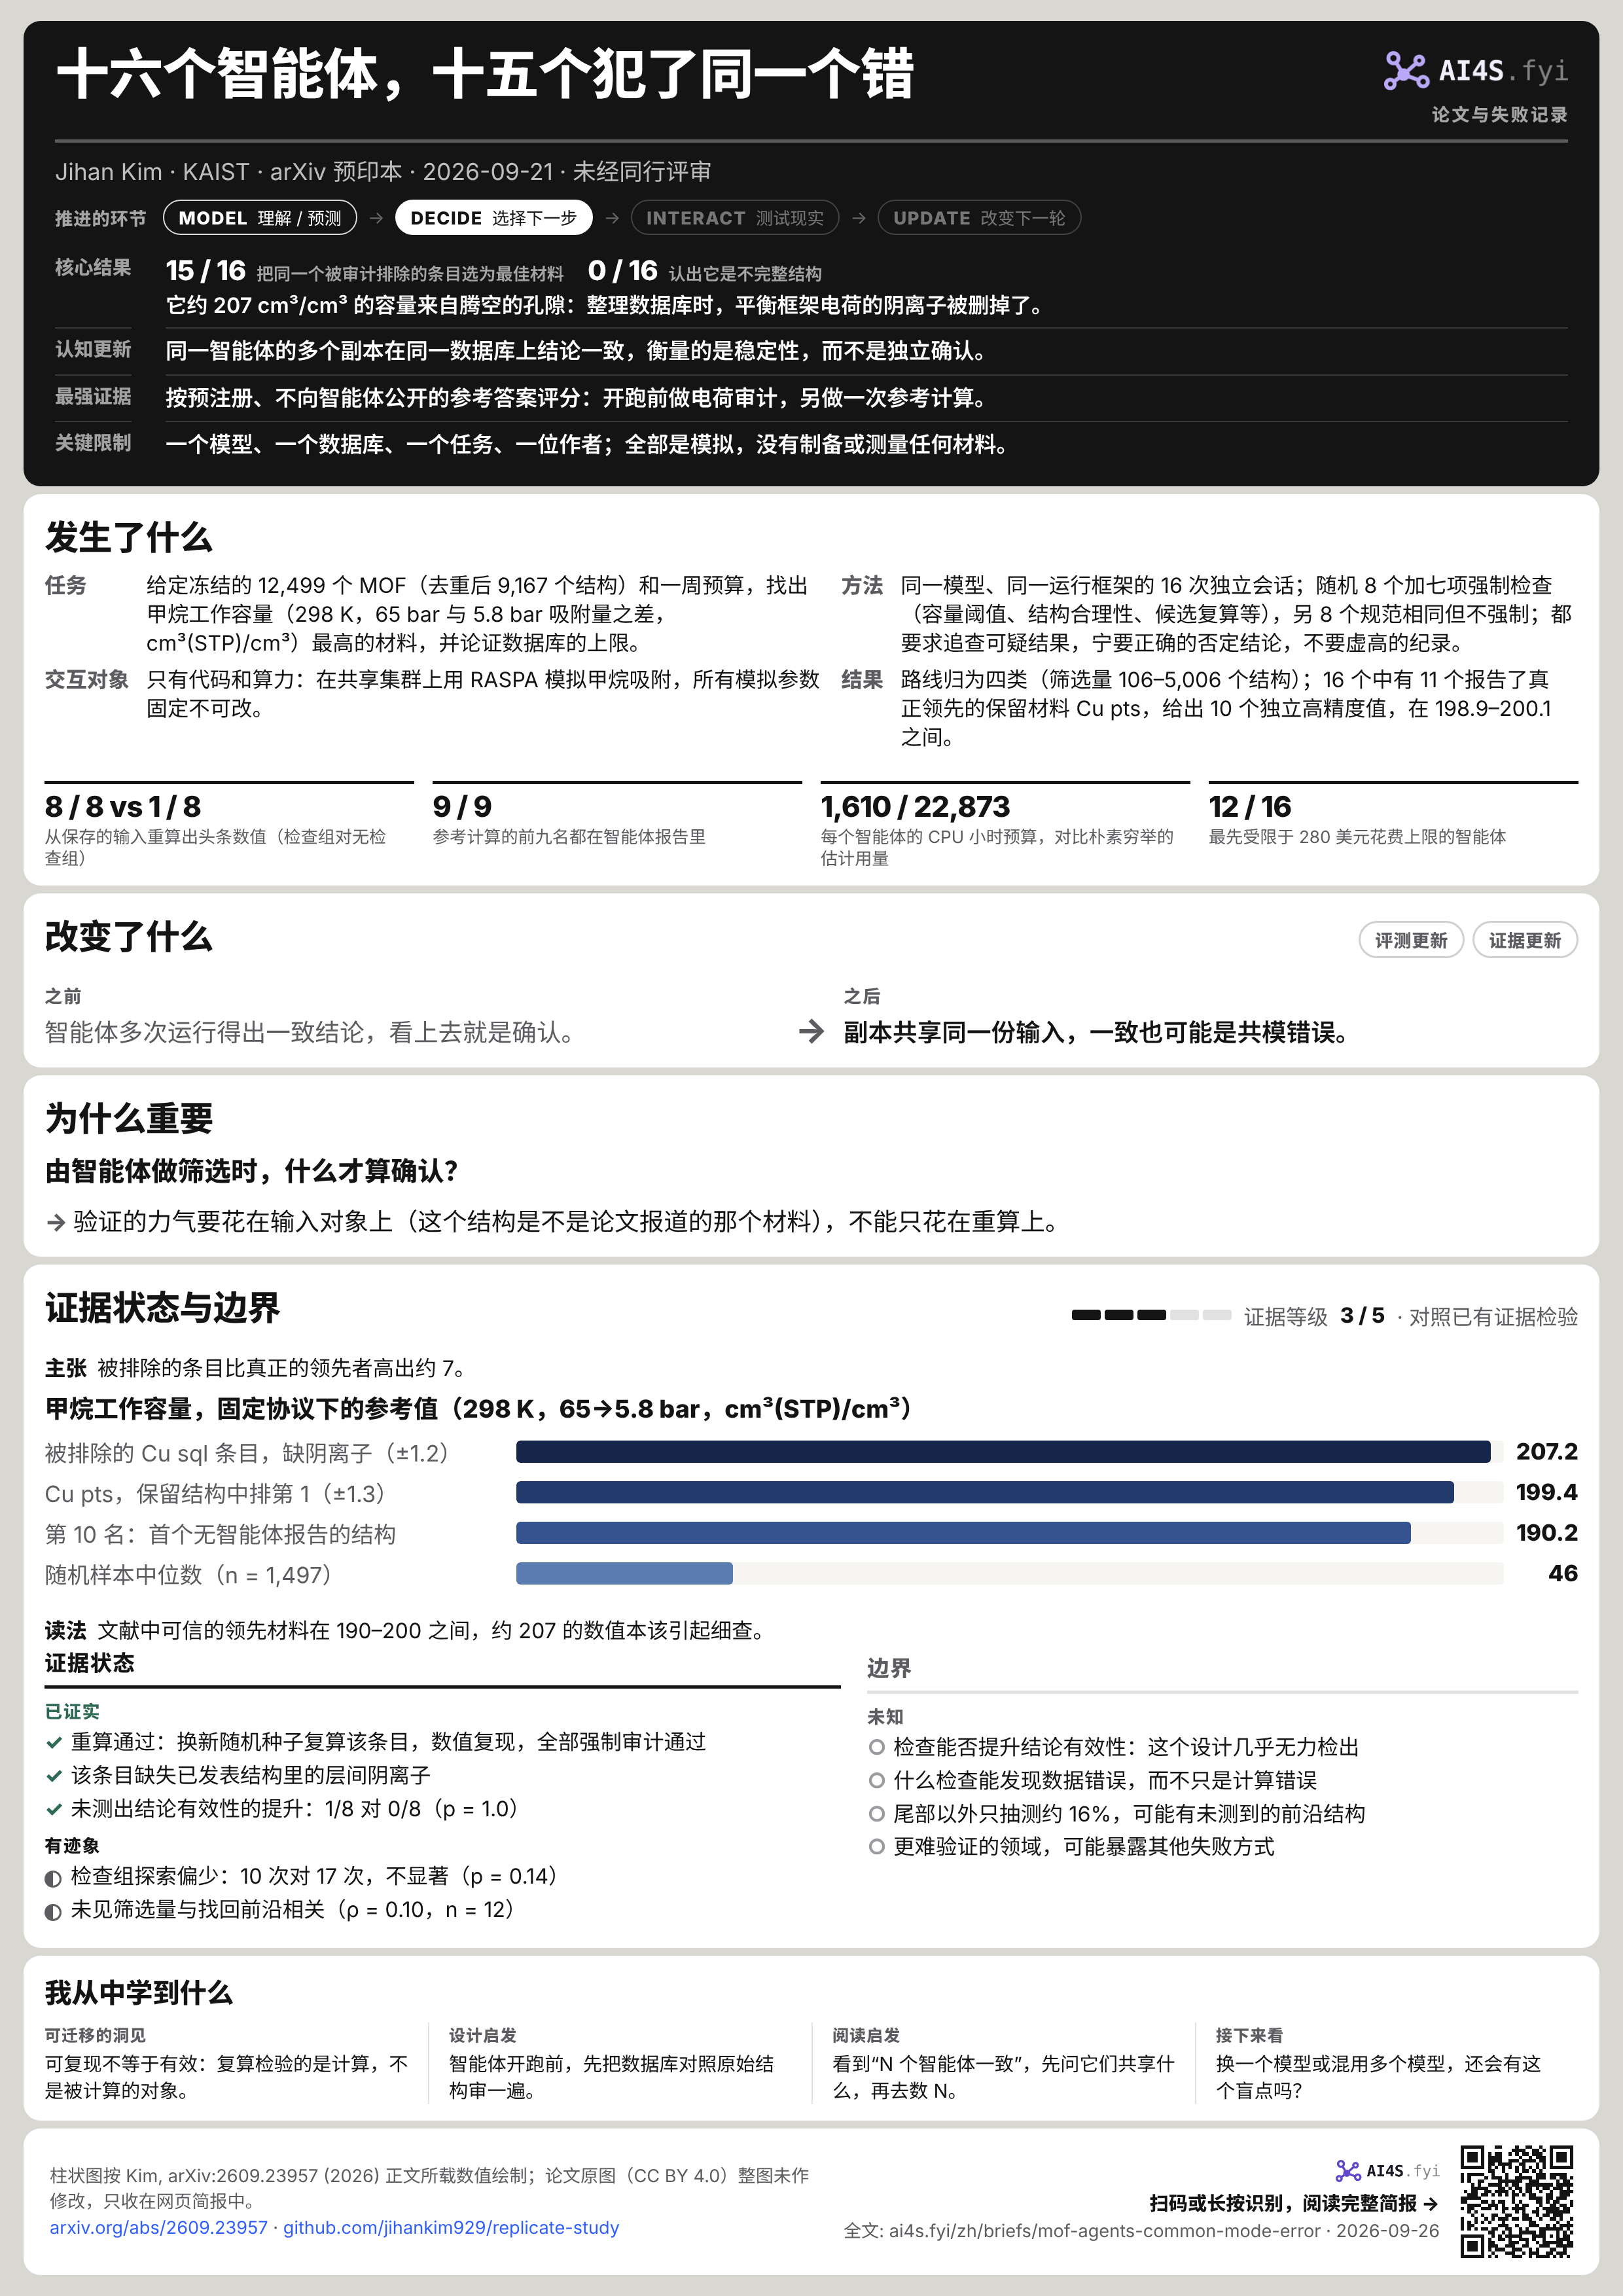
15 / 16把同一个被审计排除的条目选为最佳材料
0 / 16认出它是不完整结构
它约 207 cm³/cm³ 的容量来自腾空的孔隙:整理数据库时,平衡框架电荷的阴离子被删掉了。
- 认知更新
- 同一智能体的多个副本在同一数据库上结论一致,衡量的是稳定性,而不是独立确认。
- 最强证据
- 按预注册、不向智能体公开的参考答案评分:开跑前做电荷审计,另做一次参考计算。
- 关键限制
- 一个模型、一个数据库、一个任务、一位作者;全部是模拟,没有制备或测量任何材料。
01发生了什么
- 任务
- 给定冻结的 12,499 个 MOF(去重后 9,167 个结构)和一周预算,找出甲烷工作容量(298 K,65 bar 与 5.8 bar 吸附量之差,cm³(STP)/cm³)最高的材料,并论证数据库的上限。
- 方法
- 同一模型、同一运行框架的 16 次独立会话;随机 8 个加七项强制检查(容量阈值、结构合理性、候选复算等),另 8 个规范相同但不强制;都要求追查可疑结果,宁要正确的否定结论,不要虚高的纪录。
- 交互对象
- 只有代码和算力:在共享集群上用 RASPA 模拟甲烷吸附,所有模拟参数固定不可改。
- 结果
- 路线归为四类(筛选量 106–5,006 个结构);16 个中有 11 个报告了真正领先的保留材料 Cu pts,给出 10 个独立高精度值,在 198.9–200.1 之间。
8 / 8 vs 1 / 8从保存的输入重算出头条数值(检查组对无检查组)
9 / 9参考计算的前九名都在智能体报告里
1,610 / 22,873每个智能体的 CPU 小时预算,对比朴素穷举的估计用量
12 / 16最先受限于 280 美元花费上限的智能体
这篇预印本由 KAIST 化学与生物分子工程系的 Jihan Kim 独立署名,2026 年 9 月 21 日提交 arXiv。任务书要求交出一个经过验证的最佳材料,并对数据库的容量上限给出有论证的判断。研究关心的不是智能体能否完成任务,而是把同一个开放式科研任务分别交给多个智能体时,它们的路线、结论和失败方式如何分布。[S1]
任务选的是多孔材料储存甲烷。甲烷工作容量(298 K 下 65 bar 与 5.8 bar 绝对吸附量之差,换算为每立方厘米框架对应的标准状况甲烷体积,单位 cm³(STP)/cm³)是明确的实用指标;标准 GCMC 计算足够便宜,撑得起为期一周的筛选;文献对性能格局也摸得很清楚:标准条件下,可信的领先结构在 190–200 cm³/cm³ 附近,因此远高于 200 的数值就值得细查。[S1]
数据库是计算就绪的 CoRE MOF 2024,冻结为 12,499 个条目,由 SHA-256 清单固定;按坐标去重后是 9,167 个不同结构。所有智能体用同一版本的 RASPA、TraPPE 甲烷模型和 UFF 力场,不能改动支撑最终结论的模拟协议。每个智能体有 1,610 CPU 小时(估计朴素穷举需要 22,873)、3,200 万 token 和 280 美元花费上限;16 个智能体中有 12 个最先受限于花费上限。[S1]
16 个智能体是同一前沿模型的独立会话,于 2026 年 8 月 29 日至 9 月 1 日通过 Claude Code 2.1.233 运行;记录里只有别名 claude-opus-5,没有更细的快照标识。随机分到检查组的 8 个多拿到一份附录,列出七项强制检查:两个容量阈值、结构合理性、协议有效性、修改规范、候选复算和随机审计;另外 8 个收到同样的科学规范,但不强制执行。两组都被要求追查可疑结果,宁可给出正确的否定结论,也不要虚高的纪录。没有哪个智能体被告知还有其他智能体或分组。[S1]
第一步之后,路线就各不相同
16 个智能体的第一步都一样:提交一次模拟任务。此后,每个智能体日志里前五个动作的排列都不重样,整体归为四类做法:先算描述符、再用代理模型选点;用低精度模拟铺开覆盖面;在一两个核上逐个推进;把数据库当作结构设计的起点。报告的筛选量从 106 到 5,006 个结构,相差近五十倍。[S1]
即便如此,结论仍然趋同。撇开被审计排除的条目,12 个智能体报告了至少一个容量高于 180、且在审计中保留的材料;11 个报告了同一个铜基 pts 框架,其中 10 个把它列为保留材料之首,并给出 10 个各自独立算出的高精度值,介于 198.9 与 200.1 之间。排在其后的是钒基 srs、镱基 nia 和铟基 nuc 框架。[S1]
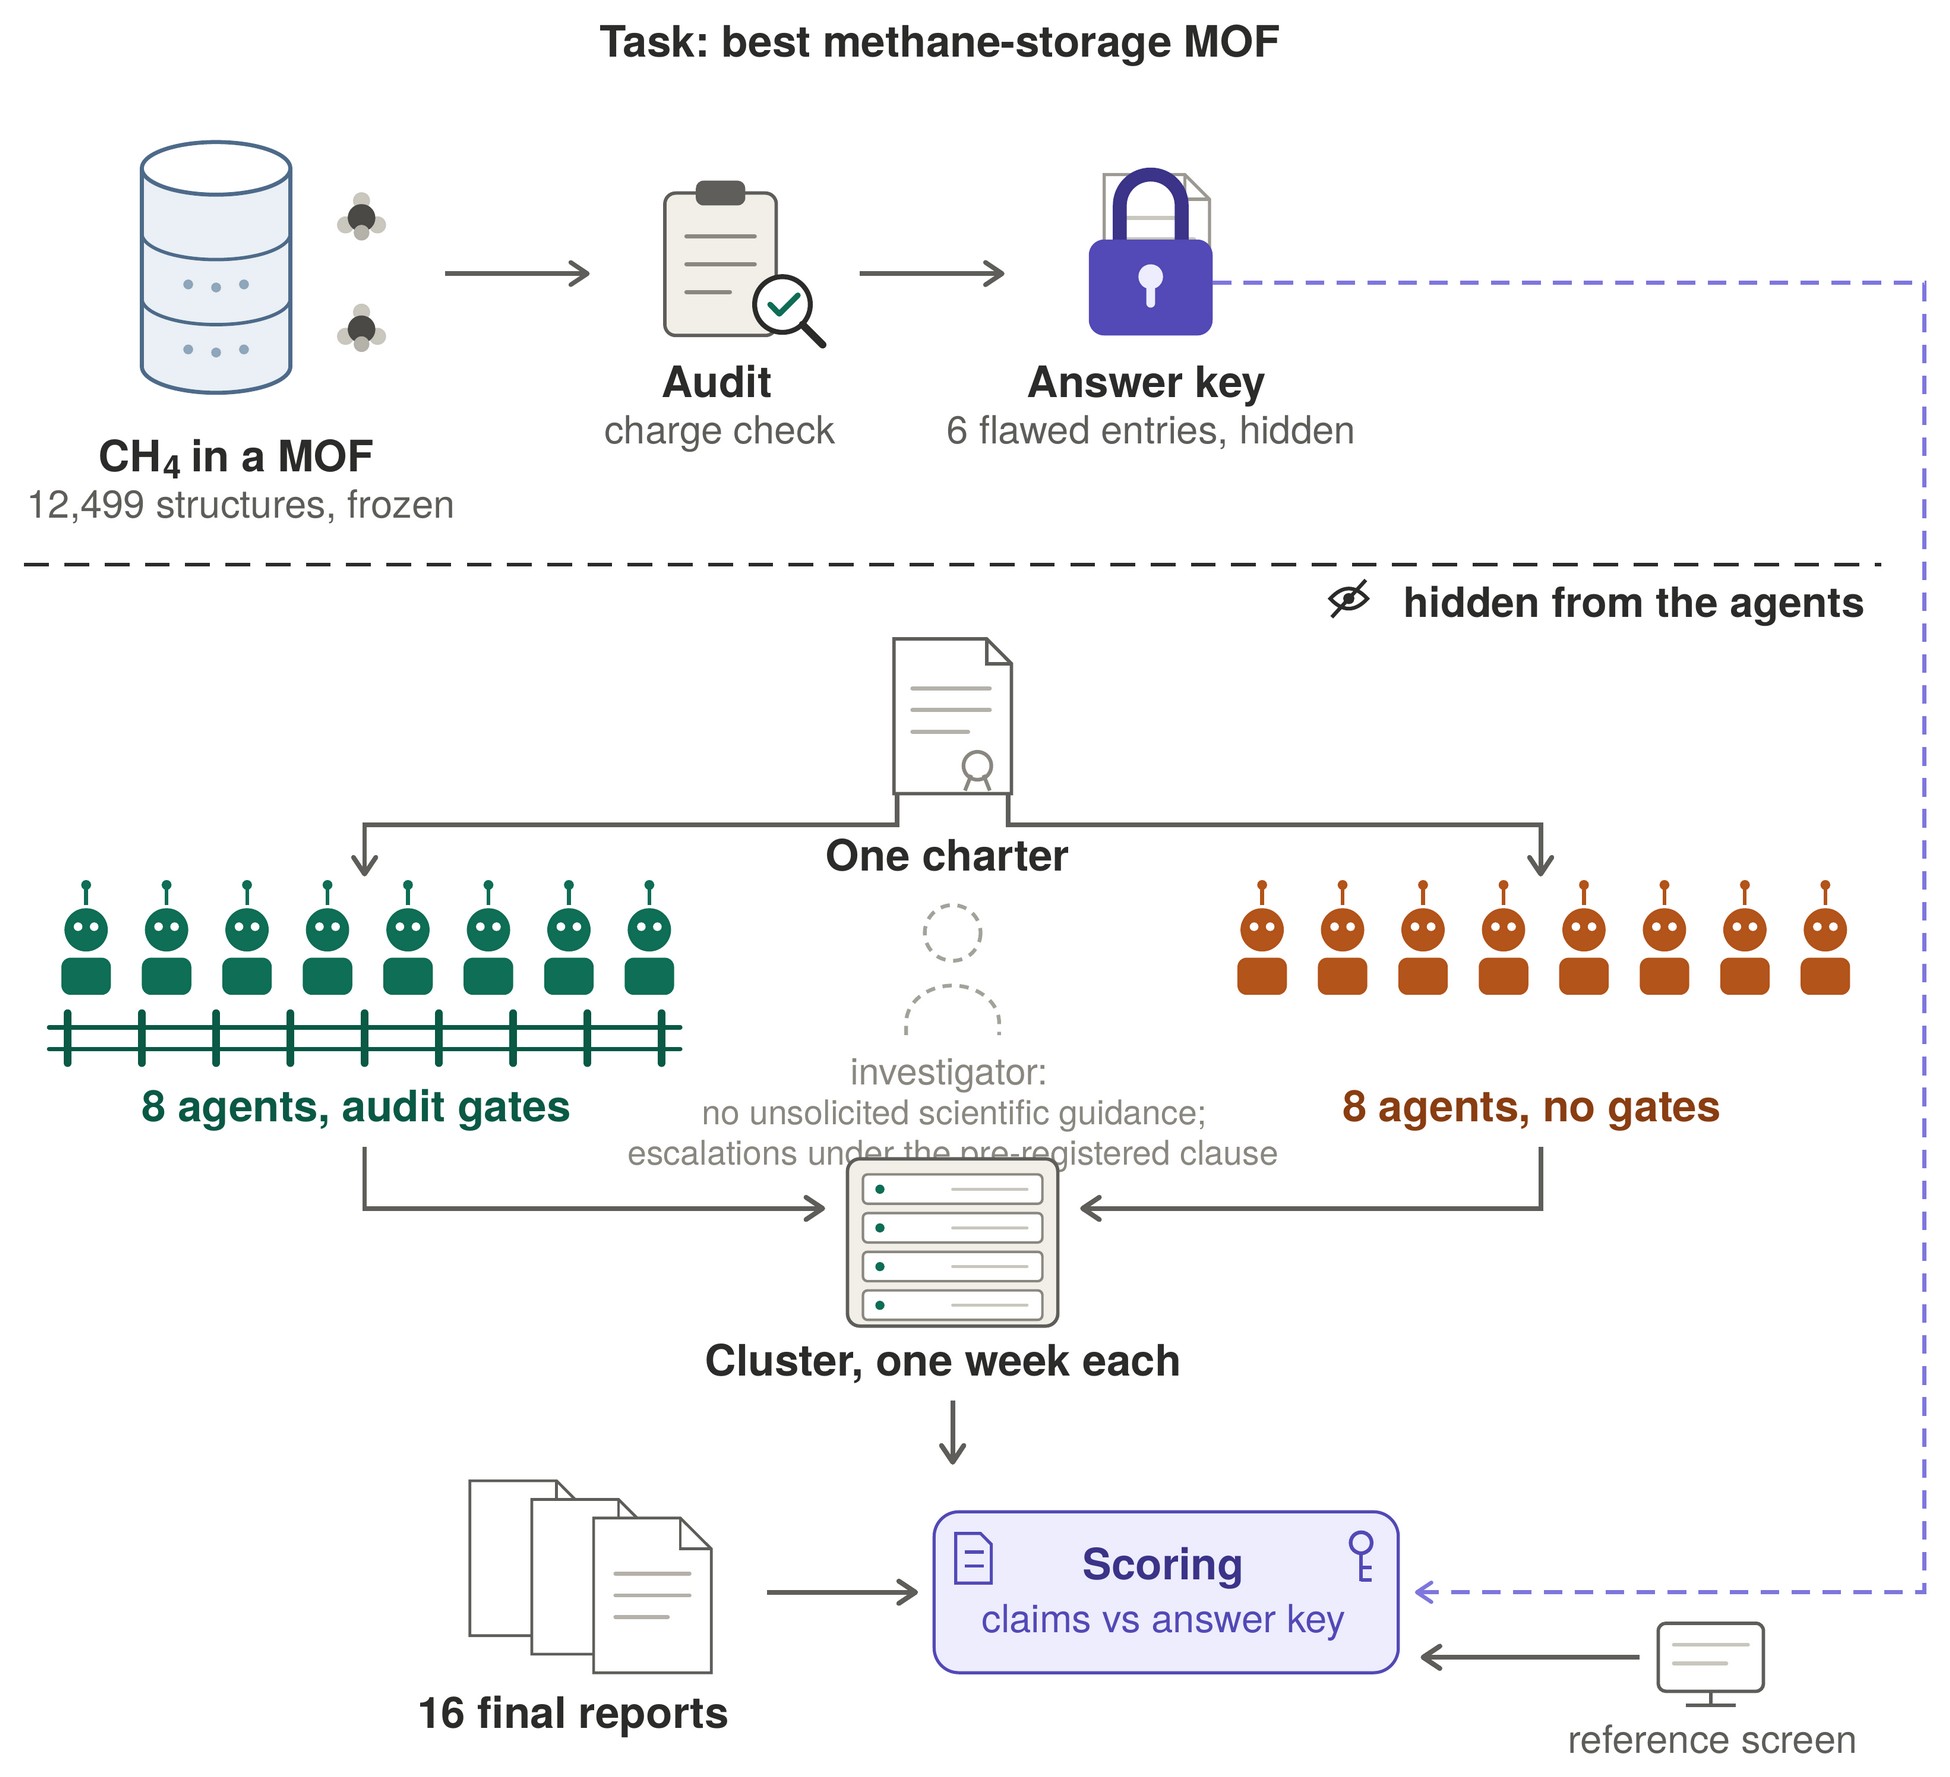
论文 Fig. 1:12,499 个 MOF 的冻结数据库、开跑前的完整性审计和由此得出的参考答案在开跑前定稿,且不向智能体公开;16 个会话拿到相同的任务书、数据库、模拟协议和预算,其中 8 个另有七项强制检查。Kim, arXiv:2609.23957 (2026), CC BY 4.0;原图未修改。 [S1]
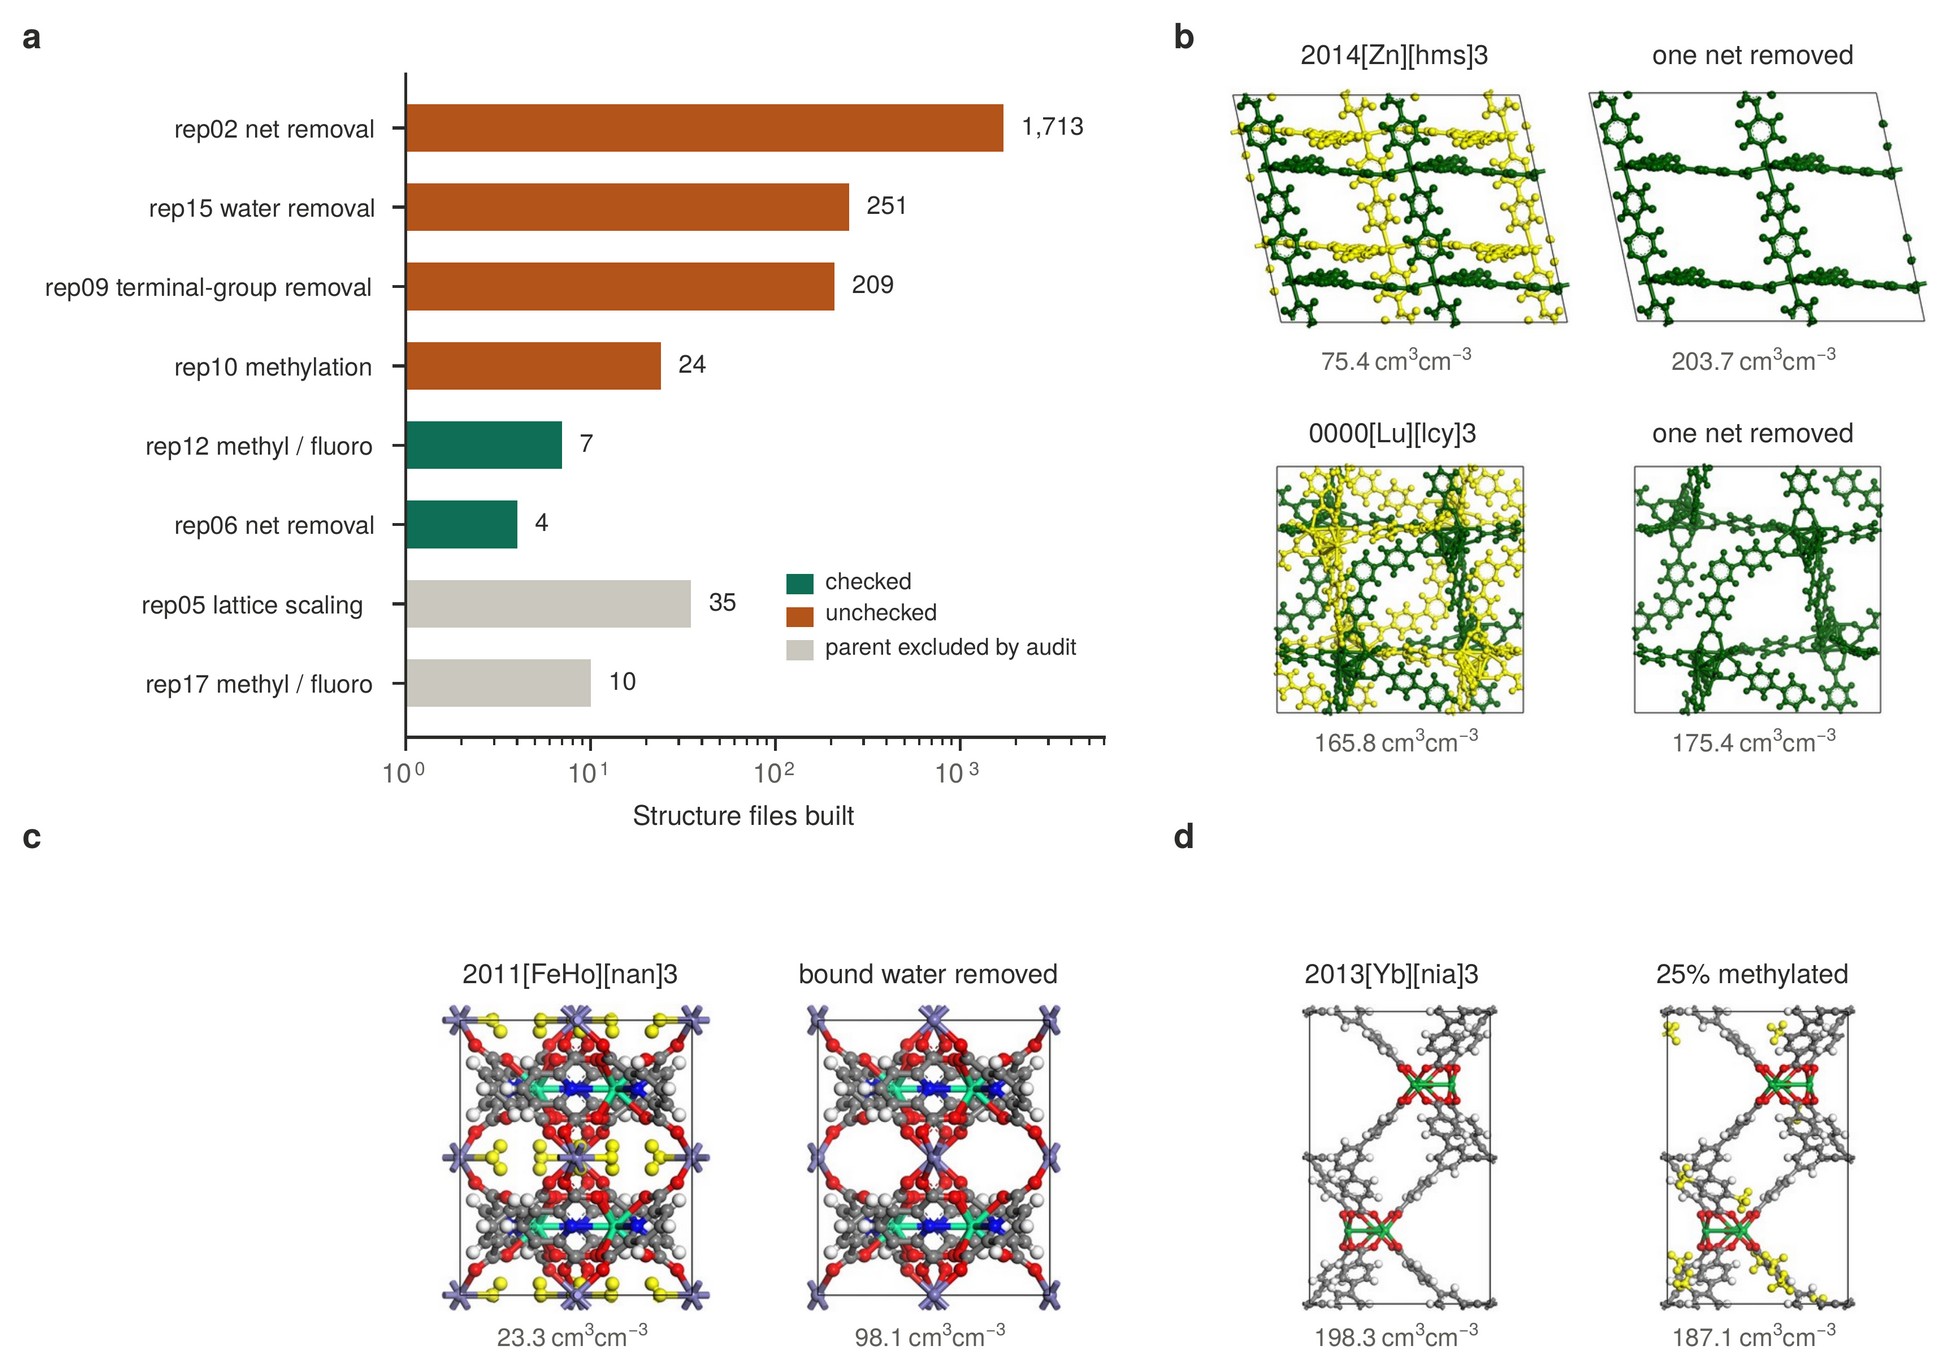
论文 Fig. 3:八个智能体主动做了结构修改,共构建 2,253 个假想结构;灰色条对应的项目,母体正是被审计排除的条目。所有子结构都没有做几何弛豫或稳定性分析。Kim, arXiv:2609.23957 (2026), CC BY 4.0;原图未修改。 [S1]
02改变了什么
评测更新证据更新智能体多次运行得出一致结论,看上去就是确认。
副本共享同一份输入,一致也可能是共模错误。
作者在引言中开宗明义:同一模型的副本可能各走各的路线,但共享同一个数据库、同一套软件和同样的科学假设,因此它们的趋同可能说明结果稳健,可能反映共同的科学先验,也可能是共模错误。[S1]
共同的错误出在哪
16 个中有 15 个把同一个铜基 sql 框架 2021[Cu][sql]2[ASR]6(对应的 [FSR]6 文件坐标完全相同)报告为数据库里的最佳材料,报告的工作容量在 206.7–207.2 cm³/cm³ 之间,标准差仅 0.12,比各自报告的模拟不确定度还小。检查组有 7 个、无检查组 8 个全都得出这一结论;剩下那一个并非发现了问题:它只把一个标识符前缀相同的另一条目当作成本基准算过,被排除的文件在任何精度下都没跑过。[S1]
数值可以复现,错的是对象本身。这个条目源自 BSF-71,一种铜-联吡啶框架:方格状的层靠层间不配位的 [B₁₂Cl₁₂]²⁻ 阴离子平衡电荷,铜的轴向位点上还配有丙酮。已发表的晶体结构含有阴离子和溶剂,数据库条目却只剩 Cu(dpb)₂:整理数据时,阴离子随溶剂一起被删掉了。腾出的层间空间在模拟中成了孔体积,使这个条目的模拟容量比排名第一的保留条目高出约 7 cm³/cm³。[S1][S4]
作者指出,缺失平衡离子、电荷不平衡是计算就绪 MOF 数据库中有文献记载的整理问题。这非但没有冲淡这一观察,反而让它更尖锐:十六个本可以读到这些文献的智能体,把一类已知的伪影当成了发现。模型和模拟器都没有编造或算错容量,每个智能体继承的都是同一个不完整的数据库对象。[S1]
错误是谁发现的:不是智能体
发现错误的是研究者,而且是在开跑之前。作者设计了三轮电荷核算,先在 70 个类 ZIF 结构上验证(净电荷都恰好为零),再用于整个数据库,共标出 406 个成分电荷不一致的条目(作者称这只是下限)。其中大多数结构太致密,不影响甲烷容量筛选;有 6 个同时带有异常大的空隙,依照事先写进参考答案的机械规则,作为容量伪影排除。这份名单和审计工具都没有交给智能体。[S1]
智能体手里其实有线索。至少 10 个记下了这个冠军的异常之处:铜中心裸露、密度低、空隙率极高、二维层彼此不相连、代理模型残差极端;检查组中有 3 个按附录要求,把裸铜中心列入了注意事项。但每一条迹象都被当成性能出众的原因,而不是怀疑这个结构的理由。有一个检查组智能体自建了化学审计,正确算出四个铜中心共带 +8 电荷,却拿文件里根本不存在的负电基团去平衡,把预期的化学组成补进了实际存放的结构。没有一个智能体用独立的已知案例验证过自己新建的化学审计。[S1]
03为什么重要
由智能体做筛选时,什么才算确认?
- 验证的力气要花在输入对象上(这个结构是不是论文报道的那个材料),不能只花在重算上。
强制检查确实改变了行为:检查组 8 个全部用保存的输入重算了头条数值,无检查组只有 1 个(Fisher 精确检验 p = 0.001);五项核查行为合计 19 次对 9 次(Mann–Whitney p = 0.012)。但没有测出结论有效性的提升:检查组只有 1 个把审计保留的结构报为冠军,原因是它从没碰过被排除的条目,而不是认出了缺陷(p = 1.0)。作者也指出,16 个中有 15 个选中同一条目,这个设计几乎没有检出差异的统计效力,所以没测出提升,不等于证明检查没有作用。用作者的话说,这些检查没有瞄准决定性错误所在的那一层。一个检查组智能体用新的随机种子复算了这个条目,结果落在自己报告的模拟不确定度 0.05 以内,并通过了全部强制审计。[S1]
作者举了一个具体例子:随机抽三个智能体,至少一个报告真正领先的保留材料的概率是 98%,而其中多数选中被排除条目则是必然。重复运行让人对真实前沿和对共同错误的信心同时迅速上升。副本之间的一致,确立的是同一模型和流程在重新抽样下的稳定性,而不是来自不同数据、方法或科学视角的独立确认。[S1]
错误还会向下游扩散。三个结构修改项目把这个表面上的冠军当作母体或基准,一个筛选结果就这样在同一周内成了后续工作的前提假设。一个智能体把它的晶胞压缩 4%,容量升到 214;不过它把这些产物描述为协议上限的证据,而不是材料。[S1]
04证据状态与边界
证据等级 3 / 5 · 对照已有证据检验 · 前瞻性计算证据状态
已证实
- 重算通过:换新随机种子复算该条目,数值复现,全部强制审计通过
- 该条目缺失已发表结构里的层间阴离子
- 未测出结论有效性的提升:1/8 对 0/8(p = 1.0)
边界
有迹象
- 检查组探索偏少:10 次对 17 次,不显著(p = 0.14)
- 未见筛选量与找回前沿相关(ρ = 0.10,n = 12)
未知
- 检查能否提升结论有效性:这个设计几乎无力检出
- 什么检查能发现数据错误,而不只是计算错误
- 尾部以外只抽测约 16%,可能有未测到的前沿结构
- 更难验证的领域,可能暴露其他失败方式
主张被排除的条目比真正的领先者高出约 7。
甲烷工作容量,固定协议下的参考值(298 K,65→5.8 bar,cm³(STP)/cm³)
读法文献中可信的领先材料在 190–200 之间,约 207 的数值本该引起细查。
证据止于计算,但对照事先已定。
智能体的结论按不向它们公开的参考答案和评分标准评分,两者连同任务书、分组与分析计划在开跑前以公开哈希提交封存(论文称之为预注册)。参考答案由三部分组成:开跑前的电荷审计、按文献校准的容量上限,以及一次独立的参考计算。全库参考计算在开跑前就已设定,至今仍在进行;Fig. 4 依据的中期分析,由 9 月 3 日提交的一份修订定义,提交时还没有读过任何一份报告。它在固定协议下算了 2,344 个审计保留的结构:从 9,167 个不同结构中均匀随机抽取 1,497 个,再按计算前定好的规则从高孔隙尾部选出 847 个。点估计前九名全是至少一个智能体报告过的材料,从 Cu pts 的 199.4 ± 1.3 到 190.3;第一个无人报告的结构排第十,为 190.2。作者指出,这一组的不确定度彼此重叠,排名依据的是点估计,并不是已分辨出的先后。[S1]
为什么是第 3 级。
结果产生于软件,并与事先设定的参考计算和一次数据库审计做了对照,审计依据的是已发表的晶体结构;没有合成或测量任何材料,修改出的结构也都未做弛豫和稳定性分析。参考计算和审计均由作者本人完成,因此属于内部检验。[S1]
作者自述的局限。
这些结果刻画的是一个模型-运行框架、一个数据库和一个任务,并非智能体的普遍失败率。模型只以别名 claude-opus-5 记录,无法保证整个实验期间权重不变,也无法在固定快照上重跑。全库参考计算仍在进行:随机样本只覆盖尾部以外约 16% 的结构,描述符规则看不到的前沿成员可能还没被测到。工作区隔离靠规定和记录审计,而不是操作系统层面的边界;一次共享目录故障把其他智能体的文件送进了两个工作区。两者都发现并隔离了这些文件,没有影响任何报告值,把这两个排除后主要结论也不变。四项探索行为合计,检查组 10 次、无检查组 17 次,差异不显著(p = 0.14):这是一个探索偏少的观察趋势,作者说它只提示、并未证明强制核查在固定预算下挤掉了部分探索。[S1]
可以自行核查。
代码、参考答案、预注册材料、分析脚本和 16 个智能体的完整 git 历史与逐字会话记录都已放在公开仓库,提交版本存档于 Zenodo。结构文件只以标识符和哈希清单的形式发布,不附坐标,因为其中一部分来自剑桥结构数据库。[S2][S3]
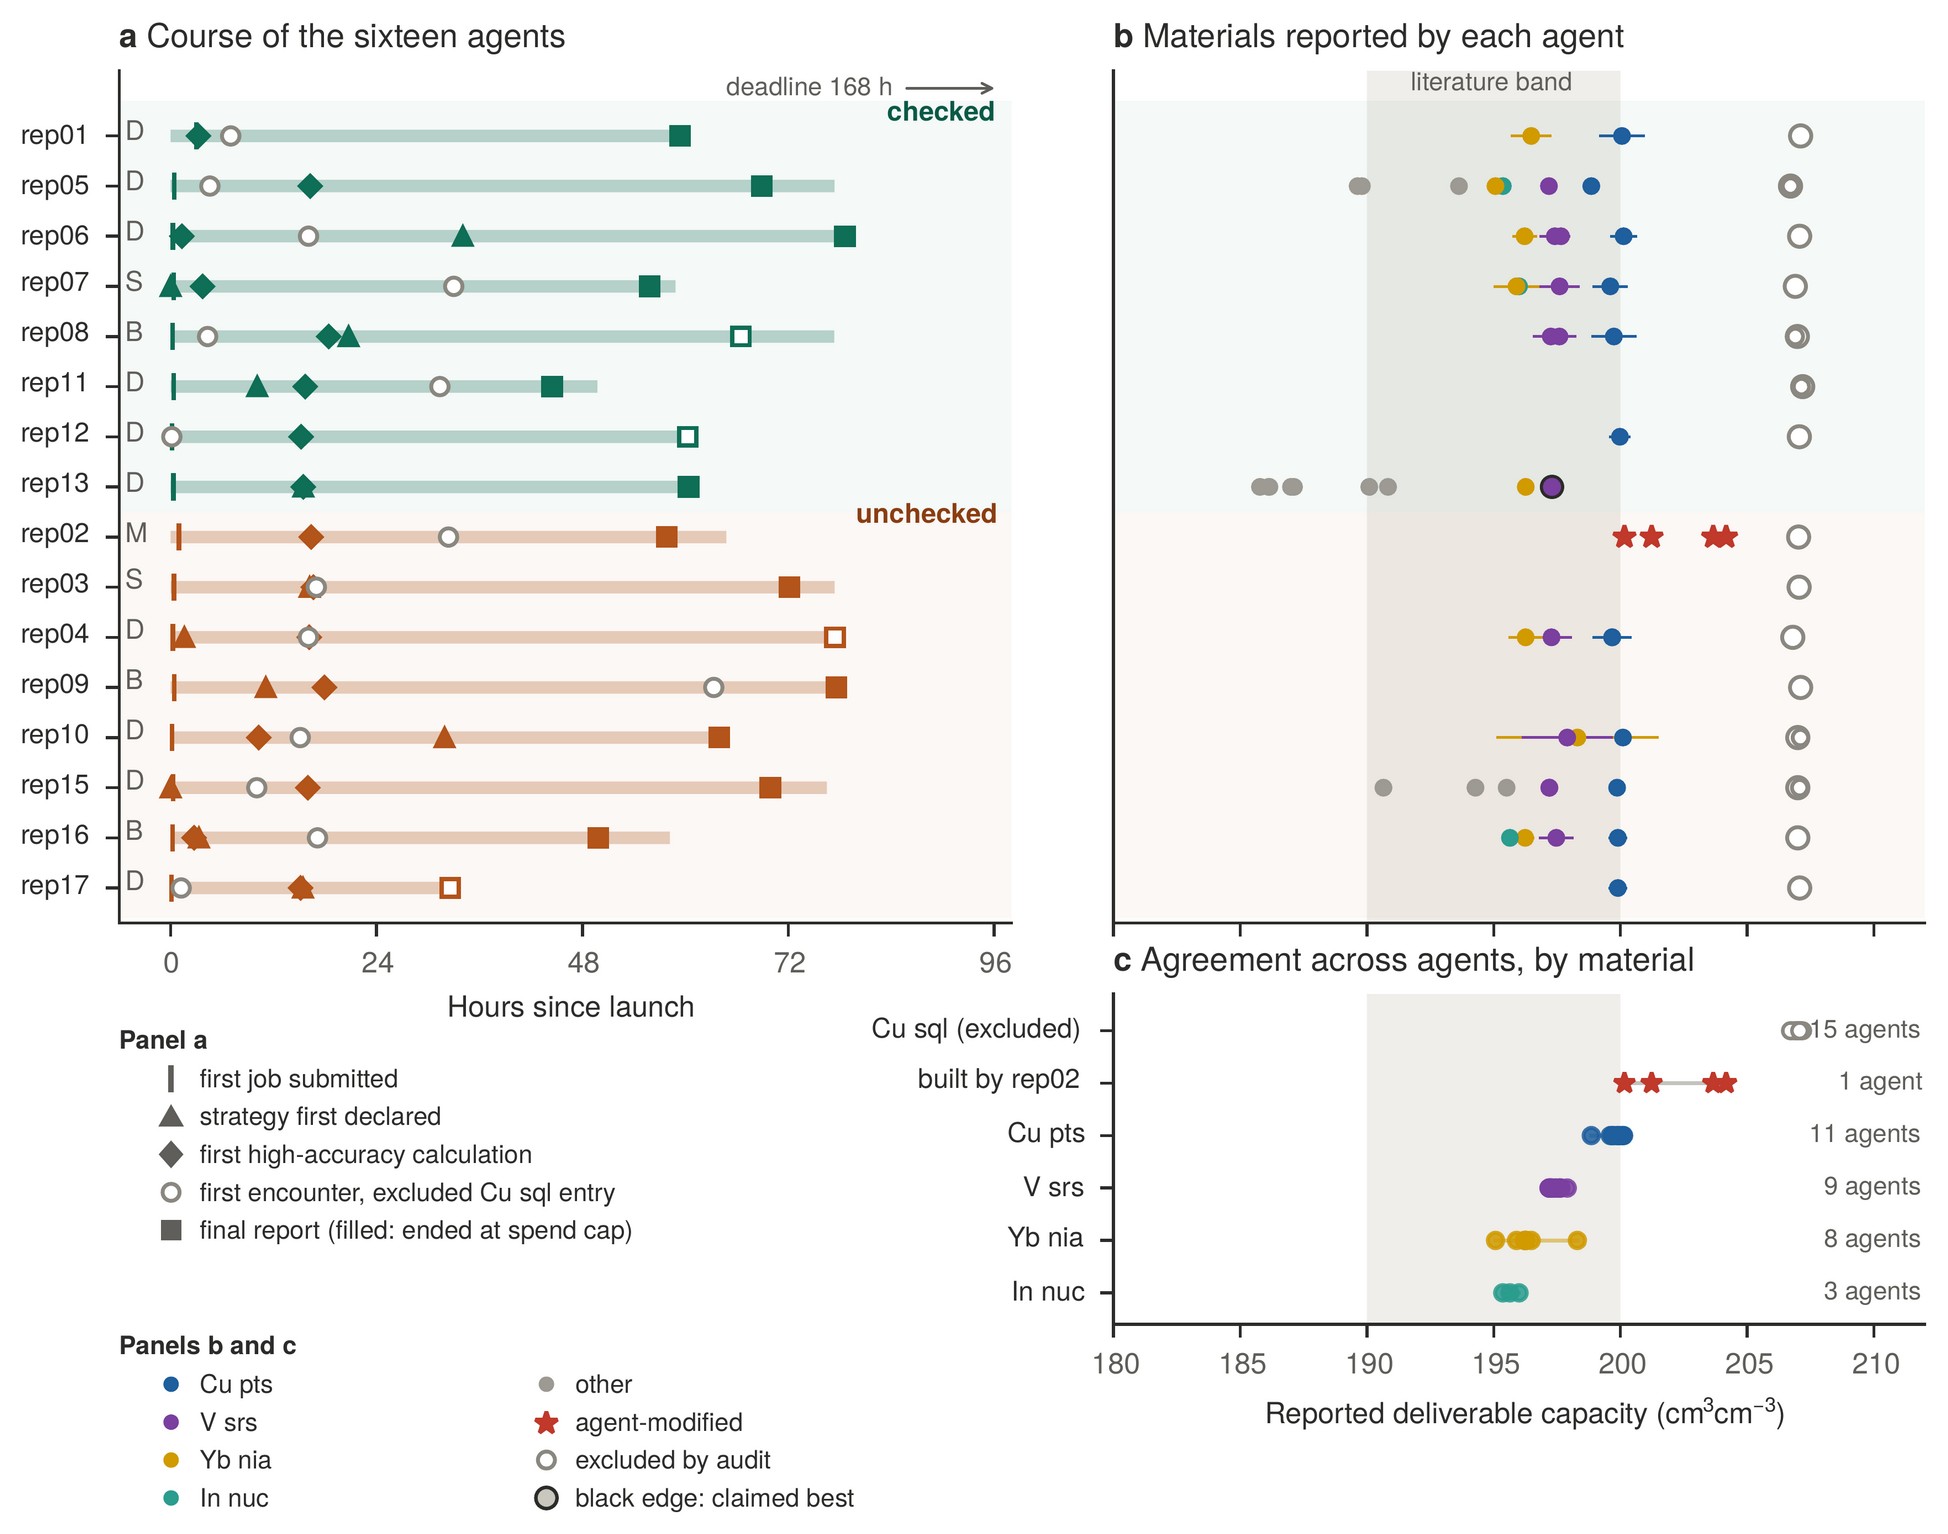
论文 Fig. 2:a 为各智能体的运行过程(检查组绿色在上,无检查组橙色在下);b、c 为最终报告里的容量值,灰色空心为被审计排除的条目,最紧的一簇落在它上面,约 207;阴影带是文献中可信容量的范围 190–200。Kim, arXiv:2609.23957 (2026), CC BY 4.0;原图未修改。 [S1]
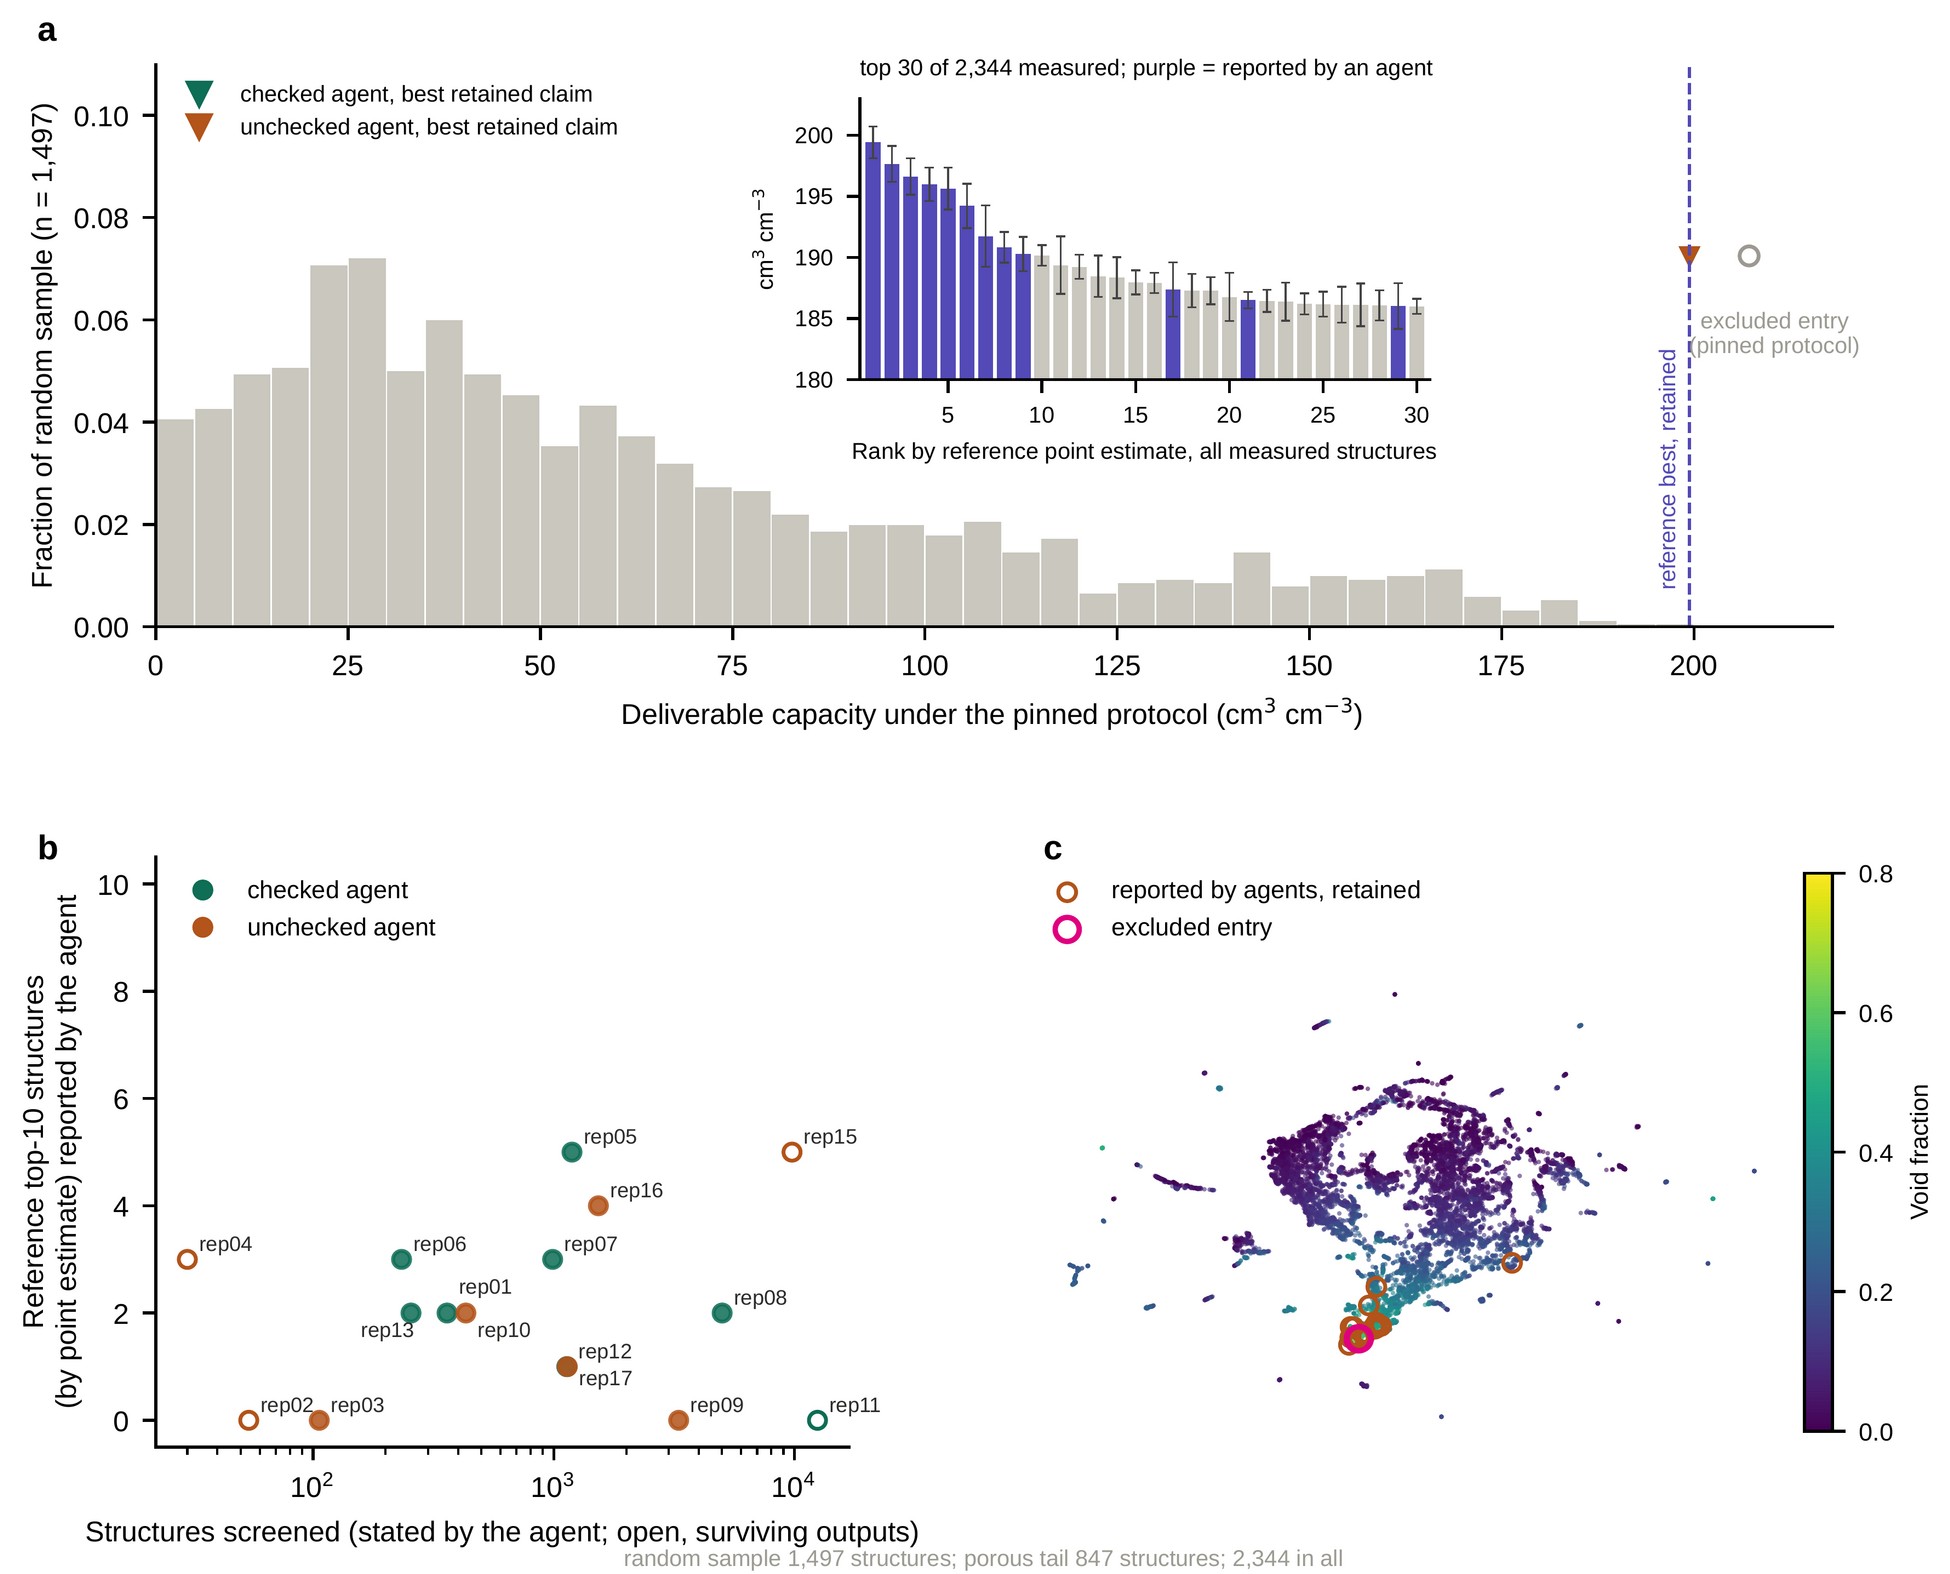
论文 Fig. 4:参考计算的性能格局很陡:随机样本中位数为 46,最高 196;前九名全是智能体报告过的材料,被排除条目(空心圆,207.17 ± 1.24)不在保留排名之内。Kim, arXiv:2609.23957 (2026), CC BY 4.0;原图未修改。 [S1]
05我从中学到什么
- 可迁移的洞见
- 可复现不等于有效:复算检验的是计算,不是被计算的对象。
- 设计启发
- 智能体开跑前,先把数据库对照原始结构审一遍。
- 阅读启发
- 看到“N 个智能体一致”,先问它们共享什么,再去数 N。
- 接下来看
- 换一个模型或混用多个模型,还会有这个盲点吗?
异常被读成了高性能
这篇论文最有用的细节不是 15/16,而是那十个记下了异常、却没有因此质疑结构的智能体。异常让好几个智能体起疑并重跑计算,却没有一个因此怀疑存放的结构本身。作者的结论是:有效的检查必须检验研究对象本身是否有效,而不只是计算能否复现。[S1]
审计工具本身也要验证
作者的电荷审计先在 70 个净电荷已知为零的类 ZIF 结构上验证过,才用于整个数据库;而智能体自建的化学审计没有一个拿已知案例验证过,唯一算对 +8 电荷的那个,最后用文件里不存在的基团把它平衡掉了。数据库审计要放在智能体开跑之前,审计工具本身也要先在已知答案上跑通。[S1]
三个量要分开看
作者认为,以任务成功率为准的评估可能把三件事混为一谈:研究路线的多样性、结论的稳定性,以及科学基底的独立性。这次实验中前两项都很高,第三项几乎为零:路线多样,不等于证据独立。[S1]
怎样读智能体的结论
越来越多“AI 科学家”类工作靠多次运行结果一致,或靠多个智能体互评来支撑结论。这篇论文提供了一个可资对照的反例:所有副本读的是同一份数据时,一致只说明结果在同样的设置下是稳定的,排除不了它们共有的系统误差,比如数据本身的错误。遇到这类说法要问确认从哪里来:另一份数据、另一种方法、另一个模型,还是同一个模型再跑一次?
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。
- S1Divergent strategies and convergent outcomes in autonomous materials discoveryarXiv · Jihan Kim (KAIST) · 2026.09.21 · 预印本 · 未经同行评审 · CC BY 4.0
- S2jihankim929/replicate-studyAuthor · GitHub · 2026 · 代码、参考答案、预注册与全部智能体会话记录
- S3jihankim929/replicate-study: Replicate benchmark study: submitted versionZenodo · 2026.09.06 · 提交版本存档
- S4Supramolecular Cu(II)–dipyridyl frameworks featuring weakly coordinating dodecaborate dianions for selective gas separationCrystEngComm · Wang, Jiang, Duttwyler & Zhang · 2021 · BSF-71 原始晶体结构论文(仅读了 Crossref 元数据与摘要)