

论文与工作流程
GPT-4o 转录 2,576 张近百年前的鸟类标本标签,在 130 张人工核对的标签上与人工转录的文本相似度 95 分(满分 100)
伦敦自然历史博物馆的 Peter Learned、Ken Norris 等人与美国自然历史博物馆合作,用手机拍下 1929 至 1931 年马达加斯加考察采集的鸟类标本标签,交给 GPT-4o 转录,再把地名变成坐标,画出四个特有种的历史分布图。对照两人各自转录、再核对过的 130 张标签,最终提示词的平均文本相似度是 95.25。分数是在调提示词用的同一批标签上测的,手写地名明显差于打印的。
●论文 + 人工对照 + 示意分布图
当前边界:分数是文本相似度,不是字段全对的比例;在调提示词的同一批标签上测;定位靠人工修正;分布图只是示意
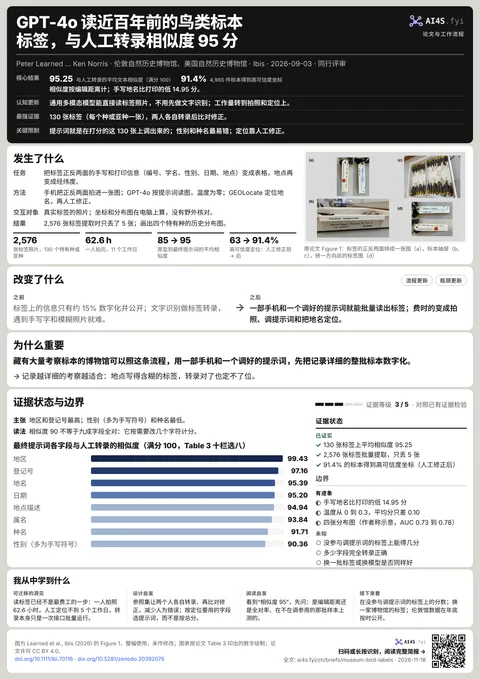
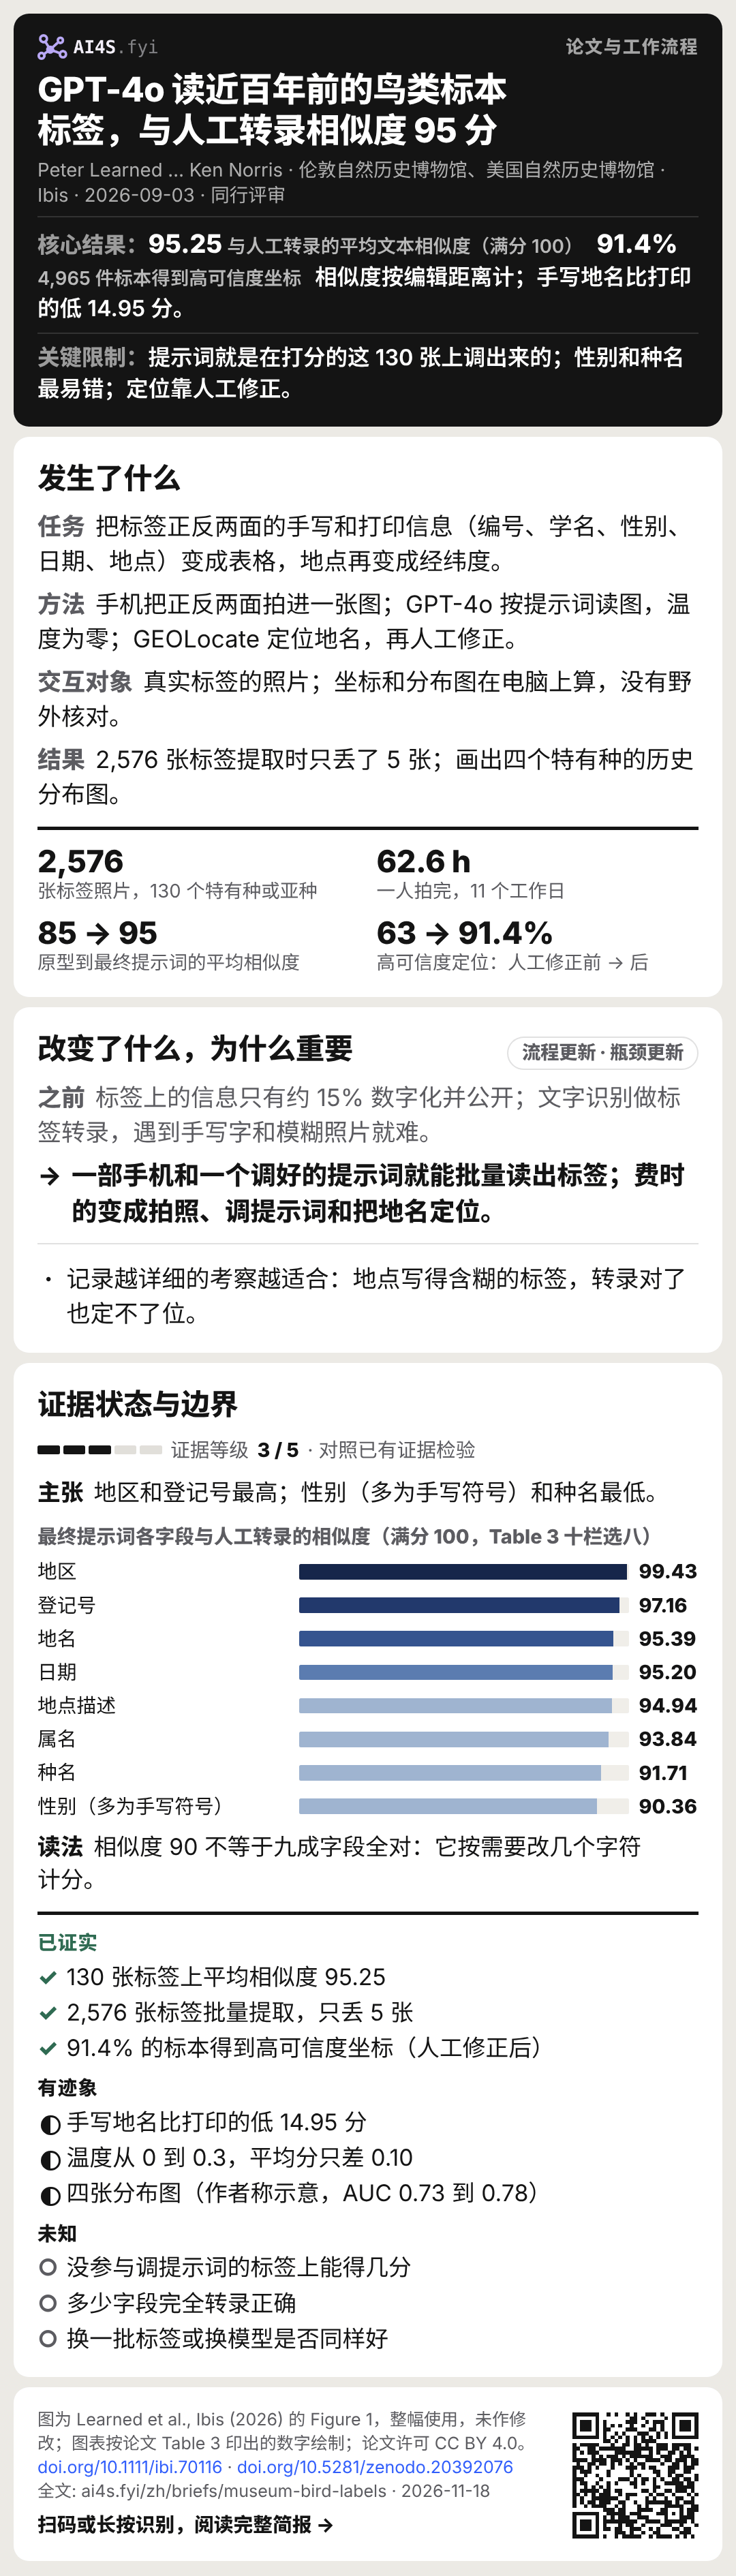
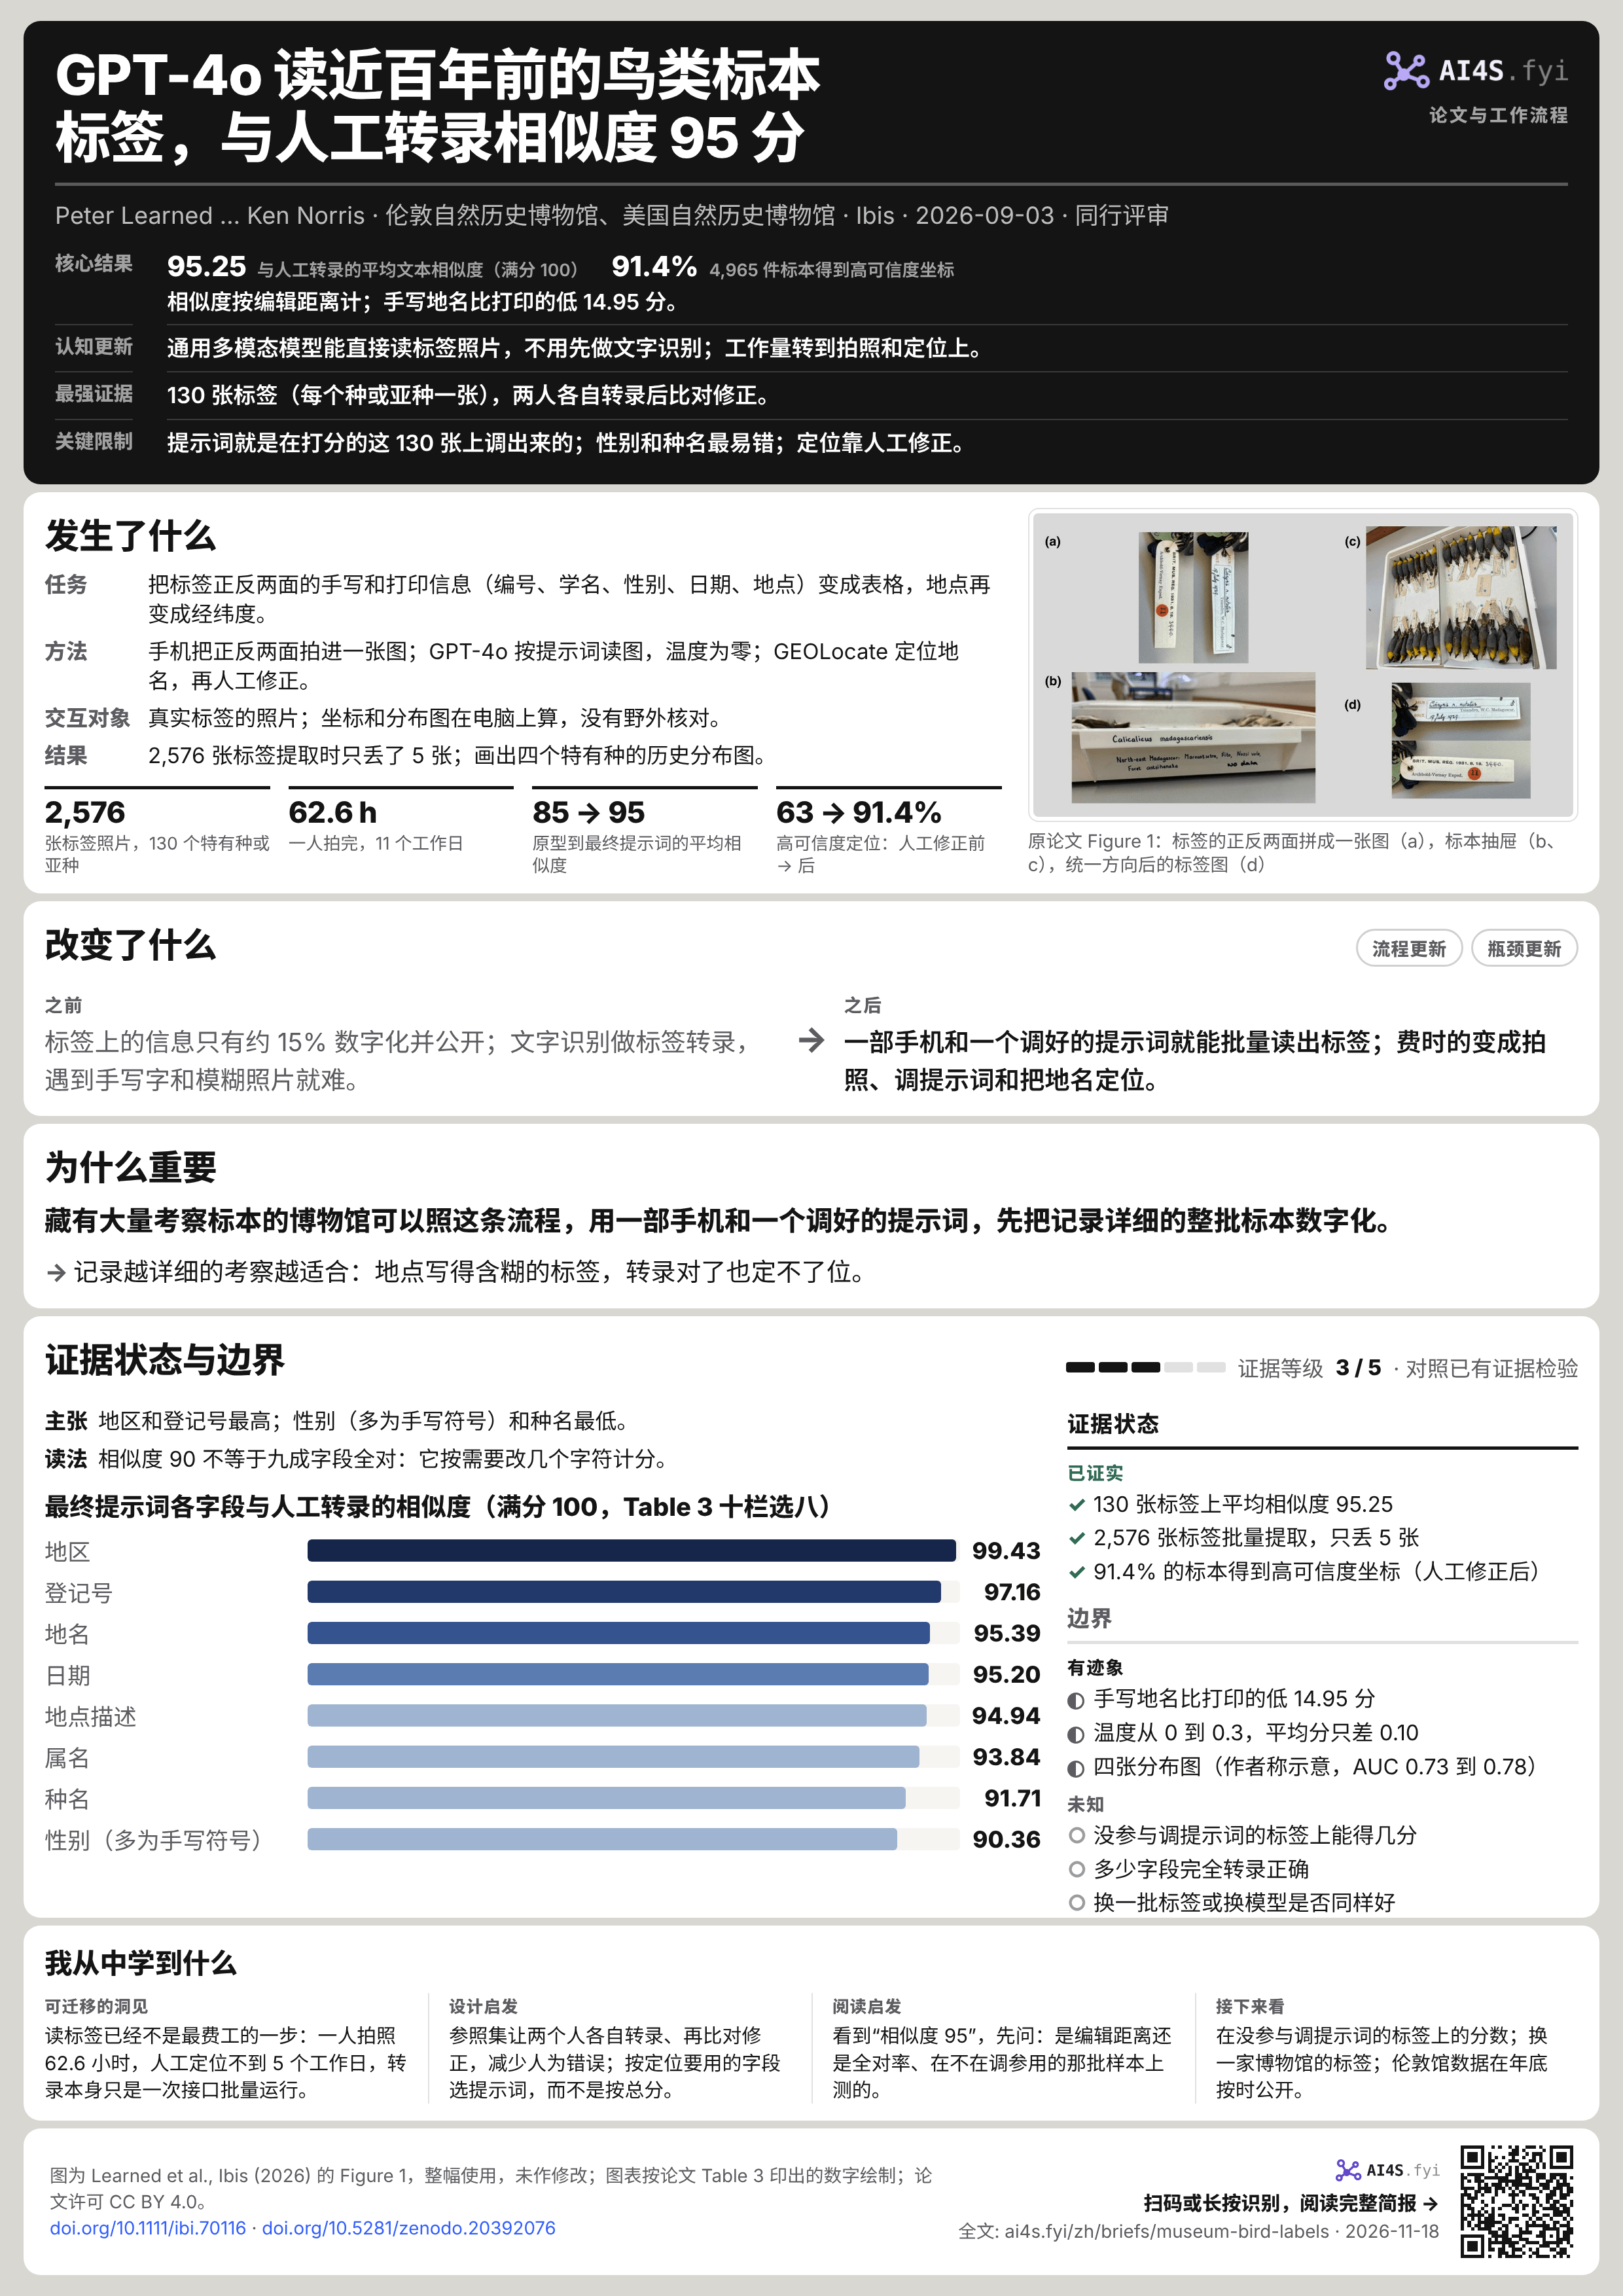
95.25与人工转录的平均文本相似度(满
91.4%4,965 件标本得到高可信
相似度按编辑距离计;手写地名比打印的低
- 认知更新
- 通用多模态模型能直接读标签照片,不用先做文字识别;工作量转到拍照和定
位上。 - 最强证据
- 130 张标签(每个种或亚种一张),两人各自转录后比对
修正。 - 关键限制
- 提示词就是在打分的这 130 张上调出来的;性别和种名最易错;定位靠人工
修正。
01发生了什么
- 任务
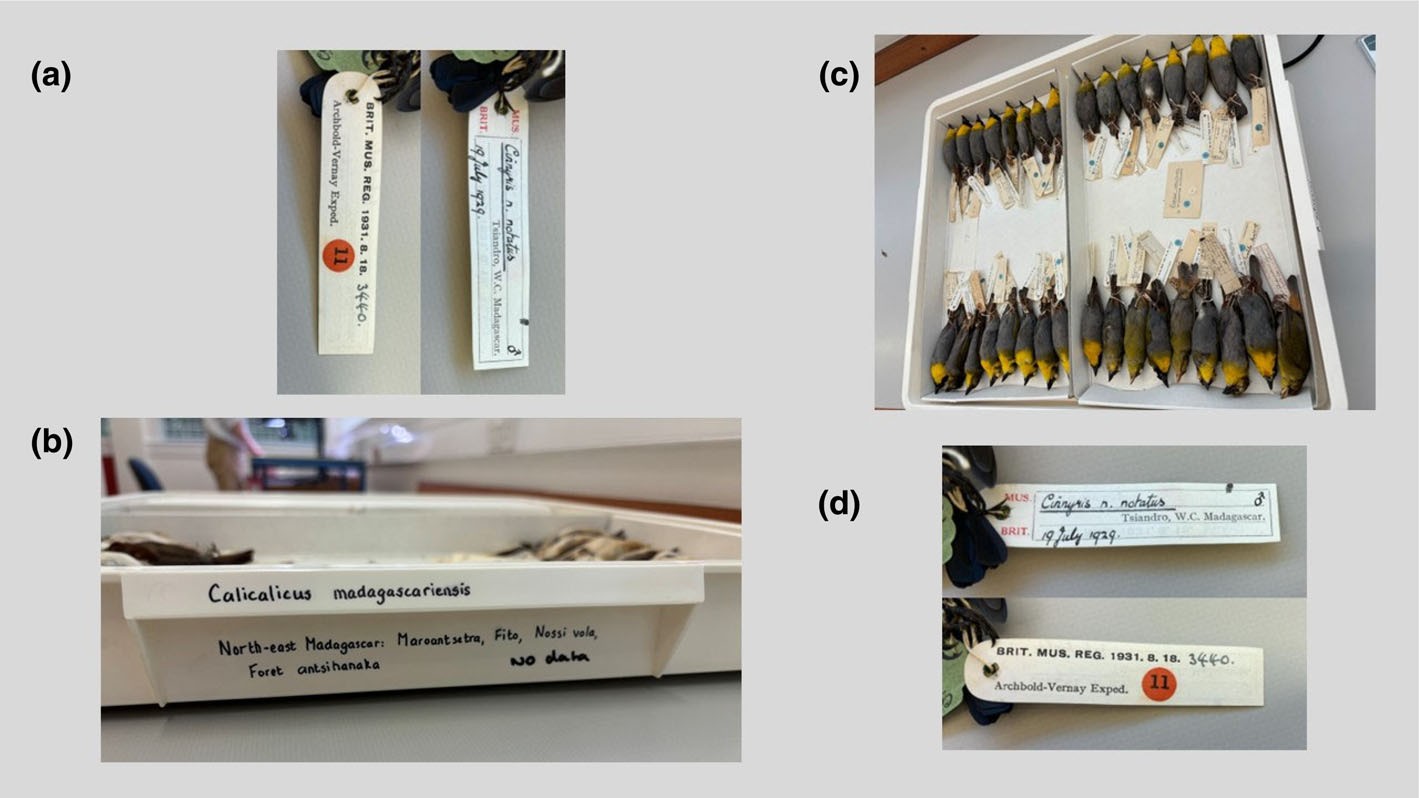
- 把标签正反两面的手写和打印信息(编号、学名、性别、日期、地点)变成表格,地点再变成经
纬度。 - 方法
- 手机把正反两面拍进一张图;GPT-4o 按提示词读图,温度为零;GEOLocate 定位地名,再人工
修正。 - 交互对象
- 真实标签的照片;坐标和分布图在电脑上算,没有野外
核对。 - 结果
- 2,576 张标签提取时只丢了 5 张;画出四个特有种的历史分
布图。
2,576张标签照片,130 个特有种
62.6 h一人拍完,11 个
85 → 95原型到最终提示词的平均
63 → 91.4%高可信度定位:人工修
论文 2026 年 9 月 3 日在线发表于英国鸟类学会的期刊 Ibis,许可为 CC BY 4.0。七位作者来自伦敦自然历史博物馆(南肯辛顿和特林两处)和纽约的美国自然历史博物馆;通讯作者 Ken Norris 是伦敦自然历史博物馆生物多样性变化方向的研究负责人,第一作者 Peter Learned 参与构思、方法、数据、分析和软件(与 Norris 等人共同承担)。论文写明没有专门经费,作者声明无利益冲突。脚本和提示词文档在 Zenodo;伦敦馆的数据说是 2026 年底前上传到该馆的数据门户,美国馆的数据可向馆方
为什么选这次考察
Archbold-Vernay 考察 1929 至 1931 年在马达加斯加采集了约 7,500 件鸟类标本,覆盖 150 多个种,伦敦和纽约两馆大致各分一半,每件都记了比较详细的地点。作者说这个规模靠人工转录很吃力;标签上手写和打印混杂,还有表示雌雄的符号;而马达加斯加约 250 个本土鸟种里有 100 多个特有种或亚种,15% 的鸟种受威胁,所以这批历史记录在生态上有价值。纽约馆几年前已经人工录入了自己那一半的登记册;伦敦馆没有数字记录,作者先从登记册手工整理出种名和编号,再去库房找标本。所以拍照和模型转录只用伦敦馆的标本,定位和建模才把两馆合在
拍照:一部手机,11 个工作日
标签两面都有信息。拍照用 iPhone 15 Plus,1080 像素,用 Instagram 相机免费的分屏布局(竖向分割)把正反两面拍进一张图;为了省时间,标签不用先摆正,拍完再用一个 Python 脚本统一方向。每批标本前先拍一张抽屉标签,方便以后回查。一个人用了 62.6 小时、11 个工作日,拍下 2,729 张,总计每小时约 44 张(Table 1 各日速率的平均为 47 张,含重复和抽屉照片);去掉重复和不能用的,留下
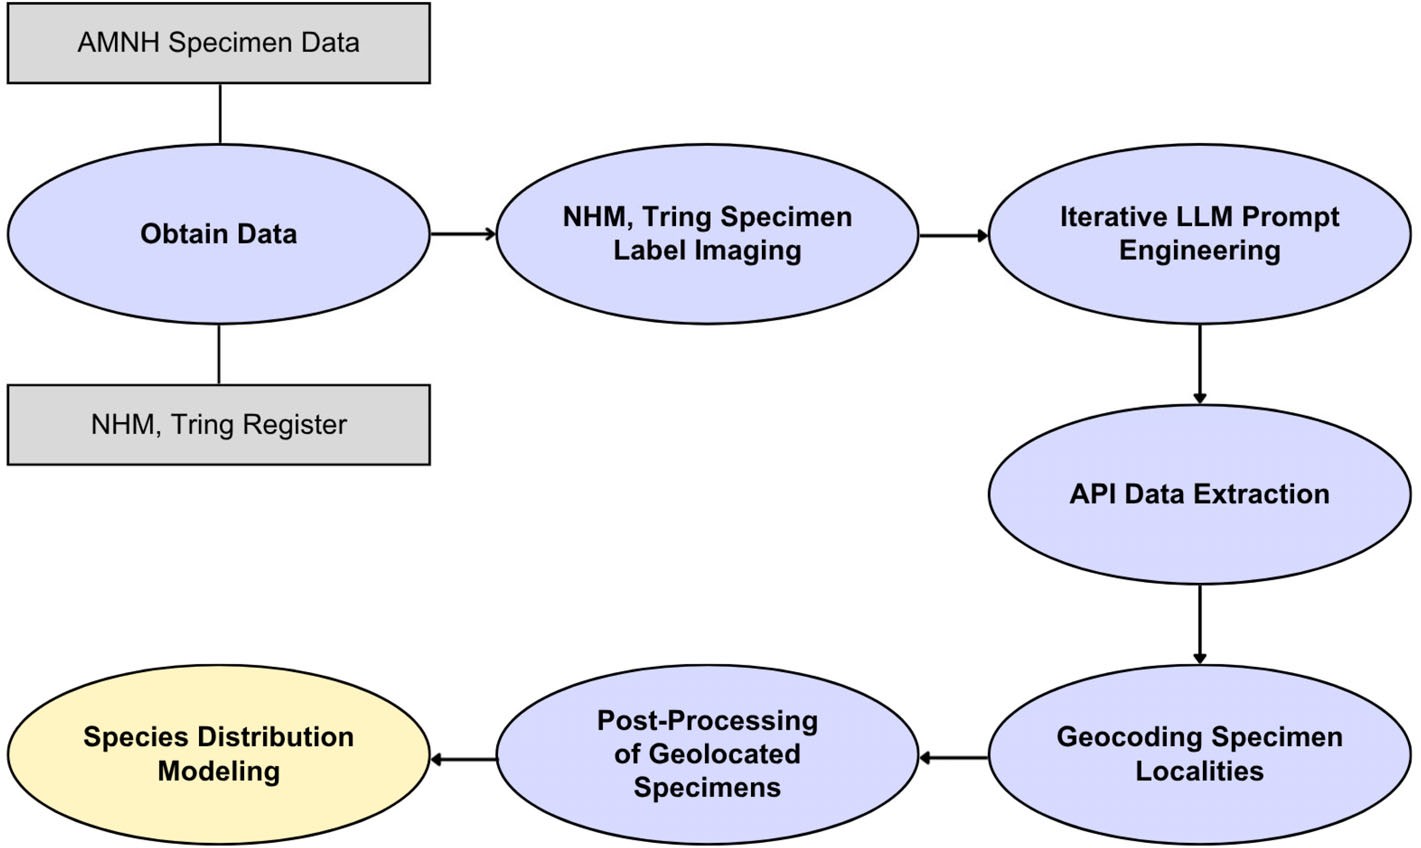
Figure 2:七个阶段。取得两馆的标本记录,在特林拍标签,反复调提示词,通过接口批量提取,给地点定位,人工修正,最后建物种分布模型。 [S1]
02改变了什么
流程更新瓶颈更新标签上的信息只有约 15% 数字化并公开;文字识别做标签转录,遇到手写字和模糊照片
一部手机和一个调好的提示词就能批量读出标签;费时的变成拍照、调提示词和把地名
提示词怎么调:从 85 分到 95 分
起点是伦敦馆此前为标本标签写的一个 ChatGPT-4o 原型提示词(v1.1)。每改一版,就通过 OpenAI 的接口(在 Google Colab 里调用,为此买的接口密钥约 10 美元)让模型读那 130 张标签,再和人工转录比相似度。原型平均 85.18 分,性别一栏是 0 分;中间一版 v1.3 跌到 56.26。最后 v1.4、v1.6、v2.2 三版平均分超过 95,其中 v1.6 最高(95.48),但作者选了 v2.2(95.25),因为它在地点和地名两栏最准,而这两栏是定位要用的。v2.2 共 253 个词,要求逐字转录。把温度从 0 改成 0.3,平均分只差
定位:自动 63%,人工修正后 91.4%
地点、地名和地区拼成一串(例如“1 mi N Ivohibe Madagascar”),交给杜兰大学自然历史博物馆开发的网页工具 GEOLocate 批量定位,它给出坐标和 0 到 100 的可信度,80 分以上算高可信度。第一轮只有 63% 达到。随后人工修正:改拼错的地名,把法语地名换成英语,并把“某地以西三天路程”这类说法,按考察首席鸟类学家 Austin Rand 1936 年的记述估算的行进距离改写成公里数。修正后 91.4% 达到高可信度,5.8% 有坐标但可信度低,2.8% 找不到,多是“灌木林”“石灰岩森林”这类太含糊的描述。作者说人工处理不到 5 个工作日。按日期排序也能找出模型转录错的地名,因为考察在某一天只在某一个
03为什么重要
藏有大量考察标本的博物馆可以照这条流程,用一部手机和一个调好的提示词,先把记录详细的整批标本数
- 记录越详细的考察越适合:地点写得含糊的标签,转录对了也定不
了位。
按作者引用的估计,标本标签上的信息只有约 15% 被数字化并公开,主要因为逐件数字化和定位费时费钱。作者称两馆这次数字化并定位的 4,965 件,是对 VertNet 上 1925 至 1935 年 5,876 件马达加斯加鸟类标本的重要补充;其中伦敦馆的 2,571 件,VertNet 上该馆原只列了 190 件。VertNet 上全球有 660 万件保存的鸟类标本,作者据此说这类流程原则上可能对鸟类及其他类群的标本数字化影响很大,但每用到一批新标本,提示词都要重新调整、重新测准确度。他们也写明,大语言模型会出错,偶尔会编造信息;要求逐字转录有助于减少这种
分布图用免费的 MaxEnt 软件,为四个特有种画:Coua caerulea、Accipiter francesiae、Pterocles personatus 和 Cinnyris sovimanga。环境变量有 1930 年的土地利用和人口(HYDE 3.3)、1929 至 1931 年的降水和气温(CRU TS 4.07),再加上 WWF 的(现代)生态区和海拔。采样偏差用各处采到的标本数粗略估计。四个模型的检验 AUC 在 0.730 到 0.778 之间(Table 4),作者称为中等;每种有 14 到 41 个不重复的采集点。作者说这些图应当看作示意而非定论,但它们是该岛特有鸟种最早的一批分布图之一,比国际鸟盟的特有鸟区工作早约
04证据状态与边界
证据等级 3 / 5 · 对照已有证据检验证据状态
已证实
- 130 张标签上平均相似
度 95.25 - 2,576 张标签批量提取,
只丢 5 张 - 91.4% 的标本得到高可信度坐标(人工修
正后)
边界
有迹象
- 手写地名比打印的低
14.95 分 - 温度从 0 到 0.3,平均分只
差 0.10 - 四张分布图(作者称示意,AUC 0.73 到
0.78)
未知
- 没参与调提示词的标签上能
得几分 - 多少字段完全转
录正确 - 换一批标签或换模型是否
同样好
主张地区和登记号最高;性别(多为手写符号)和种名
最终提示词各字段与人工转录的相似度(满分 100,Table 3 十栏选八)
读法相似度 90 不等于九成字段全对:它按需要改几个字符
分数是怎么算的。
参照集是从每个特有种或亚种的照片里随机抽一张,共 130 张,由两个人各自转录,用文本相似度比对两份,再回到照片上修正分歧。相似度用 fuzzywuzzy 软件包计算:把一段文字改成另一段需要插入、删除或替换几个字符(编辑距离),换算成 0 到 100 的分数。作者把各字段平均 95 分以上定为高准确度。所以 95.25 是十个字段相似度的平均,不是“多少张标签或多少字段完全正确”;论文没有给出后者。提示词的每一版都在这 130 张上测、在这 130 张上改,最后选的是这批标签上表现最好的版本,论文没有用另一批没见过的标签
哪些因素影响准确度。
用线性模型看 v2.2:不同标签之间、不同字段之间的准确度差异显著,性别和种名两栏明显更容易出错。用混合模型看标签特征:污渍、光线暗、照片模糊都没有显著影响(P > 0.17);但地点信息是手写的,比打印的低 14.95 分(P = 1.38e-05)。作者解释,性别多用手写的雌雄符号,位置也不固定,是最难读的;种名的“错误”有一部分是模型把缩写的种名补全了(例如把 Neomixis t. decaryi 写成 Neomixis tenella decaryi),技术上算错,对数据质量影响
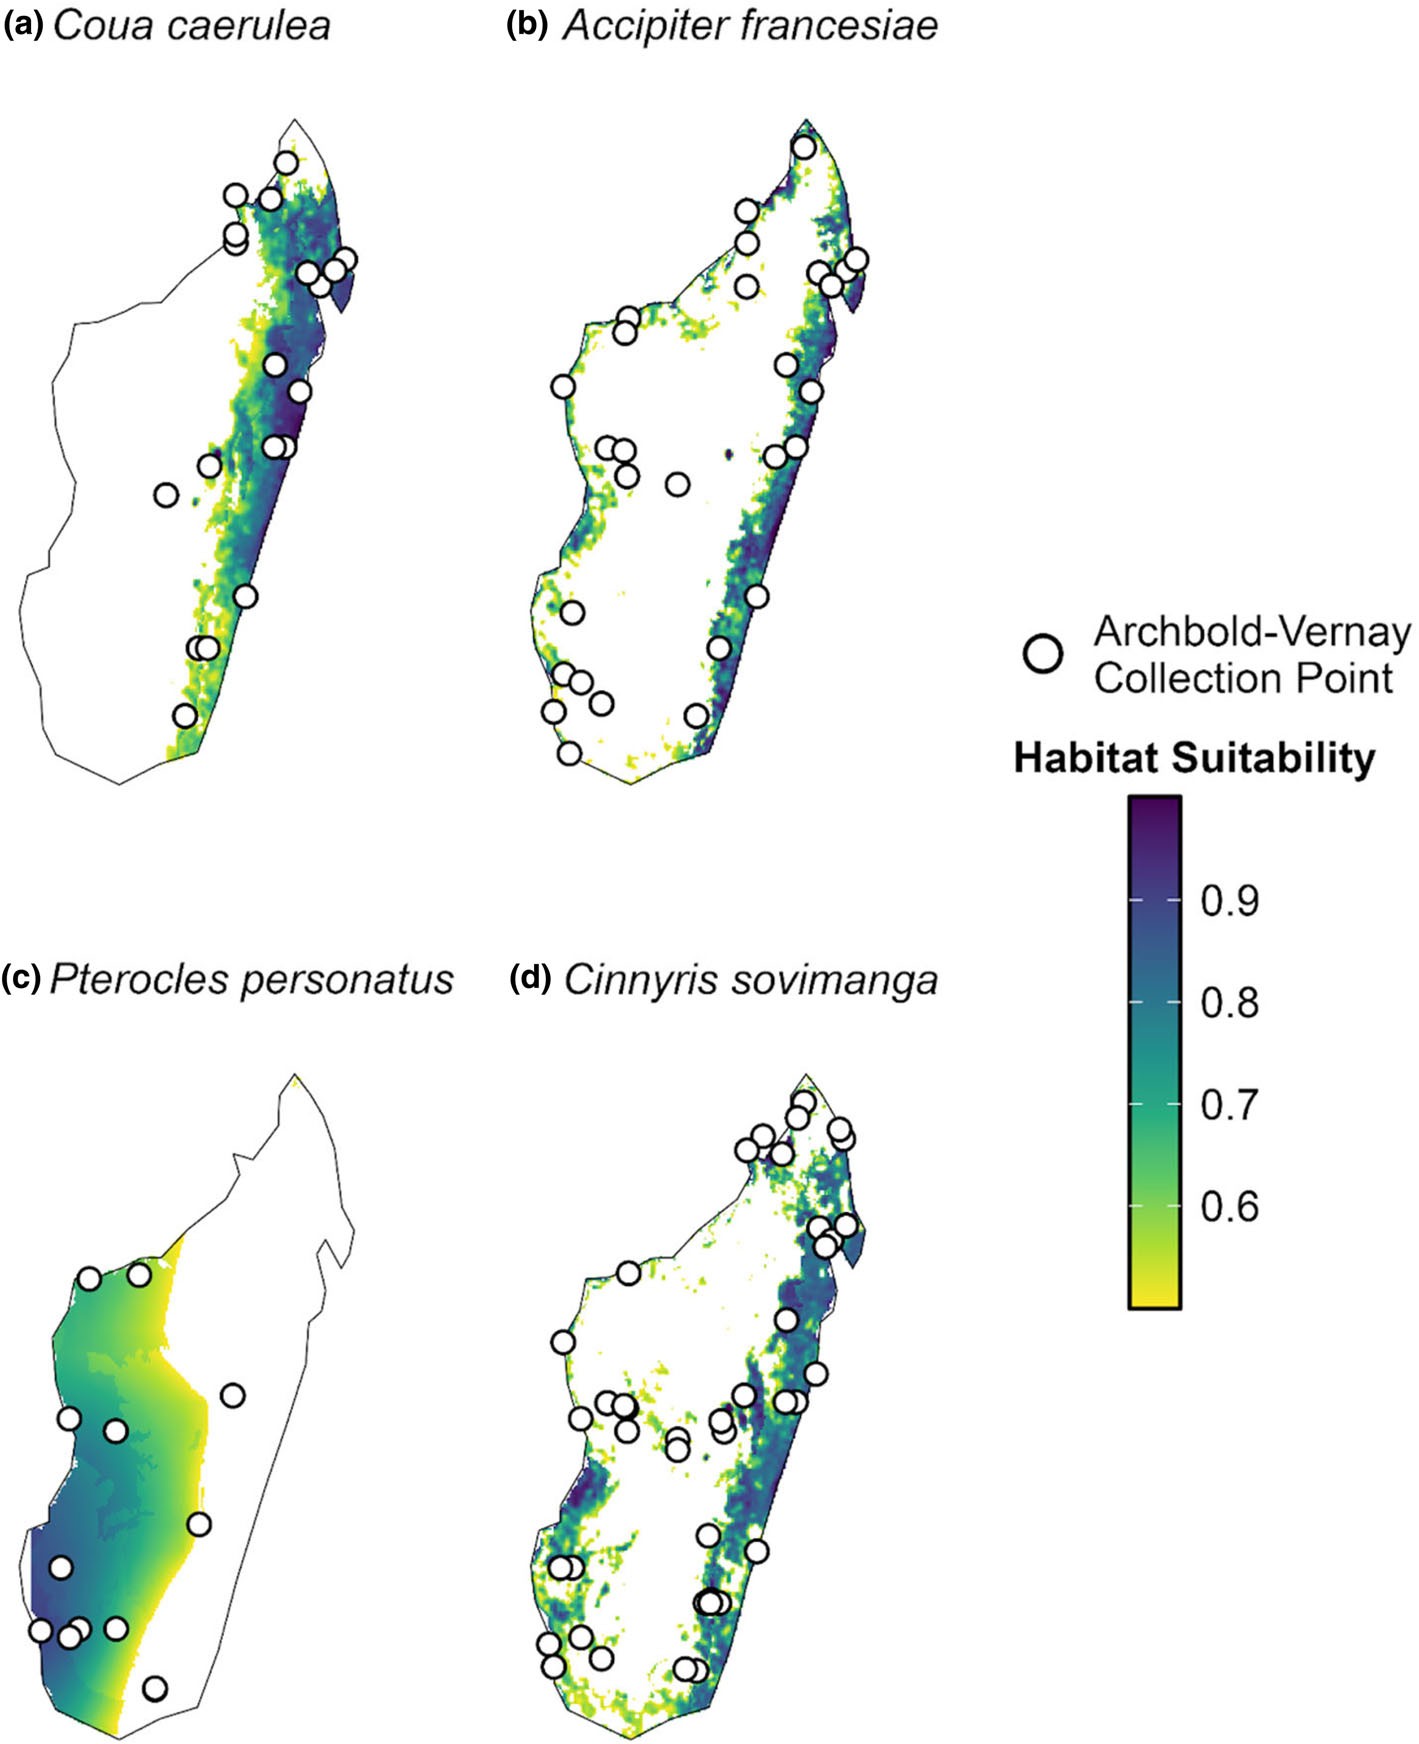
Figure 4:四个特有种的栖息地适宜度,颜色从黄(0.5)到深紫(1.0),白圈是考察的采集点。作者说这些图只是示意。 [S1]
05我从中学到什么
- 可迁移的洞见
- 读标签已经不是最费工的一步:一人拍照 62.6 小时,人工定位不到 5 个工作日,转录本身只是一次接口批量
运行。 - 设计启发
- 参照集让两个人各自转录、再比对修正,减少人为错误;按定位要用的字段选提示词,而不是按
总分。 - 阅读启发
- 看到“相似度 95”,先问:是编辑距离还是全对率、在不在调参用的那批样本上
测的。 - 接下来看
- 在没参与调提示词的标签上的分数;换一家博物馆的标签;伦敦馆数据在年底按时
公开。
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。