

预印本与模型
Google DeepMind 的 OCELOT 预测 10 万个物种的分布,卫星嵌入让留出区域得分提高 51%
Google DeepMind 和 Google Research 的 Bart van Merriënboer、Drew Purves 等七人,用开放生物多样性数据库 GBIF 的 20 亿条观测训练了一个模型:给定地点,它估计在那里记录到的生物属于 10 万个物种中哪一个。最宽 600 公里的整块区域从训练中拿掉后测试,加入 AlphaEarth Foundations 卫星嵌入使排序得分从 0.076 升到 0.115。所有结果都是作者自己的测试,预印本未经评审,权重尚未发布。
●预印本 + 留出区域检验 + 分布图对照
当前边界:预测的是相对出现率,不是物种在不在、有多少;不考虑季节和迁徙;还没在真实设备布设上测;权重未发布
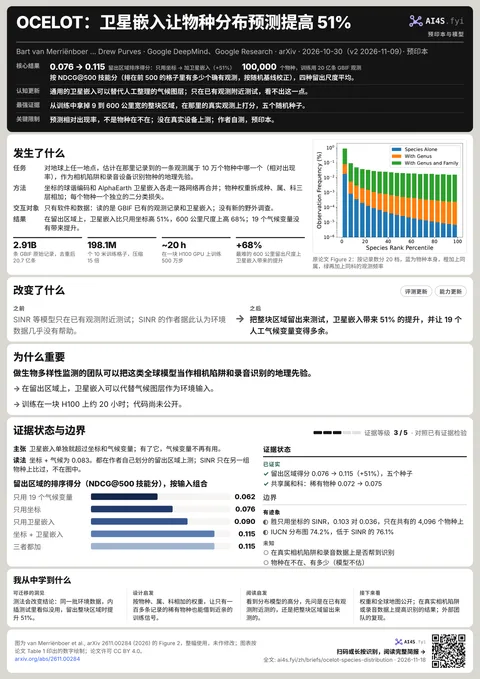
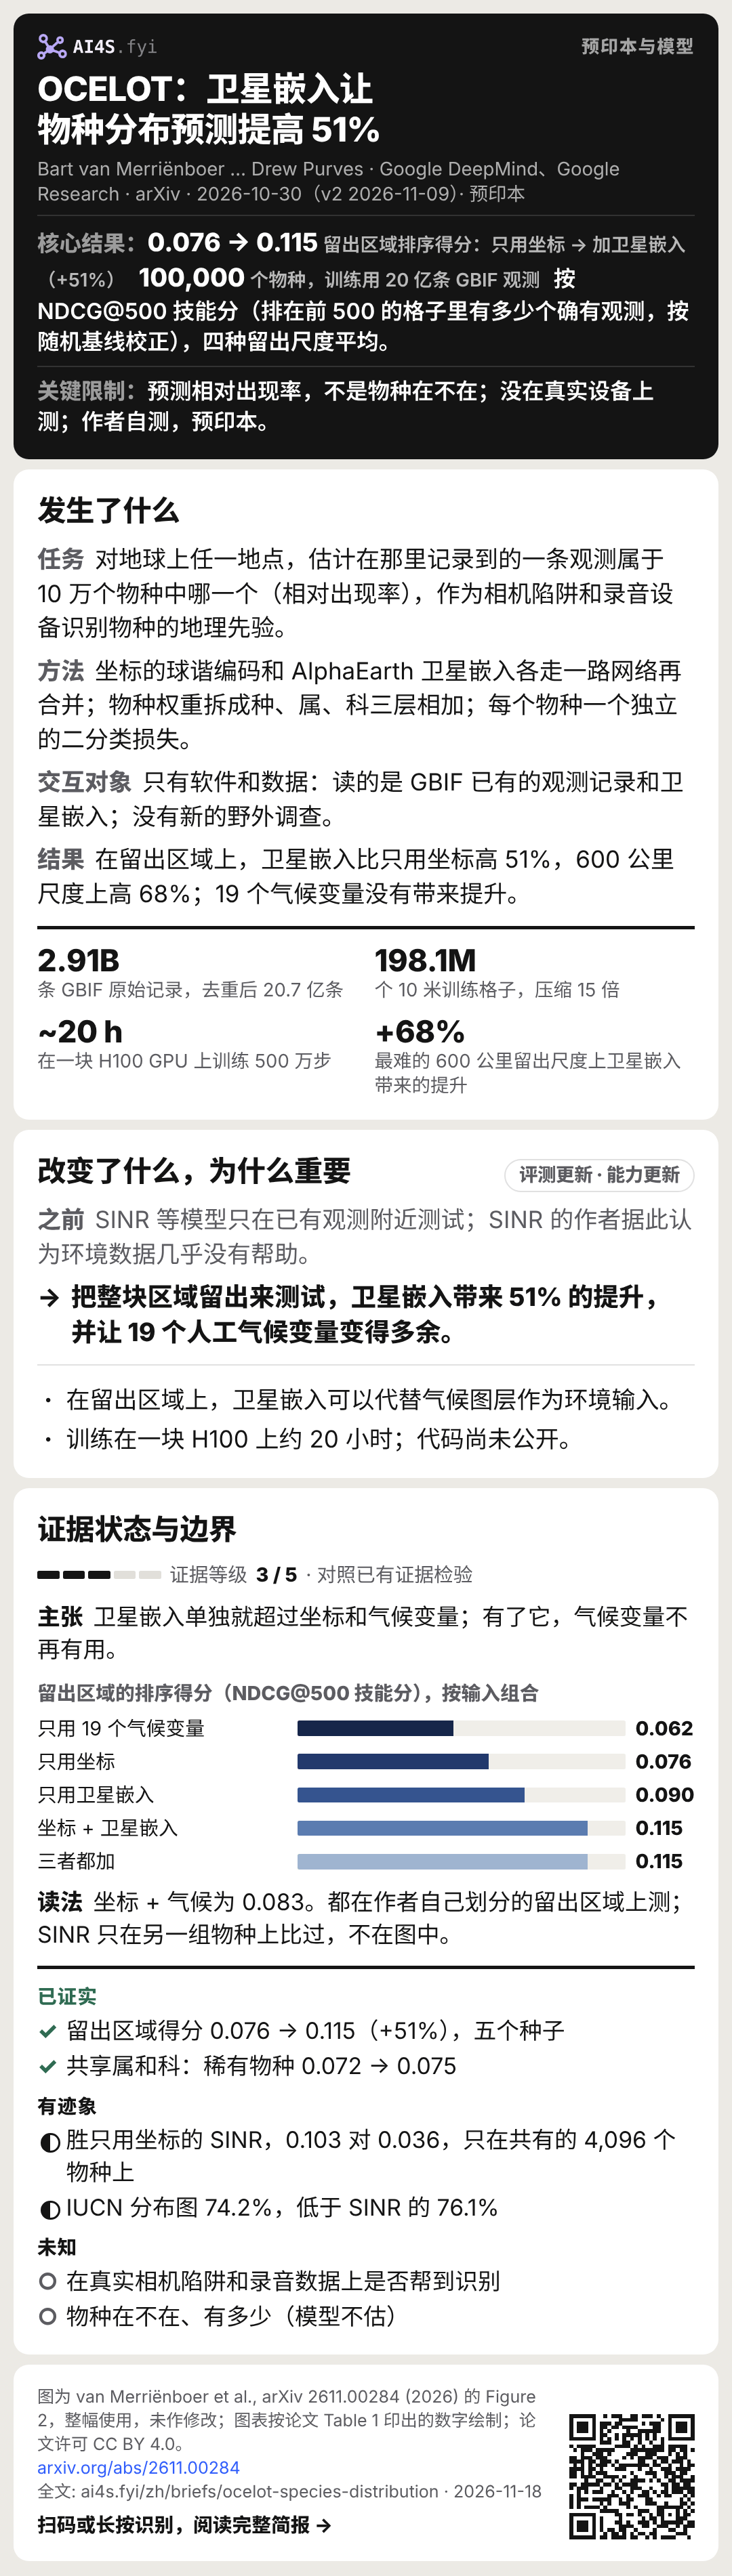
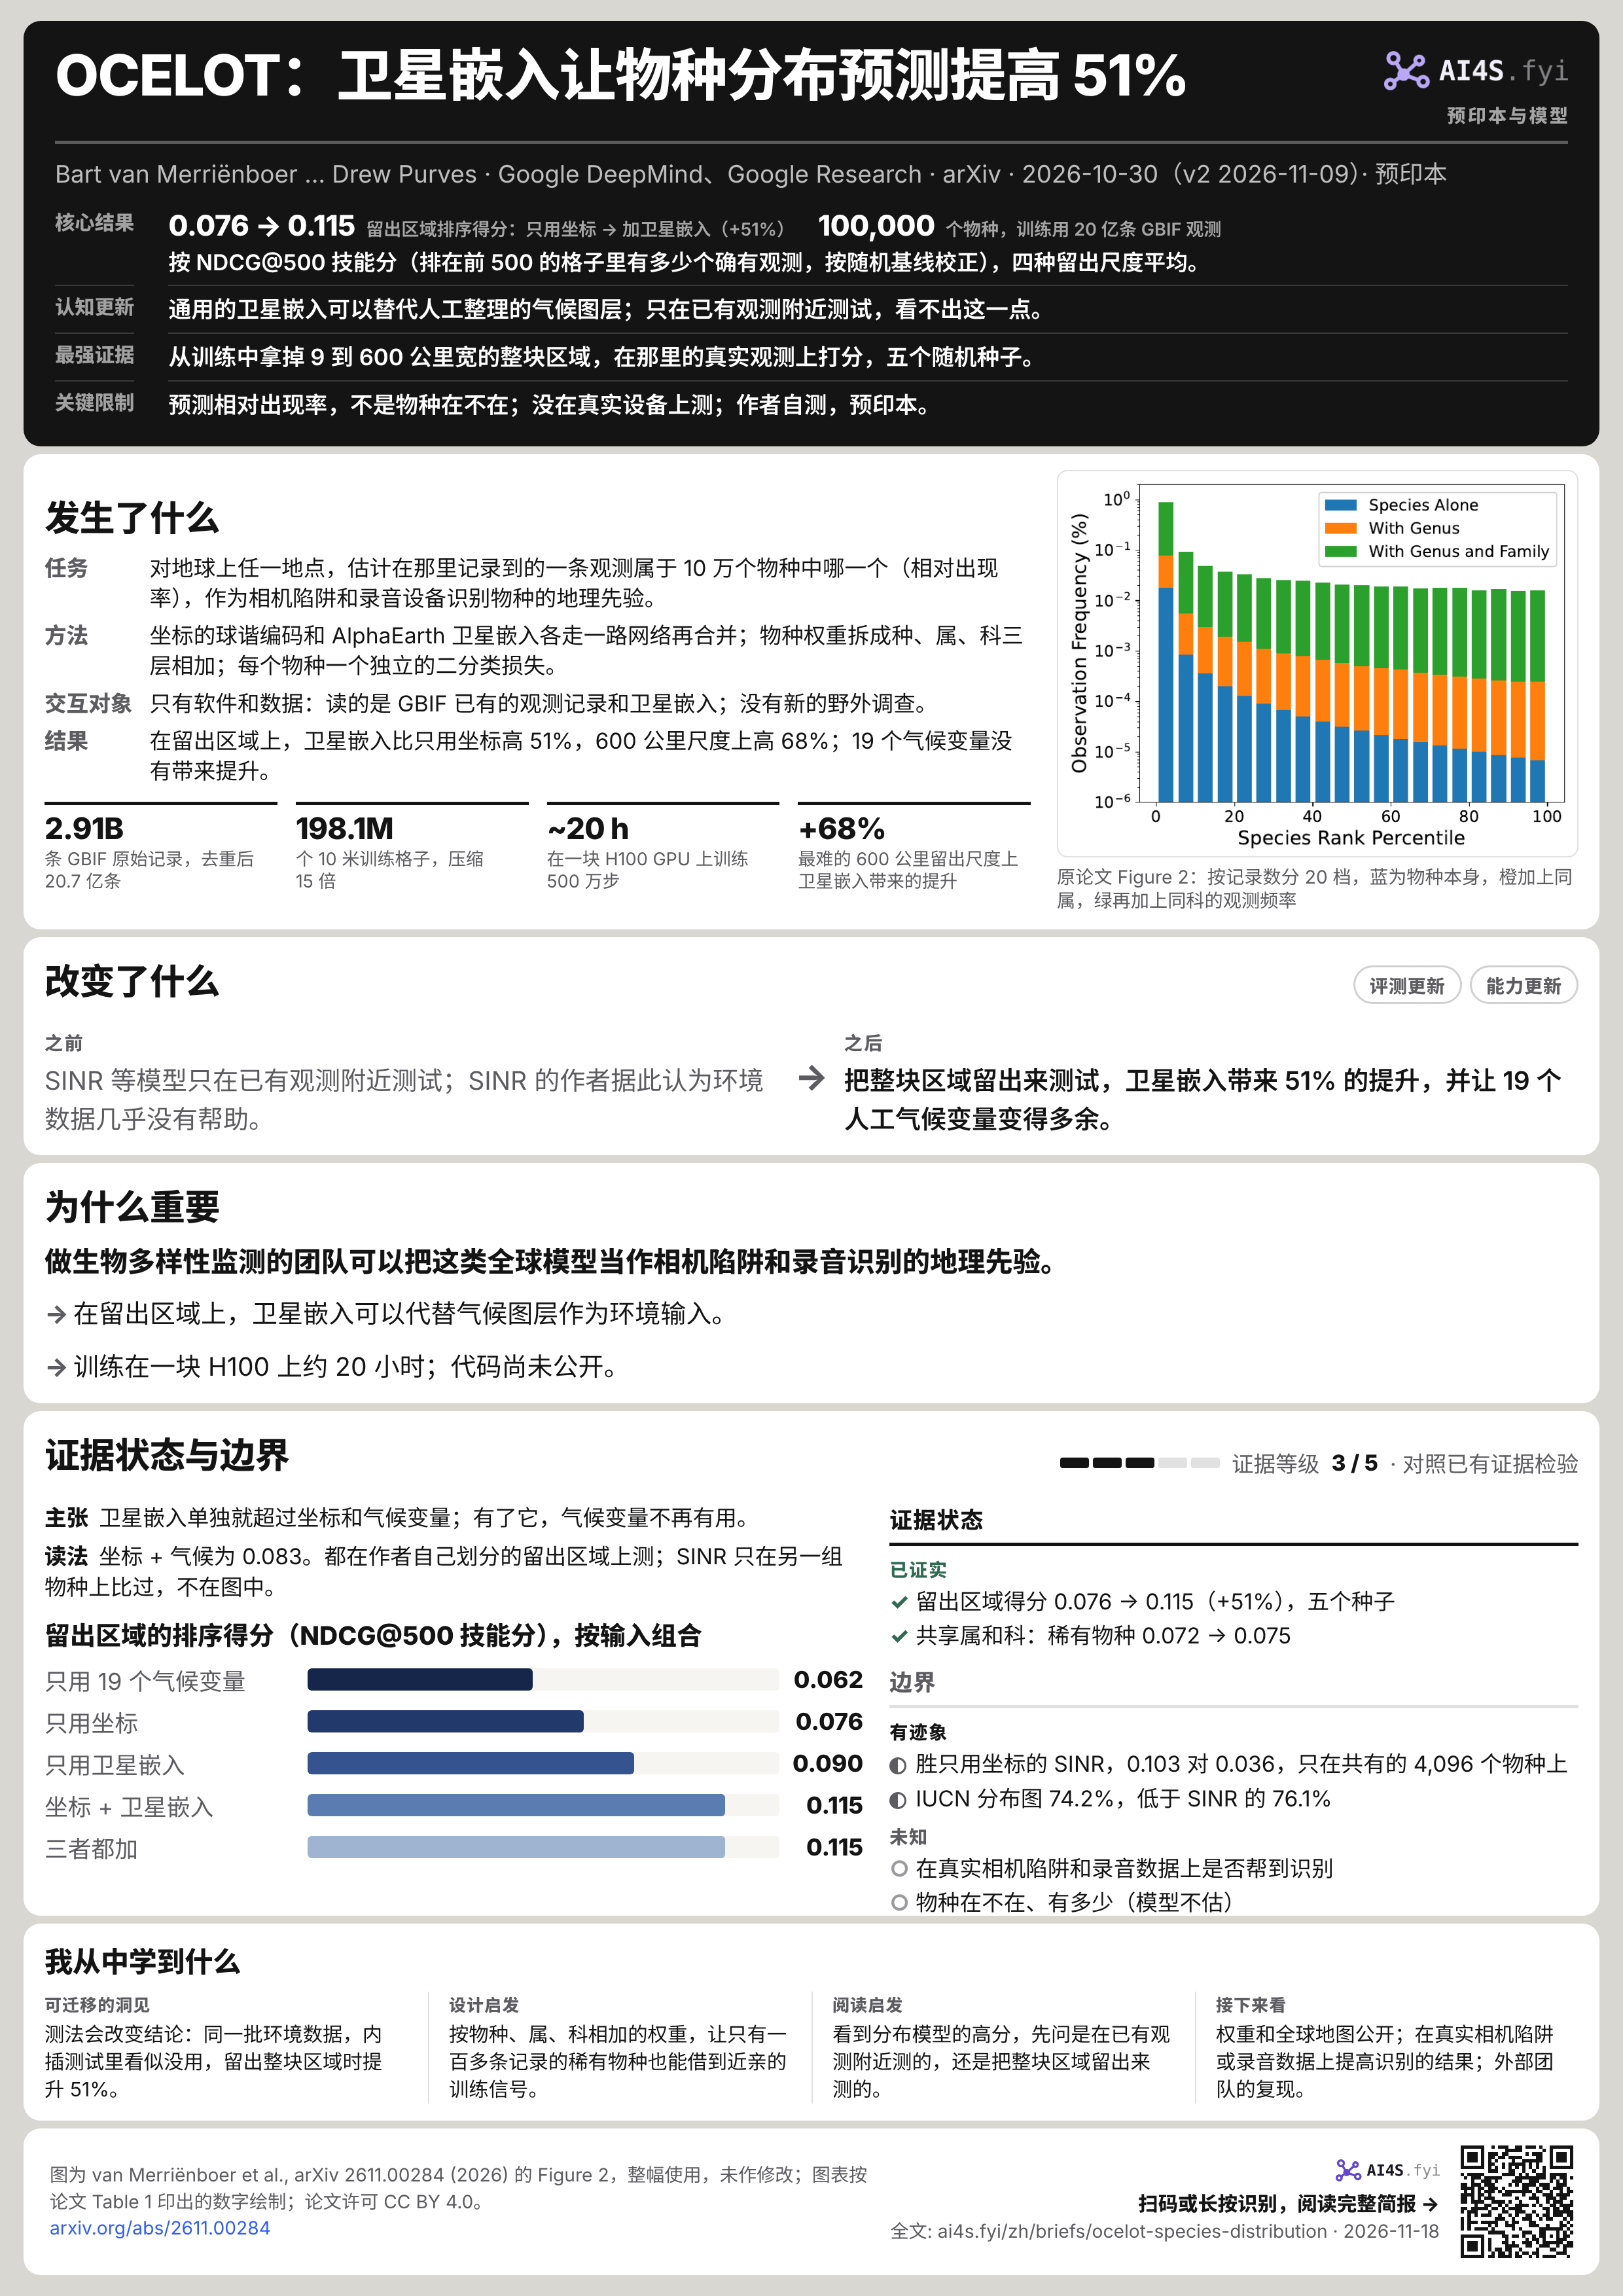
0.076 → 0.115留出区域排序得分:只用坐标 → 加卫星嵌入(
100,000个物种,训练用 20 亿条
按 NDCG@500 技能分(排在前 500 的格子里有多少个确有观测,按随机基线校正),四种留出尺度
- 认知更新
- 通用的卫星嵌入可以替代人工整理的气候图层;只在已有观测附近测试,看不出这
一点。 - 最强证据
- 从训练中拿掉 9 到 600 公里宽的整块区域,在那里的真实观测上打分,五个随机
种子。 - 关键限制
- 预测相对出现率,不是物种在不在;没在真实设备上测;作者自测,预
印本。
01发生了什么
- 任务
- 对地球上任一地点,估计在那里记录到的一条观测属于 10 万个物种中哪一个(相对出现率),作为相机陷阱和录音设备识别物种的地理
先验。 - 方法
- 坐标的球谐编码和 AlphaEarth 卫星嵌入各走一路网络再合并;物种权重拆成种、属、科三层相加;每个物种一个独立的二分类
损失。 - 交互对象
- 只有软件和数据:读的是 GBIF 已有的观测记录和卫星嵌入;没有新的野外
调查。 - 结果
- 在留出区域上,卫星嵌入比只用坐标高 51%,600 公里尺度上高 68%;19 个气候变量没有带来
提升。
2.91B条 GBIF 原始记录,去重后
198.1M个 10 米训练格子,压
~20 h在一块 H100 GPU 上训练
+68%最难的 600 公里留出尺度上卫星嵌入带来
论文第一版 2026 年 10 月 30 日挂在 arXiv(cs.LG),第二版 11 月 9 日,许可为 CC BY 4.0,两版摘要相同。七位作者中五位署 Google DeepMind、两位署 Google Research;联系人是第一作者 Bart van Merriënboer,最后一位作者是 Google DeepMind 自然方向负责人 Drew Purves。Purves 在自己的 LinkedIn 帖子里写道,这项工作建立在 Cole 等人 2023 年的 SINR 之上(iNaturalist 地理模型的基础),团队期待在适当时候开源模型、代码和全球地图;论文本身只写了计划发布模型
相对出现率:它回答的是哪个问题
公民科学的观测只记“看到了”,不记“没看到”,所以分不清一个地方没有记录是因为不适合这个物种,还是因为没人去过。论文按目标类群背景的思路处理:假设各物种被观测的努力程度大致相同,那么在“这里有一条观测”的条件下,观测努力可以消掉,剩下的是这条观测属于每个物种的比例,即相对出现率。它反映的是群落组成,不是物种在不在、有多少。作者指出 SINR 把这类数据当作有或无的二元标签处理,会在物种丰富的群落里扭曲概率。这个量的直接用途,是给相机陷阱或录音识别模型当地理先验:识别模型给出“像哪个物种”,OCELOT 给出“这里通常是哪些物种”,两者
数据怎么处理
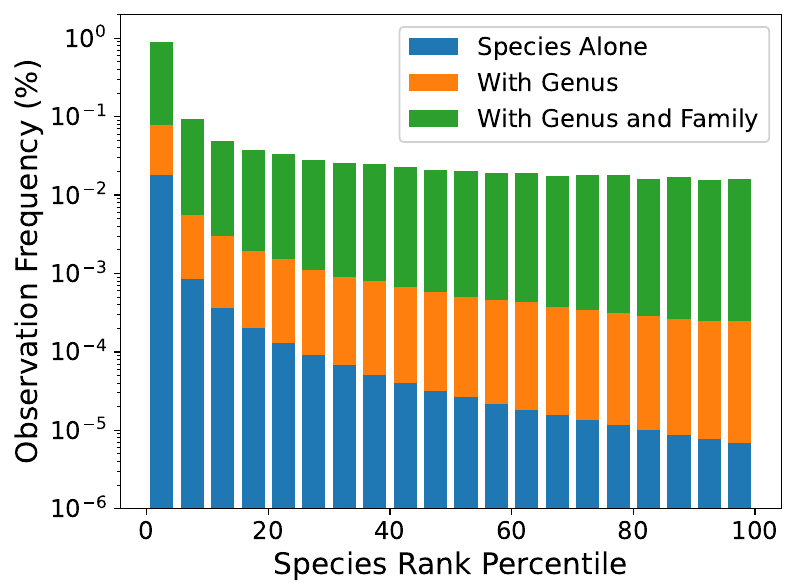
训练数据是 2026 年 9 月的 GBIF 快照:去掉有质量问题的记录、按学名对上 iNaturalist 的分类后,有 29.1 亿条记录、480,013 个物种。同一个物种同一天在同一个约 600 米的格子里只保留一条(这个尺度按时空辛普森多样性指数选出),去掉 8.387 亿条(28.8%)重复,剩 20.7 亿条;再按约 10 米的格子合并成 1.981 亿个多标签训练格子。词表取最常见的 10 万个物种,覆盖 99.66% 的观测,记录数从第一名的 2,090 万条一直降到第 10 万名的 132 条。每个格子的观测数呈重尾分布,按观测数给损失加权会让训练不稳定,所以改为按格子抽样;抽样指数经调参取 0.5(观测数的平方根),介于按记录和按地点均匀之间,减少热门地点的
02改变了什么
评测更新能力更新SINR 等模型只在已有观测附近测试;SINR 的作者据此认为环境数据几乎没有
把整块区域留出来测试,卫星嵌入带来 51% 的提升,并让 19 个人工气候变量变得
为什么要换一种测法
观测集中在人常去的地方,而相机陷阱和录音设备越来越多地布设在偏远地区,那里正是记录最少的地方。作者认为只在已有观测附近的测试分不出“记住了观测者去过哪里”的模型和“学会了环境”的模型。所以他们把地球按 S2 网格切成约 600、150、38 和 9 公里四种尺度的整块,八成训练、一成验证、一成测试,测试块内的训练数据全部拿掉。排序指标用 NDCG@500:看模型排在前 500 的格子里有多少个确有观测,靠前的权重更高;再用随机基线校正,算成技能分。为了计算量,它在约 50 万个留出地点、随机抽取的 4,096 个物种上计算。作者说,SINR 的“环境数据帮助不大”是只做内插测试得出的
Table 1 的结果:只用坐标 0.076,只用 19 个 WorldClim 气候变量 0.062,坐标加气候 0.083,只用卫星嵌入 0.090,坐标加卫星嵌入(即 OCELOT)0.115,三者都加仍是 0.115。也就是说,卫星嵌入单独就超过了坐标和气候变量,加上它之后气候变量不再有用。作者的解释是 AlphaEarth 嵌入本身已经隐含了位置、海拔和气候。按尺度看,卫星嵌入在最难的 600 公里尺度上提升最大(
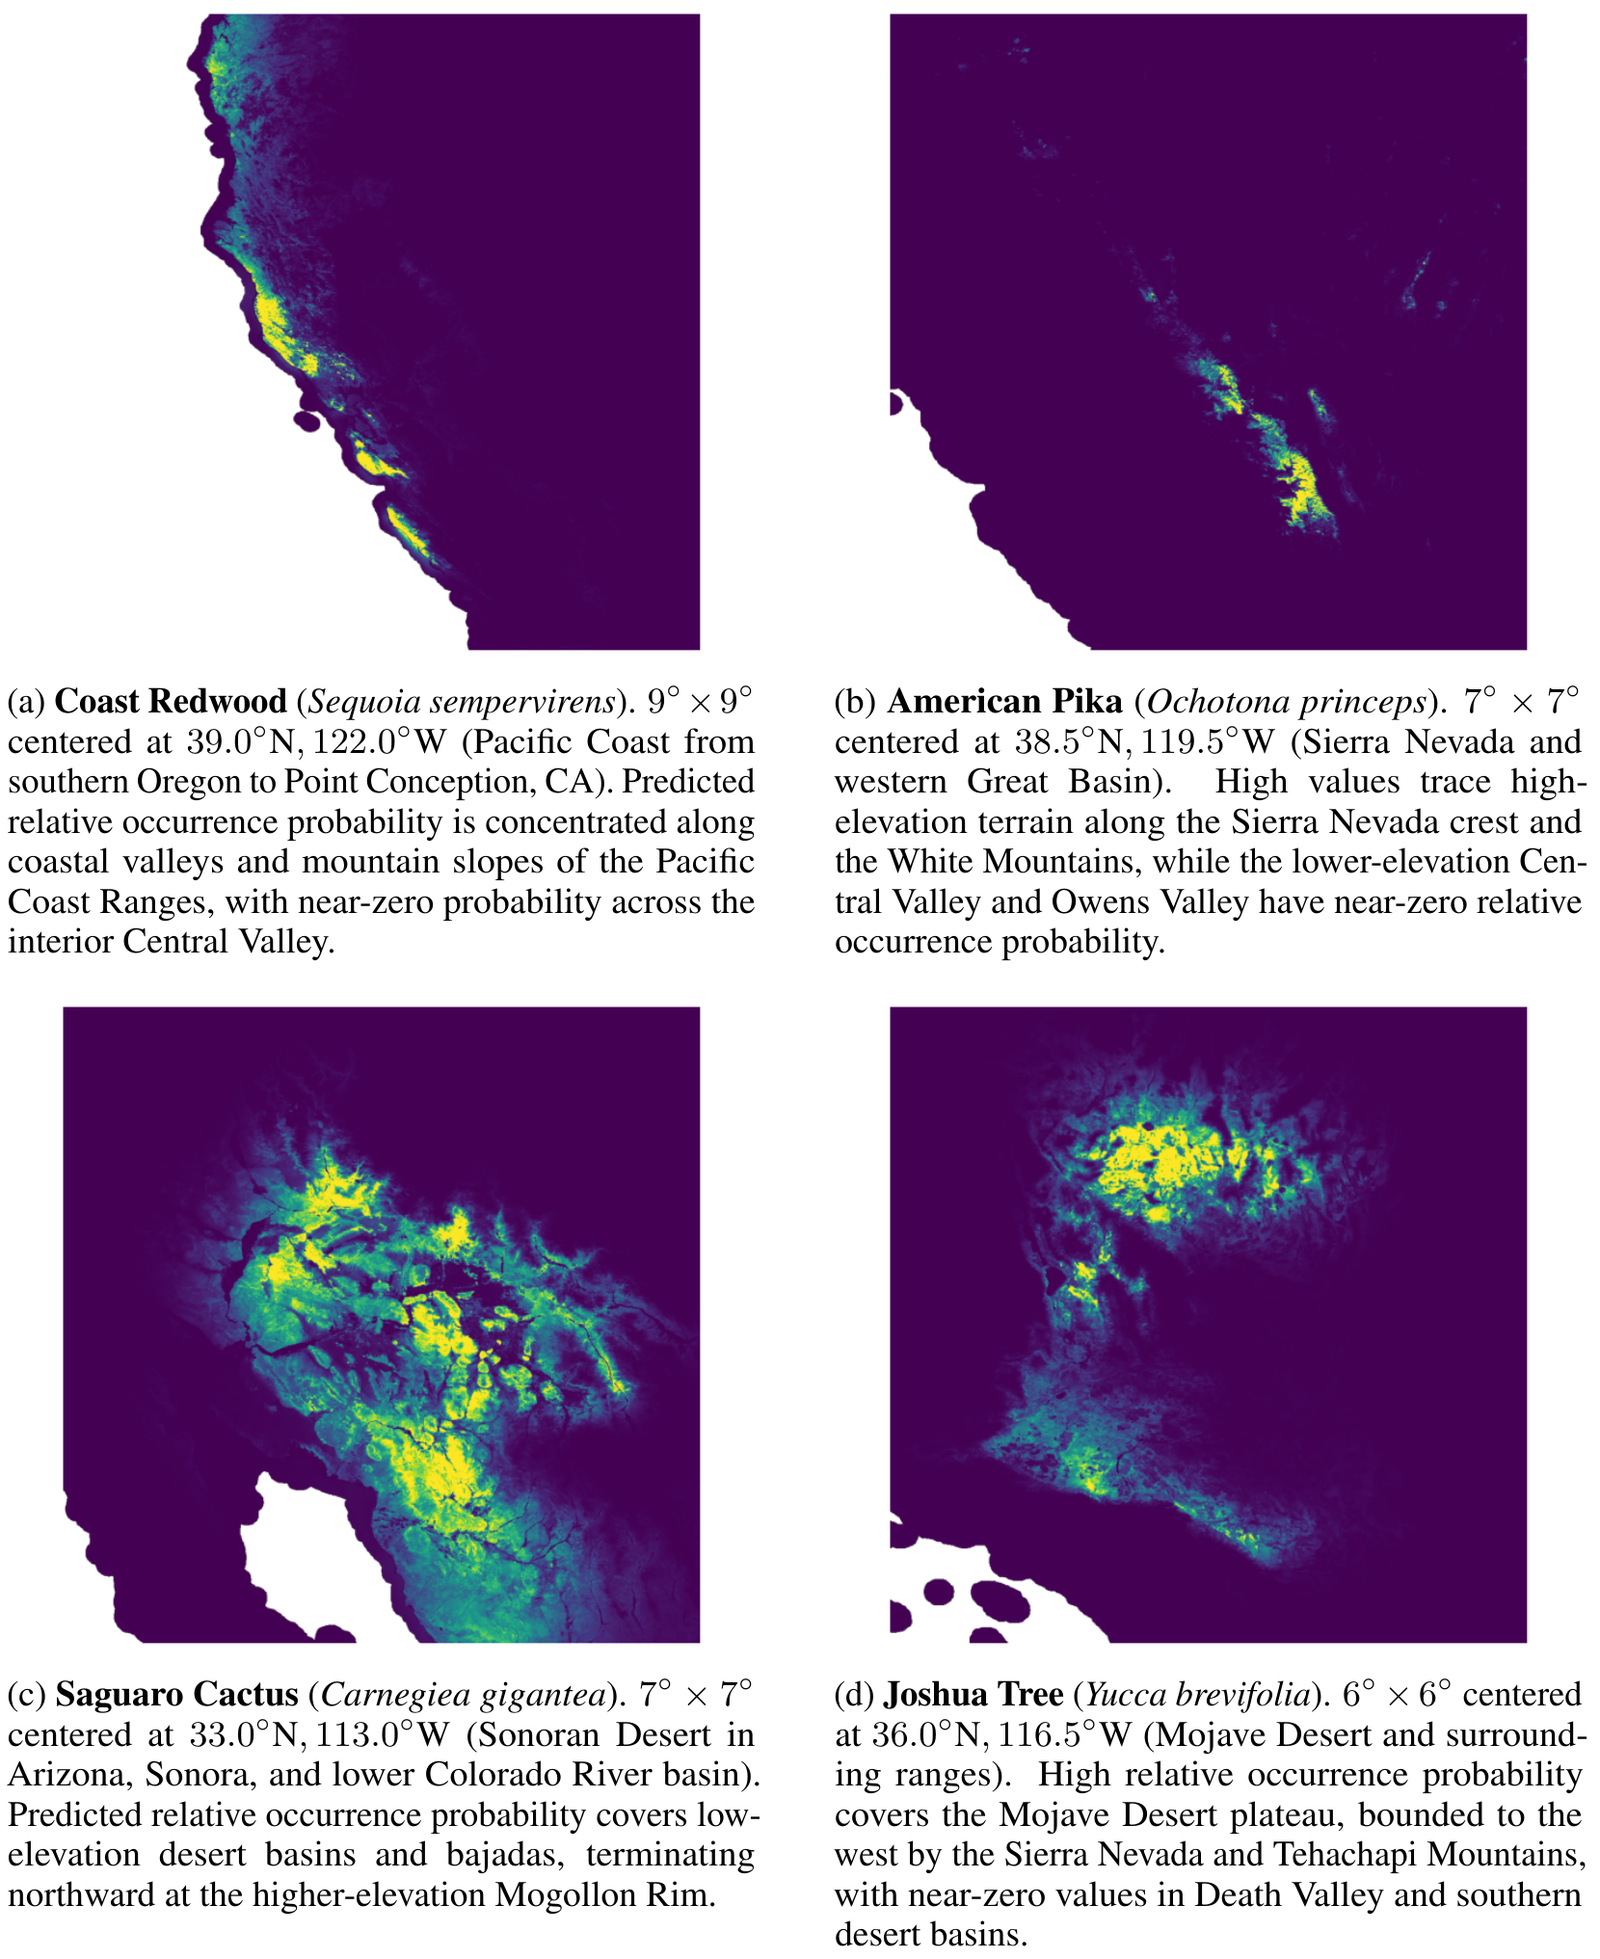
Figure 3:北美西部四个物种(海岸红杉、美洲鼠兔、巨人柱、约书亚树)的相对出现率预测,附作者对每幅图的说明。暖色(黄)表示相对出现率高,深蓝接近零。 [S1]
03为什么重要
做生物多样性监测的团队可以把这类全球模型当作相机陷阱和录音识别的地理
- 在留出区域上,卫星嵌入可以代替气候图层作为环境
输入。 - 训练在一块 H100 上约 20 小时;代码尚未
公开。
04证据状态与边界
证据等级 3 / 5 · 对照已有证据检验证据状态
已证实
- 留出区域得分 0.076 → 0.115(+51%),五
个种子 - 共享属和科:稀有物种 0.072
→ 0.075
边界
有迹象
- 胜只用坐标的 SINR,0.103 对 0.036,只在共有的 4,096 个
物种上 - IUCN 分布图 74.2%,低于 SINR
的 76.1%
未知
- 在真实相机陷阱和录音数据上是否帮
到识别 - 物种在不在、有多少(模型
不估)
主张卫星嵌入单独就超过坐标和气候变量;有了它,气候变量不再
留出区域的排序得分(NDCG@500 技能分),按输入组合
读法坐标 + 气候为 0.083。都在作者自己划分的留出区域上测;SINR 只在另一组物种上比过,不在
内插基准上的成绩。
作者也在 SINR 的三个基准上测了:作为图像识别的地理先验,OCELOT 首位准确率 86.4%(SINR 81.9%);eBird 北美 535 种鸟类分布图上平均精度 83.22%(SINR 80.48%);IUCN 2,418 个物种的专家分布图上 74.16%,低于带环境输入的 SINR 的 76.07%。作者说 eBird 和 IUCN 两项评的是有或无的分布范围,OCELOT 并没有为此训练;IUCN 的多边形是粗略的分布外沿,会惩罚精细的生境区分,这也是粗分辨率的气候变量在 IUCN 上略胜卫星嵌入的
和 SINR 的直接比较为什么只能部分做。
SINR 支持的物种和 OCELOT 不同,所以留出区域的比较只在双方都支持的 4,096 个物种上做:OCELOT 0.1034,只用坐标的 SINR 0.036。作者写明没有拿到带环境输入的 SINR 模型文件,所以那一版没有参加留出区域测试。论文也说,OCELOT 和以往模型在训练数据规模、架构和损失上都不同,不能把差距全归于某一处
作者写下的边界。
模型不考虑时间:季节迁徙、物候变化和长期分布变化都没有建模。卫星嵌入是潜在向量,不像气候变量那样能直接解释成物理量,要事后探查才能知道预测靠的是哪种环境因素。系统是一个静态模型,没有办法在不重训的情况下加入专家观测或新物种。下一步包括加入物候、在真实布设数据上评估、扩展到更多类群和
05我从中学到什么
- 可迁移的洞见
- 测法会改变结论:同一批环境数据,内插测试里看似没用,留出整块区域时提
升 51%。 - 设计启发
- 按物种、属、科相加的权重,让只有一百多条记录的稀有物种也能借到近亲的训练
信号。 - 阅读启发
- 看到分布模型的高分,先问是在已有观测附近测的,还是把整块区域留出来
测的。 - 接下来看
- 权重和全球地图公开;在真实相机陷阱或录音数据上提高识别的结果;外部团队的
复现。
长图版本方便保存转发→资料来源
文中事实尽量链接至原始公告、项目清单、试验登记或同行评审论文;研究计划与已完成结果分开记录。