

论文解读· 科学证据 · Frontier
Inherent Faraday:一个 27B 判断模型调用前沿编码智能体做科研
Inherent 训练的不是写代码的本事,而是写代码之外的决策:做哪个实验,证据够不够,要不要再来一轮。代码交给眼下写得最好的模型。
◆预印本 + 自建基准 + 自建 LLM judge
当前边界:能确认的是一种分工方式行得通,而不是 AI 已经会做科研
这项工作推进的是:把研究判断(做哪个实验、证据够不够、要不要再来一轮)单独训练进一个 27B 模型,代码交给可替换的前沿 coding agent 去写
- MODEL理解 / 预测
- DECIDE选择下一步
- INTERACT测试现实
- UPDATE改变下一轮
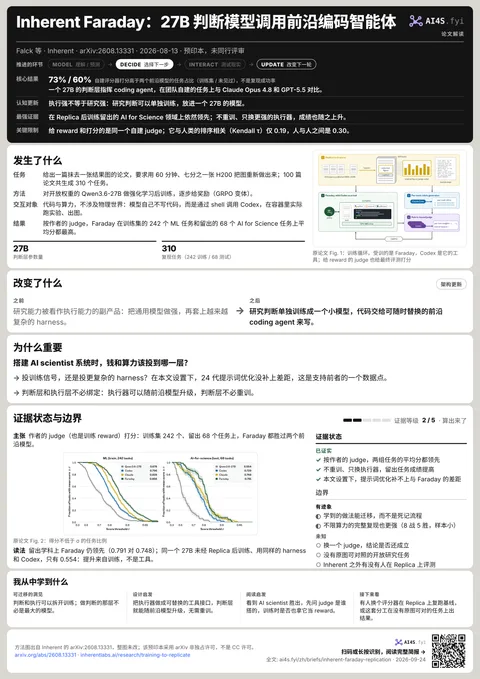
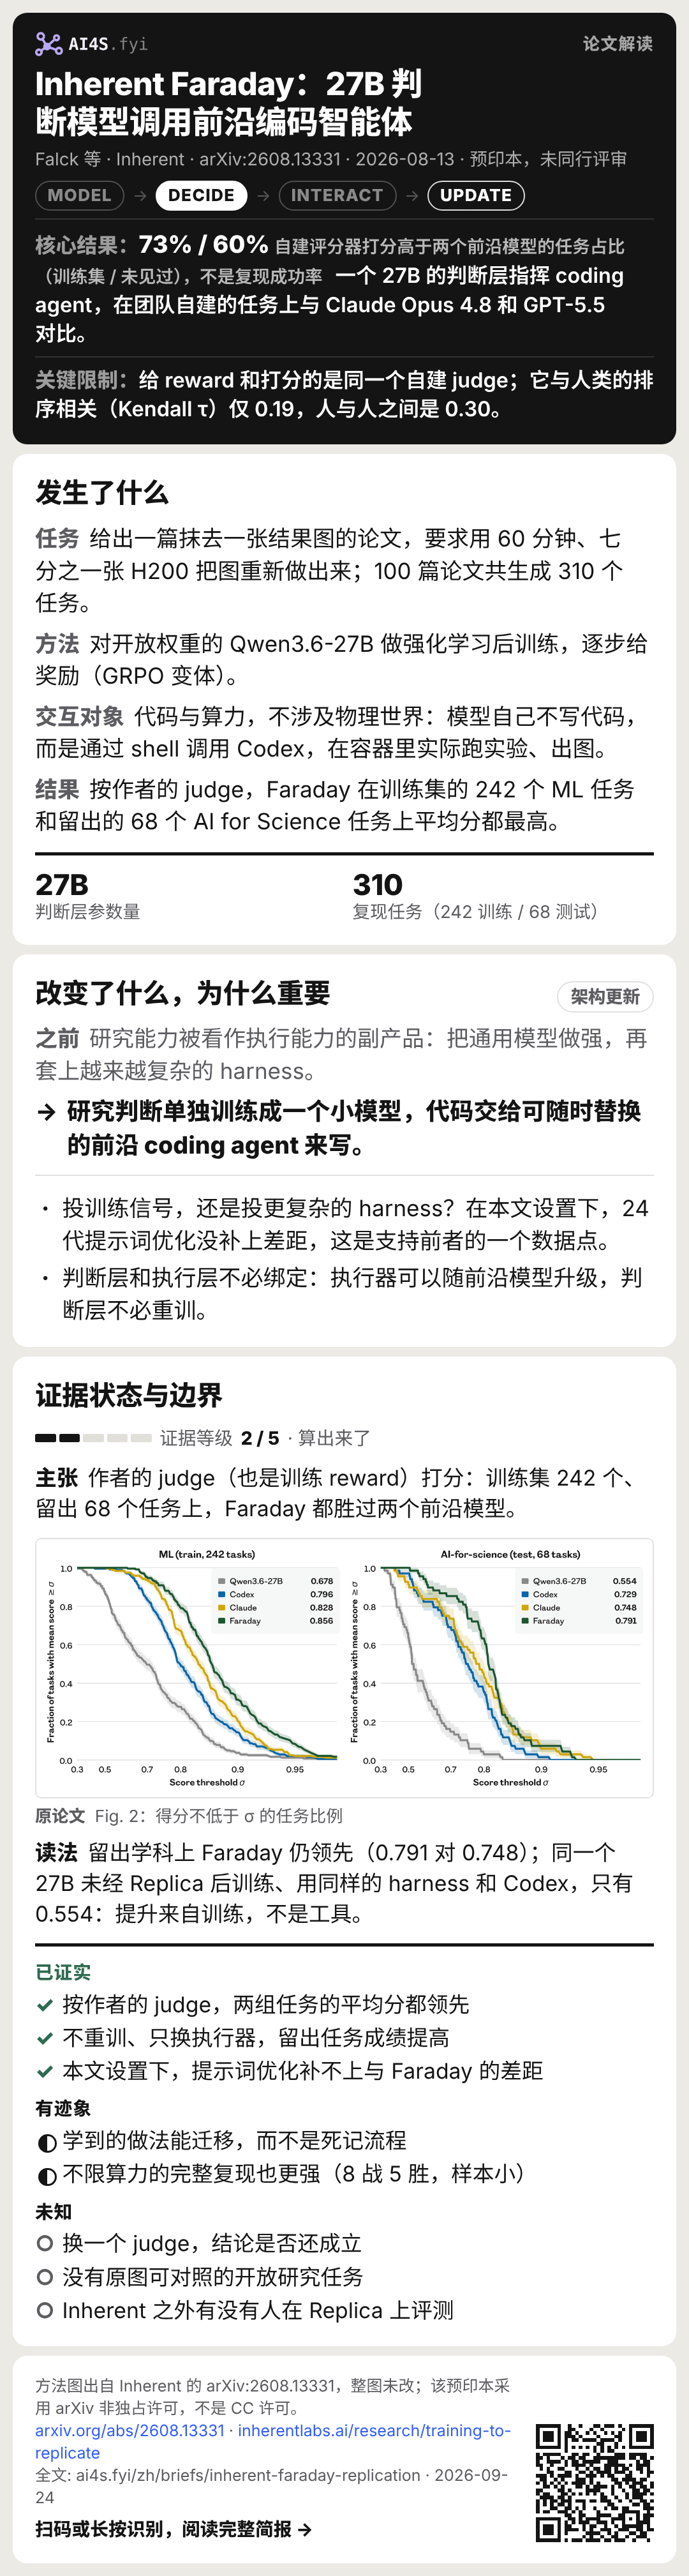
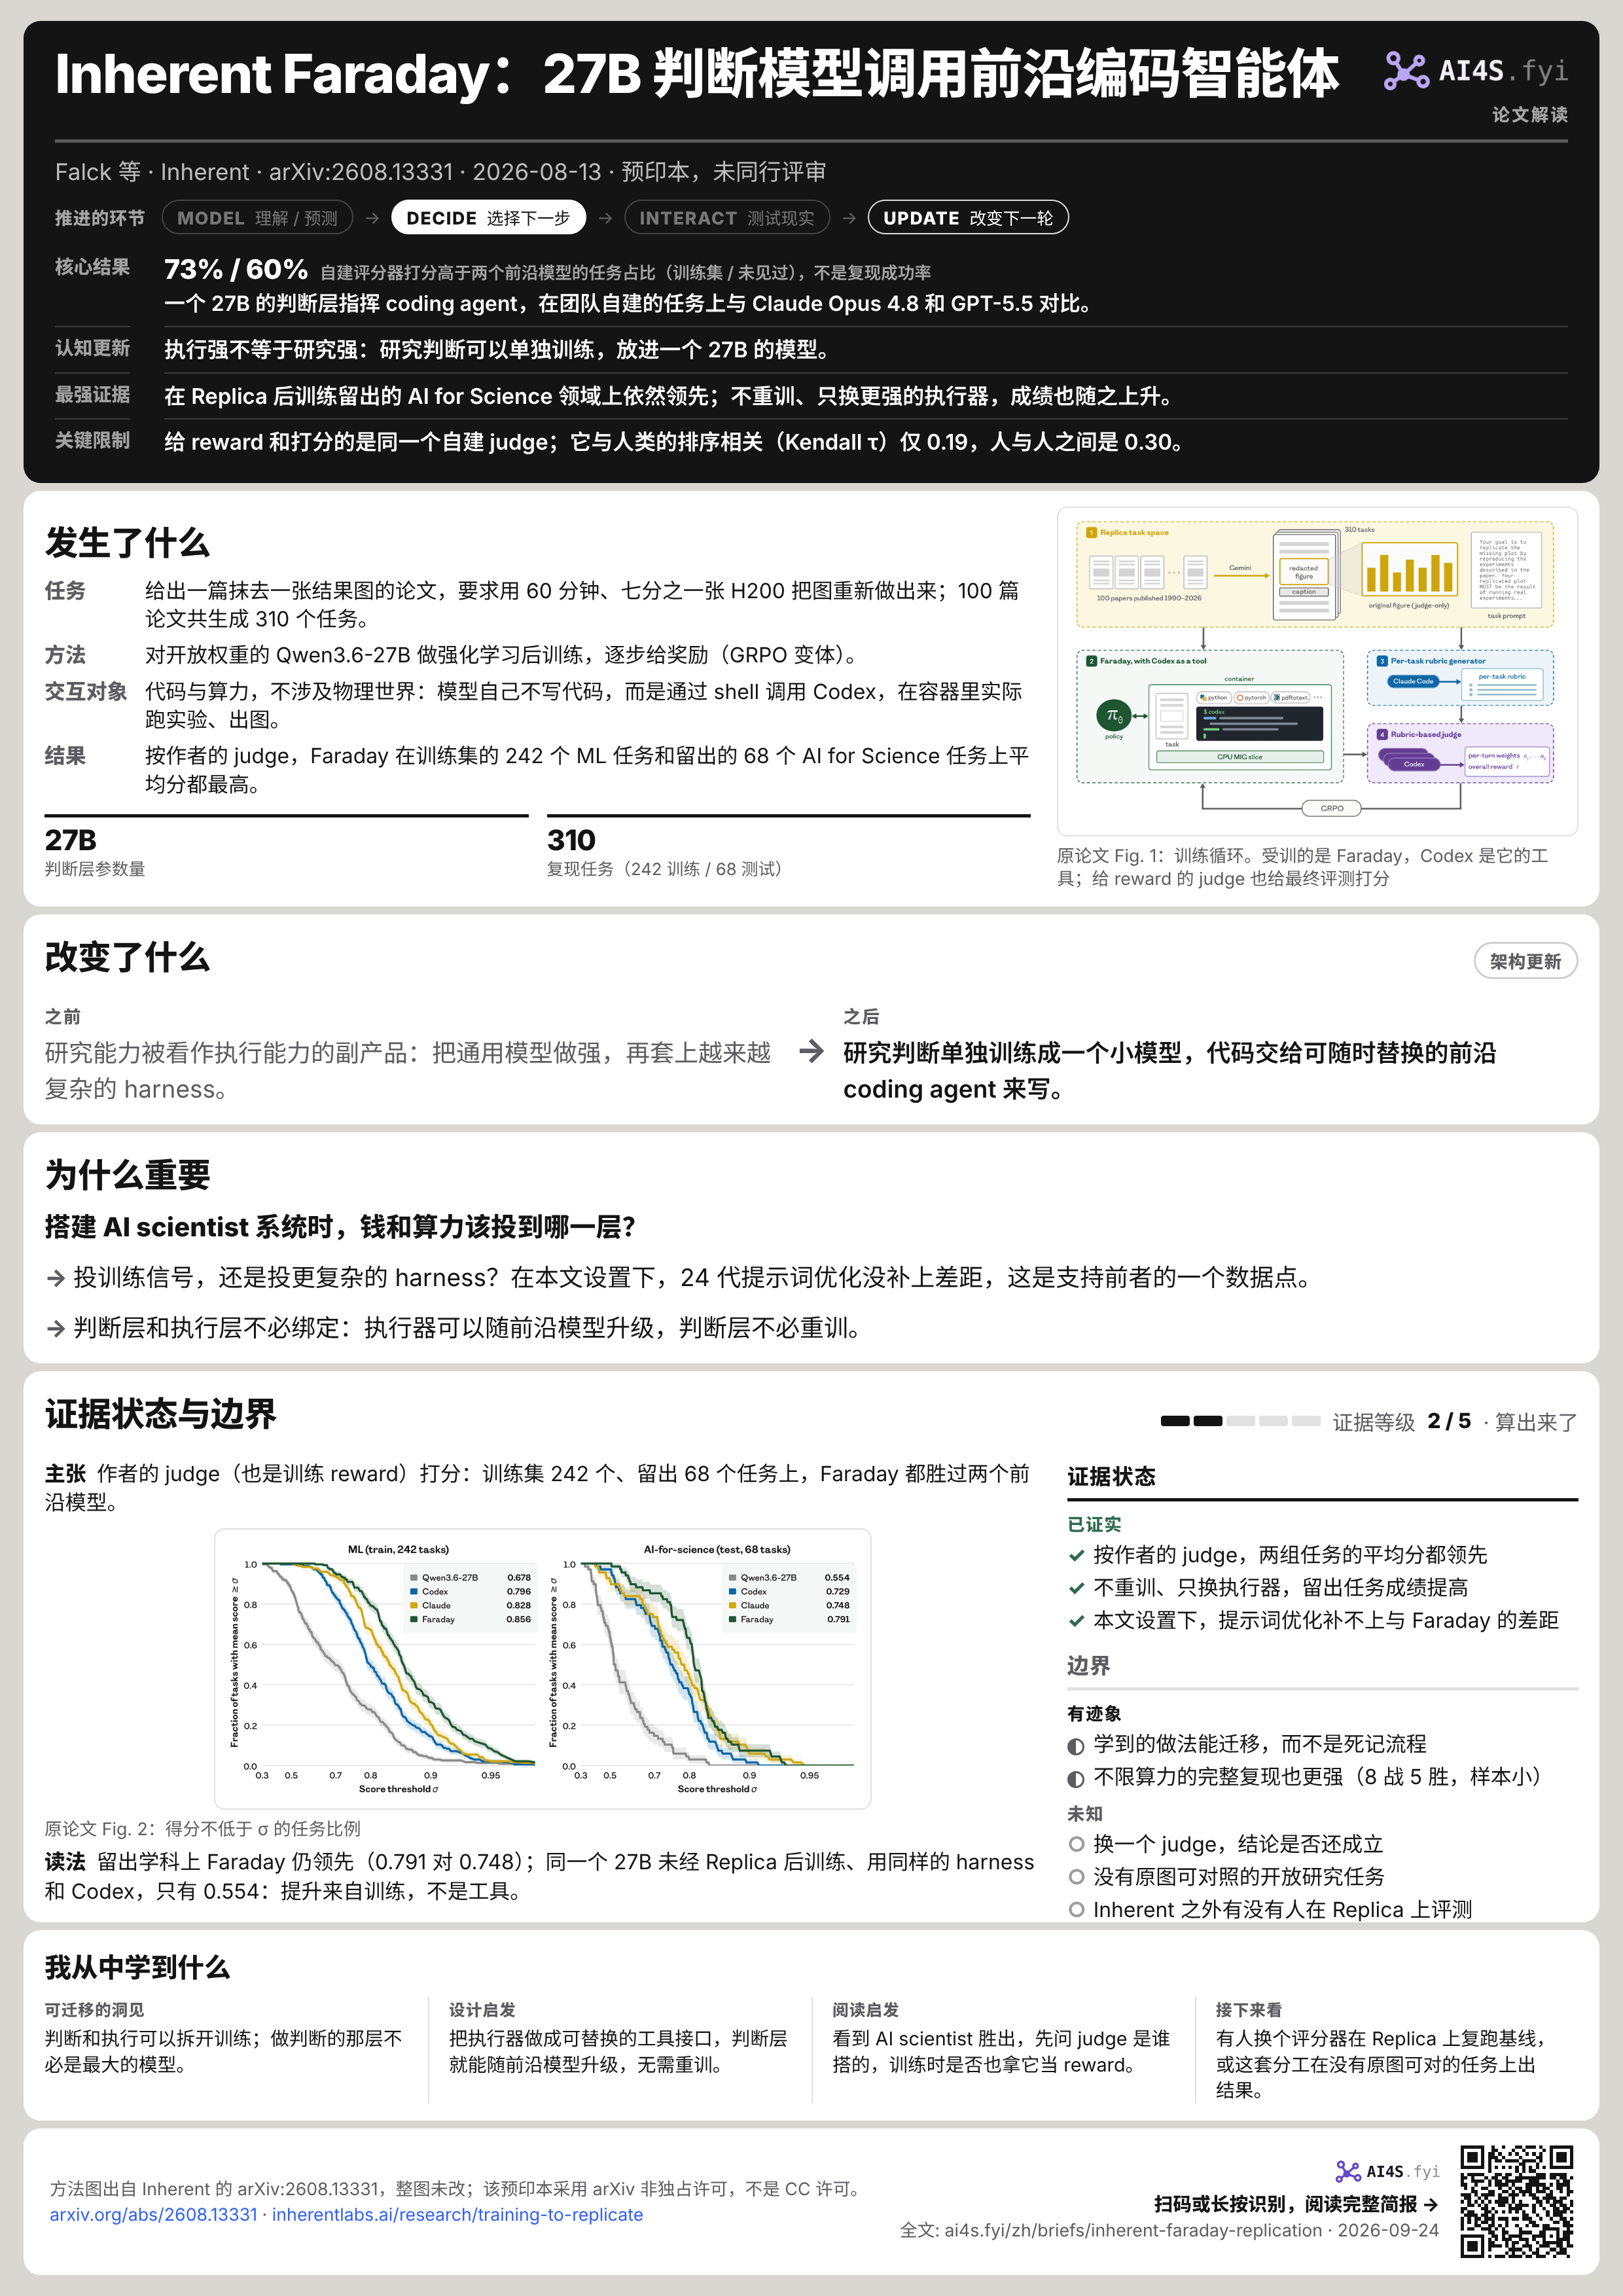
73% / 60%自建评分器打分高于两个前沿模型的任务占比(训练集 / 未见过),不是复现成功率
一个 27B 的判断层指挥 coding agent,在团队自建的任务上与 Claude Opus 4.8 和 GPT-5.5 对比。
- 认知更新
- 执行强不等于研究强:研究判断可以单独训练,放进一个 27B 的模型。
- 最强证据
- 在 Replica 后训练留出的 AI for Science 领域上依然领先;不重训、只换更强的执行器,成绩也随之上升。
- 关键限制
- 给 reward 和打分的是同一个自建 judge;它与人类的排序相关(Kendall τ)仅 0.19,人与人之间是 0.30。
01发生了什么
- 任务
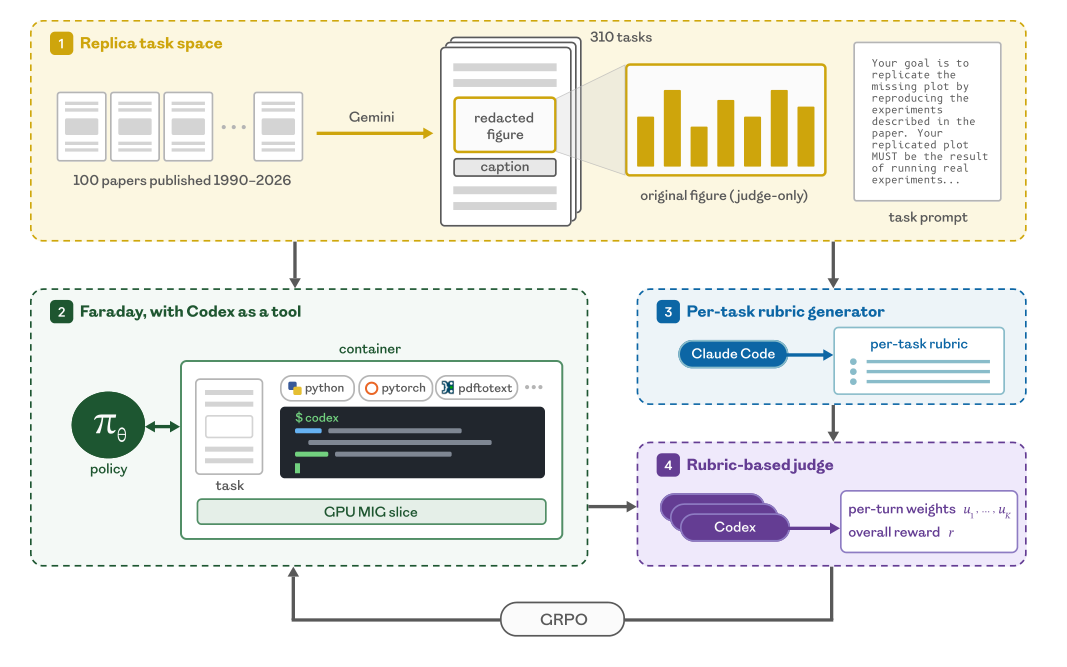
- 给出一篇抹去一张结果图的论文,要求用 60 分钟、七分之一张 H200 把图重新做出来;100 篇论文共生成 310 个任务。
- 方法
- 对开放权重的 Qwen3.6-27B 做强化学习后训练,逐步给奖励(GRPO 变体)。
- 交互对象
- 代码与算力,不涉及物理世界:模型自己不写代码,而是通过 shell 调用 Codex,在容器里实际跑实验、出图。
- 结果
- 按作者的 judge,Faraday 在训练集的 242 个 ML 任务和留出的 68 个 AI for Science 任务上平均分都最高。
27B判断层参数量
310复现任务(242 训练 / 68 测试)
Inherent 是一家伦敦公司,2026 年 5 月结束隐身模式公开亮相,创始成员大多出自 DeepMind,种子轮融资 5000 万美元,由 Index Ventures 和 Radical Ventures 联合领投。2026 年 8 月 13 日,公司发布了 Replica 与 Faraday。[S3][S1]
任务是复现一张结果图。
Replica 从 100 篇知名的机器学习和 AI for Science 论文中生成了 310 个任务,其中 242 个用于训练,68 个用于测试。每个任务交给智能体一篇论文,文中的某张结果图已被不可逆地抹去,智能体要在 60 分钟内、用七分之一张 H200 的算力把这张图重新做出来。算力不足以完整复现时,提示词要求它做一个尽量忠实的缩小版。任务由 Gemini 2.5 Pro 分三个视觉-语言阶段自动生成,再由人工逐一检查,剔除质量差的。[S1]
测试集换了学科,不只是换了论文。
训练任务取自 1990 至 2026 年的机器学习论文,测试任务取自 2012 至 2026 年的 AI for Science 论文。因此留出的不是几篇没见过的文章,而是 Replica 后训练阶段留出的整个研究领域。作者据此认为,它学到的不是死记下来的某套流程,而是一种能迁移的办法,用来应对交代不清的任务。但这只说明后训练没有用过这些任务,不说明模型从未见过相关知识:论文附录 D.1 自己承认,所选论文连同其中的图,有一些无疑在前沿多模态模型的预训练数据里;作者的论据是,产生这些图的过程数据从未被记录,也就没有模型拿它训练过。[S1]
02改变了什么
架构更新研究能力被看作执行能力的副产品:把通用模型做强,再套上越来越复杂的 harness。
研究判断单独训练成一个小模型,代码交给可随时替换的前沿 coding agent 来写。
coding agent 只是它的工具
这篇论文真正新的地方不在分数,而在架构。[S1]
Faraday 自己不写代码。
它以开放权重的 Qwen3.6-27B 为基座,在 Replica 上用一种带 turn-level credit 的 GRPO 变体做后训练,手里只有五个工具:apply_patch、read_file、list_dir、grep_files、shell。真正写代码的是一个前沿 coding agent:Codex CLI 被封装成脚本,Faraday 通过 shell 调用它,拿回一份执行记录,里面有命令、输出和每一步的耗时。它可以接着上一次会话继续,可以重置上下文,也可以同时开几个并行。论文把这种设计称为 coding agent as a tool。作者的立场很明确:Faraday 的科学能力来自改变策略权重,而不是把 harness 搞复杂。论文还说,Faraday 以 27B 参数指挥一个估计约 5T 参数的模型,这个数引自第三方估计(Li, 2026);前沿模型的参数量没有公开,所以本页只说「27B 判断模型调用前沿编码智能体」,不说它指挥的模型大多少。[S1]
换上更强的执行器,成绩随之上升。
正是这个结果,让它算得上一种模式,而不只是一次调参技巧。Faraday 训练初期,Codex 工具背后用的是 GPT-5.4 mini。作者取出只配合 GPT-5.4 mini 训练过的最后一个检查点,把工具换成 GPT-5.5,不做任何重训,留出的 AI for Science 任务上成绩就提高了。判断层并没有和训练时用的执行器绑死。[S1]
改提示词补不上这段差距。
作者对 Codex 基线跑了 24 代自动提示词优化:每代抽 10 个训练任务,每个任务 8 次 rollout,由 Claude Opus 4.8 参照全部历史记录(包括 judge 的反馈)重写提示词。优化后的提示词准确点出了失败模式,成绩却没有明显改善,与 Faraday 的差距依旧。这个负结果只适用于这里的设置:一种优化方法、一个基线、同一个 judge。[S1]
03为什么重要
搭建 AI scientist 系统时,钱和算力该投到哪一层?
- 投训练信号,还是投更复杂的 harness?在本文设置下,24 代提示词优化没补上差距,这是支持前者的一个数据点。
- 判断层和执行层不必绑定:执行器可以随前沿模型升级,判断层不必重训。
过去两年,AI4S 默认的假设是:模型越强,科研能力就越强,其余交给 harness 和工具。这篇论文提供了一个反例:执行能力强不等于研究能力强。另加一层单独学过实验选择、证据评估和迭代的研究策略,就能得到执行器本身没有的能力,而且这一层不必放在最大的模型里。[S1][S2]
把分数拆开来看,这个判断会更具体。Faraday 领先的维度是实验深度(experimental depth)、主张复现(claim reproduction)和视觉还原度(visual fidelity);在科学诚信(scientific integrity)和实现忠实度(implementation fidelity)上,它与 Claude 持平。换句话说,它赢在把研究做得更彻底,多试了几种条件,真正对上了论文的主张,而不是代码写得更好。这恰恰属于「判断」,而非「执行」。[S1]
04证据状态与边界
证据等级 2 / 5 · 算出来了 · 回顾性或模拟证据状态
已证实
- 按作者的 judge,两组任务的平均分都领先
- 不重训、只换执行器,留出任务成绩提高
- 本文设置下,提示词优化补不上与 Faraday 的差距
边界
有迹象
- 学到的做法能迁移,而不是死记流程
- 不限算力的完整复现也更强(8 战 5 胜,样本小)
未知
- 换一个 judge,结论是否还成立
- 没有原图可对照的开放研究任务
- Inherent 之外有没有人在 Replica 上评测
主张作者的 judge(也是训练 reward)打分:训练集 242 个、留出 68 个任务上,Faraday 都胜过两个前沿模型。
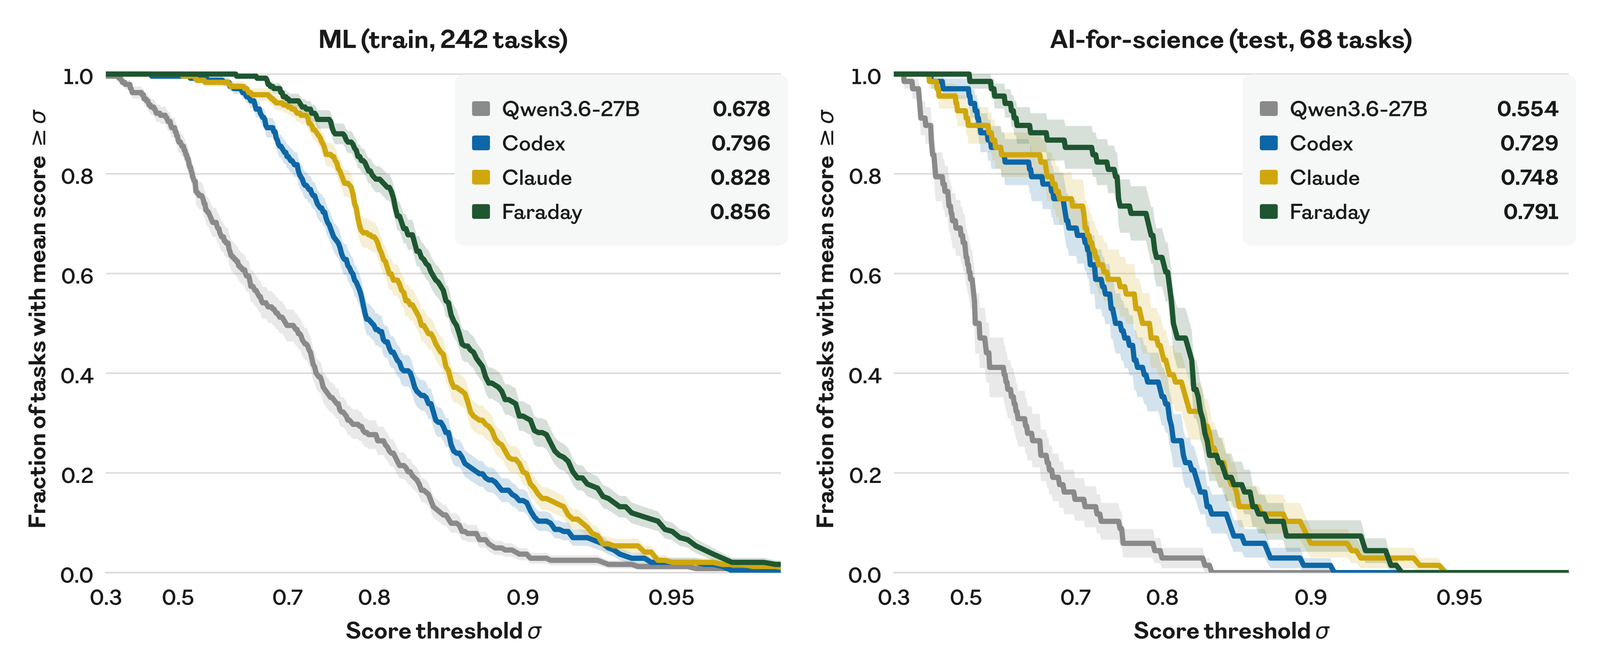
读法留出学科上 Faraday 仍领先(0.791 对 0.748);同一个 27B 未经 Replica 后训练、用同样的 harness 和 Codex,只有 0.554:提升来自训练,不是工具。
差距靠训练补上,不靠工具。
Fig. 2 里还有第四条曲线,属于未经 Replica 后训练的 Qwen3.6-27B。论文图注写明,它与 Faraday 跑在同一个简单的 harness 里,同样可以调用 Codex GPT-5.5,两者唯一的区别是 Faraday 在 Replica 上做过 RL 后训练。两者的平均分,训练集的 242 个同分布任务上是 0.678 对 0.856,留出的 68 个任务上是 0.554 对 0.791。可见光把前沿 coding agent 交给一个小模型还不够,差距是靠训练补上的。[S1]
同一个 judge 既给 reward,又判最终成绩。
每个任务的评分细则由 Claude Opus 4.7 依据一份元细则生成,具体打分由 Codex GPT-5.5 完成。这个 judge 在训练时提供 reward 和逐轮的 credit,评测时又给 Faraday 和两个基线打分。流程本身交代得很清楚,但这意味着「Faraday 更好」这个结论,是拿作者自己造、训练时也在用的那把尺子量出来的。[S1]
这把尺子与人的一致度是 0.19。
作者做了一项人类研究来校准它:rubric judge 与人类排序的 Kendall τ(排序相关系数,1 为完全一致,-1 为完全相反,不是一致率)为 0.19,高于基线 judge 的 0.15;但两个人类之间也只有 0.30,而 judge 自己两次打分之间有 0.66。可以这样理解:这个 judge 很稳定,也确实比简单的 judge 更贴近人的偏好,但在这里,「与人类一致」本身就是一个不高的门槛,因为复现得好不好,连人与人之间都难有共识。况且这些任务是专门挑出来的,正是两个 judge 分歧最大的那批。作者也坦言还有改进空间。[S1]
复现不是发现。
论文对此说得很直白:复现是通往创新的垫脚石,因为补全论文中语焉不详的细节,和设计自己的实验,所需的可能是同一种能力。但每个复现任务都有一张 gold plot 当标准答案,有了它才能自动打分、规模化训练,而开放的研究恰恰没有这样的答案。作者还特意声明,Faraday 没能复现的论文,不应被解读为原研究有问题;语料中也有作者本人或其熟人写的论文。[S1]
05我从中学到什么
- 可迁移的洞见
- 判断和执行可以拆开训练;做判断的那层不必是最大的模型。
- 设计启发
- 把执行器做成可替换的工具接口,判断层就能随前沿模型升级,无需重训。
- 阅读启发
- 看到 AI scientist 胜出,先问 judge 是谁搭的,训练时是否也拿它当 reward。
- 接下来看
- 有人换个评分器在 Replica 上复跑基线,或这套分工在没有原图可对的任务上出结果。
没有标准答案,这套分工还行不行。
Faraday 已经露出两点苗头:在 20 个换数据集或改主张的反事实变体上,它几乎全部领先;在不限算力的完整复现上,它 8 战 5 胜。但这两类任务都还有东西可以对照。真正的考验是没有 gold plot 时怎么打分:如果研究判断只能靠有标准答案的任务来训练,这条路线的天花板就在这里。
有没有第三方在 Replica 上独立评测。
目前任务集、评分细则、judge 和结论都出自同一家公司,作者在讨论部分表示欢迎社区参与。只要有一次外部评测,哪怕只是有人换个 judge 在同一批任务上复跑基线,这条记录就能从「公司给自己打分」变成「经过外部对照检验的主张」。
别人会不会也把「判断」和「执行」拆开。
这一条最值得追踪。如果这个模式成立,AI4S 的系统架构会从「一个通用模型调用工具」转向「科学判断层 + 可替换的专业执行器」,执行器可以随前沿模型更新自由升级;Faraday 换执行器无需重训,已经说明这在技术上可行。真正的信号,是第二家、第三家团队各自独立地走到同样的结构上。
长图版本方便保存转发→资料来源
本文依据 arXiv:2608.13331 全文(经 arXiv HTML 版逐节读过,包括附录 A 的泛化实验和附录 F 的人类研究),以及 Inherent 同期发布的公司文章。公司所在地、融资和创始人背景引自 tech.eu 的报道。文中引用的数值均取自正文和图注的文字,没有从图上读数。