

公司发布解读· 科学证据 · Frontier
Periodic Labs:实验结果开始变成模型的训练信号
Periodic Labs 同一天发布的三篇文章里,讲得最完整的一段是表征:模型学会判断一次合成究竟做出了什么,这个判断又回到下一轮训练。
◆公司技术博客 + 内部基准 + 专家标注
当前边界:确认下来的是一段表征能力,以及它能靠实验数据训练出来
这项工作推进的是:把实验室自己的衍射数据变成后训练信号,让模型替科学家判读做出了什么
- MODEL理解 / 预测
- DECIDE选择下一步
- INTERACT测试现实
- UPDATE改变下一轮
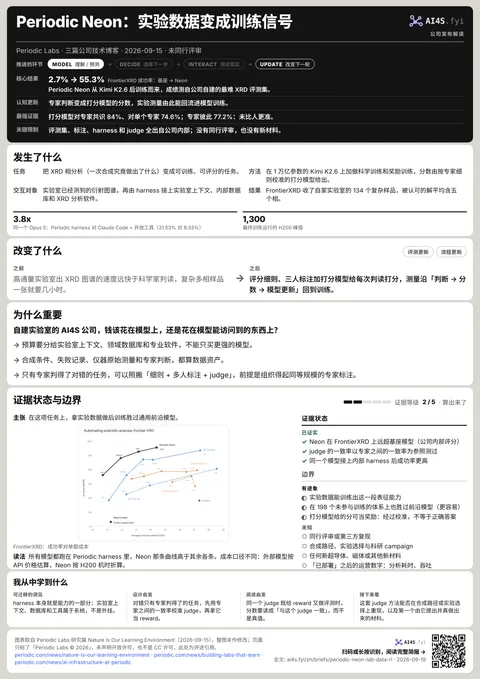
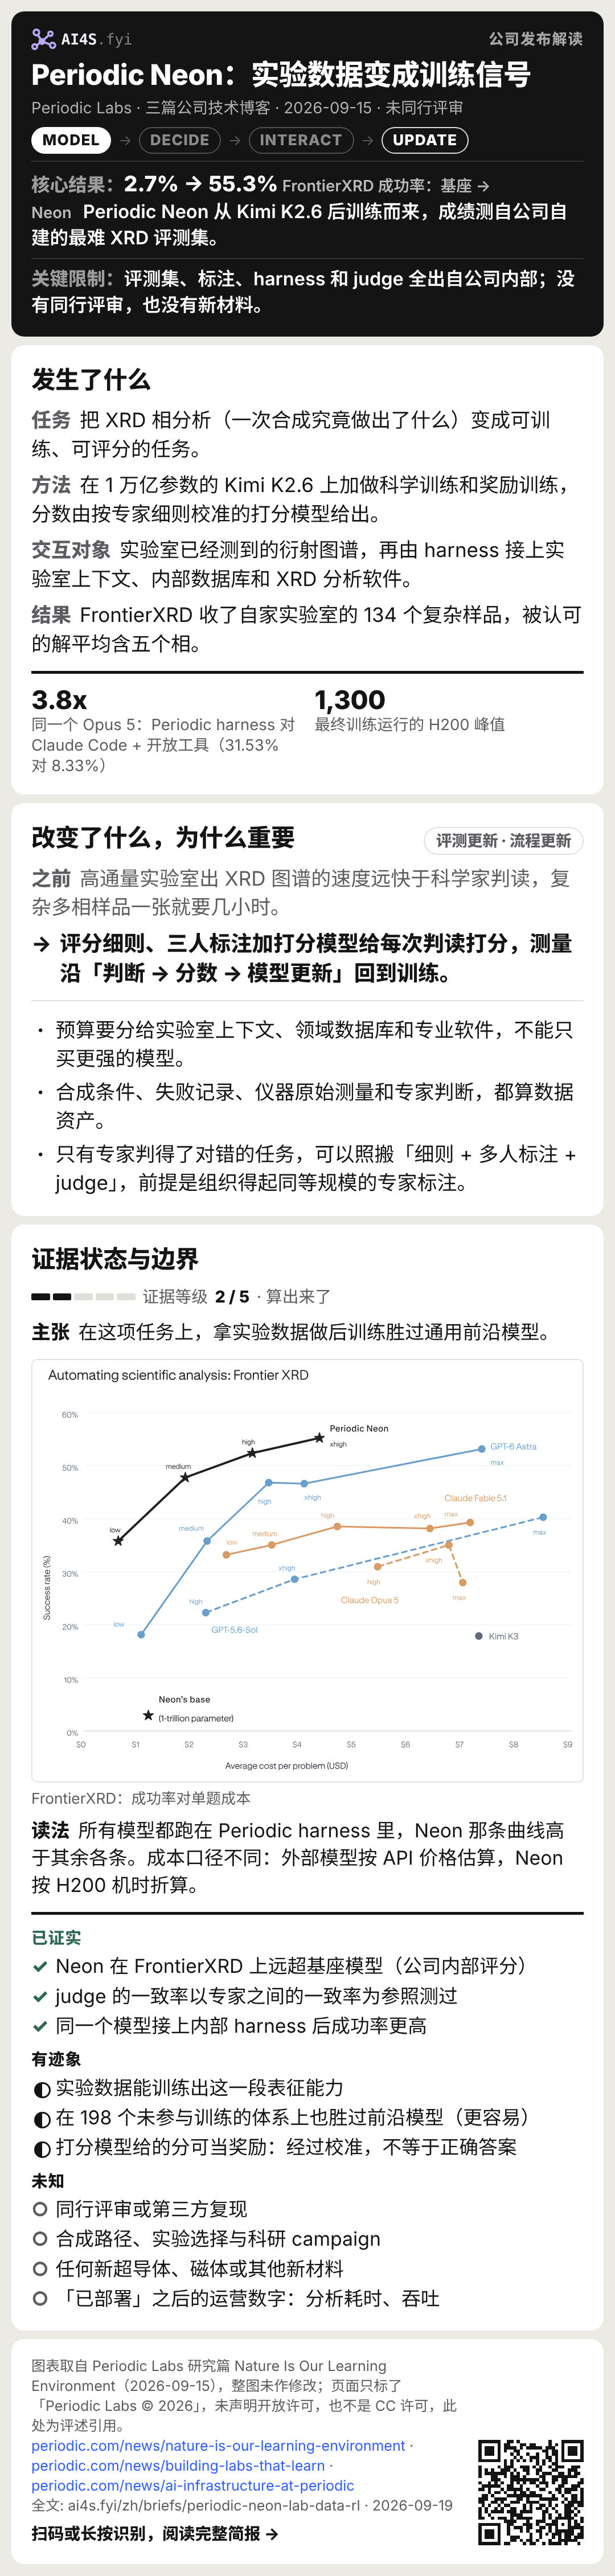
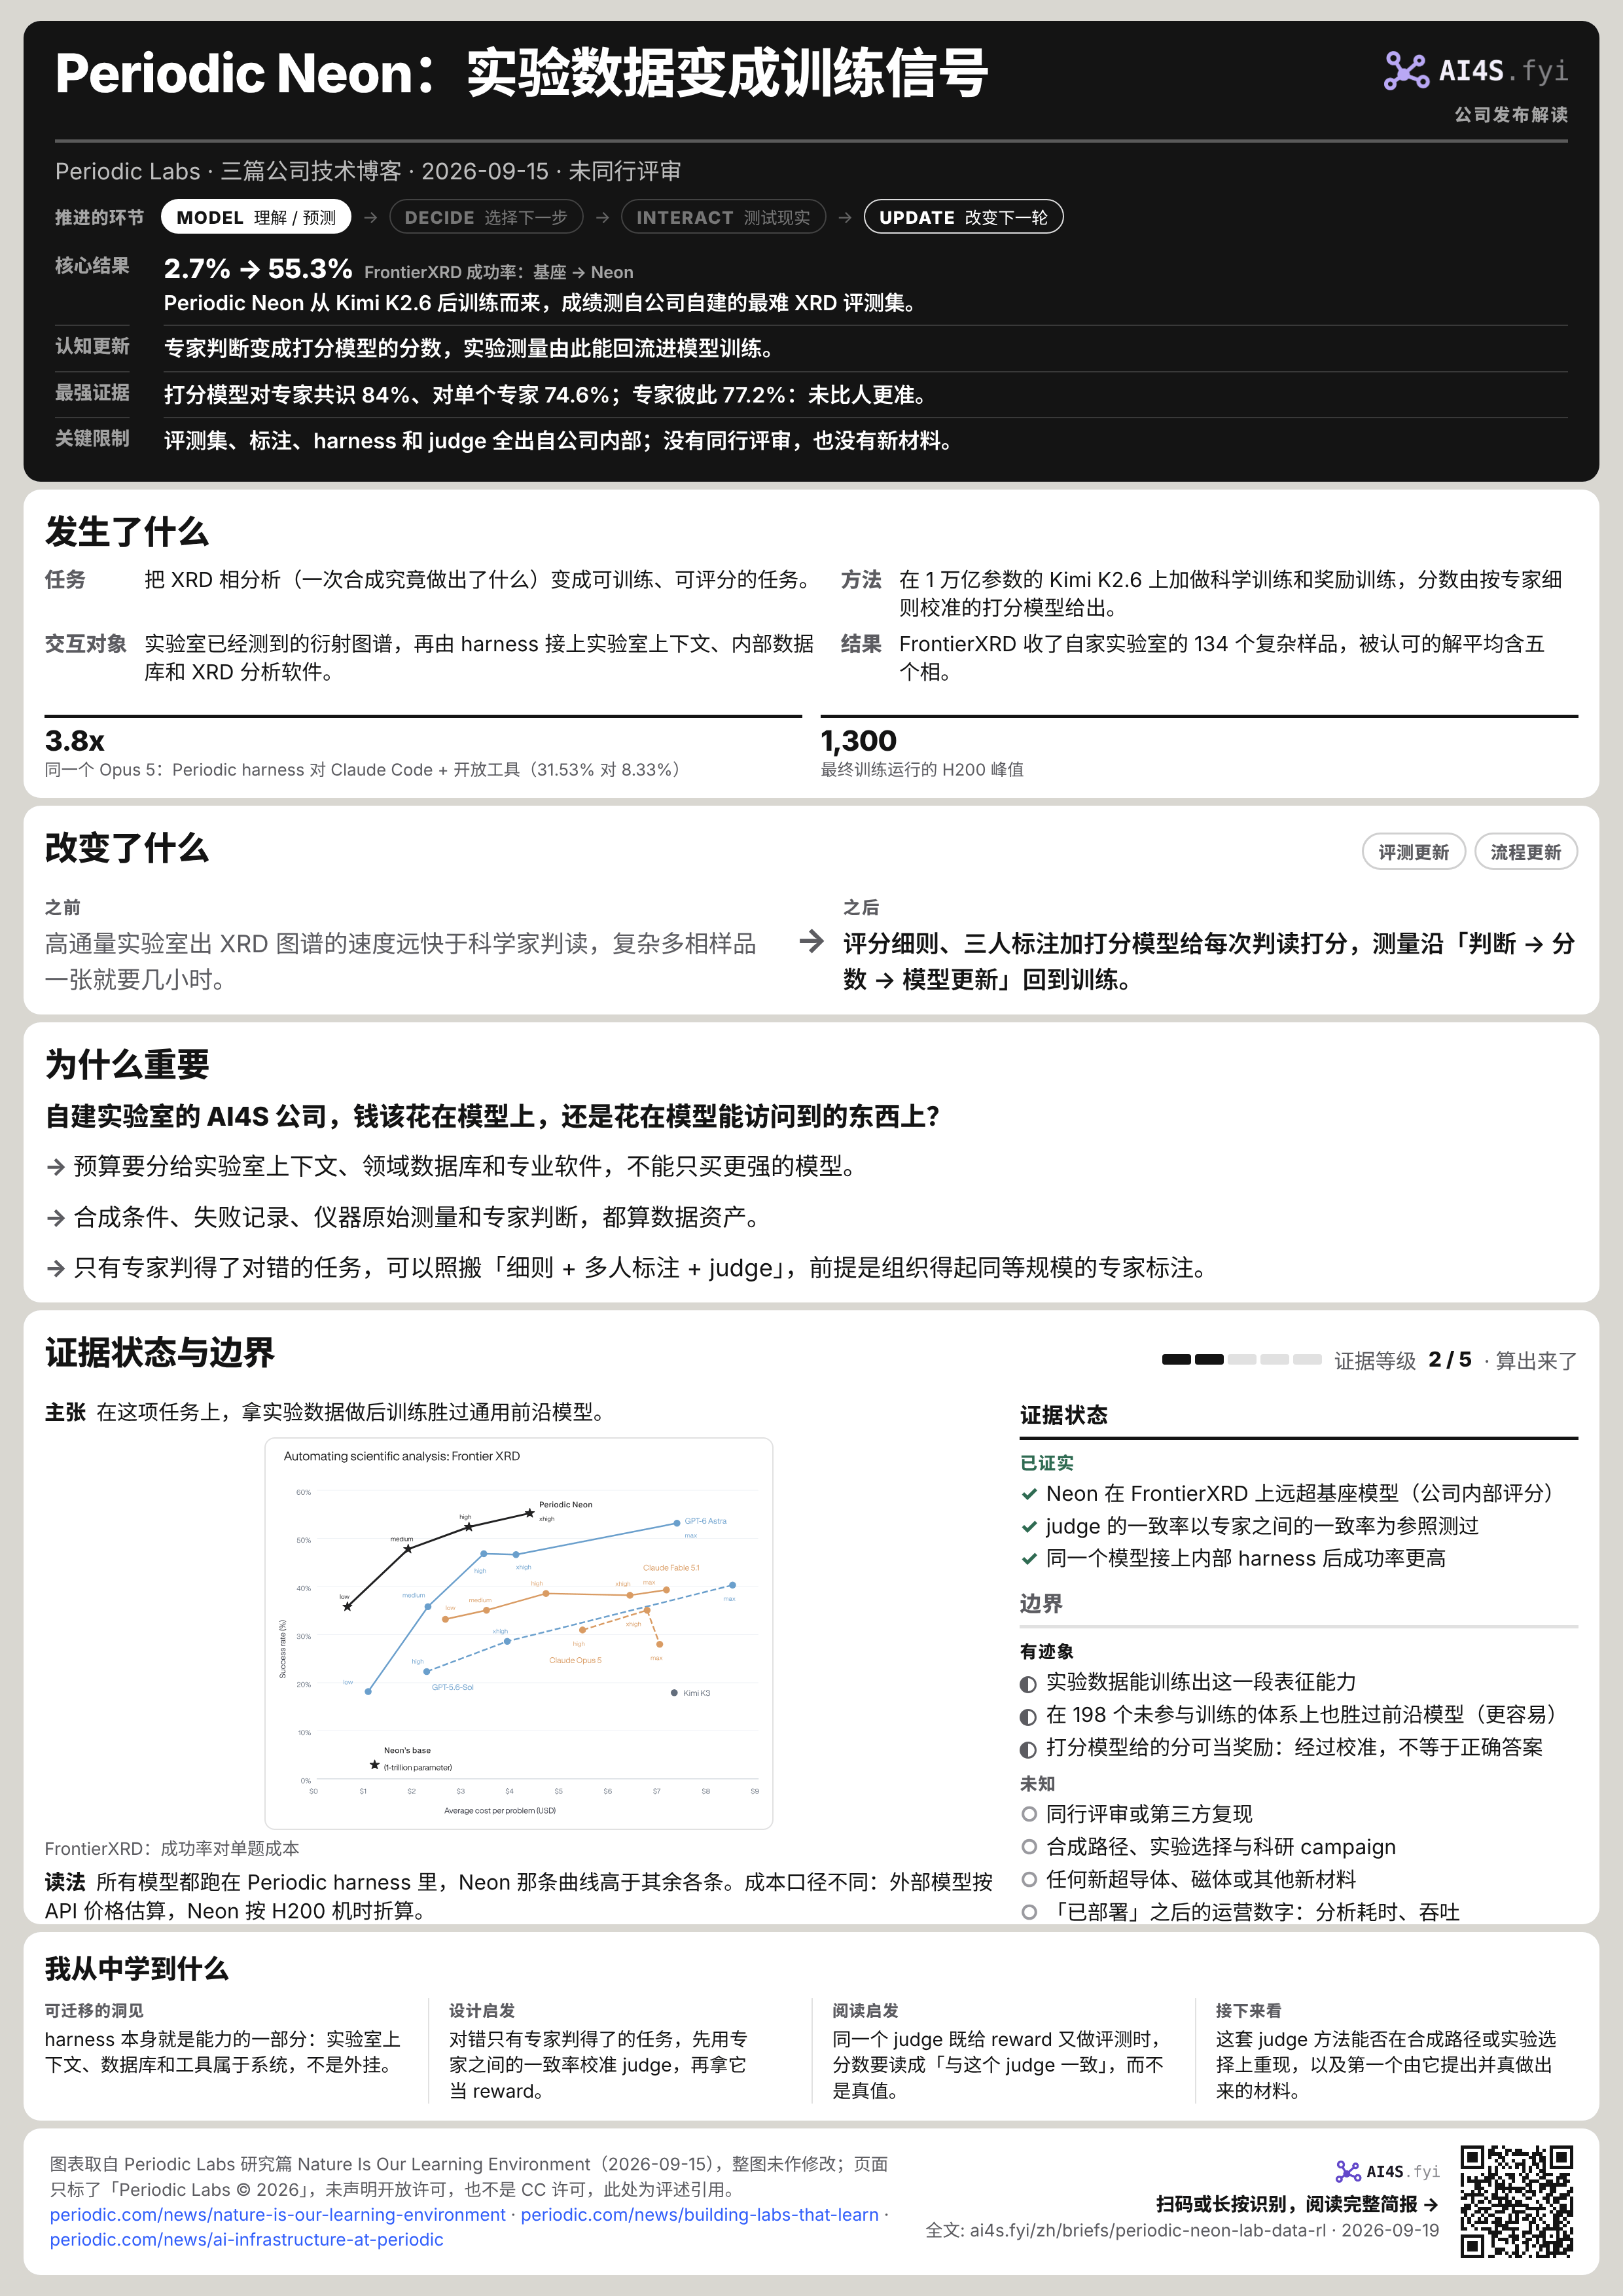
2.7% → 55.3%FrontierXRD 成功率:基座 → Neon
Periodic Neon 从 Kimi K2.6 后训练而来,成绩测自公司自建的最难 XRD 评测集。
- 认知更新
- 专家判断变成打分模型的分数,实验测量由此能回流进模型训练。
- 最强证据
- 打分模型对专家共识 84%、对单个专家 74.6%;专家彼此 77.2%:未比人更准。
- 关键限制
- 评测集、标注、harness 和 judge 全出自公司内部;没有同行评审,也没有新材料。
01发生了什么
- 任务
- 把 XRD 相分析(一次合成究竟做出了什么)变成可训练、可评分的任务。
- 方法
- 在 1 万亿参数的 Kimi K2.6 上加做科学训练和奖励训练,分数由按专家细则校准的打分模型给出。
- 交互对象
- 实验室已经测到的衍射图谱,再由 harness 接上实验室上下文、内部数据库和 XRD 分析软件。
- 结果
- FrontierXRD 收了自家实验室的 134 个复杂样品,被认可的解平均含五个相。
3.8x同一个 Opus 5:Periodic harness 对 Claude Code + 开放工具(31.53% 对 8.33%)
1,300最终训练运行的 H200 峰值
2026 年 9 月 15 日,Periodic Labs 一口气发布三篇文章,分别讲实验室、Neon 模型和背后的 AI 基础设施。三篇放在一起看,公司的路线很清楚:让实验室不断产生数据,再把这些数据送回模型训练。公司成立于 2025 年 9 月,创始人是前 OpenAI 研究副总裁 Liam Fedus,以及曾在 Google Brain 和 DeepMind 负责材料科学的 Ekin Dogus Cubuk,目标是做出更好的超导体和磁体。[S1][S4]
Neon 从 1 万亿参数的开放权重模型 Kimi K2.6 起步,经过 scientific midtraining 和强化学习。在 Periodic 自建的 FrontierXRD 上,成功率从基座模型的 2.7% 提高到 55.3%。这个评测集收了 134 个来自自家实验室的复杂 XRD 样品。[S2]
目前公开得最完整的一项能力,是材料发现流程里的「What was made?」:实验做完之后,判断究竟合成出了什么。[S1]
198
泛化评测所用的留出化学体系图谱数;原文说明这一集合比 FrontierXRD 容易[S2]
1,300
最终一次训练运行的 H200 峰值数量,含 midtraining 和 RL 两个阶段[S2][S3]
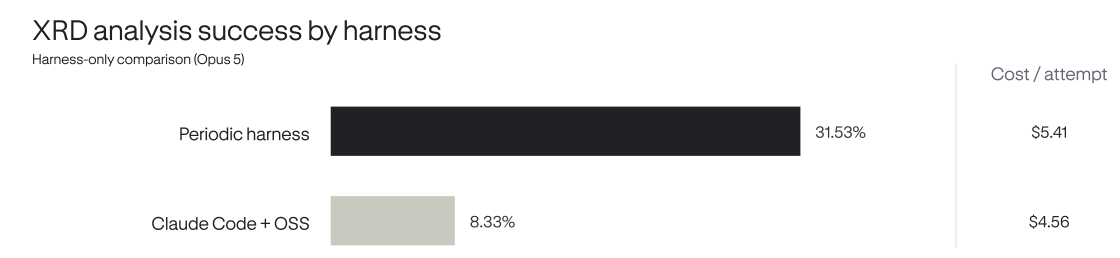
Periodic Labs 研究篇里的 harness 对照图,未经修改。两行跑的是同一个 Claude Opus 5,差别只在它能调用什么。 [S2]
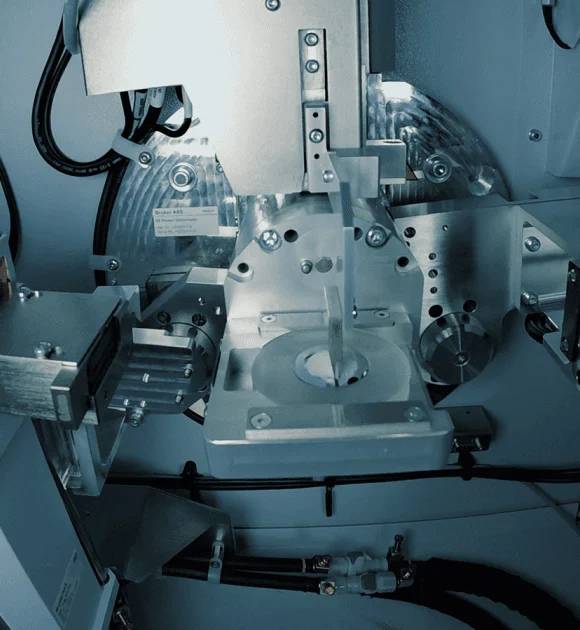
Periodic Labs 研究篇的题图,裁掉标题版面后只留照片。机身标牌可辨认出 Bruker AXS:样品放在中央,探测臂扫过一段弧,记录强度随角度的变化。这篇简报讲的那条曲线,就出自这样一台机器。 [S2]
02改变了什么
评测更新流程更新高通量实验室出 XRD 图谱的速度远快于科学家判读,复杂多相样品一张就要几小时。
评分细则、三人标注加打分模型给每次判读打分,测量沿「判断 → 分数 → 模型更新」回到训练。
测量怎样变成训练信号
XRD 相分析要做的远不止图谱匹配。一次材料合成可能同时得到目标相、未反应的前驱体和副产物,多相样品的衍射峰还彼此重叠;科学家得结合温度、气氛、样品处理历史、结构数据库和相关实验,判断某种解释在化学上讲不讲得通。FrontierXRD 里已有认可解的样品平均含五个相,复杂样品靠人工分析要花上几小时。[S2]
Periodic 把这部分专家判断做成了训练信号。材料相关专业的博士专家先定下评分细则,再为数千条 XRD 分析逐条标注,每条由三位专家标,然后据此搭出 LLM judge。专家之间的一致率是 77.2%,judge 与单个专家为 74.6%,与专家共识为 84%。[S2]
实验数据于是能沿着这样一条路径重新进入模型:实验 → 测量 → 科学判断 → reward → 模型更新。「Nature is our learning environment」这句话到这里才落到工程上:自然界给出测量结果,而从测量结果到能用于训练的 reward,中间还要有实验上下文、专业工具和专家判断。[S1][S2]
为什么先做 XRD
这里还有一个很实际的原因:实验室和 GPU 走的不是同一个时钟。一次真实的材料实验要几小时甚至几天,多做几组并行实验还得添设备、电力和工程人手;GPU 却可以一直消化已经攒下的实验数据。所以 Periodic 先把表征做成可以大规模训练和评估的问题:它既来自物理世界,又已经数字化,评价标准也相对好定。[S1]
按 AI4S.fyi 的框架看,这次最清楚的进展落在 Interact → Update 这一段:实验室做出物理测量,模型开始读得懂这些测量,结果又被送回学习过程。
Periodic Labs 公告篇的题图,裁掉标题版面后只留照片。一个样品容器正被放进支架:正是这类物理动作在给实验室定节拍,炉子和 GPU 也因此快慢对不上。 [S1]
03为什么重要
自建实验室的 AI4S 公司,钱该花在模型上,还是花在模型能访问到的东西上?
- 预算要分给实验室上下文、领域数据库和专业软件,不能只买更强的模型。
- 合成条件、失败记录、仪器原始测量和专家判断,都算数据资产。
- 只有专家判得了对错的任务,可以照搬「细则 + 多人标注 + judge」,前提是组织得起同等规模的专家标注。
接上实验室环境,差 3.8 倍
这次发布里另一个值得记住的数字是 3.8 倍。Periodic 用同一个 Claude Opus 5 做对照:一边配 Claude Code 和 COD、Materials Project、BGMN 等开放工具,另一边用 Periodic 自己的 scientific harness,里面有实验室上下文、内部结构与模拟数据库,还有 XRD 分析软件。成功率分别是 8.33% 和 31.53%,单次成本 4.56 美元和 5.41 美元(相近)。模型一点没变,差别是整套系统配置:实验上下文、数据库和工具,而不是 harness 框架代码本身。[S2]
很多 AI4S 讨论停在「模型够不够强」。这组对照摆出了另一个变量:科学任务上的能力,很大程度上取决于模型能访问到什么。对一家自建实验室的公司来说,数据资产的范围因此比通常理解的宽:不止最终那条 composition → property,合成条件、失败记录、仪器原始测量、样品历史和专家判断,都能进同一套 scientific environment,成为模型可以调用的一部分。[S2]
另一层价值在方法上。很多科学任务都属于「可证伪但不易验证」:对不对要靠专家判断,而不是某个能廉价算出的指标。Periodic 的做法是把评分细则、多人标注和 LLM judge 拼在一起,再拿专家之间的一致率作参照,说明这个 judge 够用。别的领域也可以照搬这套流程,前提是同样组织得起这个规模的专家标注。[S2]
04证据状态与边界
证据等级 2 / 5 · 算出来了 · 回顾性或模拟证据状态
已证实
- Neon 在 FrontierXRD 上远超基座模型(公司内部评分)
- judge 的一致率以专家之间的一致率为参照测过
- 同一个模型接上内部 harness 后成功率更高
边界
有迹象
- 实验数据能训练出这一段表征能力
- 在 198 个未参与训练的体系上也胜过前沿模型(更容易)
- 打分模型给的分可当奖励:经过校准,不等于正确答案
未知
- 同行评审或第三方复现
- 合成路径、实验选择与科研 campaign
- 任何新超导体、磁体或其他新材料
- 「已部署」之后的运营数字:分析耗时、吞吐
主张在这项任务上,拿实验数据做后训练胜过通用前沿模型。
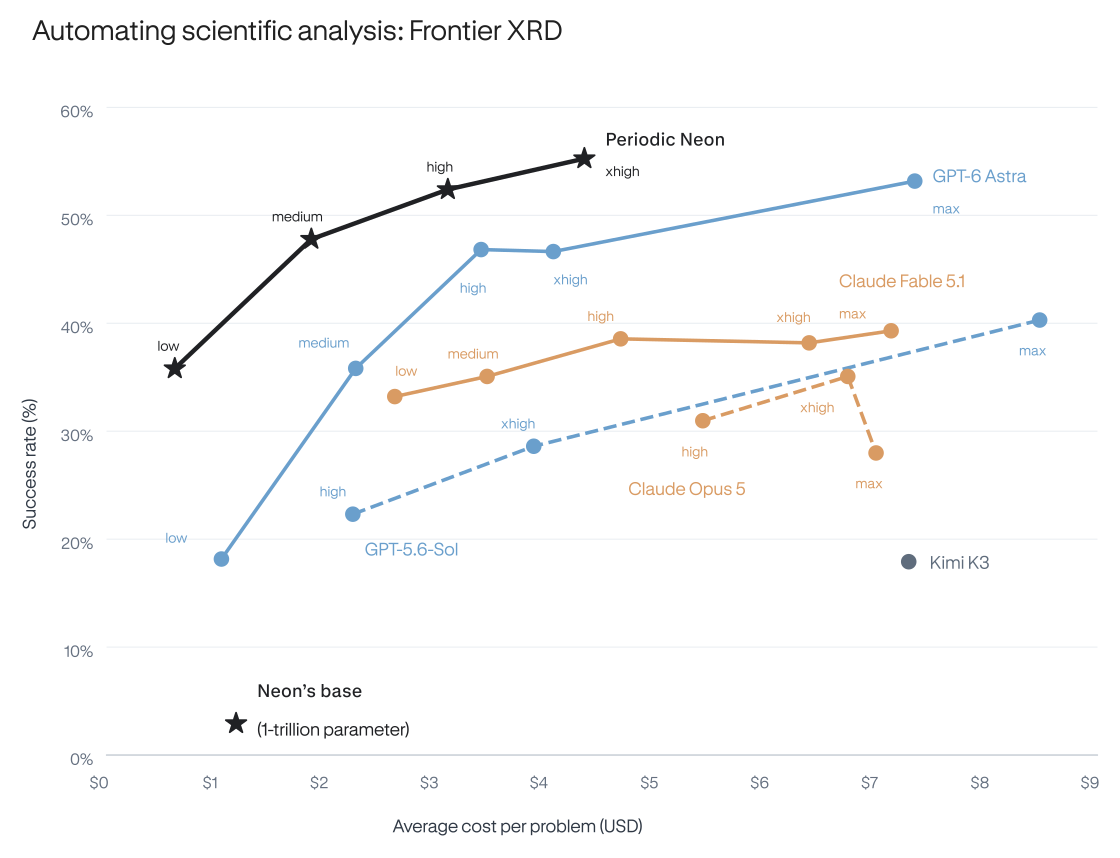
读法所有模型都跑在 Periodic harness 里,Neon 那条曲线高于其余各条。成本口径不同:外部模型按 API 价格估算,Neon 按 H200 机时折算。
评测体系和数据出自同一家公司。
FrontierXRD 是 Periodic 自建的内部基准,含 134 个样本;实验数据、专家标签、scientific harness 和评分体系也都出自这家公司。LLM judge 既给 RL 提供 reward,又参与最终评测,所以它是一套经专家校准的评价工具,还算不上独立的 ground truth。三篇都是技术博客,目前没有同行评审,也没有第三方复现。[S2][S3]
成本这条轴,两边算法不一样。
研究篇注明:外部模型按标准 API 价格估算成本,并假设各轮智能体调用全部命中缓存;Neon 则按系统每 H200 小时的吞吐、每小时 2.5 美元折算。评分用的是 Opus 5 和 GPT-5.6-Sol 组成的 LLM judge 集成。图里所有模型都跑在 Periodic harness 中。[S2]
目前拿出来的只有 XRD 分析这一段。
55.3% 出自最难的那个样本集;泛化测试用的 198 条留出体系,原文说明更容易,两个数字不能混用。这次发布也没有拿出新的超导体、磁体或别的新材料。它证明的是一段分析能力,以及这段能力能靠实验数据训练出来。[S2]
循环的另外三步,还没有同一级别的结果。
Periodic 自己把下一阶段列得很清楚:direct scientific campaigns、develop synthesis procedures、decide which experiments to run。这三步比表征难,难在评价标准:合成和实验选择没有同样明确的判据,留出集也更难构造。[S1]
05我从中学到什么
- 可迁移的洞见
- harness 本身就是能力的一部分:实验室上下文、数据库和工具属于系统,不是外挂。
- 设计启发
- 对错只有专家判得了的任务,先用专家之间的一致率校准 judge,再拿它当 reward。
- 阅读启发
- 同一个 judge 既给 reward 又做评测时,分数要读成「与这个 judge 一致」,而不是真值。
- 接下来看
- 这套 judge 方法能否在合成路径或实验选择上重现,以及第一个由它提出并真做出来的材料。
Neon 能不能从解释上一轮实验,走到挑选下一轮实验。
这是同一条循环里性质不同的两步。解释已有测量,对错相对明确;挑下一个实验,则要在候选远多于预算时作判断,选得好不好往往要等几轮之后才看得出。同一套 judge 方法要是能在合成路径或实验选择上重现,这条路线才算真正闭合。
反馈循环收紧,能不能少做实验、少花时间。
这是这条路线最终要回答的问题,也是短期内最难看到答案的。可以先盯几个中间信号:科学家的分析时间压缩了多少、实验室的有效吞吐提高了多少,以及第一个由这套系统提出并真做出来的材料。
长图版本方便保存转发→资料来源
本文依据 Periodic Labs 2026 年 9 月 15 日发布的三篇原文,本次核查中逐段读过;公司背景和融资另引成立公告与外部报道。文中提到的上游开源 PR 这次没有打开确认。