

公司发布解读· 科学证据 · Frontier
Claude 让生物分子模型更快、更省显存:不只使用科学工具,也优化工具本身
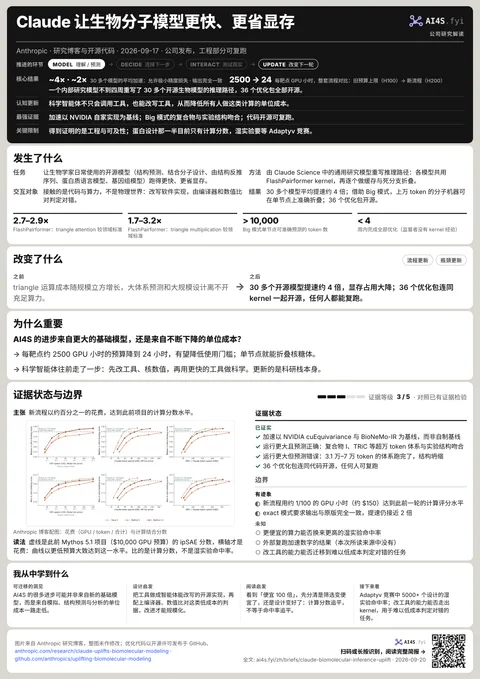
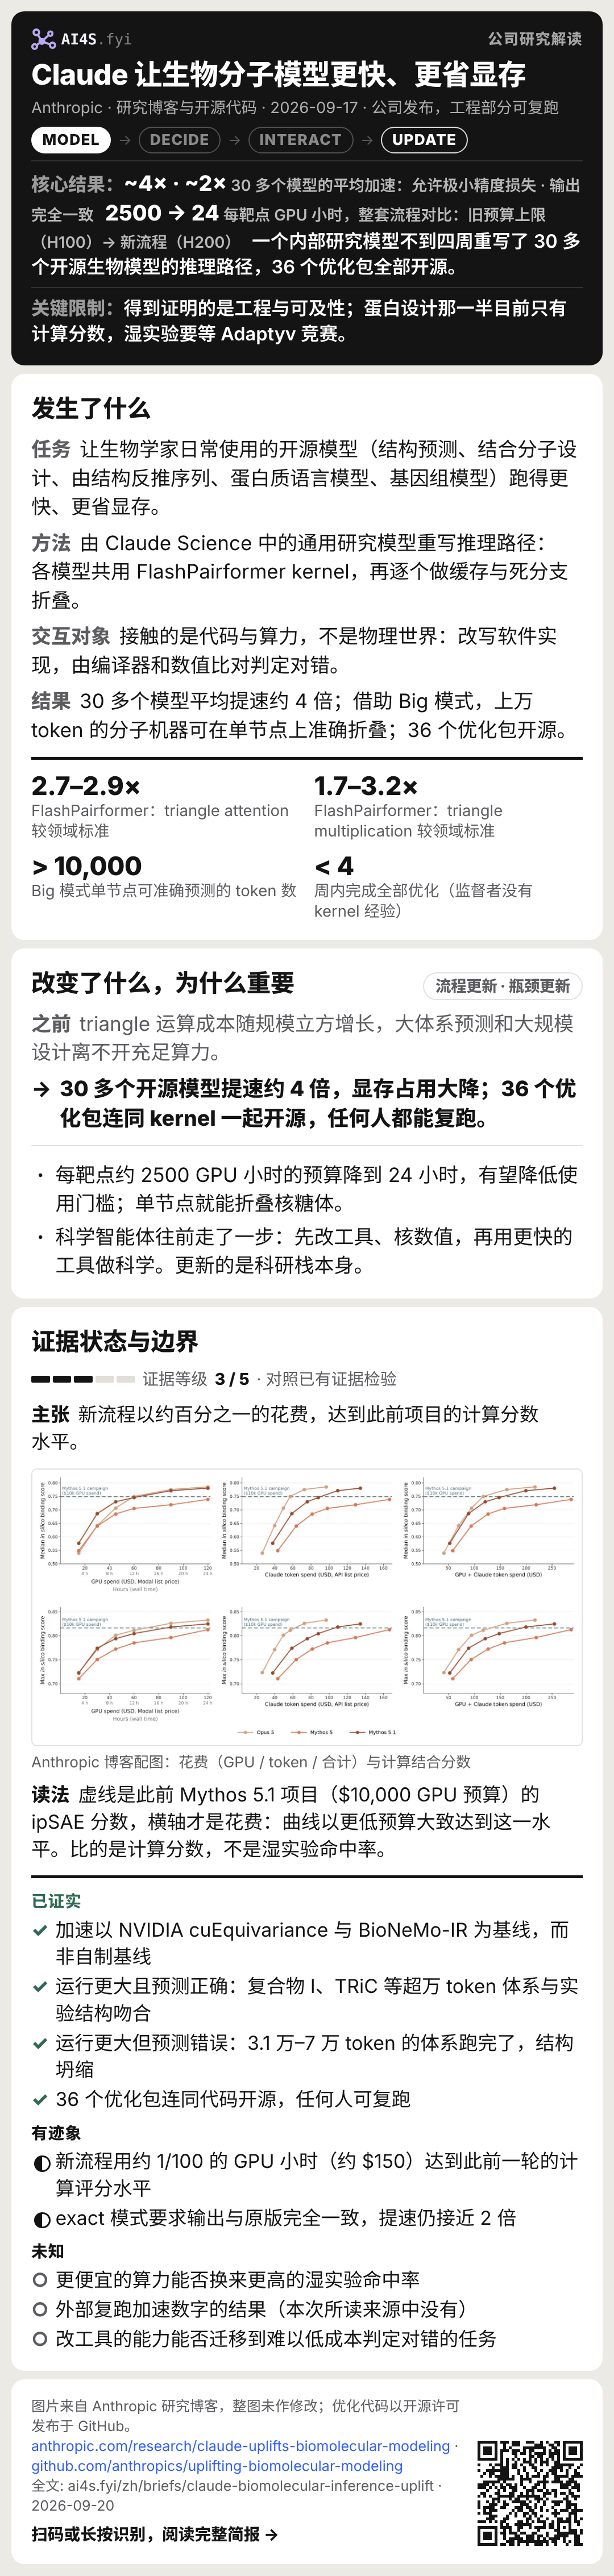
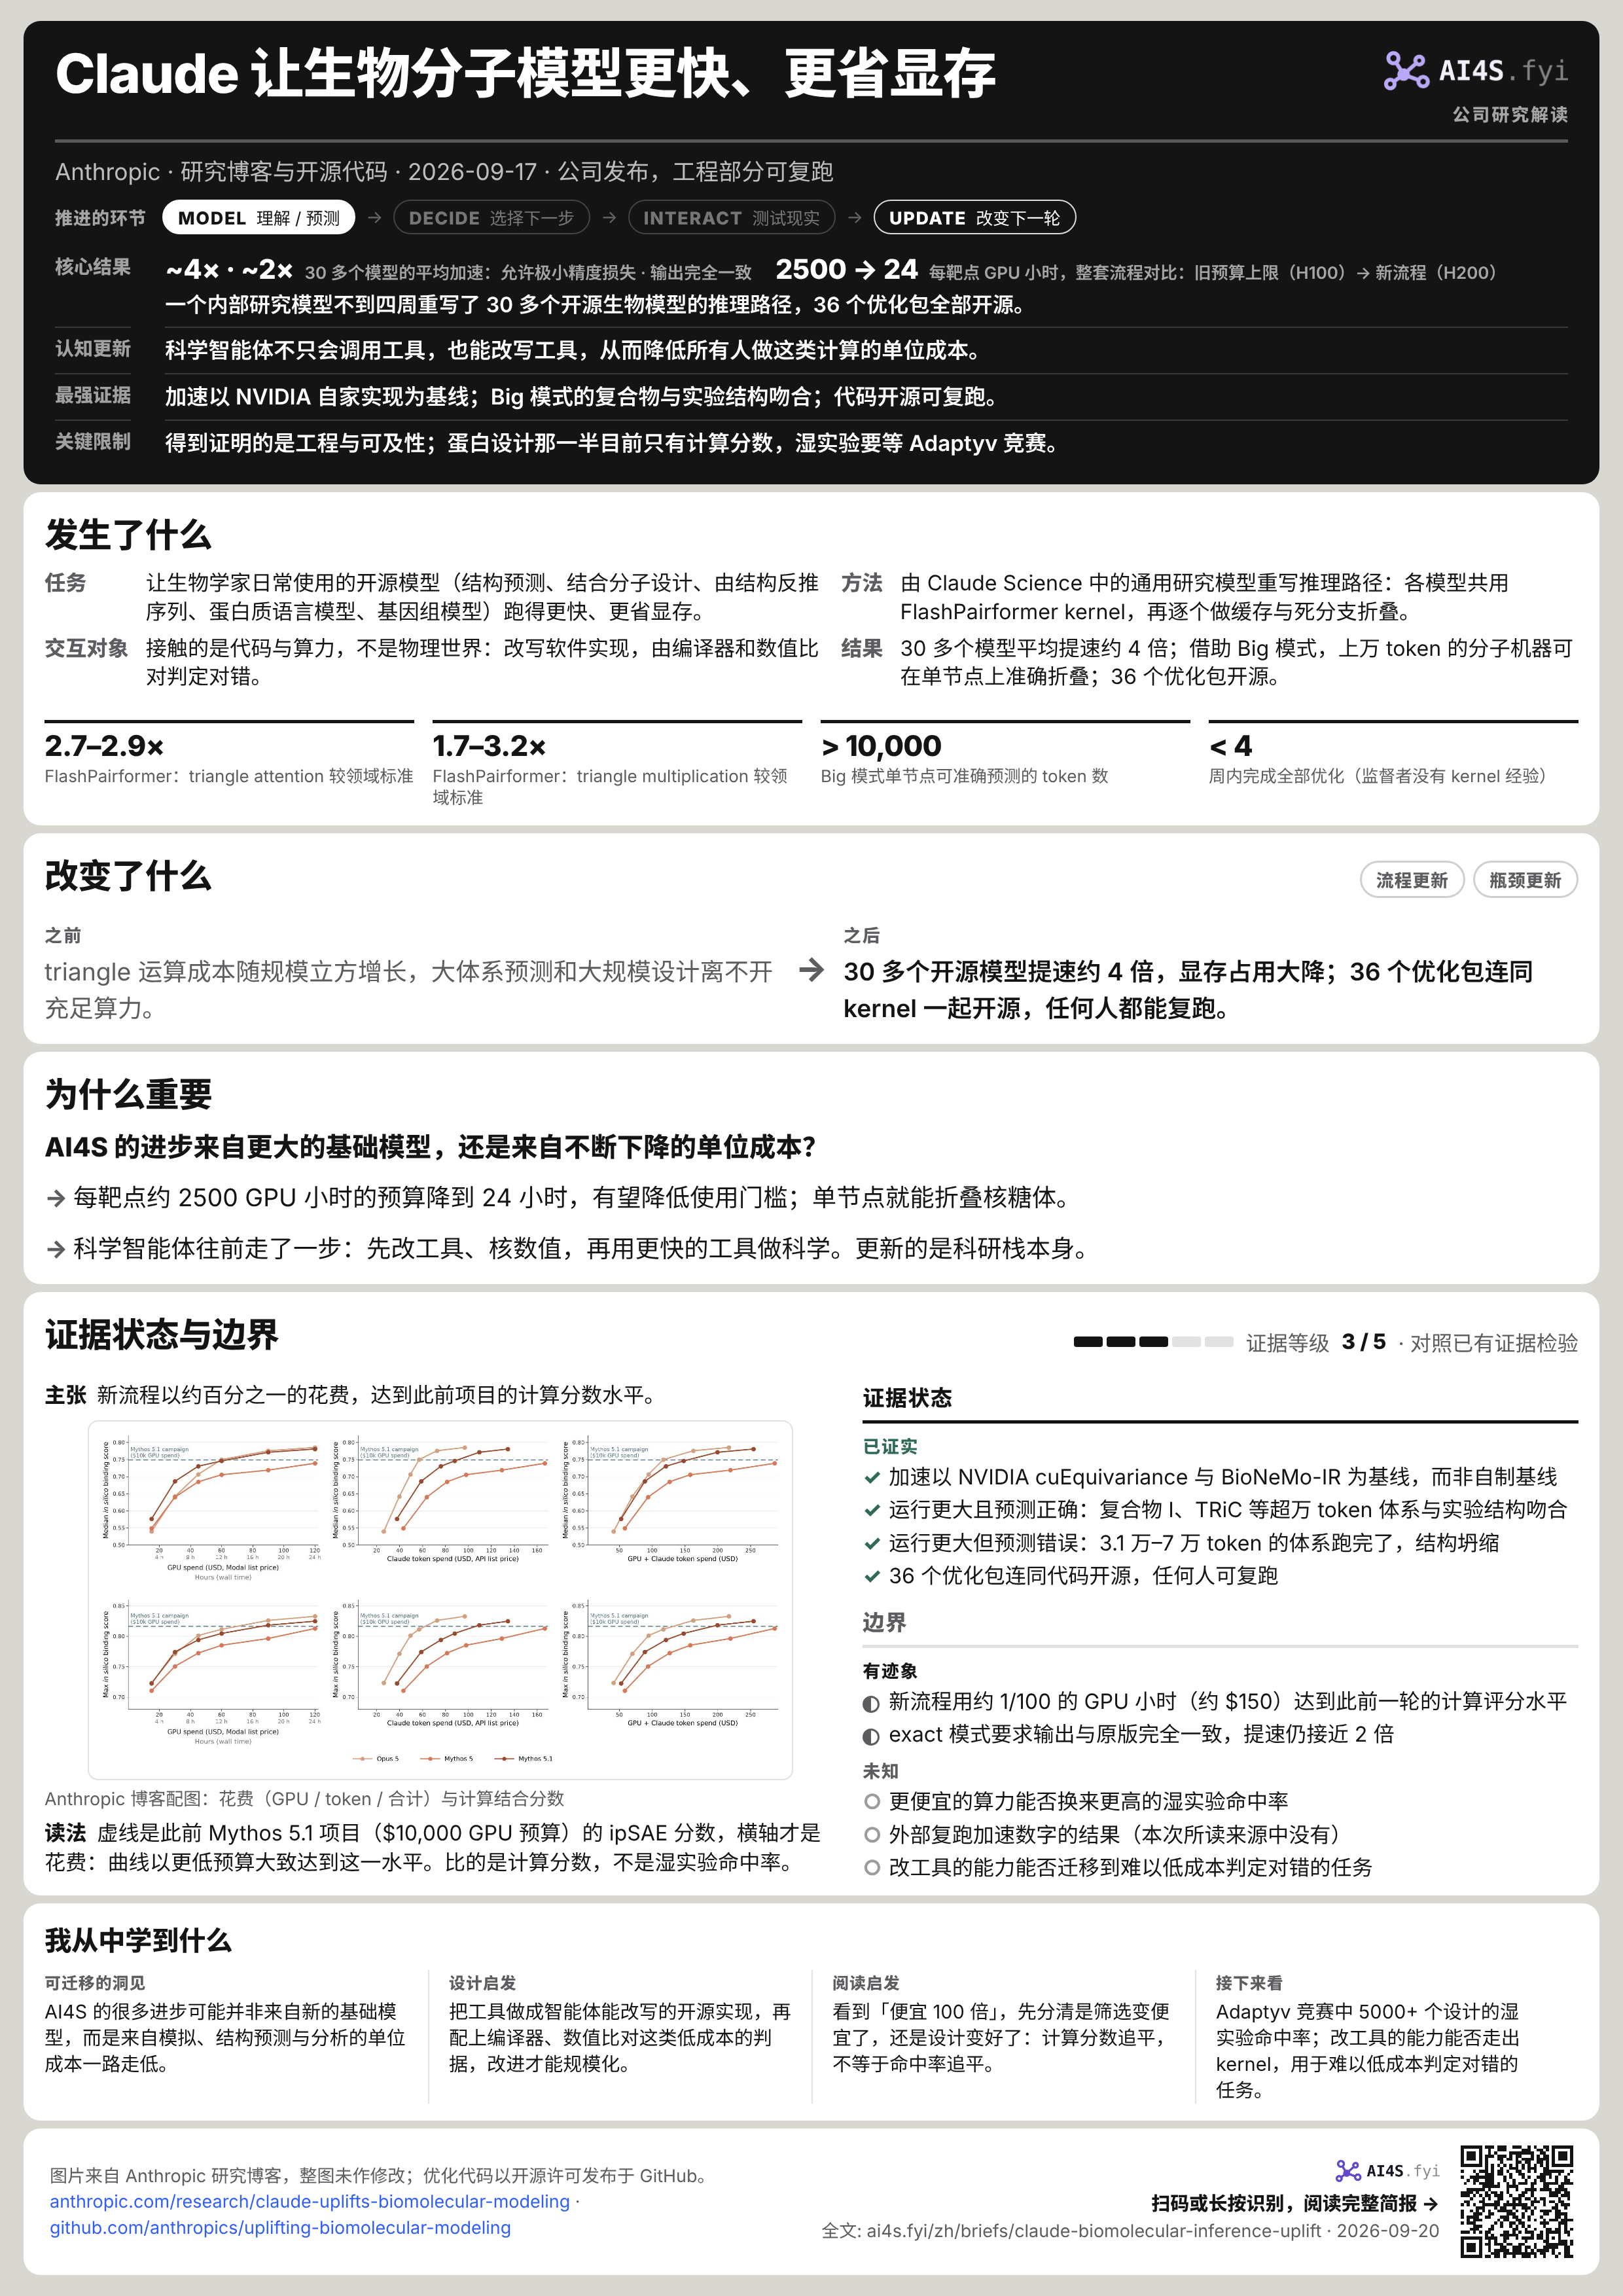
Anthropic 的一个内部研究模型用不到四周,重写了 30 多个开源生物模型的推理路径,平均提速约 4 倍,36 个优化包全部开源。改变的不是哪个模型的能力,而是所有人做这类计算的单位成本。
◐公司技术报告 + 开源代码 + 公开基线
当前边界:证明了的是工程与可及性;湿实验那一半要等 Adaptyv 竞赛
这项工作推进的是:让智能体改写科学软件的实现,把结构预测与蛋白设计的单位成本压下来
- MODEL理解 / 预测
- DECIDE选择下一步
- INTERACT测试现实
- UPDATE改变下一轮
~4× · ~2×30 多个模型的平均加速:允许极小精度损失 · 输出完全一致
2500 → 24每靶点 GPU 小时,整套流程对比:旧预算上限(H100)→ 新流程(H200)
一个内部研究模型不到四周重写了 30 多个开源生物模型的推理路径,36 个优化包全部开源。
- 认知更新
- 科学智能体不只会调用工具,也能改写工具,从而降低所有人做这类计算的单位成本。
- 最强证据
- 加速以 NVIDIA 自家实现为基线;Big 模式的复合物与实验结构吻合;代码开源可复跑。
- 关键限制
- 得到证明的是工程与可及性;蛋白设计那一半目前只有计算分数,湿实验要等 Adaptyv 竞赛。
01发生了什么
- 任务
- 让生物学家日常使用的开源模型(结构预测、结合分子设计、由结构反推序列、蛋白质语言模型、基因组模型)跑得更快、更省显存。
- 方法
- 由 Claude Science 中的通用研究模型重写推理路径:各模型共用 FlashPairformer kernel,再逐个做缓存与死分支折叠。
- 交互对象
- 接触的是代码与算力,不是物理世界:改写软件实现,由编译器和数值比对判定对错。
- 结果
- 30 多个模型平均提速约 4 倍;借助 Big 模式,上万 token 的分子机器可在单节点上准确折叠;36 个优化包开源。
2.7–2.9×FlashPairformer:triangle attention 较领域标准
1.7–3.2×FlashPairformer:triangle multiplication 较领域标准
> 10,000Big 模式单节点可准确预测的 token 数
< 4周内完成全部优化(监督者没有 kernel 经验)
2026 年 9 月 17 日,Anthropic 发布研究文章《How Claude is uplifting biomolecular modeling》,讲的是一项工程工作:Anthropic 让 Claude Science 中的一个内部通用研究模型,去优化生物学家日常使用的开源模型的推理路径,涉及结构预测与共折叠(cofolding)、binder 设计、反向折叠、蛋白质语言模型和基因组模型。它在不到四周内处理了 30 多个模型,平均提速约 4 倍;若要求输出与原实现完全一致,提速接近 2 倍。[S1]
有两点值得先记下。一是谁在监督:负责监督的是 Anthropic 的两名技术人员,他们熟悉生物分子建模,但此前从没做过推理优化或 kernel 工程。二是交付形式:成果不是一篇论文加一个演示,而是 36 个可直接替换使用的优化包,每个上游工具对应一个,发布在 GitHub 上。每个包提供三种模式:exact(输出与原版一致)、fast(数值差异极小,通常为默认)和 big(面向大输入,峰值显存最低)。[S1][S2]
Anthropic 还宣布与 Adaptyv Bio 联合举办一场蛋白设计竞赛,设五个前沿题目:物种交叉反应性、pH 敏感性、肽-MHC 特异性,以及 GPCR 等难靶点。主办方承诺对社区提交的 5000 多个设计做湿实验验证,并提供最高 100 万美元的 Claude 额度和 25 万美元的 Modal 算力,DNA 由 Twist Bioscience 提供。[S1]
02改变了什么
流程更新瓶颈更新triangle 运算成本随规模立方增长,大体系预测和大规模设计离不开充足算力。
30 多个开源模型提速约 4 倍,显存占用大降;36 个优化包连同 kernel 一起开源,任何人都能复跑。
瓶颈卡在 triangle 运算上
在 AlphaFold3、OpenFold3、Boltz-2 这类结构模型里,运行时间和显存的大头都耗在两个操作上:triangle attention 和 triangle multiplication。它们在 token 三元组上运算,模型靠它们表达几何关系;代价是时间和显存都随体系规模立方增长。体系扩大一倍,开销变为八倍;扩大到三倍,开销变为二十七倍。[S1]
压低这类开销的标准做法是写专用 kernel,NVIDIA 的 cuEquivariance 和后来的 BioNeMo Inference Runtime 正是为此开发的。FlashPairformer 是借助 Claude 开发的一组定制 kernel,专门针对这两个运算:与这一领域标准相比,triangle attention 快 2.7–2.9 倍,triangle multiplication 快 1.7–3.2 倍,视模型配置而定。在这层通用 kernel 之上,团队又让 Claude 逐个模型做针对性优化,比如缓存重复计算、把永远走不到的分支直接折叠成常量输出。两层叠加,结构预测模型平均提速约 4 倍。[S1]
第二项工作针对显存。Claude 开发的低显存 Big 模式,使超过 10000 token 的体系能在单个 GPU 节点上准确预测。用它折叠出的分子机器有人线粒体复合物 I、TRiC 伴侣蛋白复合物、蛋白酶体和一个细菌核糖体,结果都与实验测定的结构十分接近。作为对比,AlphaFold3 此前准确预测过的 40S 核糖体为 7663 个 token。[S1]
分数不变,算力只要百分之一
这批优化最直观的效果,要拿 Anthropic 此前自己做的 binder 设计来对比。那一次,Claude 拿到约 16000 词的提示,可以派生子智能体,每个靶点在 Modal 上最多可花 10000 美元(约合 2500 个 H100 GPU 小时),限时 24 小时。注意 2500 小时是预算上限,不是实际用量。[S1]
这一次条件收紧得多:单个 Claude 模型、1 张 H200、24 小时墙钟时间、约 1100 词的提示外加一份预装工具说明,不用子智能体,设计过程中也没有人工干预。三个模型(Mythos 5.1、Mythos 5、Opus 5)在 16 个靶点上运行,以 ipSAE 打分;这一计算指标已被证明能预测湿实验中的结合。结果:在 16 个靶点上取平均,中位数设计和最高分设计的 ipSAE 与此前那轮设计大致相当,GPU 小时却少了约两个数量级,GPU 与 token 成本合计约 150 美元。这是两套流程的整体比较:硬件(H100 换成 H200)、提示词、智能体组织(不再派生子智能体)和设计流程都变了,Anthropic 自己也说结果来自加速后的模型加上对此前设计方法的简化。因此它不能读作同一配置下 kernel 快了约 100 倍;kernel 与逐模型优化本身的加速,是前面那个平均约 4 倍(输出完全一致时近 2 倍)。[S1]
这句话的范围要看清:追平的是计算分数,不是湿实验命中率。ipSAE 与实验结合相关,但相关不等于等同,而且这次没有新的实验数据。[S1]
03为什么重要
AI4S 的进步来自更大的基础模型,还是来自不断下降的单位成本?
- 每靶点约 2500 GPU 小时的预算降到 24 小时,有望降低使用门槛;单节点就能折叠核糖体。
- 科学智能体往前走了一步:先改工具、核数值,再用更快的工具做科学。更新的是科研栈本身。
在这件事里,科学智能体的角色往前走了一步。此前的演示大多是模型读文献、挑候选、调用工具、解读结果,工具本身是现成的。这次的顺序换了:先找出工具的瓶颈,改写底层实现,确认数值行为没变,再用提速后的工具做科学。按本站的框架,这也算一种 Update,只是更新的对象不是假设或世界模型,而是科研栈本身。[S1]
单位成本是 AI4S 里讨论得太少的一个变量。一套 binder 设计流程,每个靶点从约 2500 个 GPU 小时的预算上限降到 24 小时(这是整套流程的比较,不只是 kernel 的功劳),有望降低这类计算的使用门槛;至于有多少实验室因此做得起,目前没有使用调查。单个节点就能折叠核糖体,结构生物学里的一类问题便不必再依赖多节点集群。如果这类优化持续下去,很多进步未必来自新的基础模型,而可能来自模拟、结构预测、分析与实验规划的单位成本一路走低。[S1]
还有一点让它有别于多数实验室的宣称:成果是开源的。36 个优化包连同代码一起公开,基线用的是 NVIDIA 自家的实现,任何人都能在自己的机器上复现这些加速数字。主张和核查手段一同发布,这在近来的公司发布里并不多见。[S1][S2]
04证据状态与边界
证据等级 3 / 5 · 对照已有证据检验 · 回顾性或模拟证据状态
已证实
- 加速以 NVIDIA cuEquivariance 与 BioNeMo-IR 为基线,而非自制基线
- 运行更大且预测正确:复合物 I、TRiC 等超万 token 体系与实验结构吻合
- 运行更大但预测错误:3.1 万–7 万 token 的体系跑完了,结构坍缩
- 36 个优化包连同代码开源,任何人可复跑
边界
有迹象
- 新流程用约 1/100 的 GPU 小时(约 $150)达到此前一轮的计算评分水平
- exact 模式要求输出与原版完全一致,提速仍接近 2 倍
未知
- 更便宜的算力能否换来更高的湿实验命中率
- 外部复跑加速数字的结果(本次所读来源中没有)
- 改工具的能力能否迁移到难以低成本判定对错的任务
主张新流程以约百分之一的花费,达到此前项目的计算分数水平。
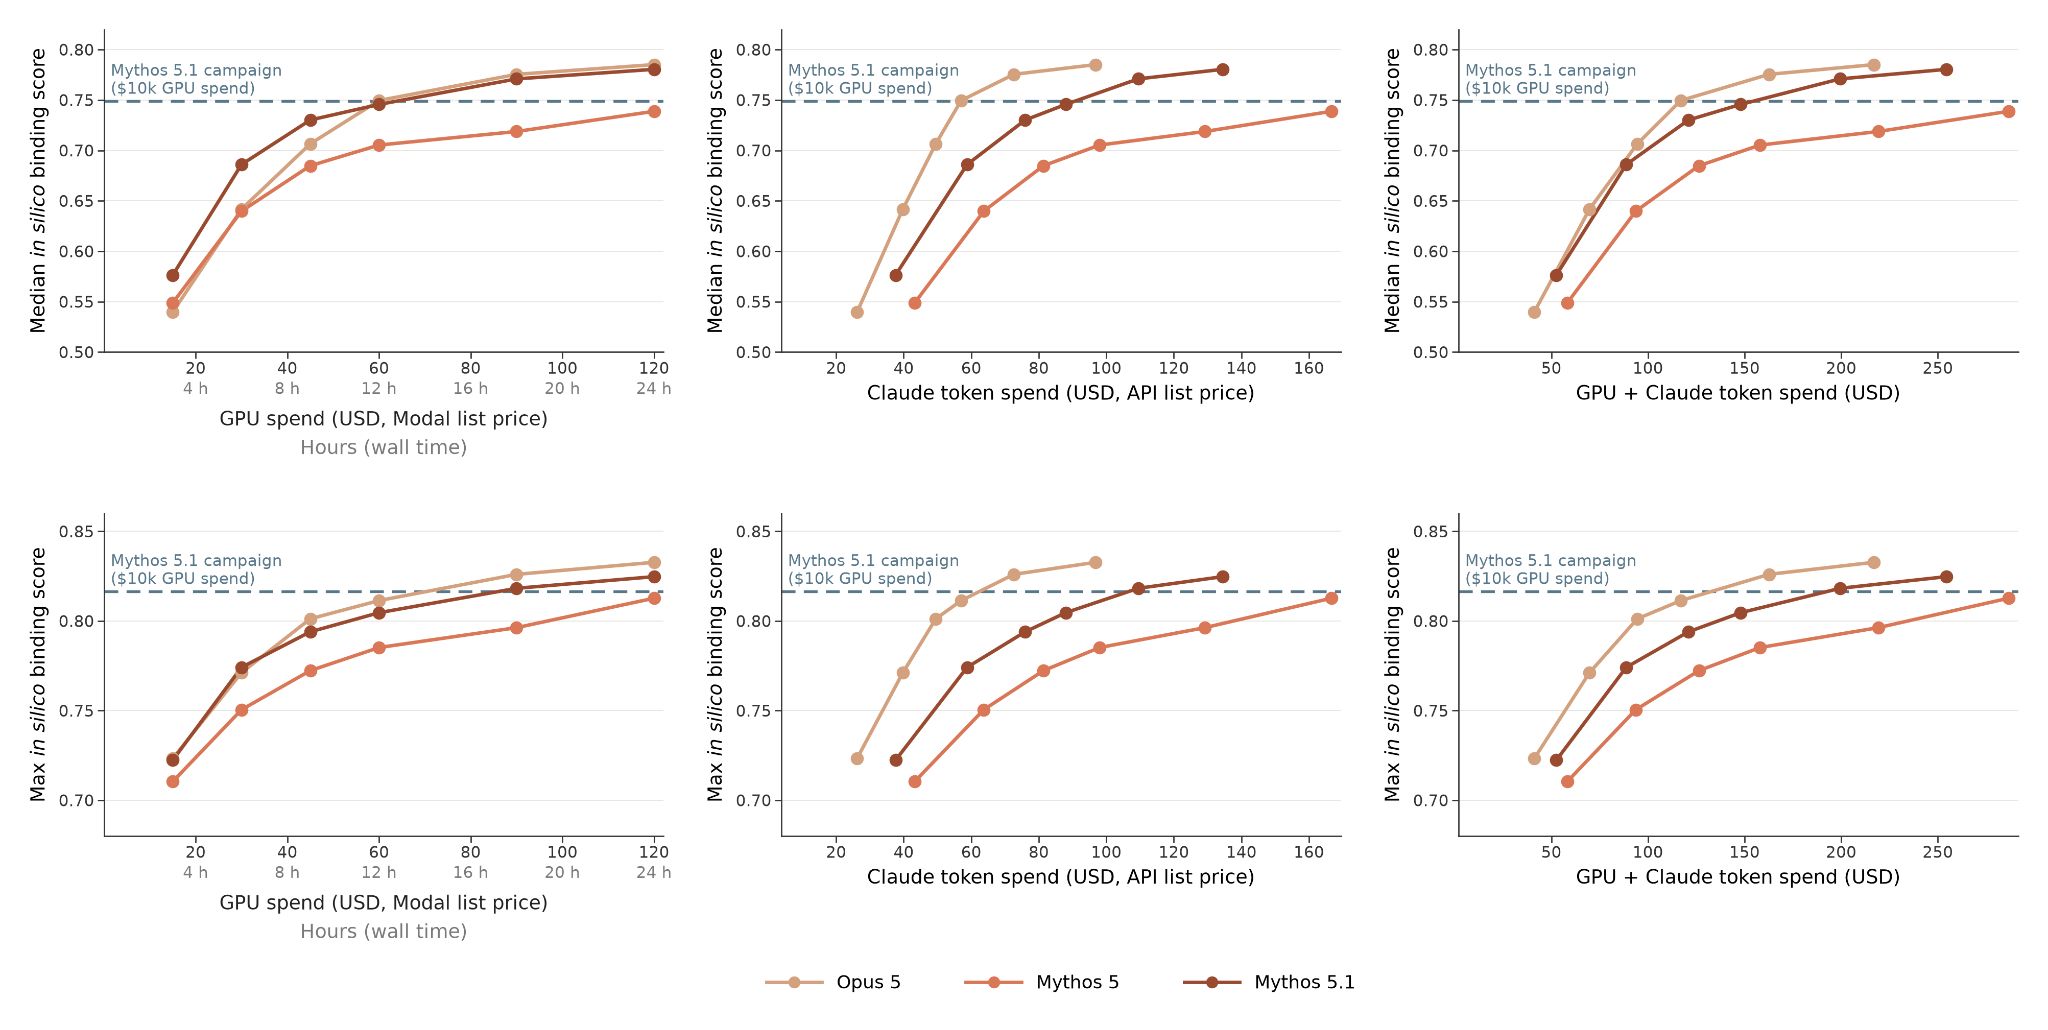
读法虚线是此前 Mythos 5.1 项目($10,000 GPU 预算)的 ipSAE 分数,横轴才是花费:曲线以更低预算大致达到这一水平。比的是计算分数,不是湿实验命中率。
工程数字这一半可以核查。
加速的基线是 NVIDIA 的 cuEquivariance 和 BioNeMo-IR,而不是自制基线;Big 模式折叠出的复合物 I、TRiC、蛋白酶体和核糖体,都与实验测定的结构做了比对;代码开源。这部分外界可以自行验证,在公司发布里属于少数。[S1][S2]
更大的体系跑得完,但算不对。
对 31,000 到 70,000 token 的病毒衣壳和蛋白质区室,推理能在单个 8 卡 B300 节点上跑完,但预测结构坍缩了。Anthropic 对此说得很明白:这些体系比模型的训练上下文大了近两个数量级,推远的是显存墙,而不是模型的泛化能力。[S1]
蛋白设计的结论,目前只有计算分数支撑。
用约百分之一的 GPU 小时达到此前的 ipSAE 参考水平,这是关于整套流程成本的结论,不是关于命中率的结论。Adaptyv 竞赛承诺对 5000 多个设计做湿实验验证;等这批数据出来,这条成本链才算接上物理世界的反馈。[S1]
kernel 优化这类任务,判定对错的成本很低。
这项工作四周就能完成,部分原因在于任务本身定义清楚:输出对不对,有编译器和数值比对来判;快不快,有基准可测。科学中的多数问题没有这样的判据,所以从“智能体能改工具”,还推不出“智能体能改科学”。
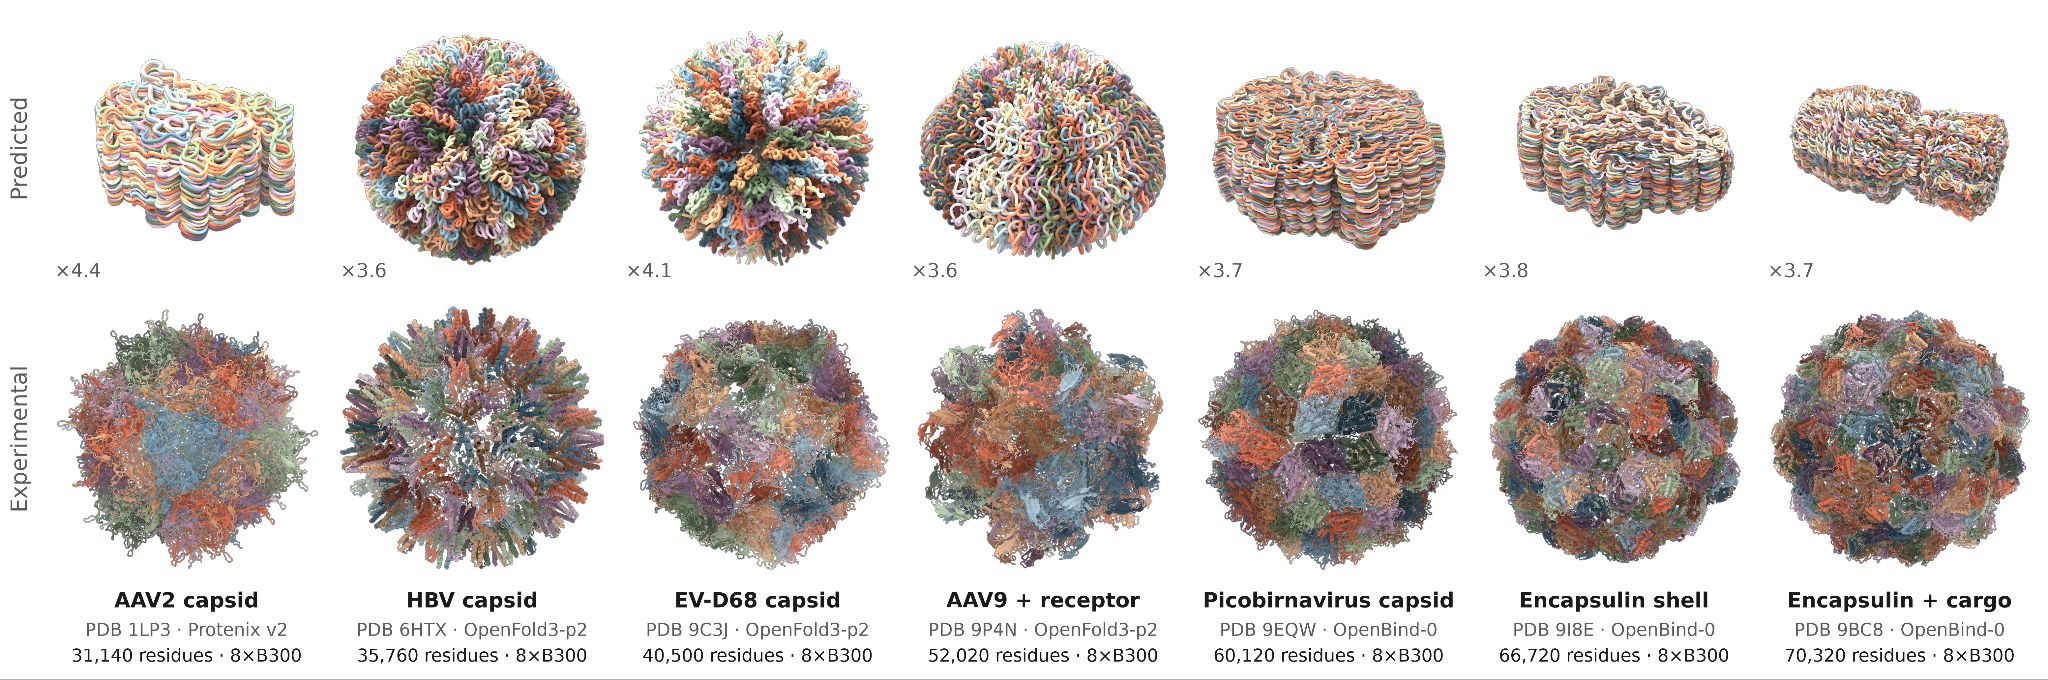
Anthropic 研究文章配图,未经修改。图中展示的是边界:在单个 8 卡 B300 节点上,31,140 到 70,320 个残基的病毒衣壳和蛋白质区室都能跑完推理(上排为预测结构,下排为实验结构),但预测明显坍缩。显存墙推远了,模型本身却没有泛化到这个尺度。 [S1]
05我从中学到什么
- 可迁移的洞见
- AI4S 的很多进步可能并非来自新的基础模型,而是来自模拟、结构预测与分析的单位成本一路走低。
- 设计启发
- 把工具做成智能体能改写的开源实现,再配上编译器、数值比对这类低成本的判据,改进才能规模化。
- 阅读启发
- 看到「便宜 100 倍」,先分清是筛选变便宜了,还是设计变好了:计算分数追平,不等于命中率追平。
- 接下来看
- Adaptyv 竞赛中 5000+ 个设计的湿实验命中率;改工具的能力能否走出 kernel,用于难以低成本判定对错的任务。
Adaptyv 竞赛的命中率数据。
5000 多个社区设计的湿实验结果,将是第一批把“算力更便宜”和“发现更多”联系起来的真实数据。如果参赛者的算力预算缩小,命中率却不降,这条链就成立;否则,说明变便宜的只是筛选,而不是设计质量。
这种能力能否走出 kernel。
下一步值得关注的,是把同样的做法用到验证成本更高的地方:实验规划、数据处理流程、模拟参数选择。这些环节没有编译器来判对错,恰好能检验“智能体改工具”究竟是一项通用能力,还是只碰巧适合一类定义清楚的任务。
长图版本方便保存转发→资料来源
本文依据 Anthropic 2026 年 9 月 17 日的研究文章,本次核查通读了原文;36 个优化包的数量和三种模式取自其 GitHub 仓库的 README。图片为原文配图,未经修改。技术报告本身这次没有逐页读完。