

技术报告解读· 科学证据 · Frontier
AnewDDE:一次对话,编排两轮抗体设计与实验
刚从字节跳动分拆出来的 Anew Labs,把结构预测、生成设计、亲和力预测和科研推理接成一条闭环。在首个公开案例中,150 个纳米抗体克隆里有 16 个做到了个位数纳摩尔。
◐技术报告 + 内部基准 + SPR 实测
当前边界:做出来并测到的是结合力,功能活性与可开发性还在后面
这项工作推进的是:把结构预测、生成设计、亲和力预测与实验反馈接成一条由智能体调度的抗体设计循环
- MODEL理解 / 预测
- DECIDE选择下一步
- INTERACT测试现实
- UPDATE改变下一轮
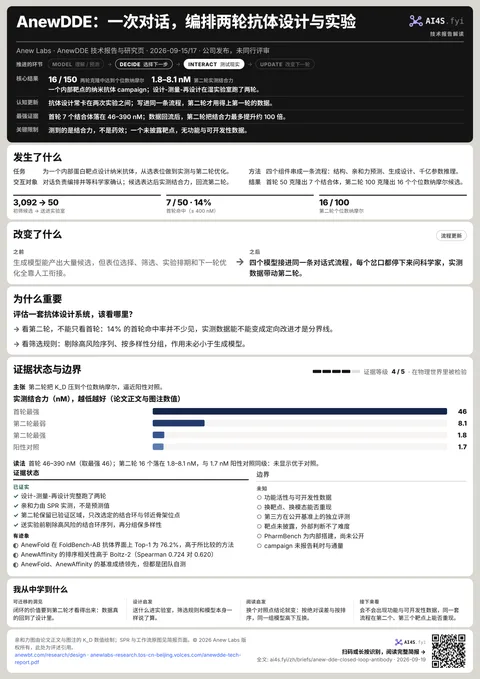
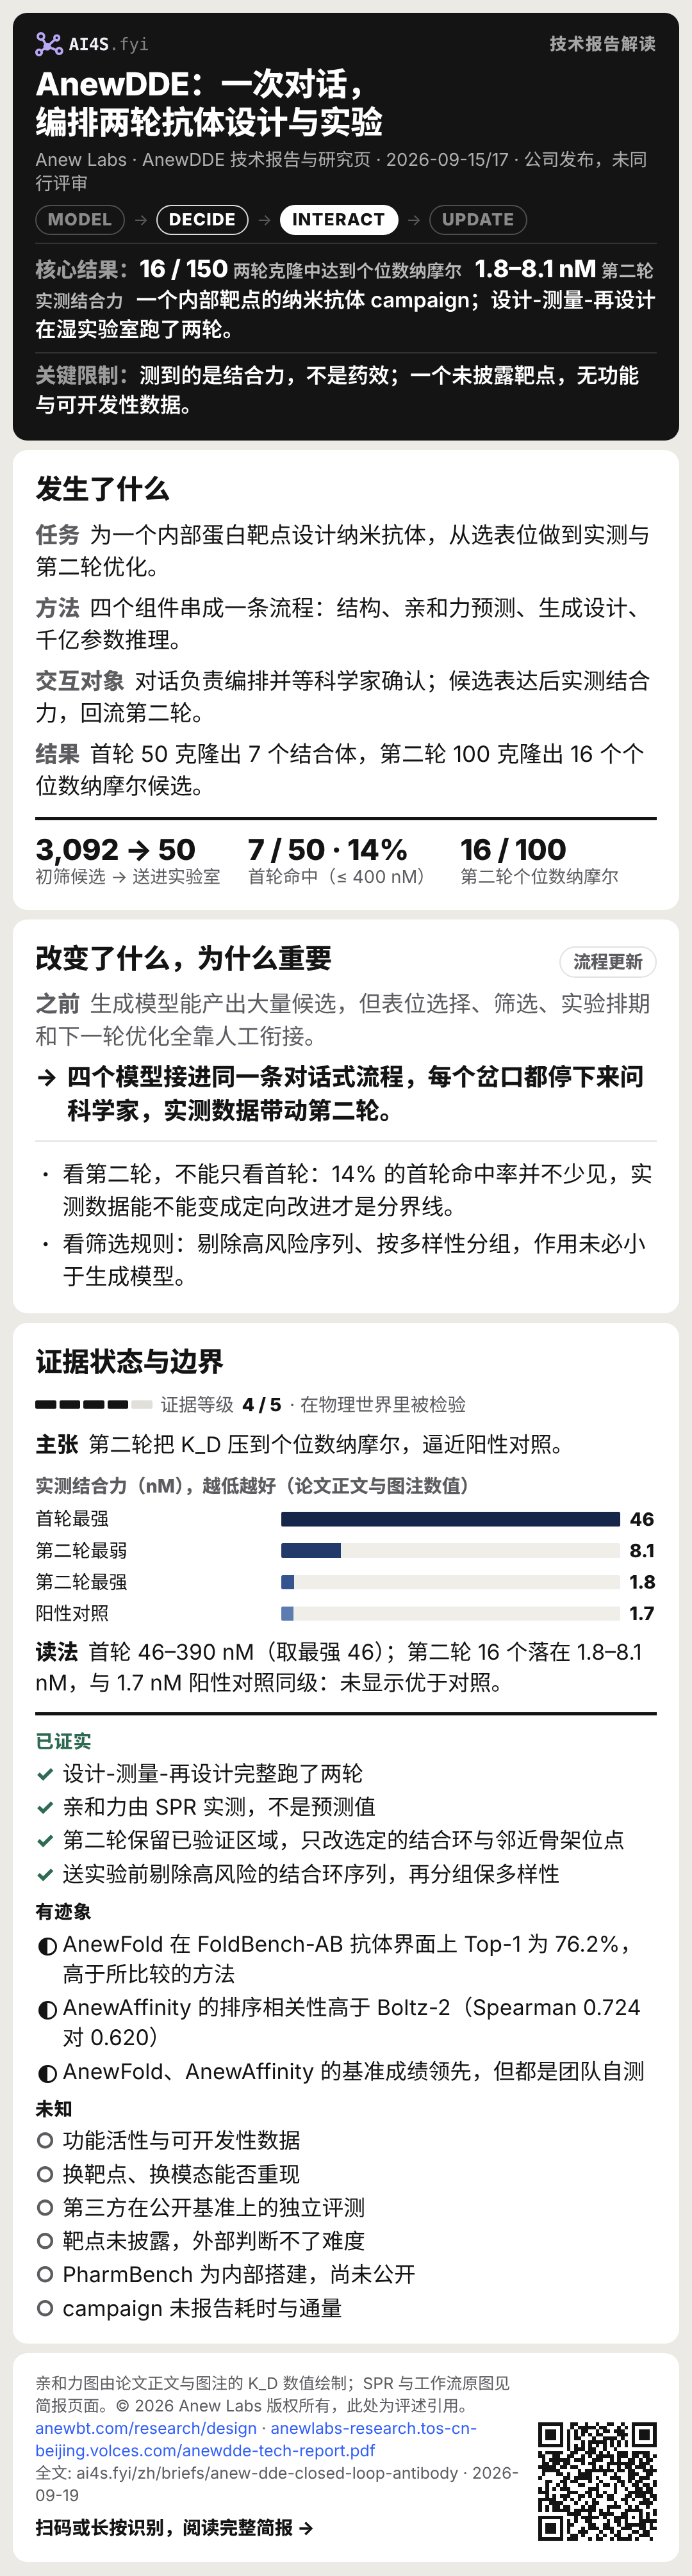
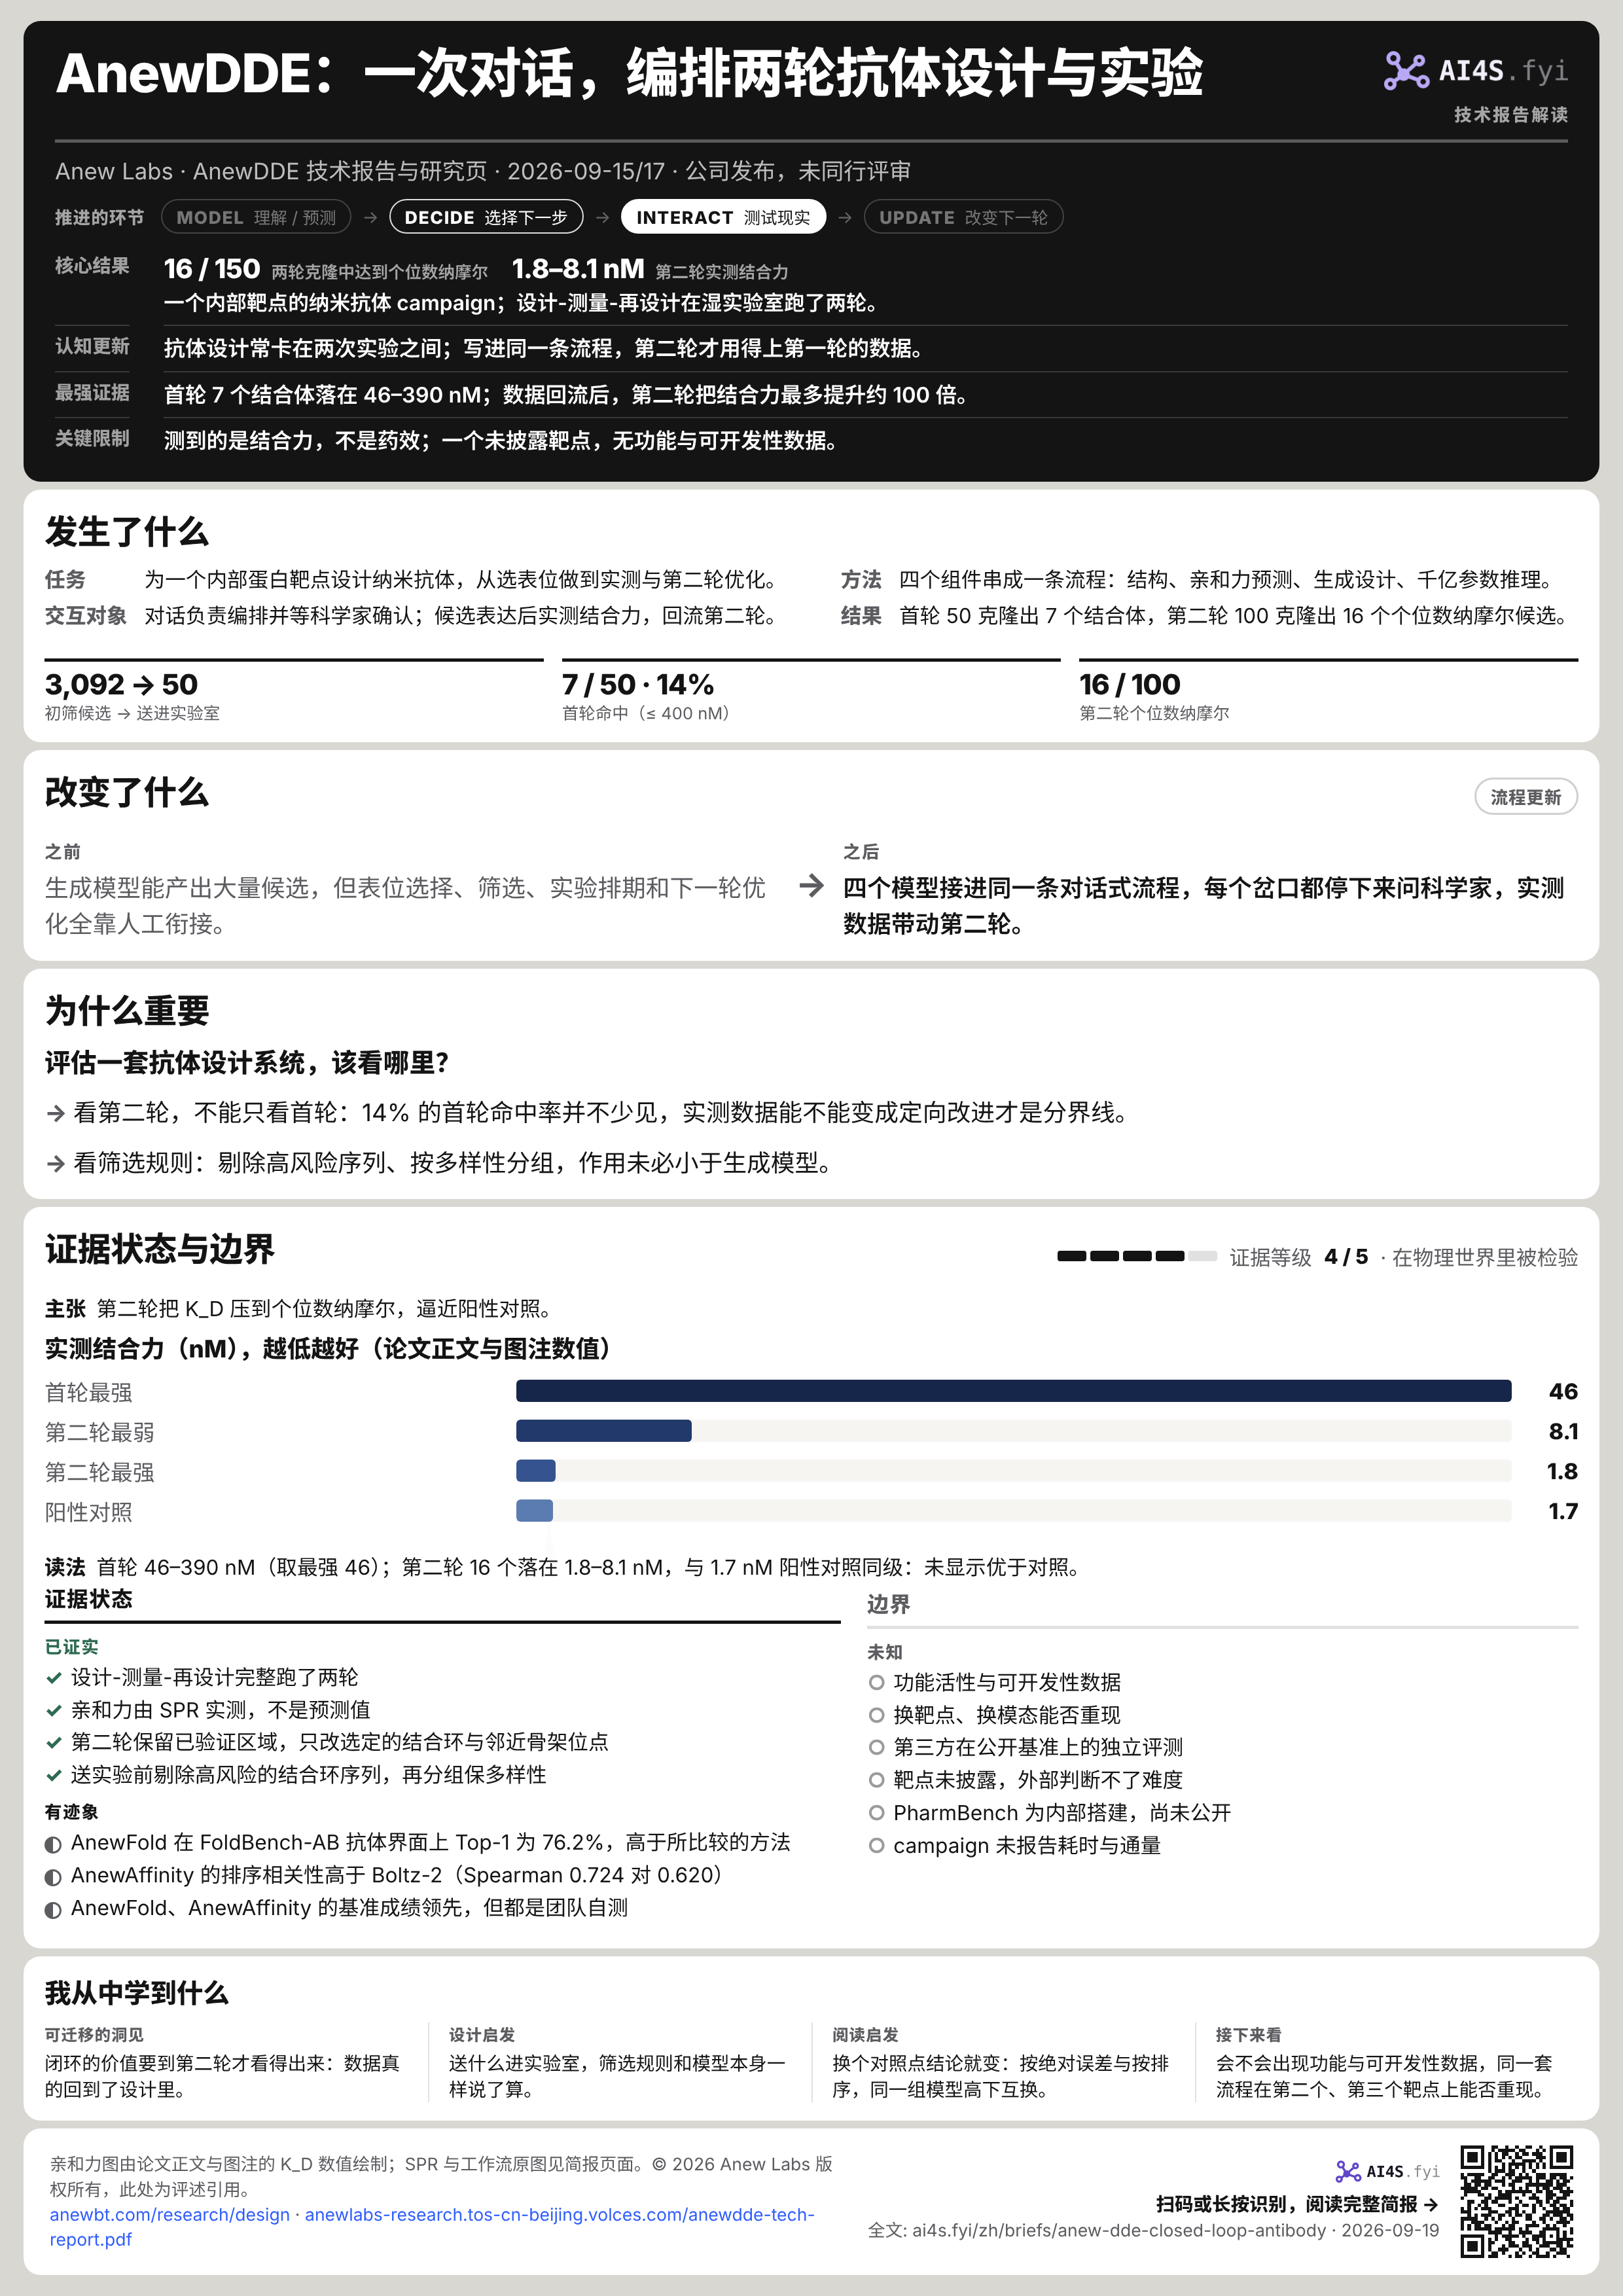
16 / 150两轮克隆中达到个位数纳摩尔
1.8–8.1 nM第二轮实测结合力
一个内部靶点的纳米抗体 campaign;设计-测量-再设计在湿实验室跑了两轮。
- 认知更新
- 抗体设计常卡在两次实验之间;写进同一条流程,第二轮才用得上第一轮的数据。
- 最强证据
- 首轮 7 个结合体落在 46–390 nM;数据回流后,第二轮把结合力最多提升约 100 倍。
- 关键限制
- 测到的是结合力,不是药效;一个未披露靶点,无功能与可开发性数据。
01发生了什么
- 任务
- 为一个内部蛋白靶点设计纳米抗体,从选表位做到实测与第二轮优化。
- 方法
- 四个组件串成一条流程:结构、亲和力预测、生成设计、千亿参数推理。
- 交互对象
- 对话负责编排并等科学家确认;候选表达后实测结合力,回流第二轮。
- 结果
- 首轮 50 克隆出 7 个结合体,第二轮 100 克隆出 16 个个位数纳摩尔候选。
3,092 → 50初筛候选 → 送进实验室
7 / 50 · 14%首轮命中(≤ 400 nM)
16 / 100第二轮个位数纳摩尔
2026 年 9 月 15 日和 17 日,Anew Labs 接连发布了三份材料:AnewMind 和 AnewDesign 两个研究页面,以及把二者串起来的 AnewDDE 技术报告。DDE 是 Drug Discovery Engine 的缩写,标题里加在它前面的词是 agentic:想说的不是又训出一个更好的模型,而是把几个模型接成了一条能连续跑下去的流程。[S1][S2][S3]
先交代一句公司背景。Anew Labs(新生实验室)是字节跳动的 AI 制药团队,此前发布的 Protenix、PXDesign 等模型在结构预测社区已经有人在用。据路透社报道,这条业务线刚完成分拆融资:融资 2.9 亿美元,估值 15 亿美元,字节跳动保留 56% 股份,HSG、IDG 资本和高瓴领投,约 50 名核心成员转入新公司,算力仍由火山引擎提供。这批材料是分拆之后的第一次集中亮相。[S5][S4]
工作流由四个组件组成,各管一段。AnewFold 做结构预测,覆盖抗体-抗原复合物、蛋白-配体相互作用、盲测口袋识别和分子胶三元复合物。AnewAffinity 预测结合亲和力,目标是精度接近自由能微扰(FEP),速度又足以支撑大规模筛选。AnewDesign 负责生成式设计和亲和力成熟。AnewMind 是一个千亿参数量级的大模型,做过全参数后训练,负责 ADMET 与可开发性分析、候选排序和研发决策推理。[S1]
把它们连起来的是一个界面。科学家在 AnewScience 网页里用自然语言说明目标,智能体去查文献和结构、提出表位、启动并管理计算任务、整理候选清单,并在每个关键岔口停下来问一句要不要继续。下图是官方给出的流程截图:左边从生物学背景走到表位选择,右边是生成、筛选和实验反馈。[S2]
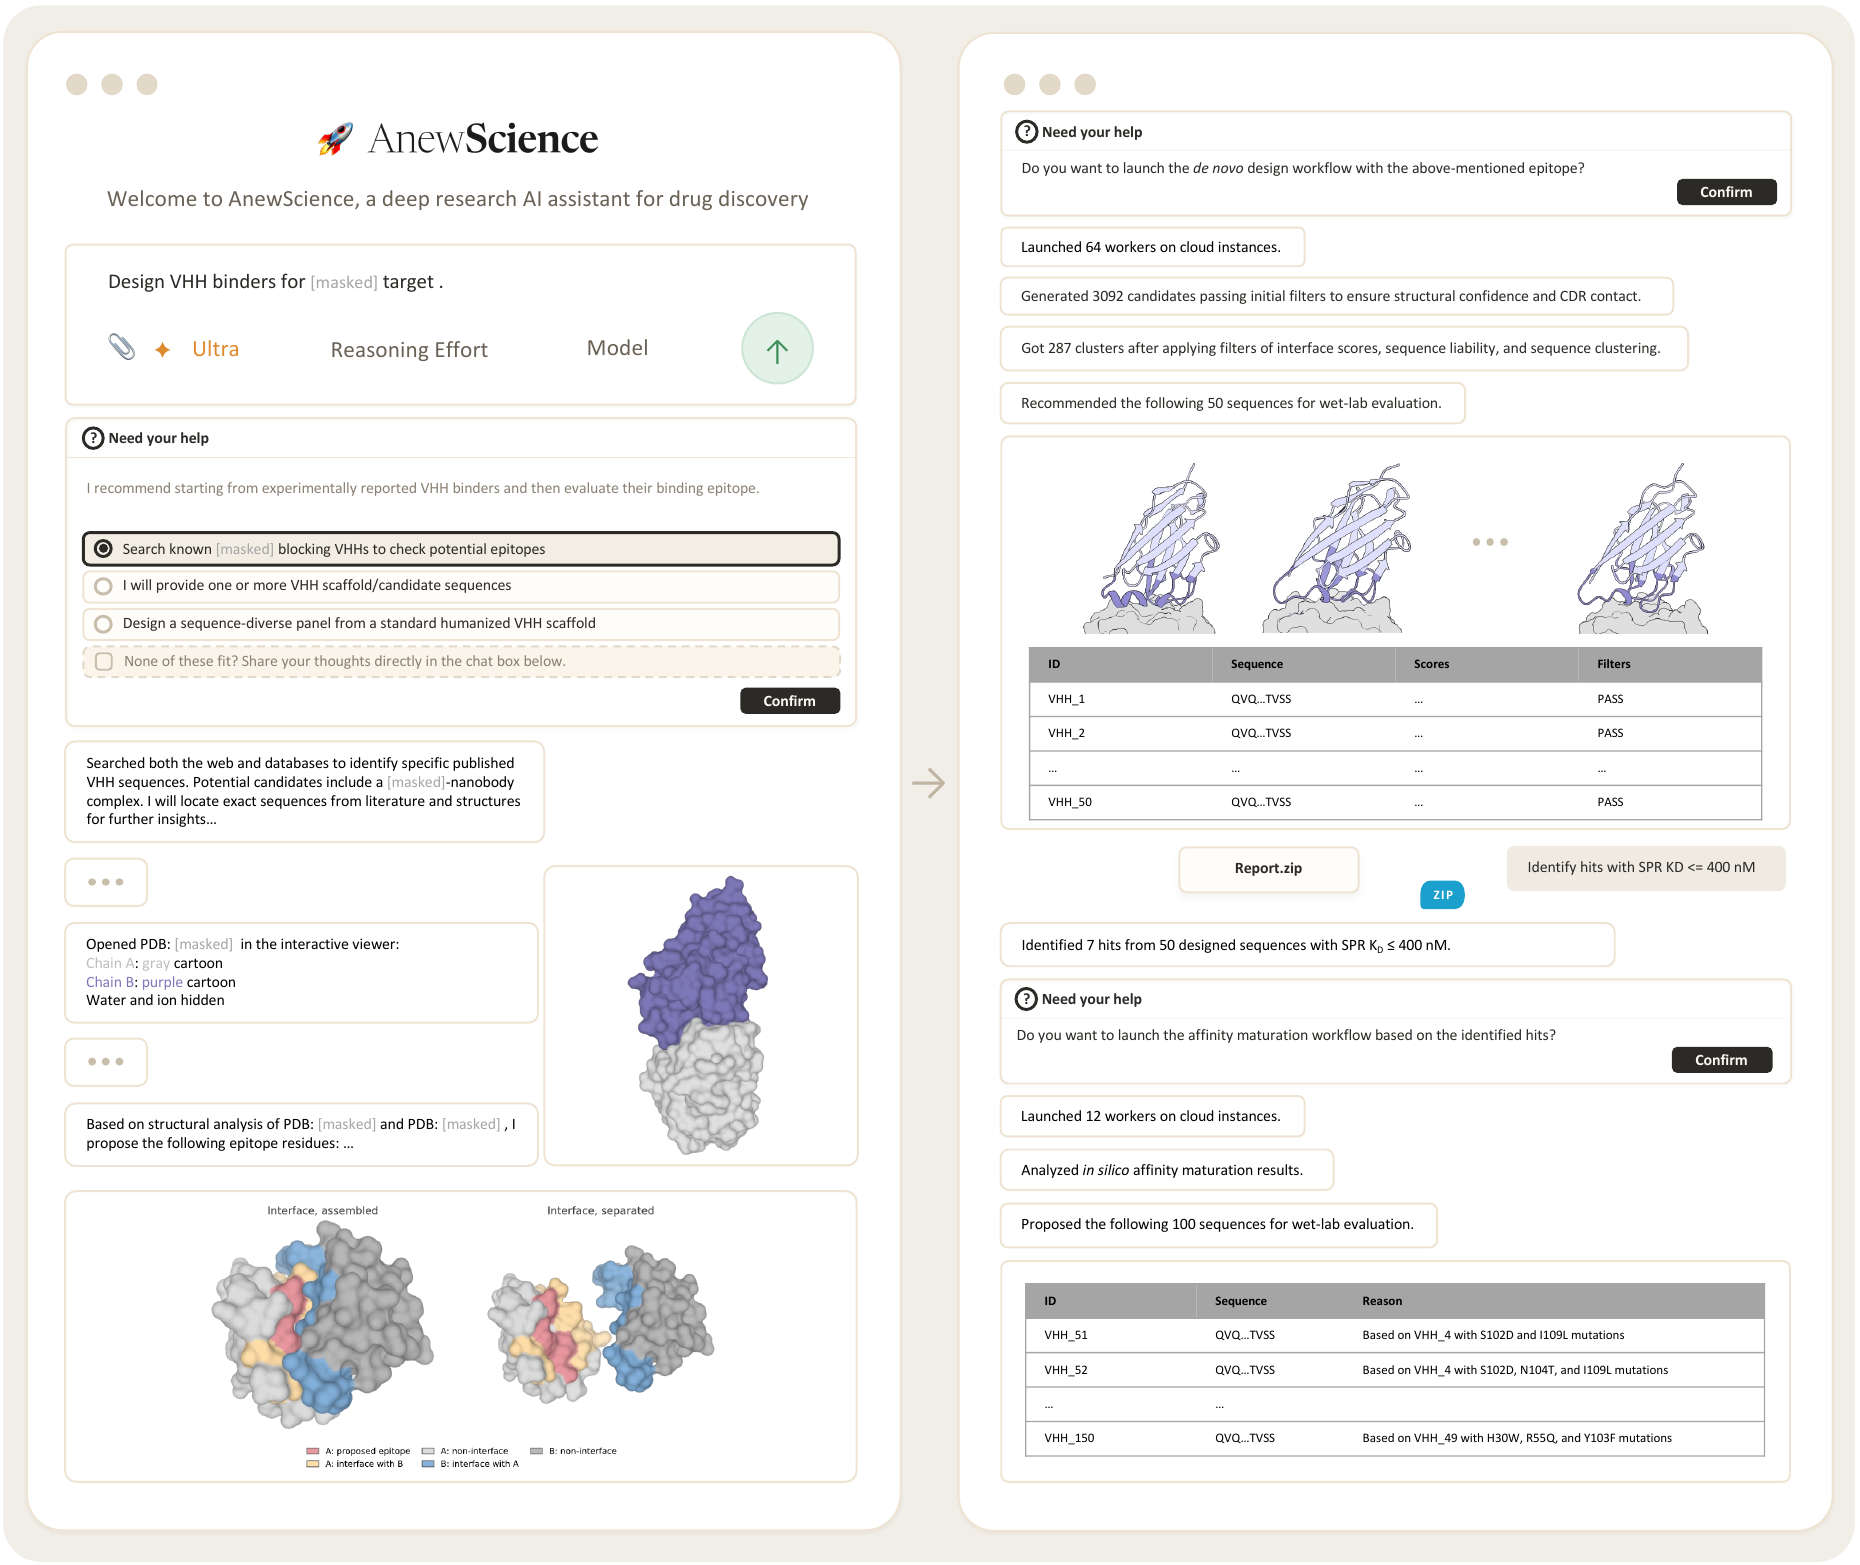
AnewScience 工作流截图:左为表位选择,右为本次 campaign 实际走过的生成、筛选与实验反馈漏斗。图自 Anew Labs 研究页。 [S2]
02改变了什么
流程更新生成模型能产出大量候选,但表位选择、筛选、实验排期和下一轮优化全靠人工衔接。
四个模型接进同一条对话式流程,每个岔口都停下来问科学家,实测数据带动第二轮。
一次 campaign,跑了两轮
第一轮从已有的实验报道出发。智能体先查已发表的 VHH 结合体,看它们结合在哪里,再检索文献、专利和结构数据库,借一个已公开的晶体结构定位候选表位;再用该蛋白与其相互作用伙伴结合的另一个结构,判断这个表位是不是落在想要阻断的机制上。表位定下来后,由扩散模型生成候选,结构预测模型打分评估。[S2]
筛选这一步做得比较细:除了看结构一致性和界面合理性,流程还会识别并剔除 CDR 区里与脱酰胺、断裂、异构化、N-糖基化相关的高风险序列,再做聚类,保证送去实验的候选在结构和序列上彼此有别。50 条序列进了实验室,SPR 测出 7 个 K_D 在 46-390 nM 之间的结合体,首轮命中率 14%。[S2][S1]
这套系统真正想证明的是第二轮。测出的亲和力和可开发性标签作为参考数据回流,部分扩散算法保留已验证的区域,只在选定的 CDR 和邻近框架残基上做探索,再由智能体协助挑选。第二轮送出 100 条序列去测,拿到 16 个 1.8-8.1 nM 的候选。两轮合计 150 个克隆,16 个达到个位数纳摩尔,成功率 10.7%。[S2][S1]
另外三个组件报了什么数
AnewFold 在抗体-抗原界面预测上报了三组 Top-1 成功率:AF3-AB 62.3%,PXMeter-AB 60.8%,FoldBench-AB 76.2%,在这三个集合上都高于所比较的方法。蛋白-配体方面,FoldBench Protein-Ligand 上报 77.4%,对照组 IsoDDE 为 76.0%,AF3 为 64.9%,Protenix-v2 为 64.0%。报告里还有一个更实用的点:只用一个 seed,AnewFold 就超过了采样 500 个 seed 的 Protenix-v1,也就是每次采样的质量更高,而不只是采得更多。[S1]
AnewAffinity 的对照在 199 个配体上做:配对 ΔΔG 的 RMSE 为 1.057 kcal/mol,加权 Pearson R² 为 0.553,Spearman 为 0.724;作为对照,Boltz-2 分别是 1.016、0.486 和 0.620。两者的长短处值得留意:Boltz-2 的绝对误差略小,AnewAffinity 报告的排序相关性更高(Spearman 0.724 对 0.620);而在实际项目里,决定先合成哪一个的是排序。[S1]
AnewMind 在这套系统里负责判断。它在 ADMET 与可开发性的四项综合评估中都进了前五,环肽膜透过性排第一,抗体可开发性接近领先;公司同时强调,它在 MMLU-Pro、GPQA Diamond 这类通用基准上没有明显退步,也就是领域后训练没有拿通用能力去换。为了评估长链条决策,团队请药物研发专家围绕真实案例搭了一个内部基准 PharmBench:逐步放出项目背景和实验证据,看模型能否把证据整合起来作出研发判断,共 200 道子题、七个能力维度,比较了 17 个模型。[S1][S3]
03为什么重要
评估一套抗体设计系统,该看哪里?
- 看第二轮,不能只看首轮:14% 的首轮命中率并不少见,实测数据能不能变成定向改进才是分界线。
- 看筛选规则:剔除高风险序列、按多样性分组,作用未必小于生成模型。
这几年抗体设计最常见的展示是单点能力:结构预测更准了,或者生成模型能产出更多看着合理的界面。真正卡住项目的往往不在这里,而在两次实验之间:谁定表位,谁把几千个候选压到实验室吃得下的数量,测量结果回来后改哪几个残基。AnewDDE 值得一看的地方在于,它把这些衔接写进了一条流程,还公开了流程跑完两轮的实测数字。[S1][S2]
自然语言界面在这里不只是个包装。流程每到一个岔口都停下来问一句要不要继续,等于把专家判断留在了循环里:表位选得对不对、这批候选值不值得花实验预算,仍由科学家拍板,智能体负责把决定变成能跑的计算任务。对一家既有 AI 团队又有药物化学团队的公司来说,这样分工比全自动更现实。[S2]
从产业角度看,这次发布还有一层意思。团队此前的 Protenix 是公开可用的 AlphaFold3 复现工作,社区里用的人不少;分拆之后,同一批人做的模型开始服务自家管线:公司披露的管线包括 IL-17、IL-4R 和两个未披露靶点。靠开源模型攒下的声誉,正在变成一家手里有候选药物的公司。[S4][S5]
04证据状态与边界
证据等级 4 / 5 · 在物理世界里被检验 · 闭环实验证据状态
已证实
- 设计-测量-再设计完整跑了两轮
- 亲和力由 SPR 实测,不是预测值
- 第二轮保留已验证区域,只改选定的结合环与邻近骨架位点
- 送实验前剔除高风险的结合环序列,再分组保多样性
边界
有迹象
- AnewFold 在 FoldBench-AB 抗体界面上 Top-1 为 76.2%,高于所比较的方法
- AnewAffinity 的排序相关性高于 Boltz-2(Spearman 0.724 对 0.620)
- AnewFold、AnewAffinity 的基准成绩领先,但都是团队自测
未知
- 功能活性与可开发性数据
- 换靶点、换模态能否重现
- 第三方在公开基准上的独立评测
- 靶点未披露,外部判断不了难度
- PharmBench 为内部搭建,尚未公开
- campaign 未报告耗时与通量
主张第二轮把 K_D 压到个位数纳摩尔,逼近阳性对照。
实测结合力(nM),越低越好(论文正文与图注数值)
读法首轮 46–390 nM(取最强 46);第二轮 16 个落在 1.8–8.1 nM,与 1.7 nM 阳性对照同级:未显示优于对照。
测到的是结合力,不是药效。
SPR 测的是亲和力。这些纳米抗体能否阻断目标机制、在细胞或动物模型里有没有活性、可开发性如何,报告把这些列为接下来的评估步骤,目前还没有数据。从结合体走到候选药物,恰恰是这几步淘汰率最高。[S2]
一个靶点、一种模态。
这次公开的,是针对一个未披露的内部蛋白靶点做的纳米抗体 campaign。靶点不公开,外部就判断不了它有多难:有成熟晶体结构、有已发表 VHH 结合体可参考的靶点,和真正的硬骨头不是一回事。报告自己也把换更多靶点的进一步研究列为后续工作。[S2]
基准由团队自己运行。
AnewFold 和 AnewAffinity 的对照都在公司内部完成,PharmBench 也是内部搭建、尚未公开。模型发布里自评很常见,读的时候当作团队自己报告的结果、而不是独立评测就好;AnewFold 用的 AF3-AB、FoldBench 等集合是公开的,第三方具备复现的条件。[S1]
换个对照点,结论就变。
亲和力这一项就是现成的例子:按 ΔΔG 的绝对误差看,Boltz-2 略好;按排序相关性看,AnewAffinity 的报告值更高。抗体那一项也有一个现成的参照:第二轮 16 个候选落在 1.8-8.1 nM,同一张图里的阳性对照是 1.7 nM,与已有分子同一数量级,未显示优于对照。[S1][S2]
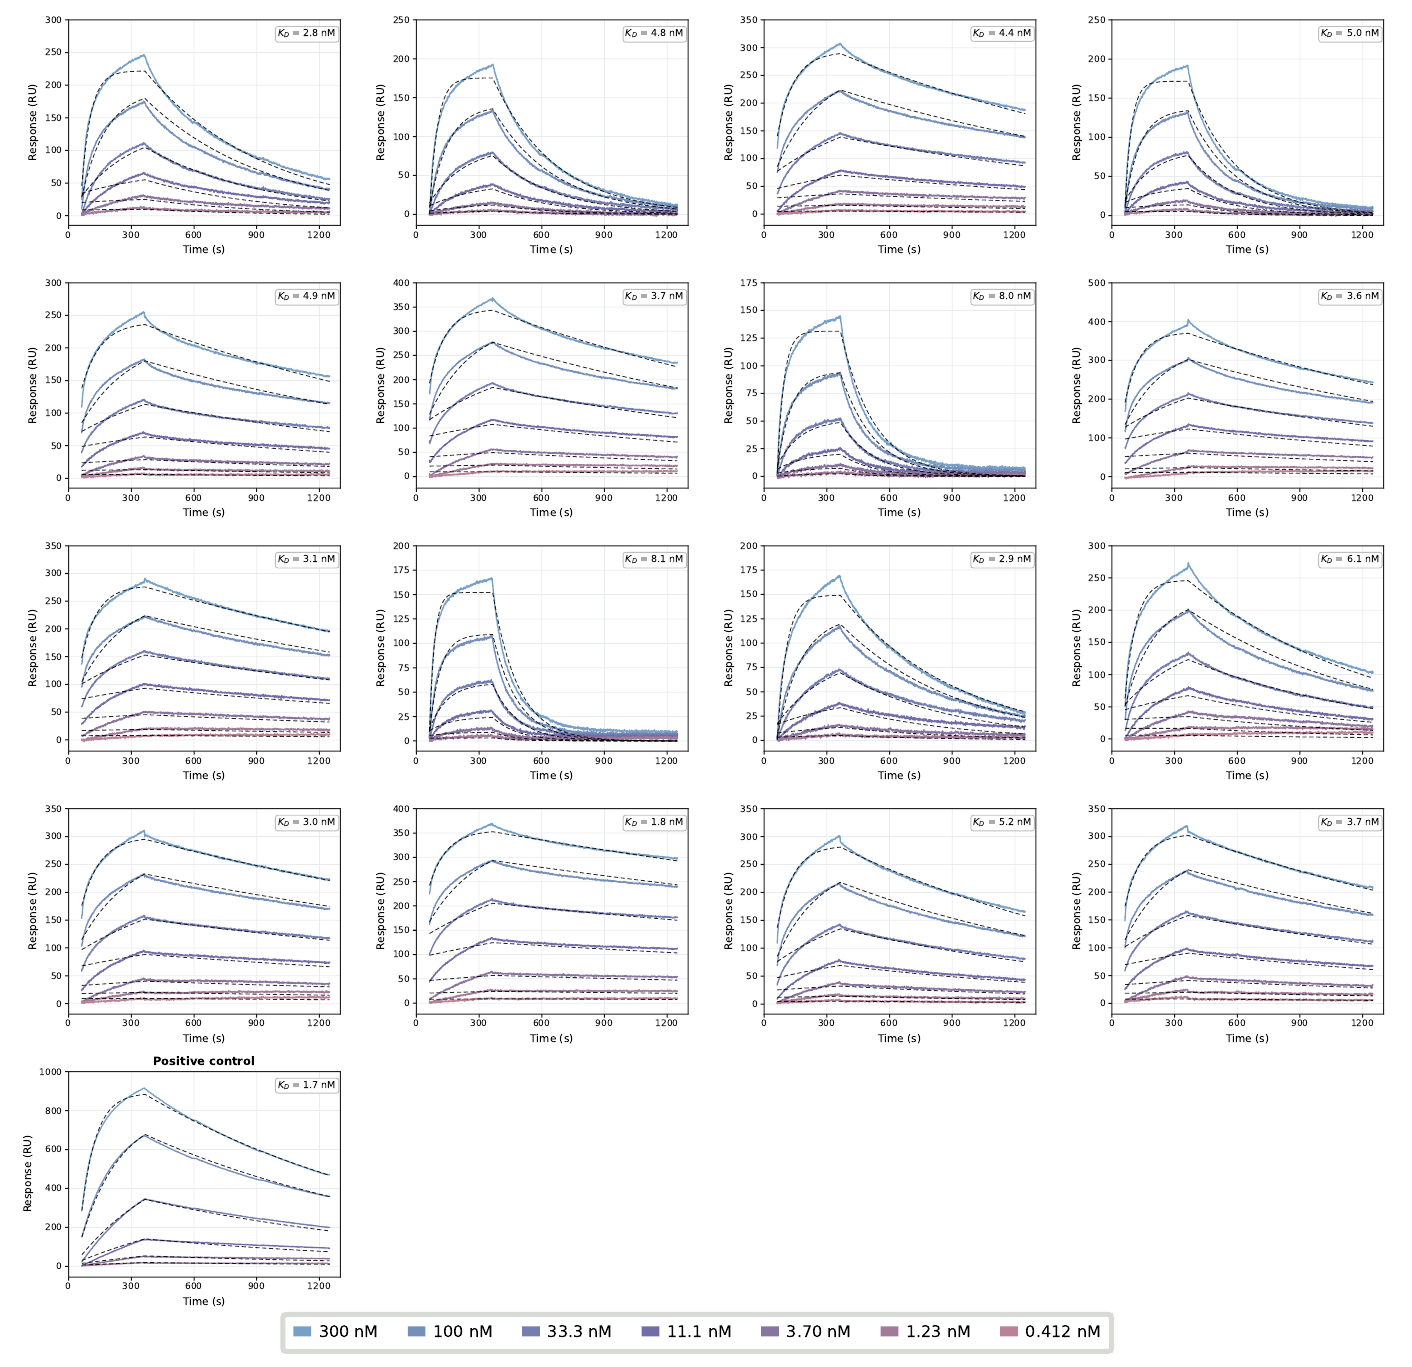
第二轮经实验反馈优化后的 SPR 响应曲线,16 个候选亲和力 1.8–8.1 nM,末幅为阳性对照。图自 Anew Labs 研究页,整图未作修改。 [S2]
05我从中学到什么
- 可迁移的洞见
- 闭环的价值要到第二轮才看得出来:数据真的回到了设计里。
- 设计启发
- 送什么进实验室,筛选规则和模型本身一样说了算。
- 阅读启发
- 换个对照点结论就变:按绝对误差与按排序,同一组模型高下互换。
- 接下来看
- 会不会出现功能与可开发性数据,同一套流程在第二个、第三个靶点上能否重现。
闭环的价值要到第二轮才看得出来。
首轮 14% 的命中率,在抗体发现里算不上稀奇;真正的分界线是拿到 SPR 数据之后能不能定向改进。这次两轮之间 K_D 最多压低约两个数量级,说明实验反馈确实进了下一轮设计,而不只是被记录下来。评估这类系统,看第二轮比看第一轮更有信息量。
写进流程的筛选规则,和模型一样重要。
报告里容易被跳过的一段是候选筛选:剔除带脱酰胺、断裂、异构化、糖基化风险的 CDR 序列,再聚类保证多样性。这些规则决定了进实验室的 50 条序列长什么样,对最终命中率的影响未必比生成模型小。
开源模型与自有管线开始分家。
Protenix 当初是公开发布的,AnewFold 和 AnewMind 目前还是内部系统的一部分。同一支团队分拆、融资、有了自己的管线之后,对外公开的东西就从模型权重变成了技术报告。这不是一家的特例,值得当作一条趋势记下来。
长图版本方便保存转发→资料来源
本文依据 Anew Labs 的 AnewDDE 技术报告和 AnewDesign、AnewMind 研究页,这几份材料本次核查中都读过;分拆融资的金额、估值和投资方来自路透社报道(经 The Next Web 转述)。管线信息来自公司官网。