验证速度决定闭环,抽象能力决定上限
按他的框架,Radical 和 Lila 这类公司在解决速度,一个物理实验的返回时间;他自己的公司在押上限,也就是怎么让模型提出不在训练分布里的想法。两者要不要同一个模型,访谈没有回答。


AI FOR SCIENCE · 访谈
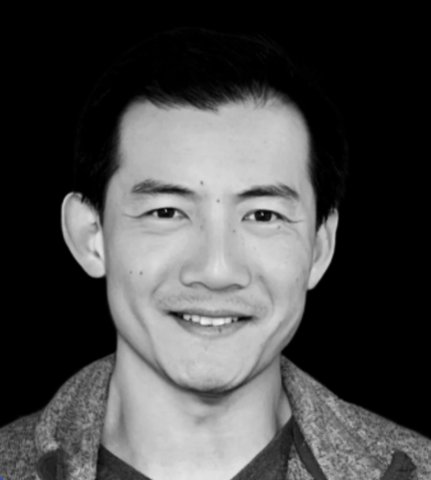
一位前 DeepMind 科学家、Unreasonable Labs 的联合创始人认为:AI4S 眼下被物理验证限速,长远被“概念形成”卡住;他把概念抽象称为 AGI 的最后一关。
他拆开了一个模型到实验的闭环(搜索时在“利用”和“探索”之间怎么打分),说明了哪些问题现在适合 AI,给出了他对 Google、OpenAI、Anthropic 在 AI4S 上各自优先级的读法,也讲了自己公司在做什么:在大语言模型外加一层符号机制,去生成概率很低的新想法。
几乎都是他个人的判断和预测;公司自己的做法没有给出数字或结果;他对别家公司内部优先级和人事变动的说法是他的读法,不是来源。
代码和数学能马上知道对不对,所以 AI 编程能形成闭环;科学要做实验,药物不到上市不知道效果。他说如果一次物理实验一分钟就能返回,就可以生成无数数据直接后训练,和代码、数学一样。现在最快的是模拟,湿实验最慢,办法是自动化实验室和更少的实验次数。
问题的定义和品位仍然是人的事。AlphaFold 之所以成功,是因为问题定义清楚、表征明确;OpenAI 与 Ginkgo 的闭环实验被他称为目前最有说服力的例子。他还反对把科学只当 AI 的应用:要让 AI 在科学问题上做好,AI 自己的推理、抽象和做实验的能力都要提高,难的科学问题反过来会推动 AI。
通用模型像“实验室主管”,调用 AlphaFold、GNoME、MatterGen 这样的垂直模型;挑下一个实验是一棵搜索树,每个节点的分数是直觉价值加上被探索过的次数,和强化学习里平衡利用与探索一样。他还说闭环本身也要能改自己的工作流,也就是“元递归”。
他说 AI 可以在已有的表征空间里排列组合,已经比人快;但从观察里抽象出新概念,比如从三只鹅、四只鸟里抽出“数”,目前做不到。他用 Doudna 的话说 AI 给的方案没有一个是他们不知道的,并认为 AlphaGo 的第 37 手是已有表征里的新采样,不是新概念。他把概念抽象称为 AGI 的最后一关,甚至怀疑它不是图灵可计算的,这是他的个人立场。
“概念抽象的过程,我认为可能是 AGI 的最后的 last mile(最后一英里)。”曹原Unreasonable Labs 想在语言模型外面加一套不是另一个语言模型的机制,用规则把跨论文、跨领域的知识串起来,给模型一个能产生小概率想法的“新直觉”。难点是创新性和可行性的平衡。他预期最终可能是约 98% 连接主义加 2% 符号,并说数学里的 Lean 形式化验证已经是这种神经符号结构。
他的粗略时间感:因果推理、长期记忆、持续学习这些基础能力要五六年;诺贝尔级的自主发现至少二三十年。AI4S 的商业化是分层的:药物和生物最先,材料的价值链太碎。人的位置是定义问题、验证和价值判断:他说“证明过剩”时,人需要理解并判断,否则像看机器人弹钢琴。
时间线 2026-08-05 的条目记录 Jeff Dean 离开 Google 创立 Discovery Loop,目标是自动化科学与工程的循环。
曹原在消息发布后第二天讲了他的读法:Google 优先把 Gemini 做上去,Dean 的团队做的方向和他自己的创业公司一致;他说这是人才流动,不是 Google 放弃 AI4S。
时间线上 AI4S 的闭环结果集中在湿实验里:Radical、Lila 等公司公布的是各自平台的吞吐和具体材料。
曹原给出一个更上层的拆法:问题选择、表征、搜索、验证、概念形成,认为验证决定闭环速度,概念形成决定发现的上限。
按他的框架,Radical 和 Lila 这类公司在解决速度,一个物理实验的返回时间;他自己的公司在押上限,也就是怎么让模型提出不在训练分布里的想法。两者要不要同一个模型,访谈没有回答。
他引用陶哲轩的说法:难题下面已堆满 AI 生成的解答,没有专家有精力验证。他的结论是人保留价值判断,因为不可解释的结果会抬高维护和信任的成本。这是对科研流程的预测,不是已测量的。
可计算、可清楚建模、容易验证的问题最适合当前 AI;问题定义和科研品位仍由人做。
受访者判断
他的任务选择框架,不是跨领域基准的结论。
验证是 AI4S 闭环最大的瓶颈;一分钟一次物理实验就能像代码、数学那样迭代。
受访者判断
论证来自实验成本和反馈速度;各领域的实际瓶颈要分别衡量。
OpenAI 与 Ginkgo 的闭环实验是目前最有说服力的闭环案例。
行业背景
他的评价;这项工作的细节见 OpenAI 那期访谈的相关证据。
A-Lab 17 天做了 353 个实验,57 个目标材料合成了 36 个。
行业背景
主持人引用的公开案例,这一期没有谈围绕它的争议。57 个里 36 个是《自然》2026 年 1 月 19 日作者更正之后的数:更正删去训练数据里本已有的一个化合物,手工重读衍射数据后确认 40 个报告的成功中 36 个成立,另 4 个无法确定;更正还说论文里的“新材料”指的是对预测平台而言是新的,不一定是科学上新的。
当前语言模型的因果推理不可靠:换措辞或做干预(do 演算)就会出错;世界模型也许能改善。
受访者判断
他的判断,依据是措辞敏感和分布外的稳定性;世界模型的收益没有被检验。
AI 还没有展示从观察里创造新概念的能力;概念抽象是 AGI 的最后一关,也许不是图灵可计算的。
受访者判断
他自己标明是个人立场;概念发明目前没有公认的基准。
基础能力继续发展约五六年;诺贝尔级的自主发现至少二三十年。
受访者判断
粗略的时间感,不是路线图。
Unreasonable Labs 在大语言模型外加一层符号机制,生成概率很低的新想法;难点是创新性和可行性的平衡。
公司自述
研发的早期阶段;没有给出结果或数字。
Google 因 Gemini 优先级调整了 AI4S,OpenAI 在 Kevin Weil 离开后把 AI4S 并入 Codex,Anthropic 的 Claude Science 是工作台,John Jumper 加入后可能做生物医药方向的模型。
行业背景
他对三家公司内部优先级的读法,不是来源。时间线记有 OpenAI 这一条:Kevin Weil 4 月 17 日离开,OpenAI for Science 拆分并入其他研究团队,并入 Codex 团队的只有写作平台 Prism,比“并入 Codex”窄;其余的说法本站没有记录。
新概念形成没有基准,世界模型和神经符号结构能否同时提高创新性与可行性也没有被检验。
尚未闭环
他自己承认这些仍在探索。
有没有公开的、能衡量“提案新颖度”和“可行性”的基准。
会表现为 一个有定义的评测,并有多家系统的得分。仍未解决 Cao 自己公司的一篇论文最接近:ProjectionBench(arXiv,2026-05-28,早于访谈;10 月 17 日记入时间线)。四个 GPT 和 Gemini 模型只凭研究问题、再逐步拿到更多细节,预测 45 篇新近材料论文的结果,由 GPT-5 按与论文结论的重合度打分。它给了多个系统的分数,但量的是与已发表结论的一致程度,不是新颖度或可行性,基准本身当时也未公开。衡量新颖度和可行性的公开基准仍未见。Unreasonable Labs 有没有拿出神经符号层相对纯 LLM 的结果。
会表现为 同一问题上新颖度和可行性的并排数字,最好有外部评审。仍未解决 10 月 11 日读到的公司新闻页共四篇:两篇是示意性的使用演示(2026-04-21、2026-05-19,早于访谈),没有新颖度与可行性的并排数字,也没有外部评审(10 月 18 日该页返回 503,未重读)。记录里公司有两篇论文,都在 2026 年 5 月:LEIA(05-27)预测点阵材料怎样变形、应力在哪里集中,只对照仿真检验;ProjectionBench(05-28)只给 GPT 和 Gemini 打分,没有神经符号层,也没有公司自己的系统。两篇都没有把神经符号层和纯 LLM 对比。世界模型或类似方法有没有在干预类因果测试上超过纯文本模型。
会表现为 一个包含干预题的测试,同一批模型的对照结果。Discovery Loop 或别的闭环公司有没有报告加入物理验证的闭环结果。
会表现为 写明验证方式和吞吐的具名结果。部分回答 10 月 27 日 BigHat 与 Anthropic 的技术报告是一个写明验证方式和吞吐的具名结果:Claude 接入 BigHat 的实验室数据系统提出改动,BigHat 的自动化实验室约 10 周做出并测了约 1010 个抗体变体,分七轮,测结合、热稳定性和聚集(时间线 10 月 27 日记入)。这是两家公司自己的报告,未经同行评审,全部测量在 BigHat 自己的实验室;Discovery Loop 仍未公布结果。后来出现的、检验或限制这次说法的证据,以及日期已过的目标。
访谈里说物理验证是瓶颈,也说 Anthropic 要补上生物医药方向。9 月 18 日路透社报道 Anthropic 已建了一个让 Claude 编排机器人实验的物理湿实验室,是从信息层走向物质层的一步。时间线条目 →
Lila 报告了一个无铱催化剂,在 2,942 种氧化物里筛出,用模拟之外的实验验证了 1,000 小时的稳定性。这是一个闭环实验;搜索发生在固定的氧化物体系里,正是他区分于“概念创造”的那种搜索。时间线条目 →
Anthropic 收购一人制药公司 Mithril Medicine,开始自己跑药物项目,同一篇文章还报告了与六家机构的合作,其中三家给出了在自己实验室测得的湿实验结果。这比湿实验室更进一步地印证了访谈里“Anthropic 要补上生物医药”的判断;但文章自己说这些工作大多还在临床前,结果都是公司自己的报告。时间线条目 →
读于 2026.10.01 YouTube 中文自动字幕(机器生成,无标点),读完全文。第一版(2026-08-23)对照过 BigGo 的文字整理。 打开原访谈 ↗BigGo 的访谈文字整理 ↗