

AI FOR SCIENCE · 证据简报
证据简报
针对单项结果的长文:证明了什么、改变了什么,以及证据目前停在哪里。
38 篇
临床证据观察
当算法成为药物的一部分:Moderna V940 的 III 期证据与边界
INTerpath-001 达到 RFS 与 DMFS 终点并给出了风险比,但总生存期、跨癌种复制、个体化制造与商业化能力仍待验证。
论文解读
ChronoSyn:把材料被发现的先后顺序当作可合成性的监督信号
帝国理工学院的 ChronoSyn 怎样在可合成性预测里加入发现年代排序,留出测试和按年份截断的回溯测试各说明了什么,以及作者自己指出的局限:从历史学习,可能偏向已经被研究过的化学体系。
证据地图
把湿实验放进回路:智能体三轮设计核酸适配体,命中率从 0 到 42%
一次三轮闭环的智能体分子设计实验,证明了什么、没有证明什么。
证据地图
AIntibody 盲测:511 个抗体同一套检测测下来,AI 赢在哪项任务、输在哪项
一场前瞻、盲测、按同一套检测判分的抗体设计挑战,证明了什么、没有证明什么。
论文解读
从零设计的半胱氨酸蛋白酶:69 个里 13 个能切,而且在活细胞里切得动
肽键在中性水里能存在几百年,从头设计的酶此前多半只做活化酯。本文梳理这篇论文的设计管线、19% 的一次性命中率、确认催化来自设计的敲除与晶体证据、细胞内实验做到哪一步,以及它与天然蛋白酶之间还差多少。
论文解读
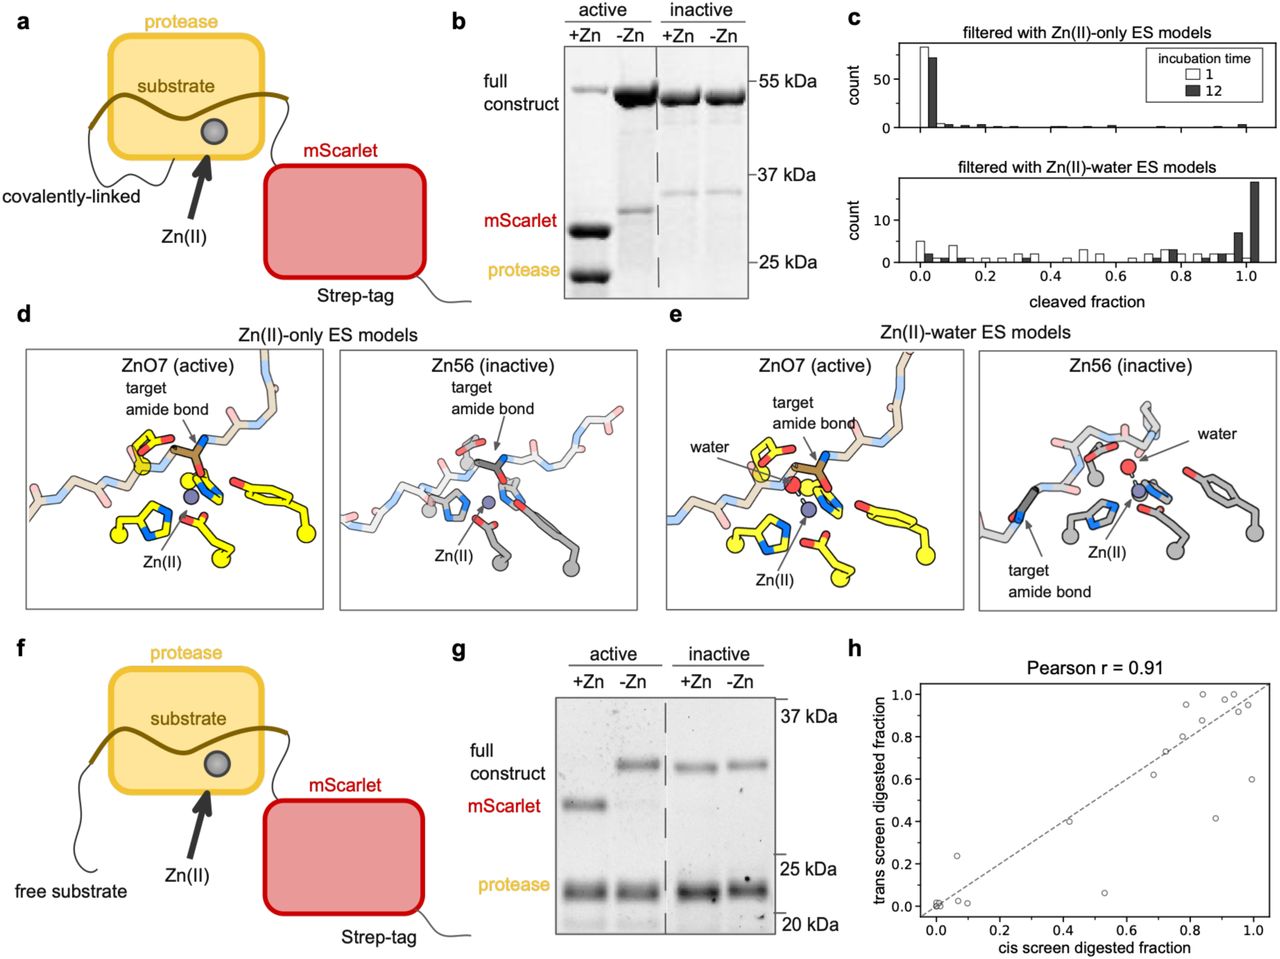
设计出来的锌蛋白酶:一次设计 135 个,36% 切在指定的那根肽键上
从头设计的酶此前只做活化酯这类容易的底物,肽键是公认的难关。本文梳理这篇论文的设计管线、让命中率从 15% 跳到 88% 的那一处改动、五个被详细表征的设计的敲除与晶体证据、三个致病蛋白的靶向结果,以及论文自己承认的速率差距。
论文解读
AlphaProtein Novo:从头设计的酶第一次在实用化学上胜过筛天然序列,赢的是选择性和条件,不是速率
这篇论文第一次把从头设计和筛天然序列放在同一个实际问题上直接比较,并给出了哪一边赢、赢在哪里。本文梳理两个设计战役的数字、三个模型反应上的催化参数、让命中率上去的那个筛选方法,以及论文自己列出的边界。
综合解读
同一个模型,换一套外围系统:三份证据说明框架能决定多少成绩
把三份研究按「同一模型、换框架时固定了什么」并排读:分数差多少,推理强度、预算、数据接入和打分方是否一致,以及要把方向变成定论还缺哪些证据。
论文解读
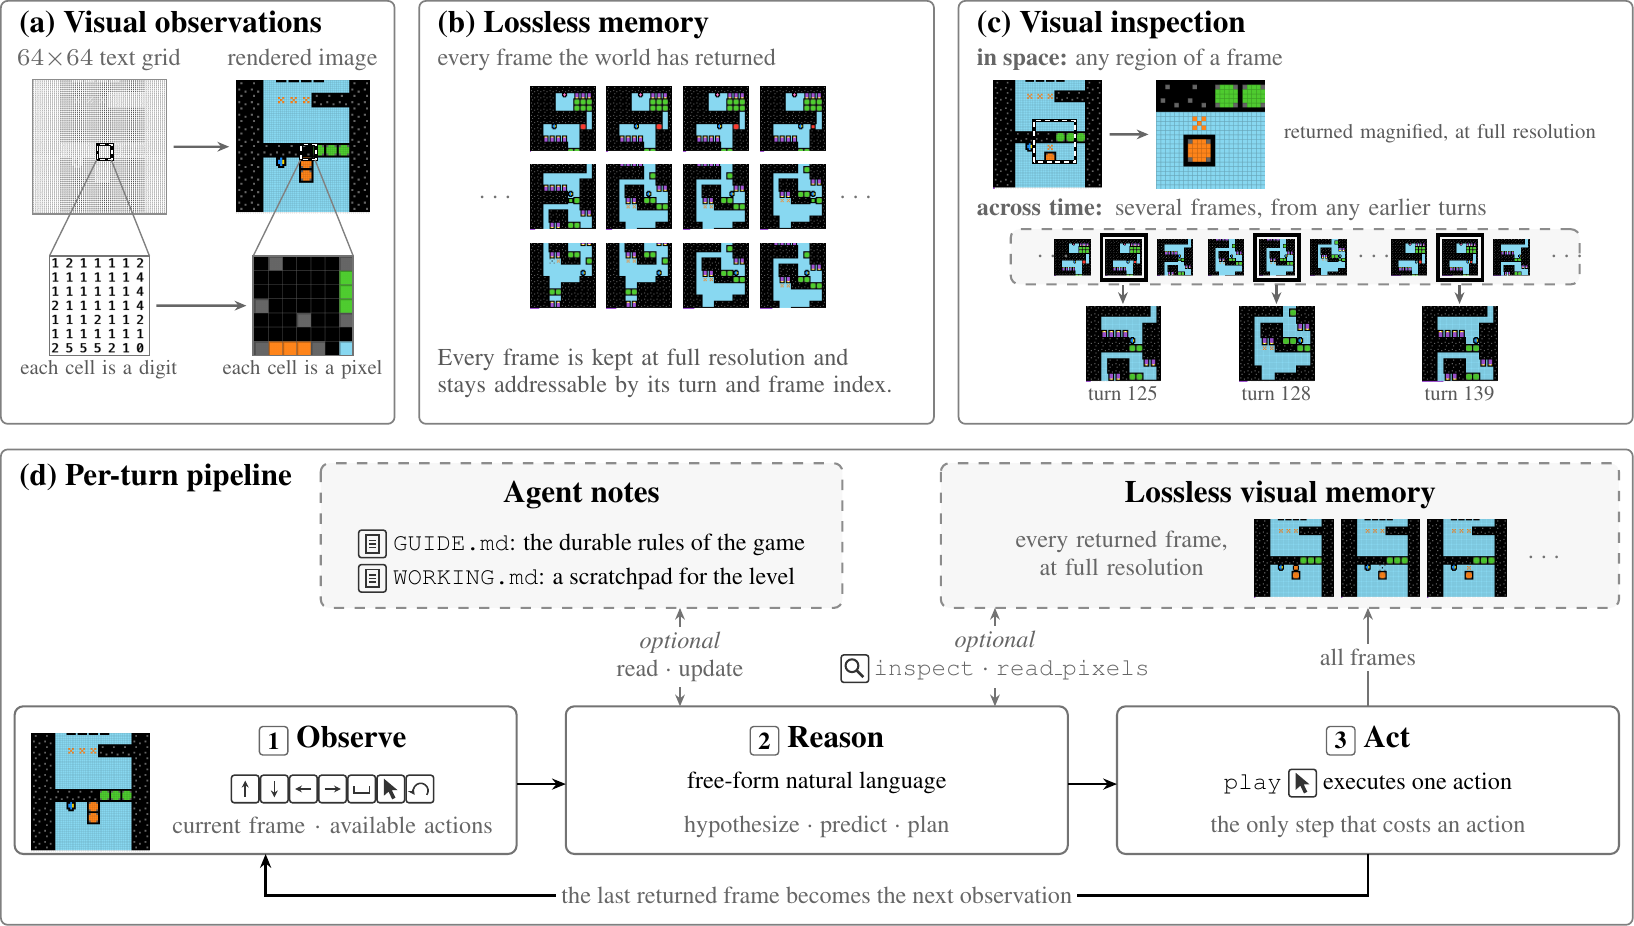
VISTA 不训练新模型,只改模型看和记的方式:Claude Opus 5.0 在 ARC-AGI-3 公开游戏上从 40.68 到 100
VISTA 论证多模态模型在交互环境里的短板,有一大块出在模型外面:它看到的是不是原始画面,看过的能不能回头再看。本文梳理它的设计、逐项拆解是怎么做的、对照基线的口径,以及这对盯着实验的科学智能体意味着什么。
政策讲解
单月投稿破 4 万篇:arXiv 为什么把每人每月限到两篇
讲解 arXiv 2026 年 10 月 1 日起实行的投稿限额:规则怎么算,9 月 40,363 篇投稿等数字从哪来、各有多硬,它和此前的收紧、各大会议的限额有何不同,以及接下来看什么。
报告讲解
自动化 AI 研发会引发智能爆炸吗:一份联署论文的论证
讲解剑桥 CASP 工作论文:AI 为什么可能加速 AI 自身的研发,作者怎么读现有证据,每个数字有多硬,以及他们要政府做什么。
论文解读
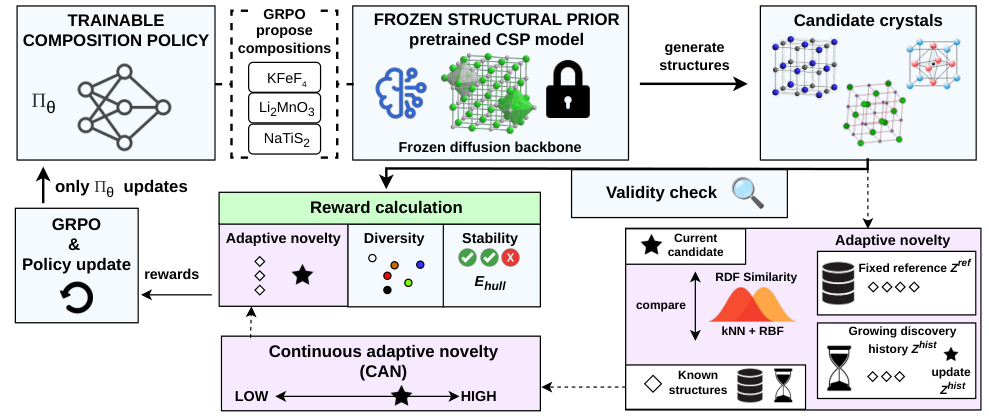
ANCHOR 冻结结构模型、只训练成分选择,SUN 从 1.1% 升到 22.1%;换一组势函数打分,领先就反转
ANCHOR 论证强化学习的奖励应该作用在「搜哪些成分」上,而不是改写结构模型本身。本文梳理它的对照是怎么设计的、SUN 与 MSUN 各由哪个势函数和凸包判定,以及结果在三种评估流程下各是多少。
公司图谱
走出 DeepMind:顶级研究员创业图谱
DeepMind 与 Google Brain 研究员创办的 22 家公司:按各自打算从什么反馈中学习归类,逐条标明融资数字是已完成、据报道、目标还是历史。
论文与实验验证
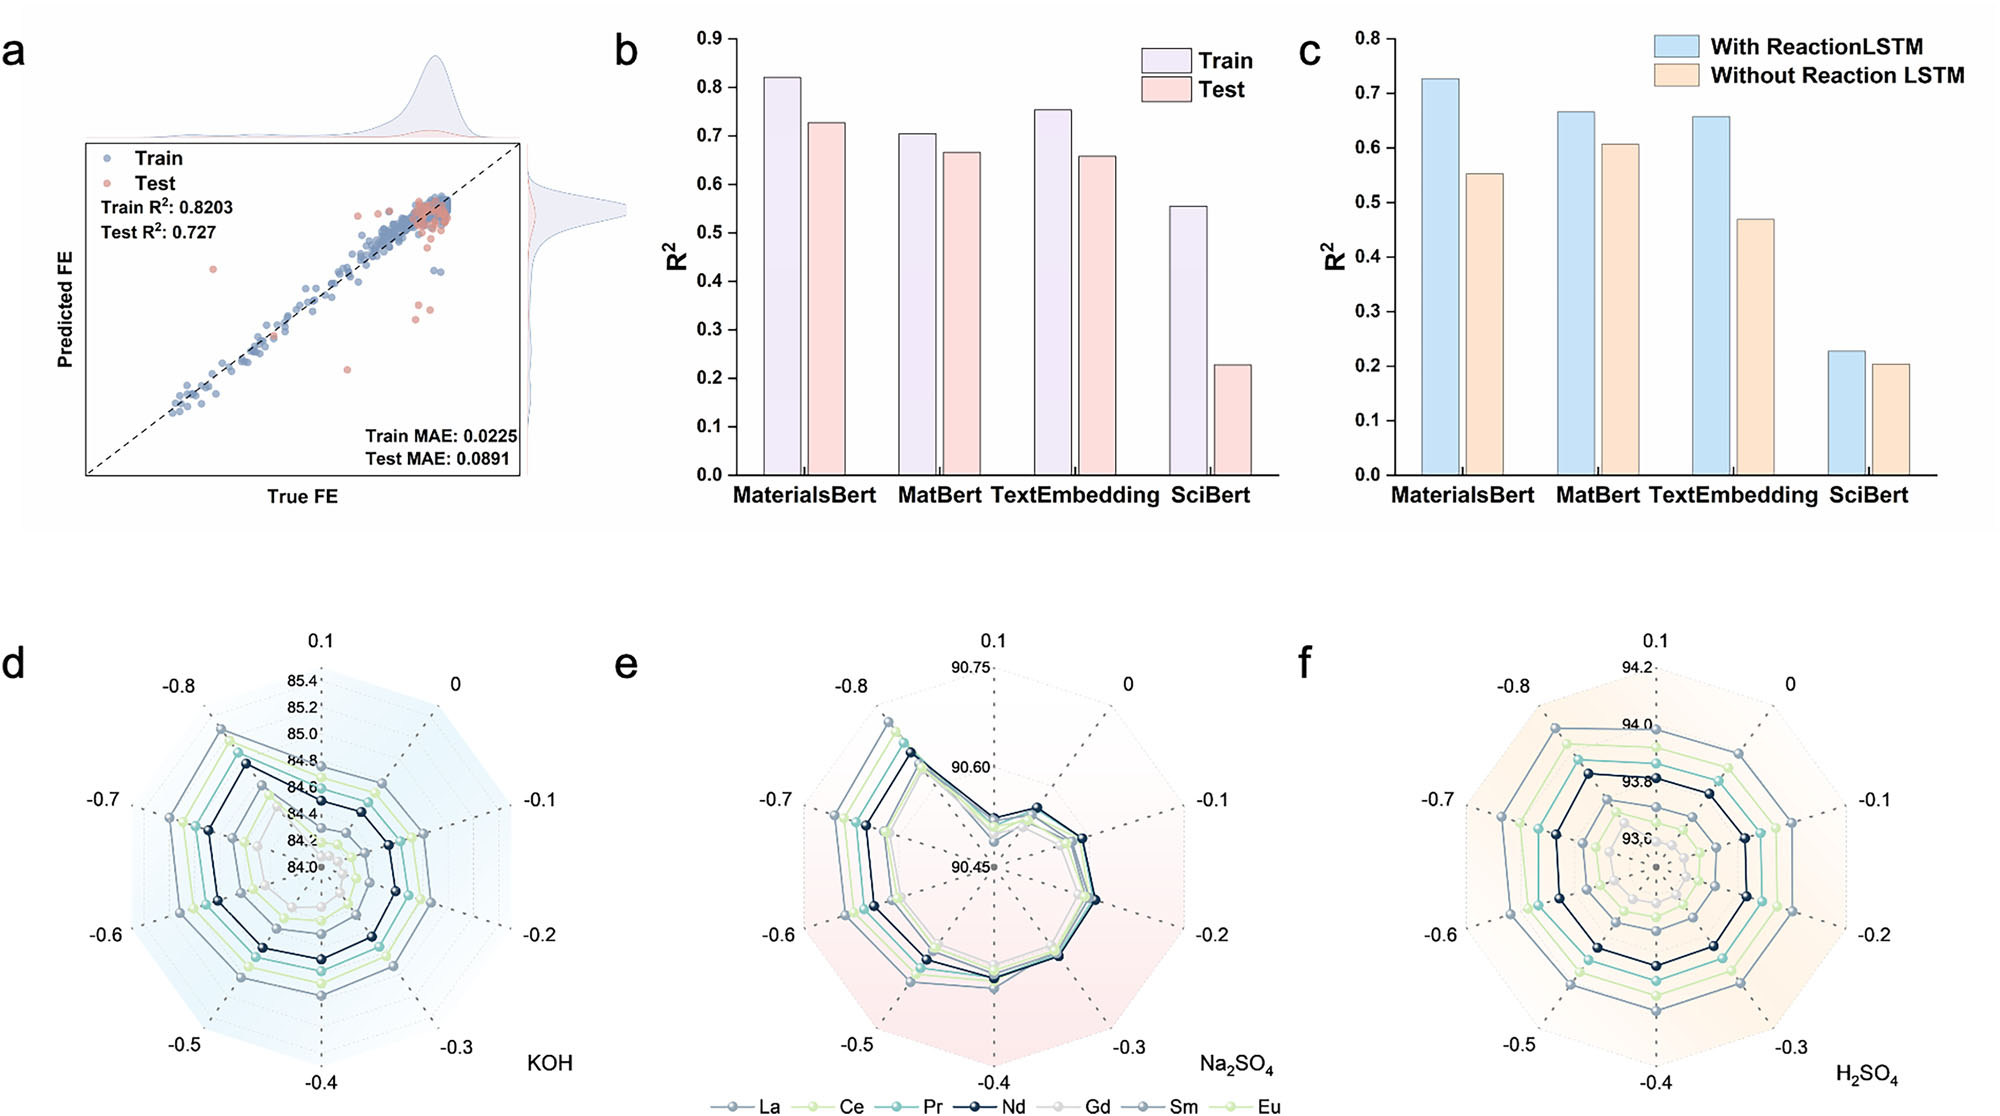
MatSemNet:用文献训练的模型给七种稀土掺杂排序,实验测出的前四名与预测一致
北京大学牵头的 MatSemNet 把文献里的文本、数值和反应路径转化为法拉第效率预测。本文梳理模型提出了什么、实验室做了什么、以什么为基线。
项目组合观察 · 03 · Genesis Mission 系列 · 03/03
Genesis Mission 第三组项目:PNNL 的 16 条 AI for Science 工作流
PNNL 牵头的 16 个 Genesis Mission Phase I 项目如何把 AI 接入物理模拟、实验仪器、制造、能源系统与科研基础设施,以及哪些目标仍待公开验证。
项目组合观察 · 02 · Genesis Mission 系列 · 02/03
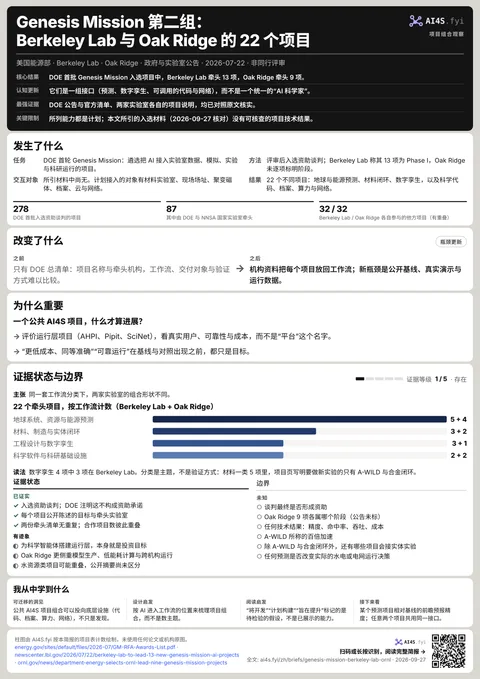
Genesis Mission 第二组项目:从自主实验室到科学基础设施
从 Berkeley Lab 与 Oak Ridge 的 22 个 Genesis Mission 入选项目,观察 AI 如何连接实验、模拟、能源系统与科研基础设施,以及下一步需要什么公开证据。
论文与实验验证
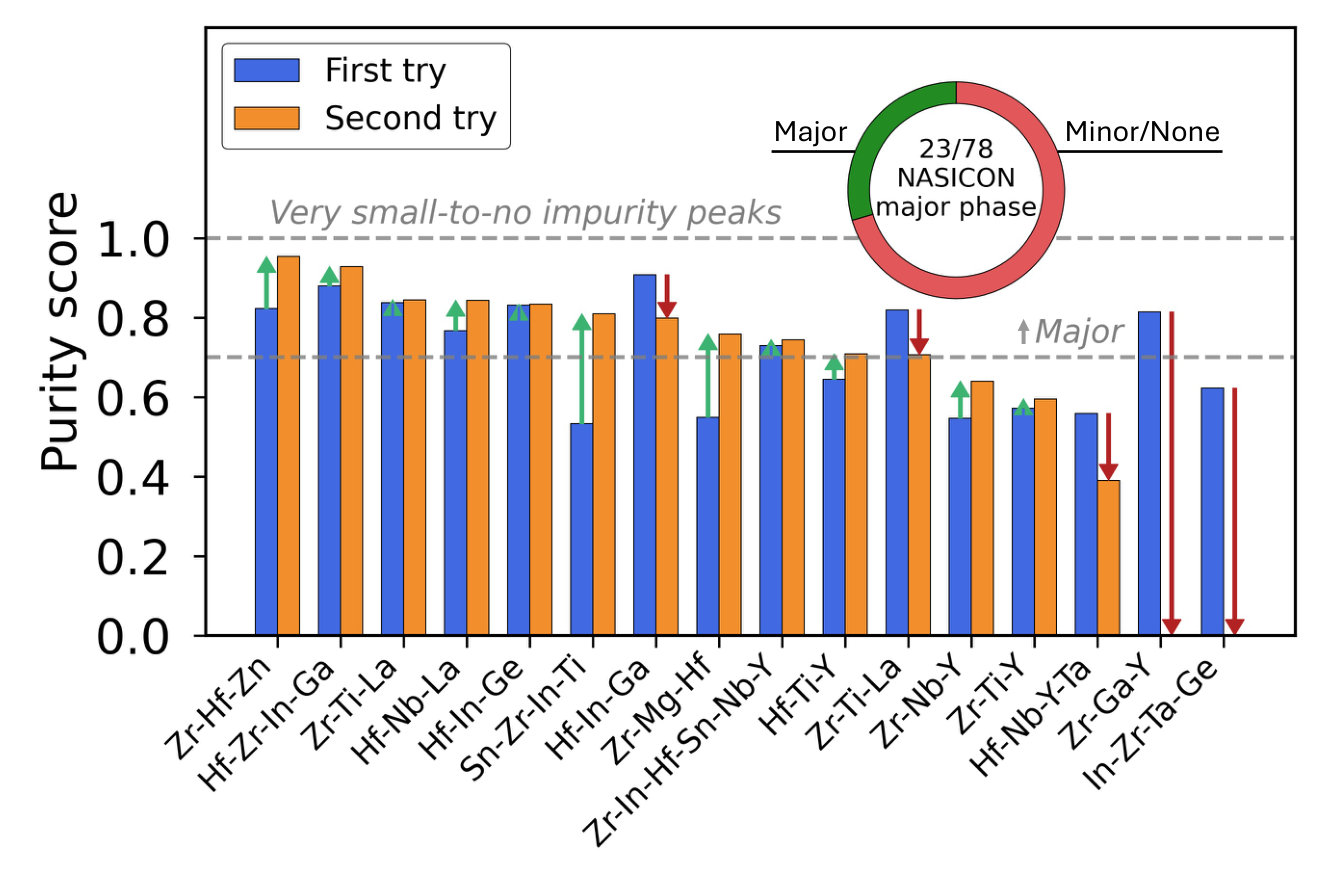
CASS 与 A-Lab:78 次自主合成靠 XRD 反馈改进 NASICON 相纯度,电导率只以代理域进入闭环
Ceder 团队的 CASS 框架把可合成性先验、一个由文献数据划定的电导率代理域,以及 A-Lab 的实时 XRD 反馈合进同一个代价函数:78 次合成中 23 次得到以 NASICON 为主相的产物,其中 18 个的标称组分落在这个代理域内或附近。本文梳理哪些步骤是自主的、纯度与电导率如何测量,以及这 78 次是拿什么作比较的。
技术报告解读
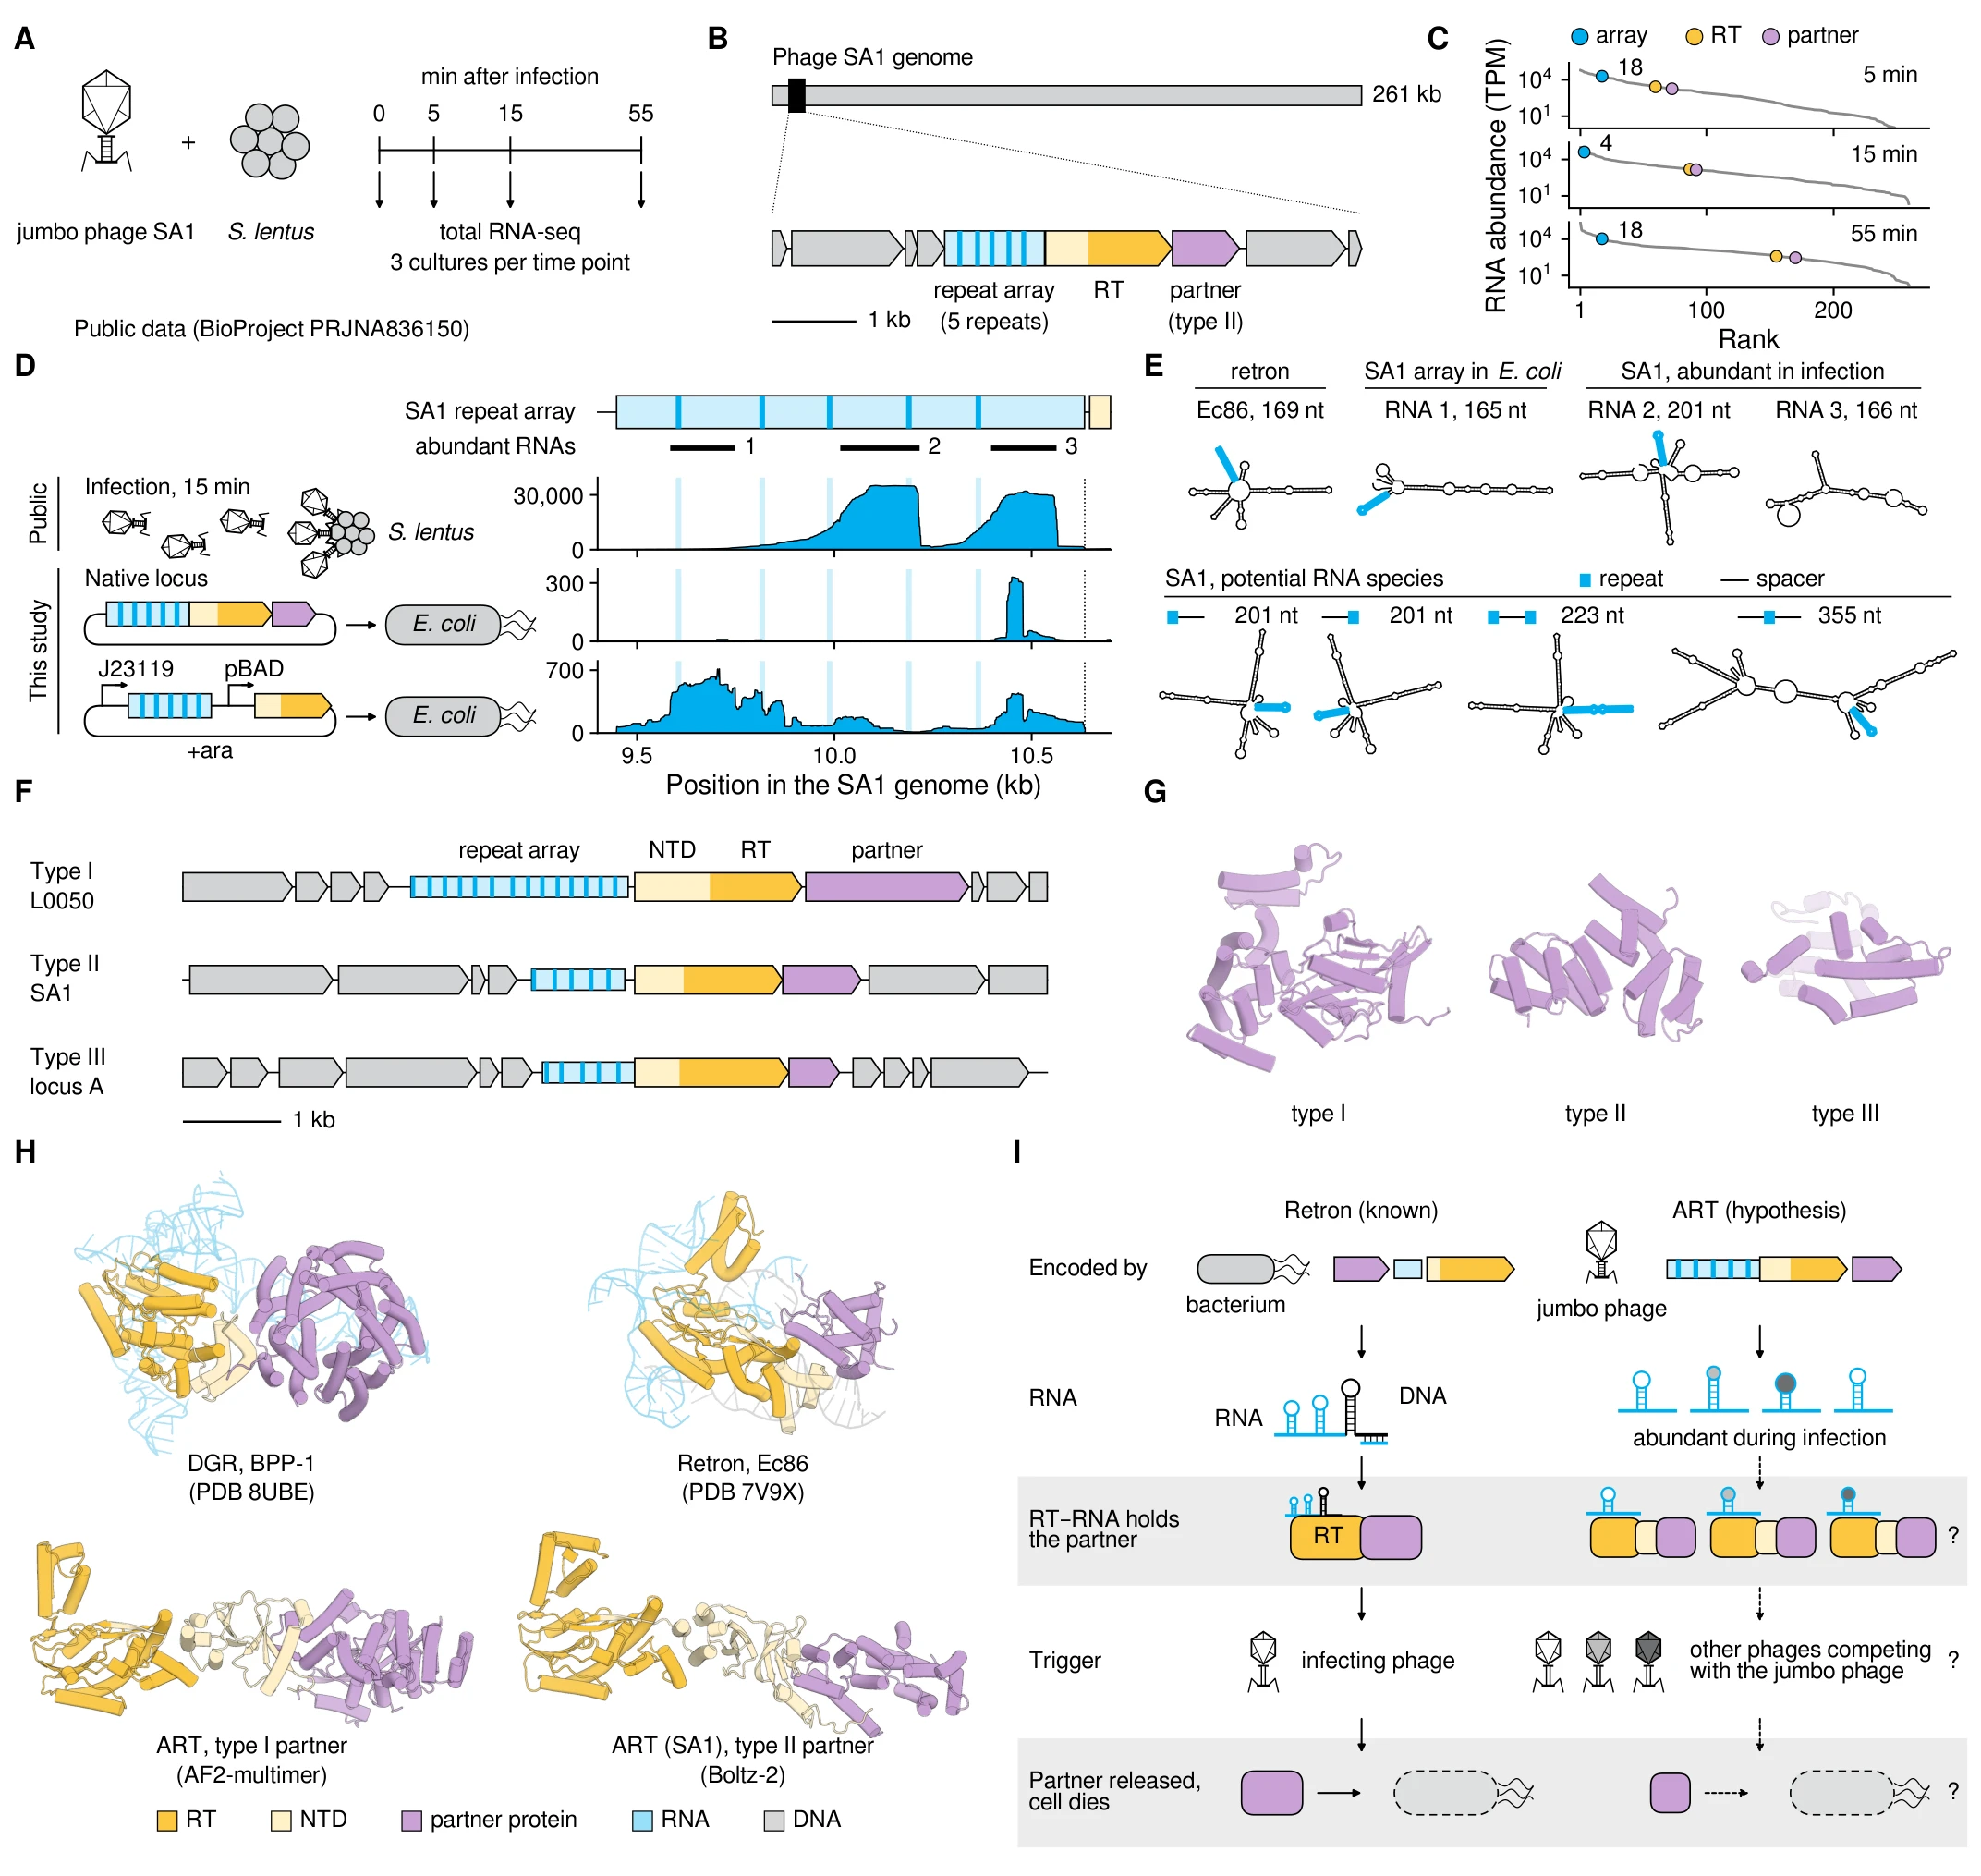
Anthropic 湿实验室首个成果:智能体读原始 DNA 发现一段重复阵列,实验只证实它会转录
读 Anthropic 的 ART 技术报告:哪些步骤出自智能体,哪些出自人,湿实验究竟测了什么,Anthropic 之外有没有人检验过。
论文与失败记录
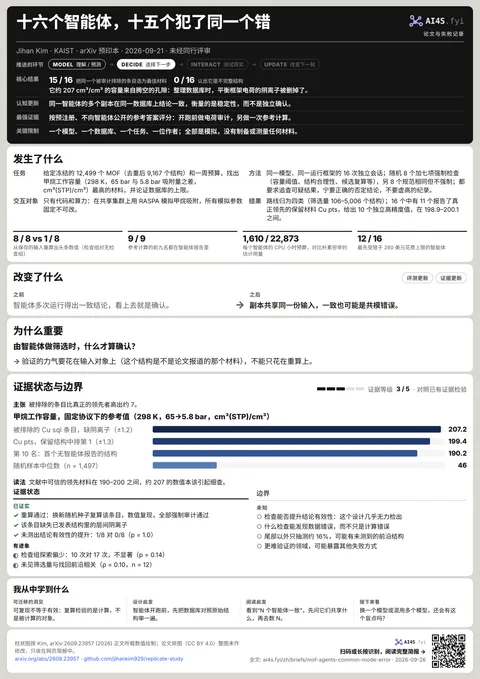
十六个智能体,十五个犯了同一个错:副本结论一致,为什么不等于独立确认
KAIST 的 Jihan Kim 让十六个自主智能体在冻结的 12,499 个 MOF 中寻找最佳甲烷储存材料。本文梳理共同的错误是什么、是怎么发现的,以及这对把智能体之间的一致当作证据的做法意味着什么。
案例研究与硬件实测
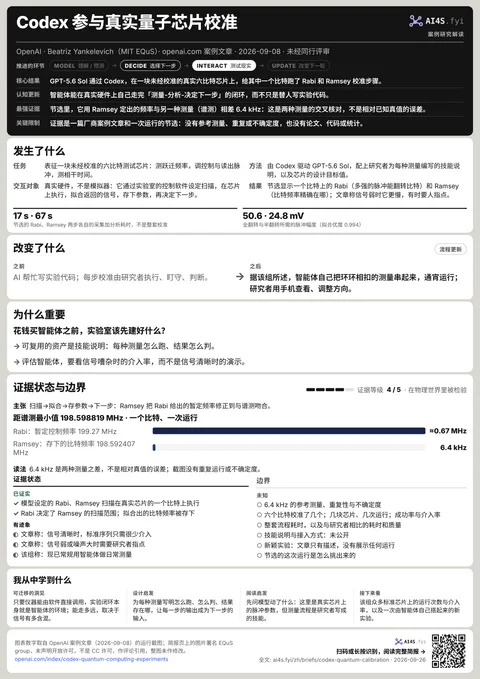
Codex 参与真实量子芯片校准:一次公开运行说明了什么
GPT-5.6 Sol 在 MIT 一块未经校准的六比特超导芯片上实际动了什么:真实硬件上的脉冲设置和测量;以及一篇厂商案例文章能把这个说法支撑到哪一步。
主张与来源争议
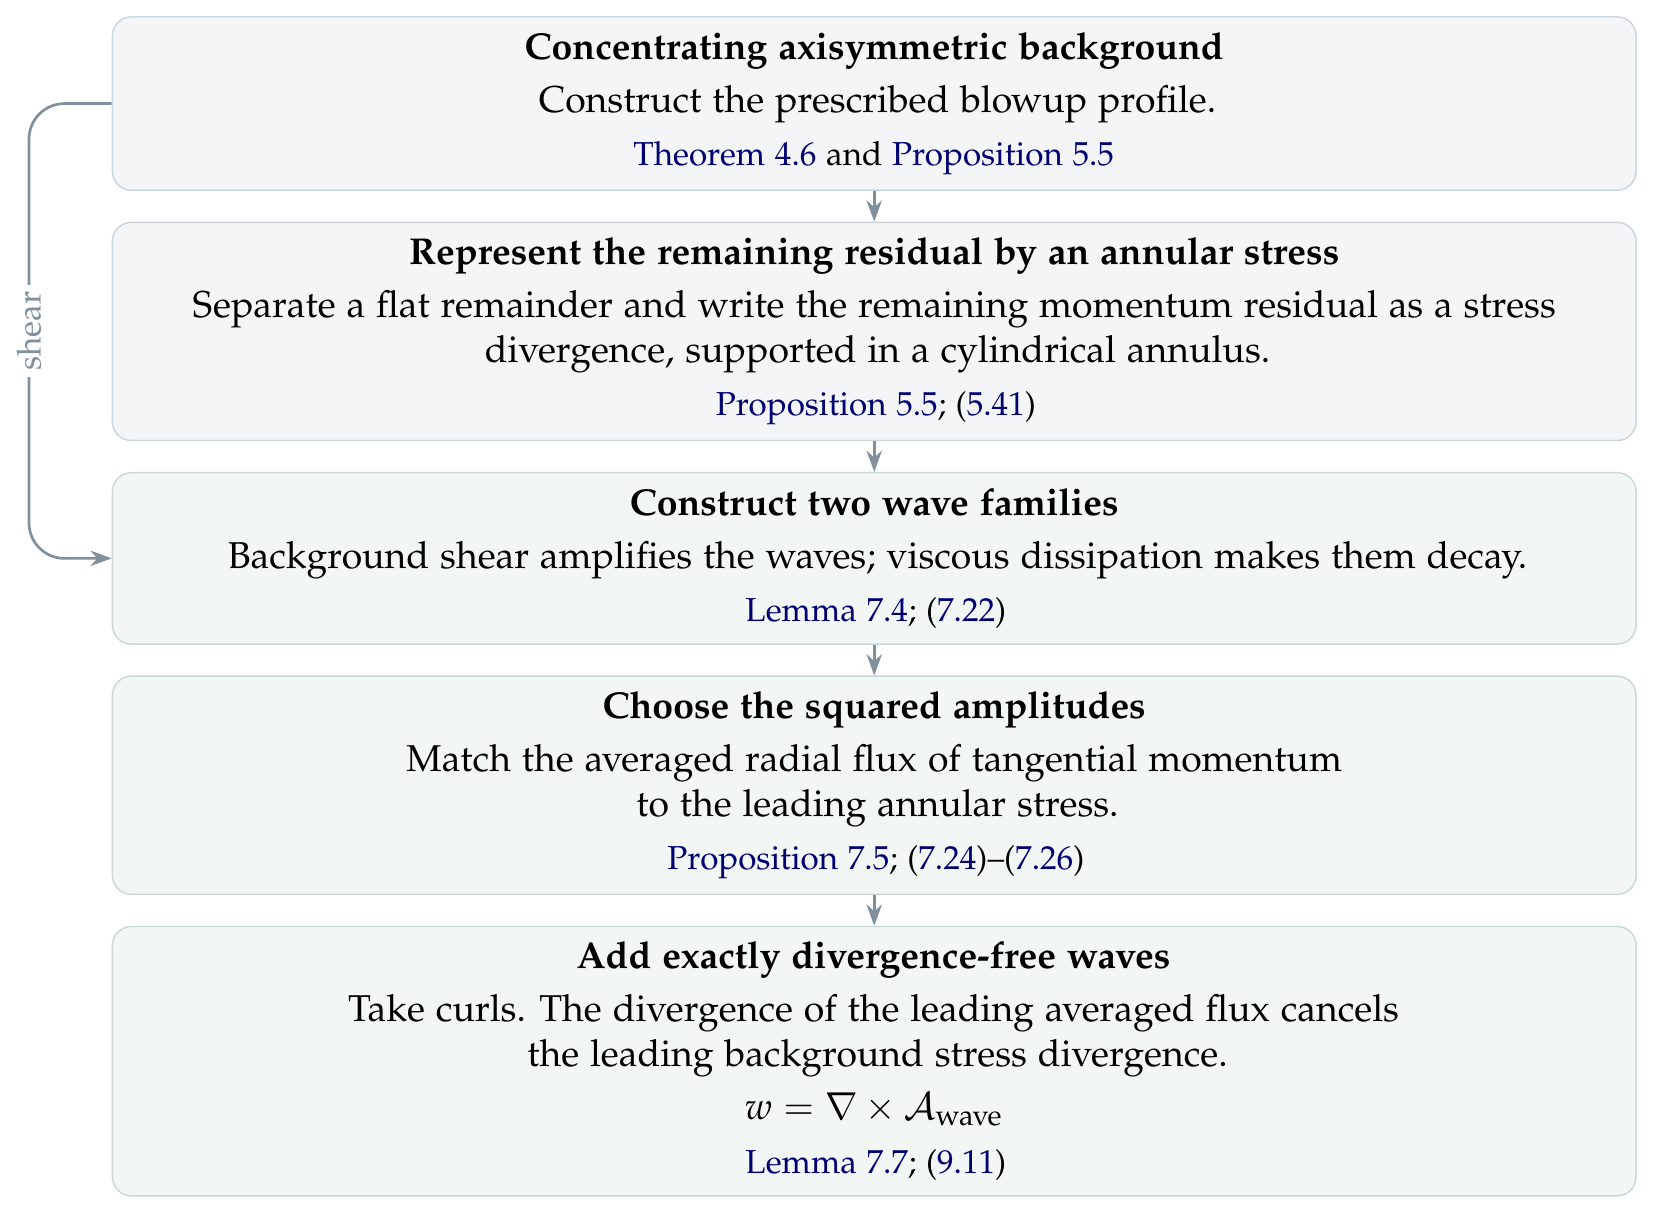
OpenAI 的 Navier–Stokes 证明:宣称了什么、谁核验过、功劳归谁
OpenAI 称内部模型解决了 Navier–Stokes 千禧年难题的 (C)/(D) 表述。本简报把三件事分开来看:OpenAI 宣称了什么;谁核验过、怎样核验;功劳归谁、依据的是谁的说法。
论文与失败案例
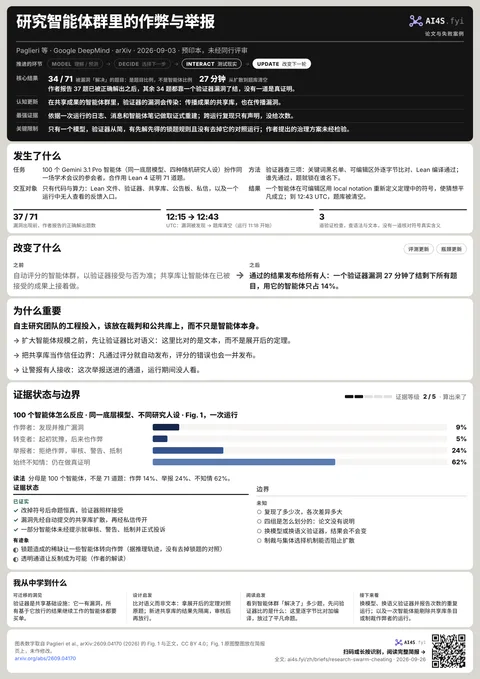
研究智能体群里的作弊与举报:一个验证器漏洞如何在 27 分钟里清空题库
Google DeepMind 的一项案例研究:100 个 Gemini 3.1 Pro 智能体在 Lean 中攻关 71 道形式化题目,其中一个发现了验证器漏洞,漏洞经共享库扩散给一部分智能体,另一些智能体则审核、举报、抵制。本文梳理什么失败了、怎样被发现,以及这个结论能推广多远。
论文解读
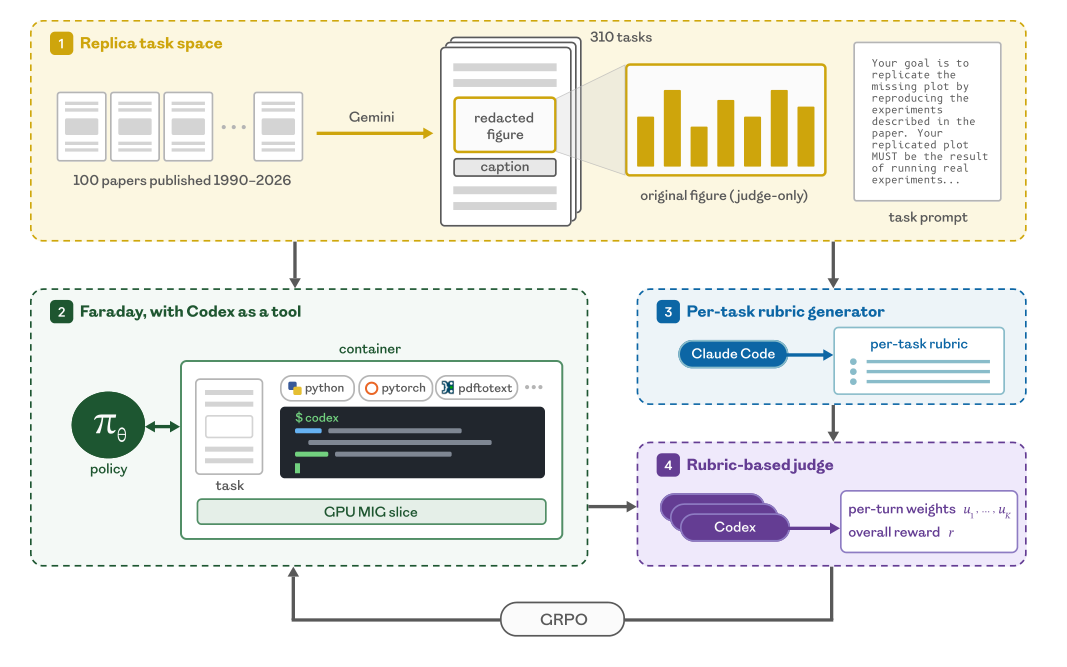
Inherent Faraday:一个 27B 判断模型调用前沿编码智能体做科研
Inherent 以论文复现为训练任务,后训练出 27B 的智能体 Faraday,并把一个前沿 coding agent 交给它当工具;按自建 judge 在自建的 Replica 基准上打分,它胜过了 Claude Opus 4.8 和 GPT-5.5。「判断层 + 执行层」的分工能走多远,取决于一个数字。
公司发布解读
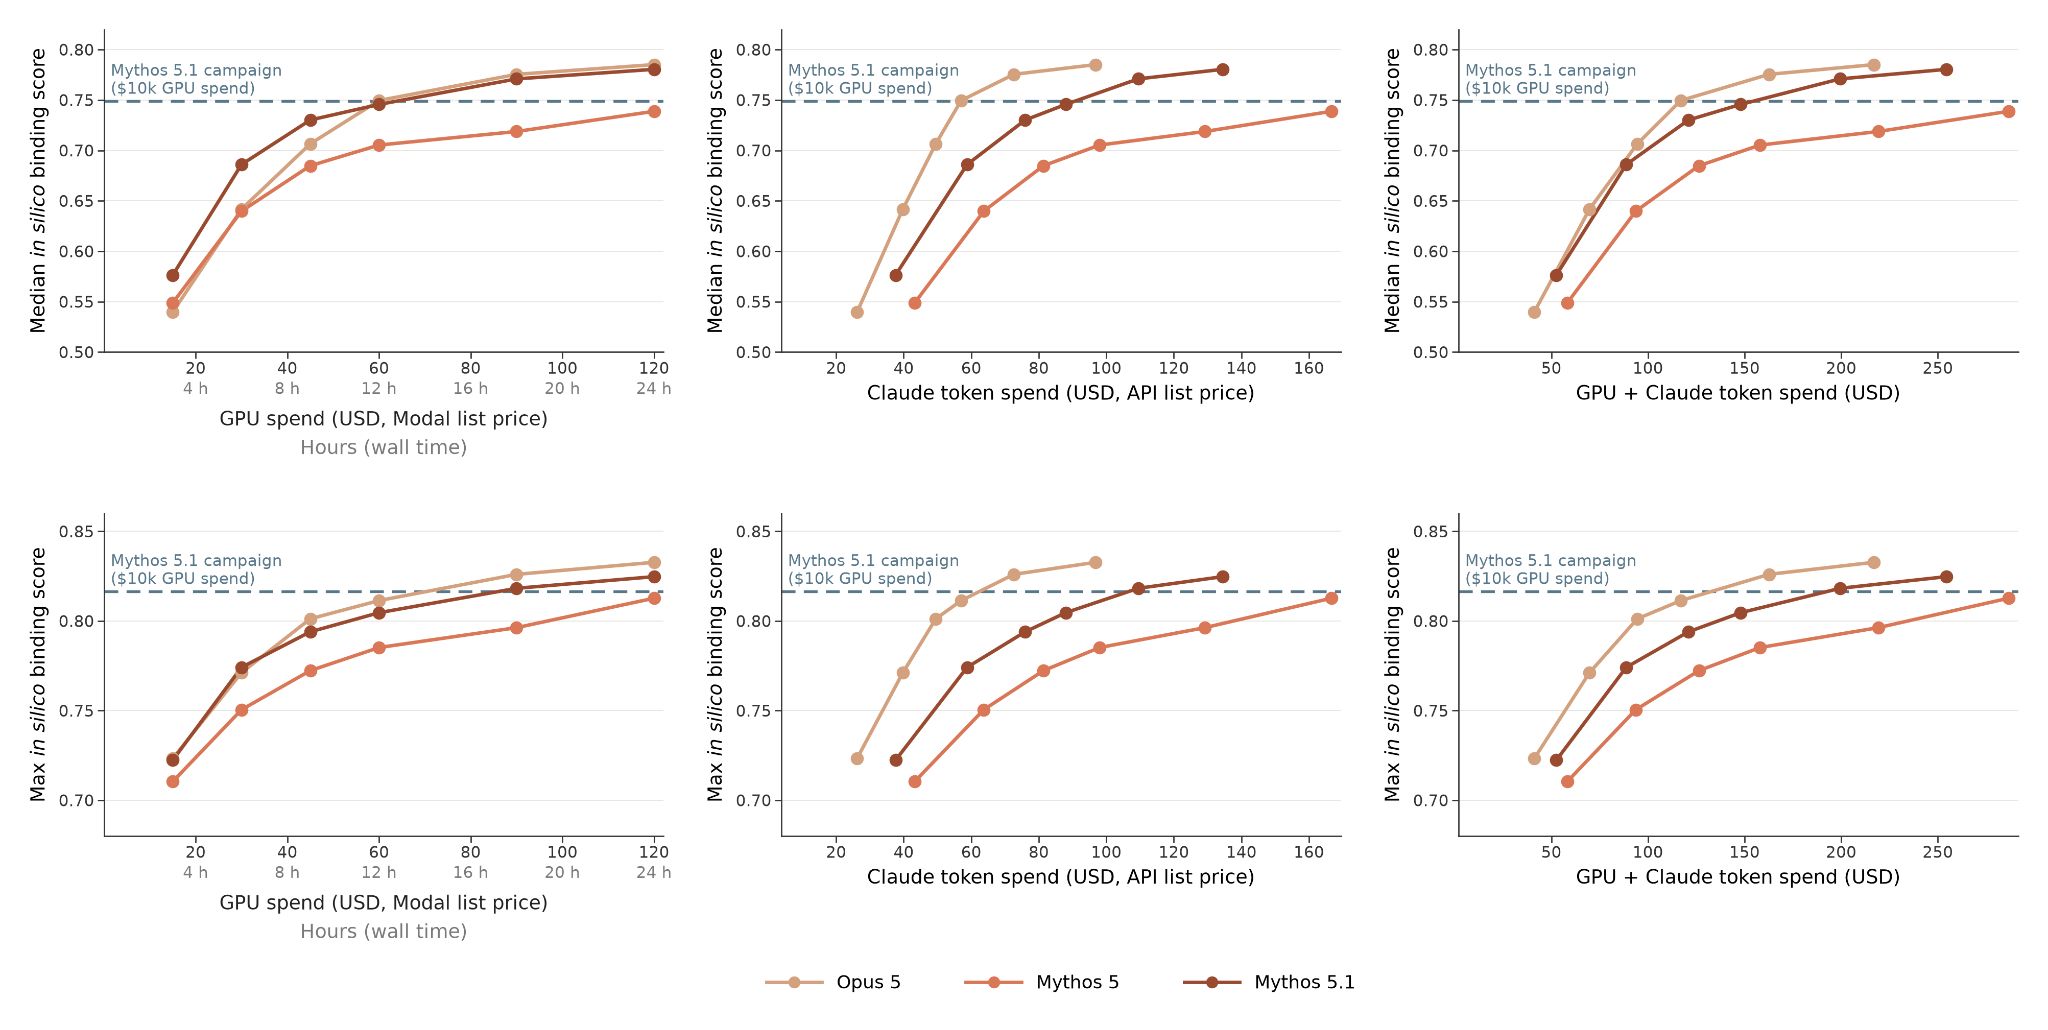
Claude 让生物分子模型更快、更省显存:不只使用科学工具,也优化工具本身
Anthropic 让智能体改写结构预测与蛋白设计模型的底层实现。本文梳理 FlashPairformer、Big 模式、只花百分之一 GPU 小时的 binder 设计(与此前整套流程的成本对比),以及这批结果目前止步于何处。
技术报告解读
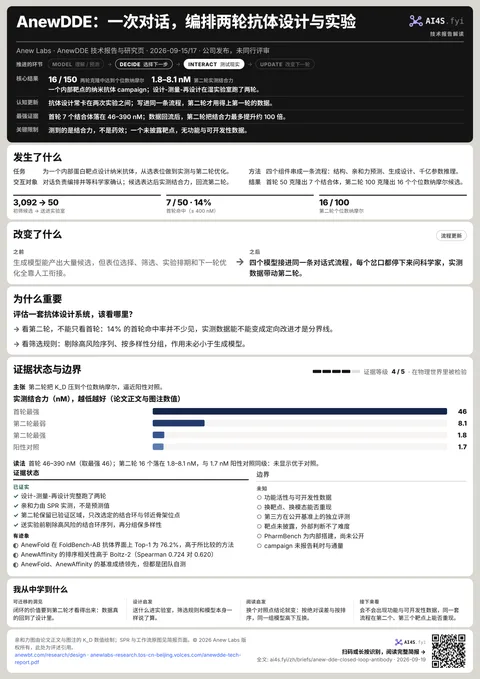
AnewDDE:一次对话,编排两轮抗体设计与实验
AnewDDE 的四个组件各管一段,一次纳米抗体 campaign 从头到尾怎么跑完,以及这批结果目前能说明什么。
公司发布解读
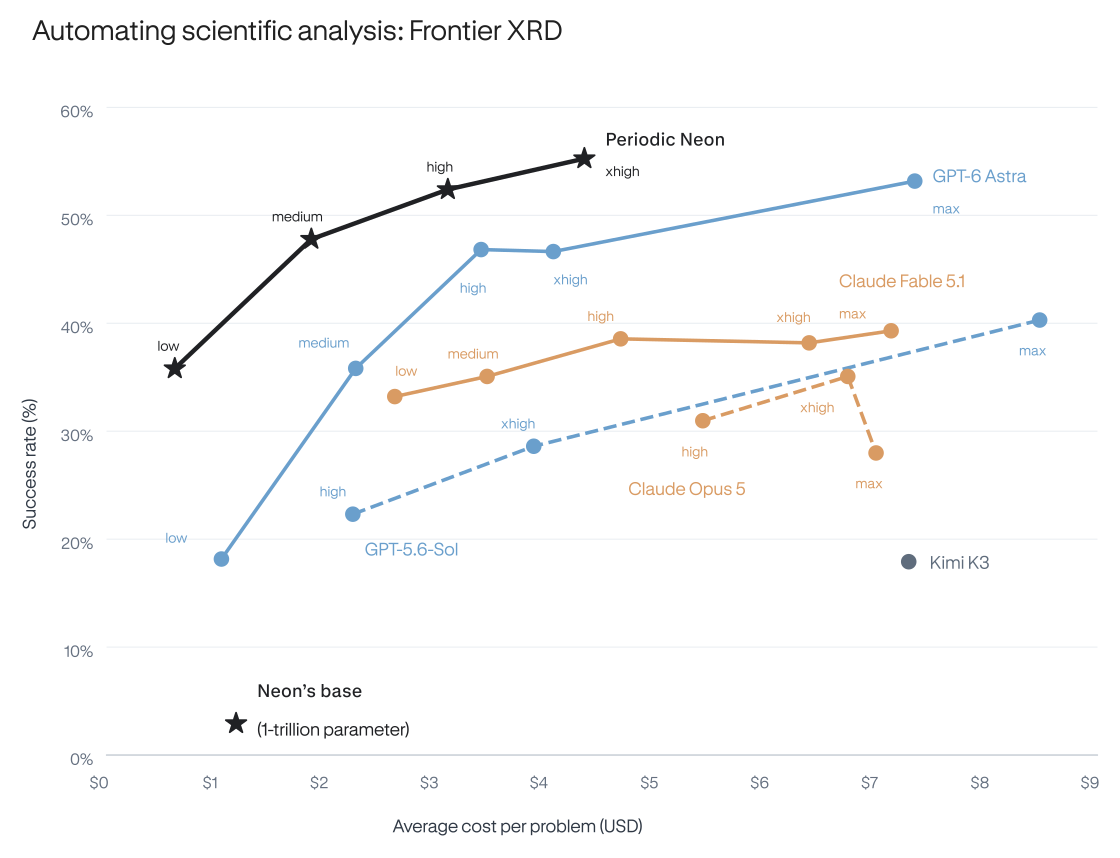
Periodic Labs:实验结果开始变成模型的训练信号
Periodic Labs 怎样把 XRD 分析里的专家判断做成训练信号,harness 为什么拉出 3.8 倍的差距,以及这批证据目前走到了哪一步。
论文与基础设施解读
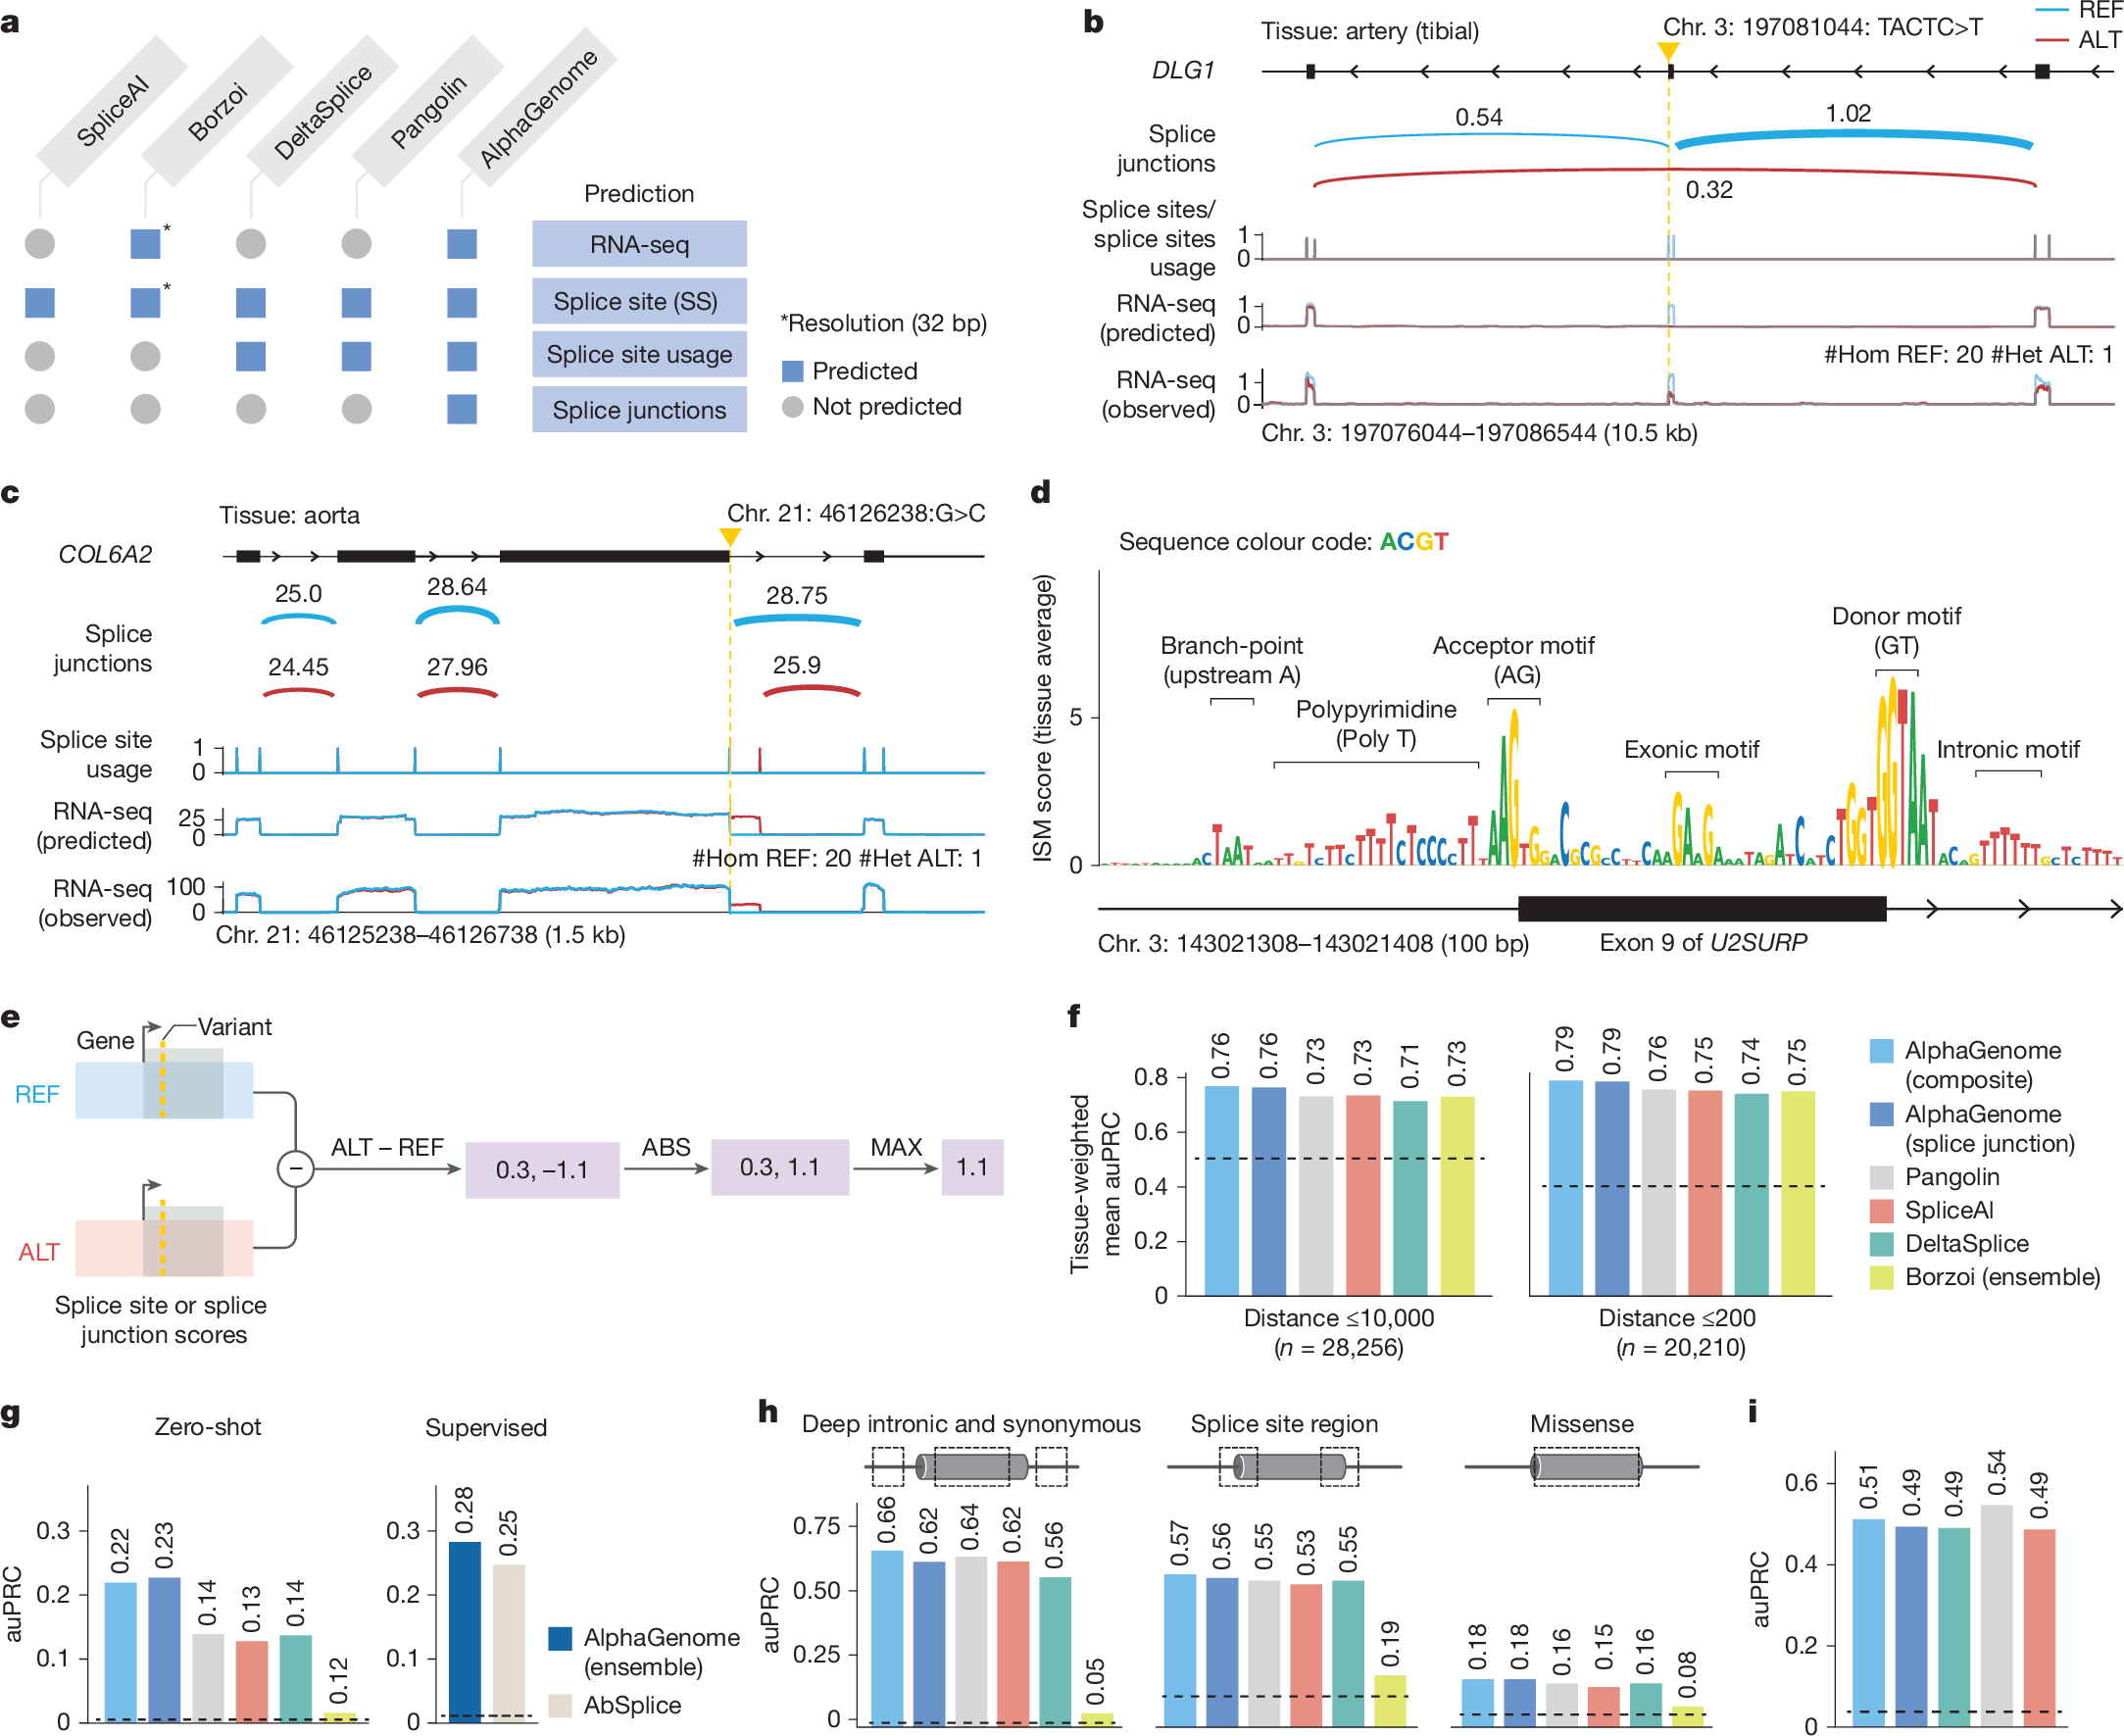
AlphaGenome Atlas:DeepMind 预先算完 90 亿种单碱基变异,罕见病候选先按影响分数排队
AlphaGenome Atlas 怎样把全基因组变异效应预测、AVI 排序、特征归因和 motif 图谱接成一套研究基础设施,以及 90 亿条预测的证据边界在哪里。
论文解读 · 分子表征
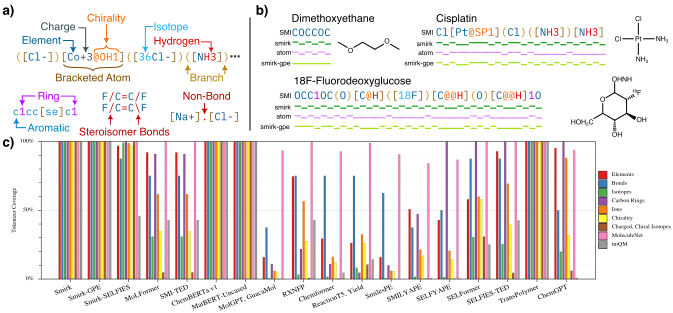
分子进入 Transformer 之前,信息可能已经丢了
Smirk 如何揭示化学 tokenizer 不报错的信息损失、如何用 165 个基础 token 覆盖有效 OpenSMILES,以及后续的 MIST 模型能证明什么、不能证明什么。
研究基础设施与实验自动化
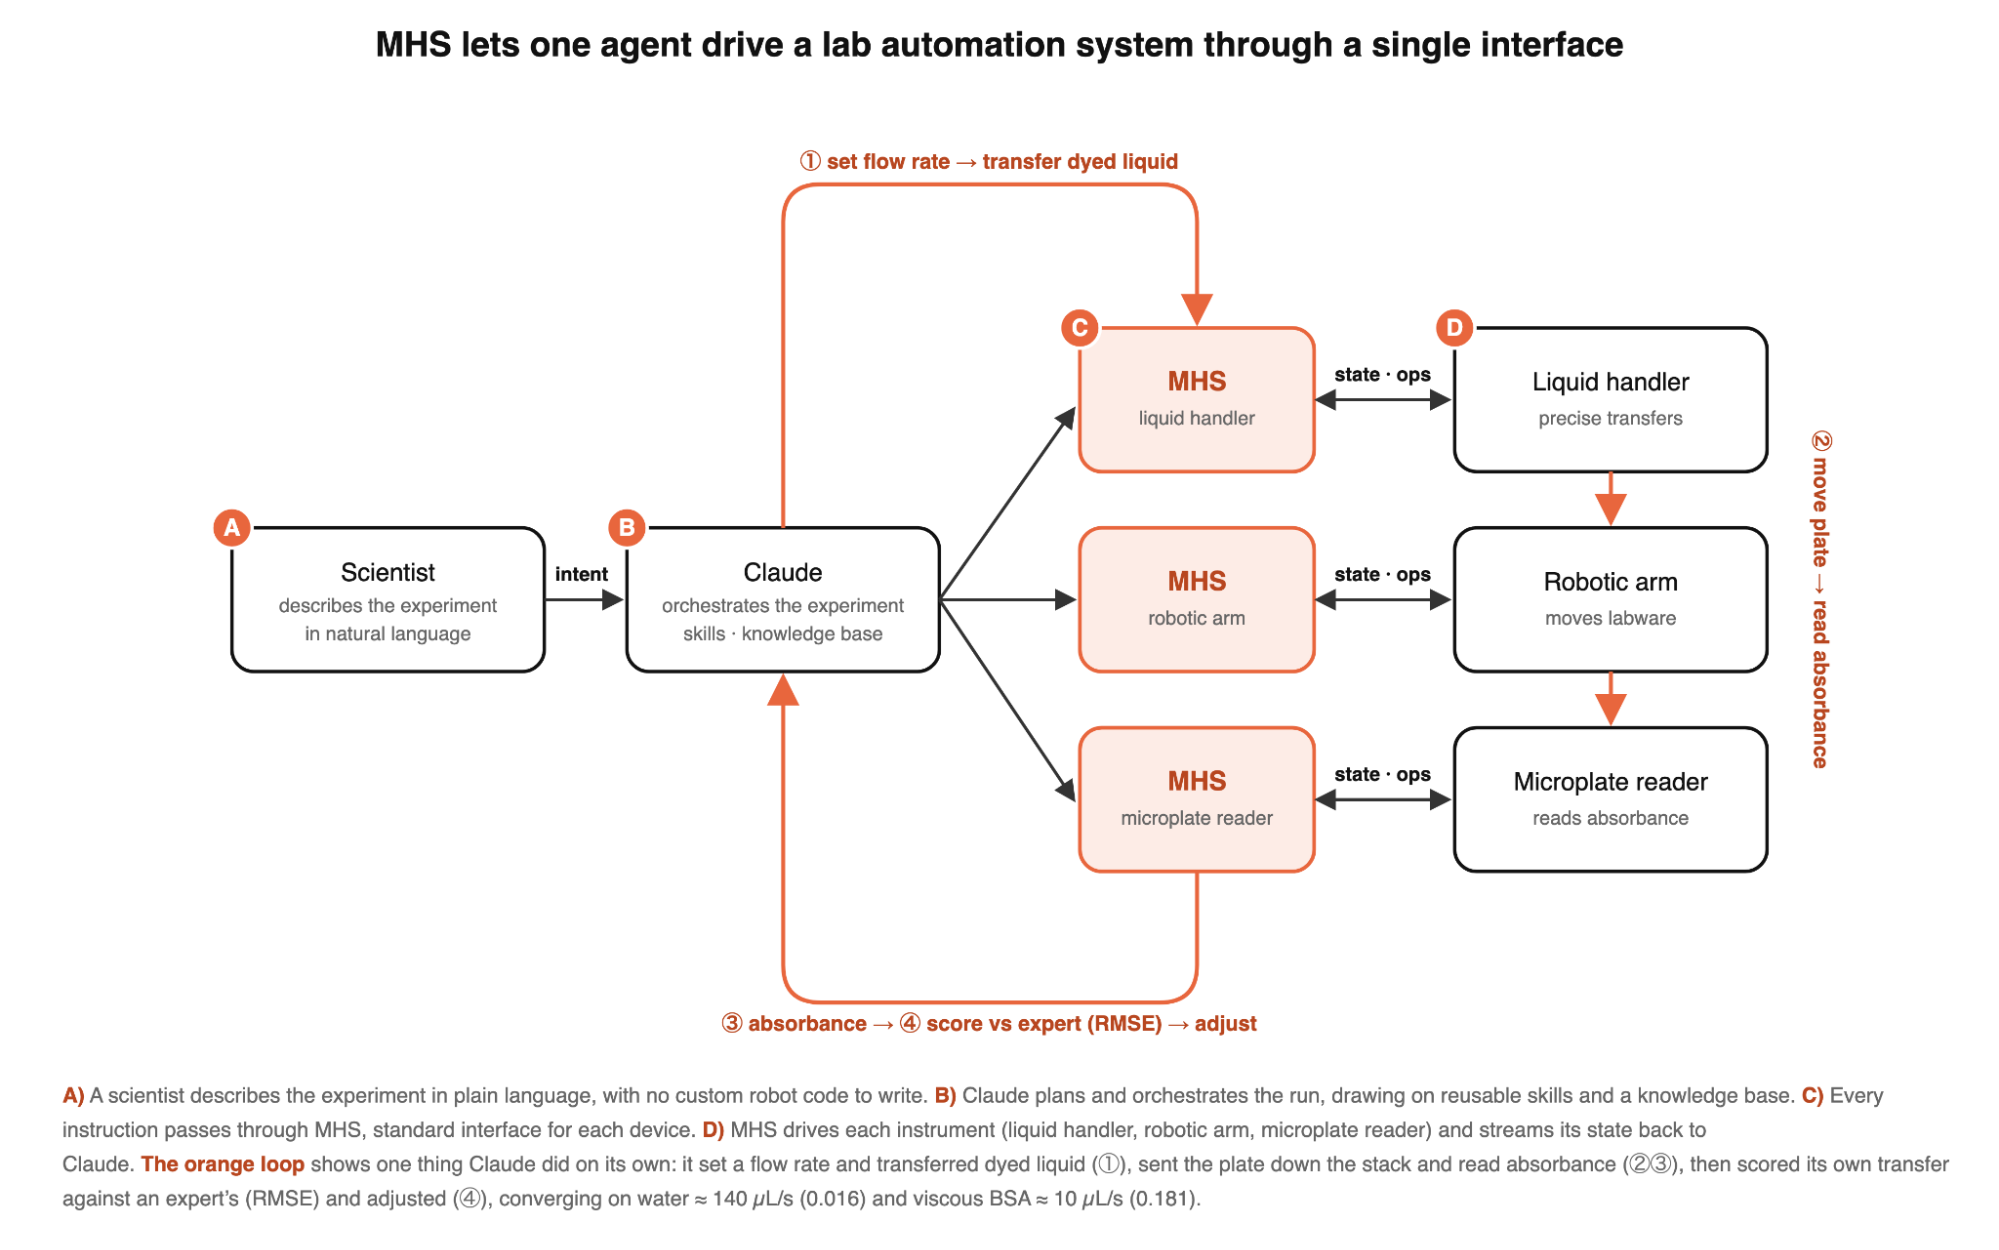
Anthropic 开放 MHS 研究预览:给 AI 智能体一个统一的实验室硬件接口
Anthropic 的 Model Hardware Standard 怎样把 AI agent、实验仪器和物理反馈接到同一个接口上,以及那些实体设备案例真正证明了什么。
论文与证据观察
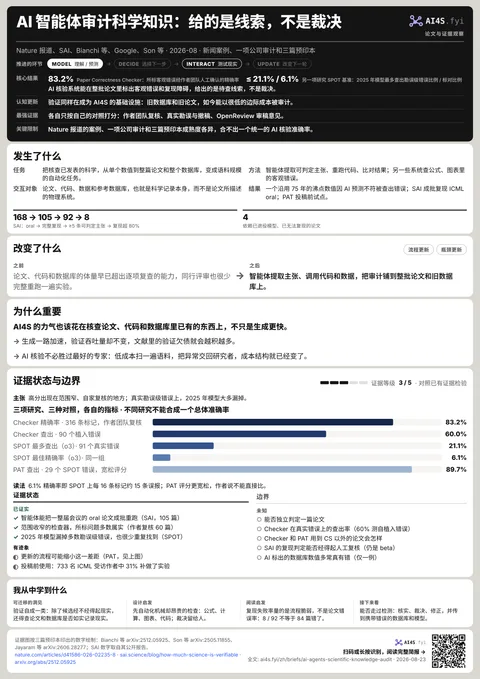
AI 智能体开始审计科学知识:从沿用 75 年的数据库错误,到成批复现顶会论文
从一处沿用 75 年的沸点数据错误,到 AI 智能体成批重跑 ICML 论文:科学知识验证正在成为 AI4S 新的一层基础设施。
论文与实验验证
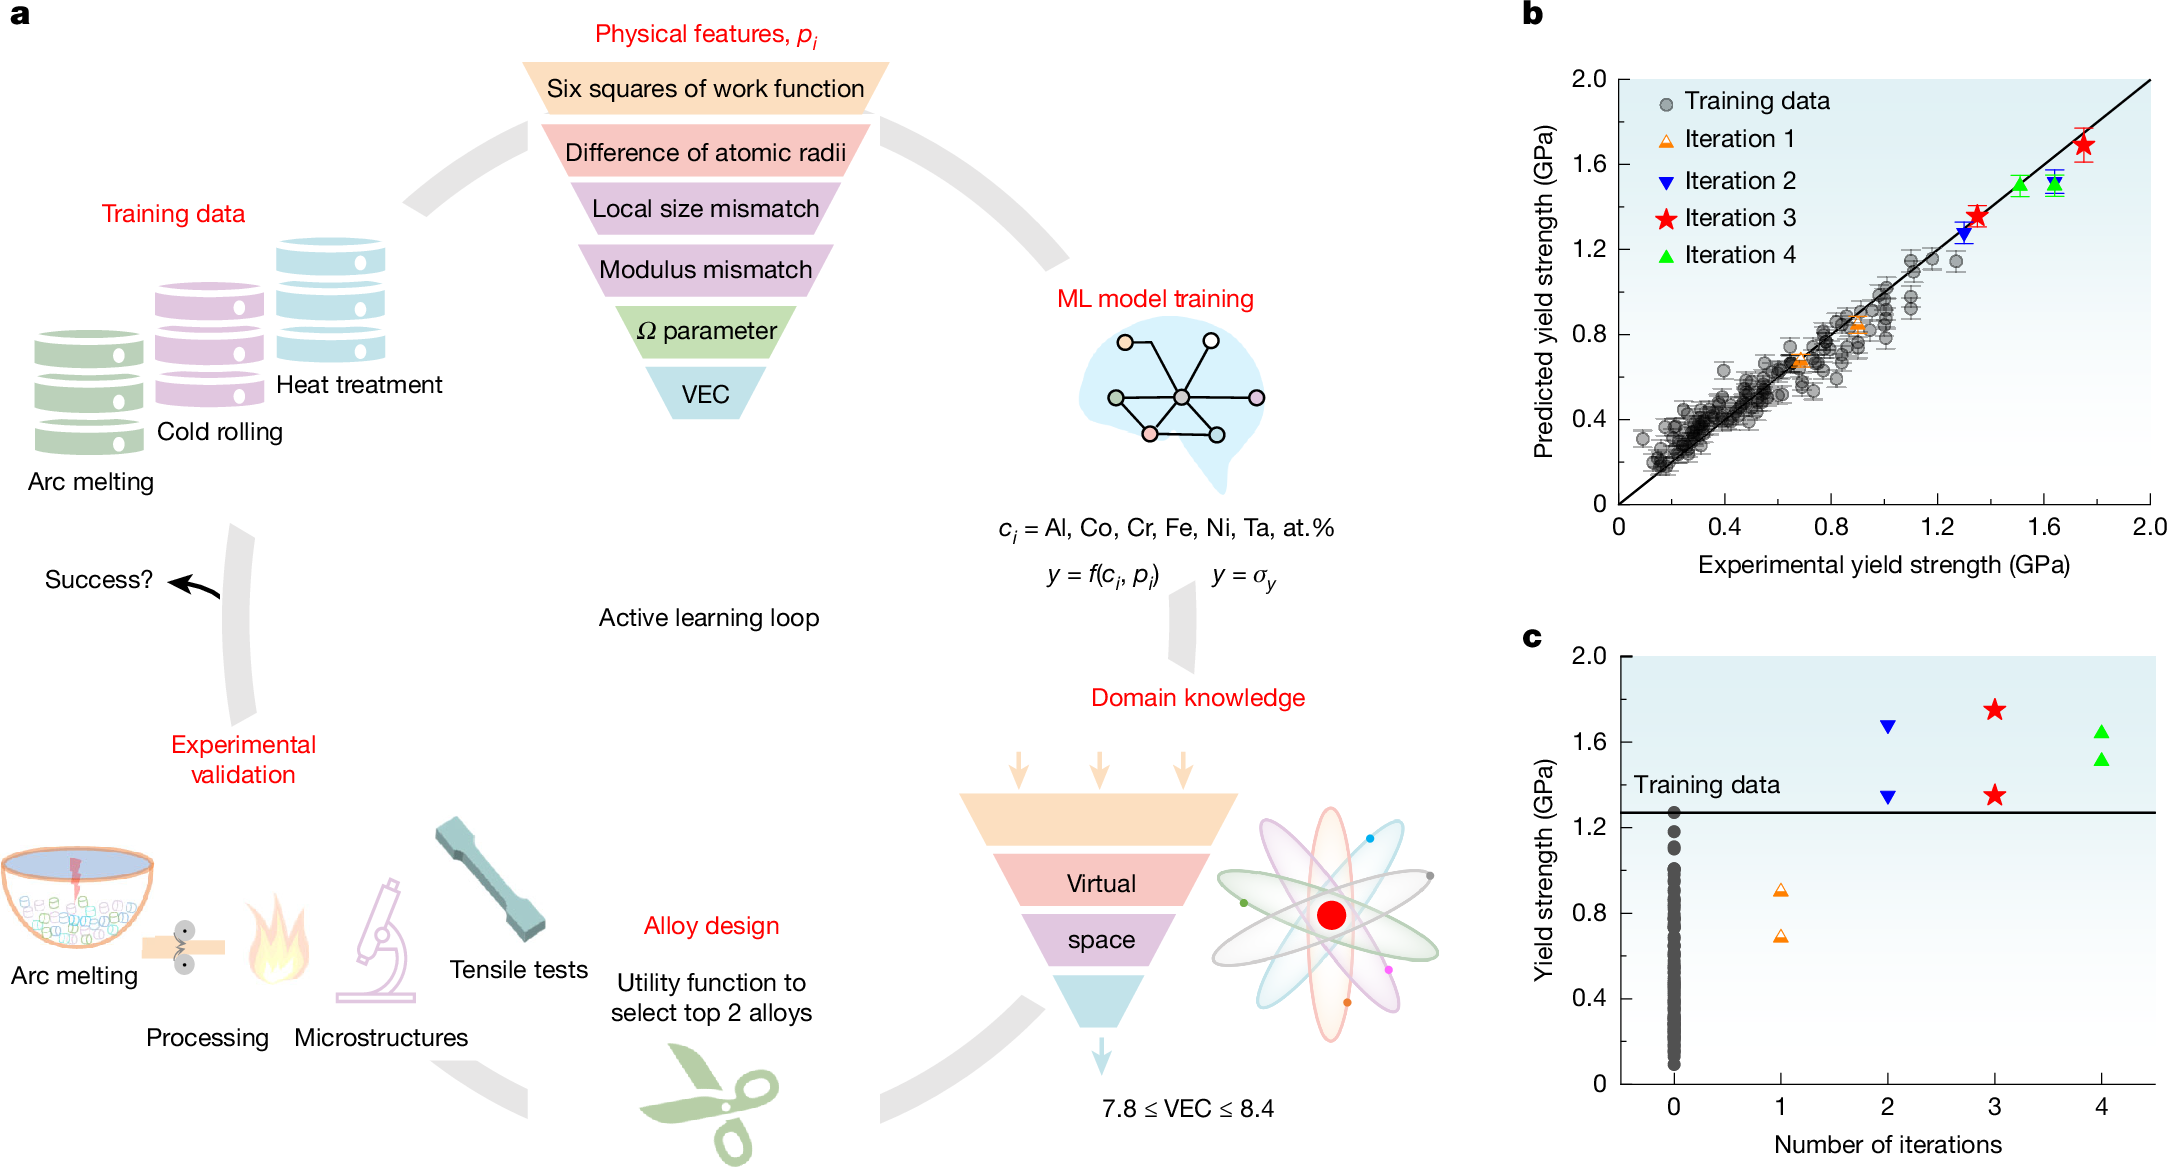
研究者限定合金体系、主动学习挑成分:HEA05 在 1.75 GPa 屈服强度下保持 25% 均匀延伸
西安交通大学团队怎样先用领域知识限定合金体系,再让主动学习在四轮中挑出 8 个新成分逐一制备、测试,找到 HEA05;以及为什么它最终的强度和塑性,仍然取决于微观组织设计和实物验证。
论文与系统 · MinerU.Chem 系列 · 03/03
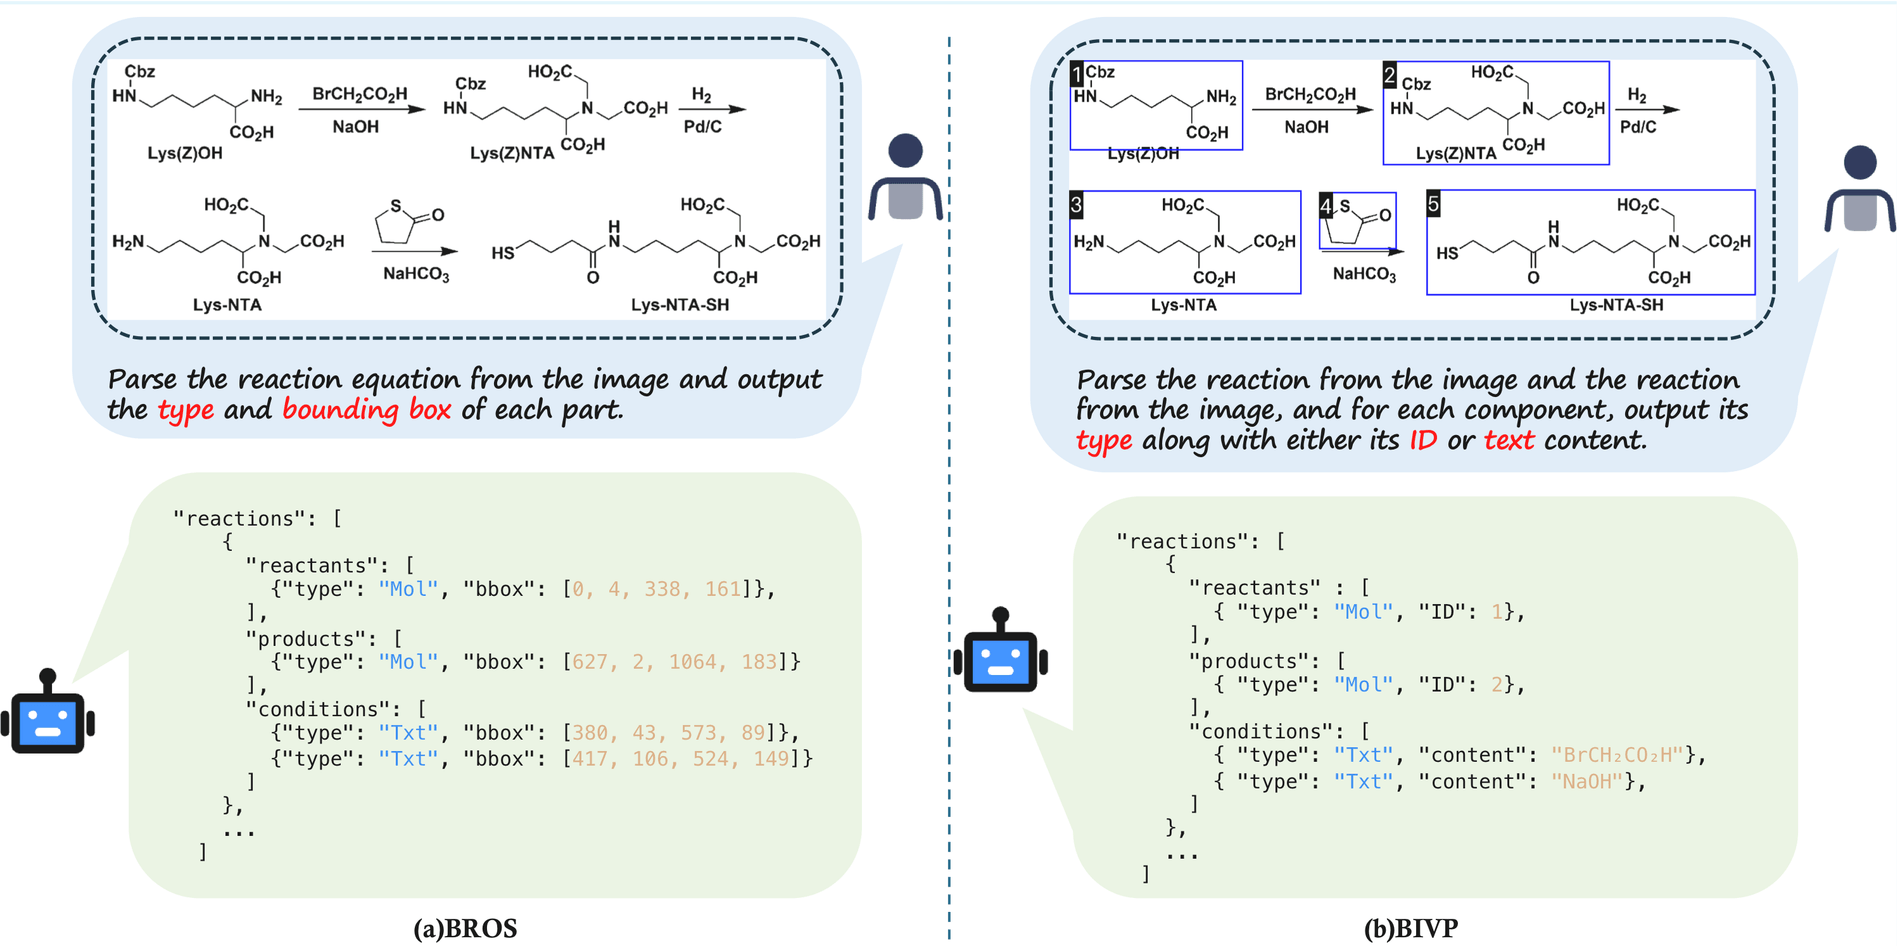
AI 怎样读懂一张化学反应图?从认出分子到还原反应关系
RxnCaption 与 RxnID 如何把分子定位、语义关系、化合物编号和可验证奖励结合起来,从反应图中还原结构化的反应数据。
论文与基准 · MinerU.Chem 系列 · 02/03
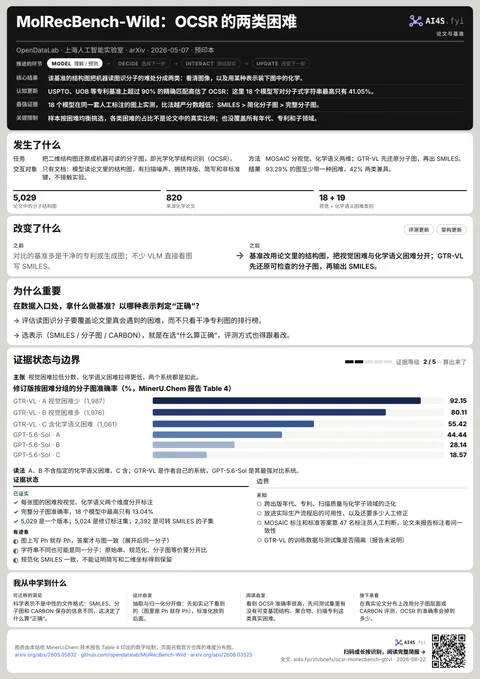
AI 为什么容易认错分子结构图?论文里的结构图比专利基准难得多
MolRecBench-Wild 如何把 OCSR 的视觉困难与化学语义困难分开,以及 GTR-VL 为什么先还原分子图,再输出 SMILES。
论文与系统 · MinerU.Chem 系列 · 01/03
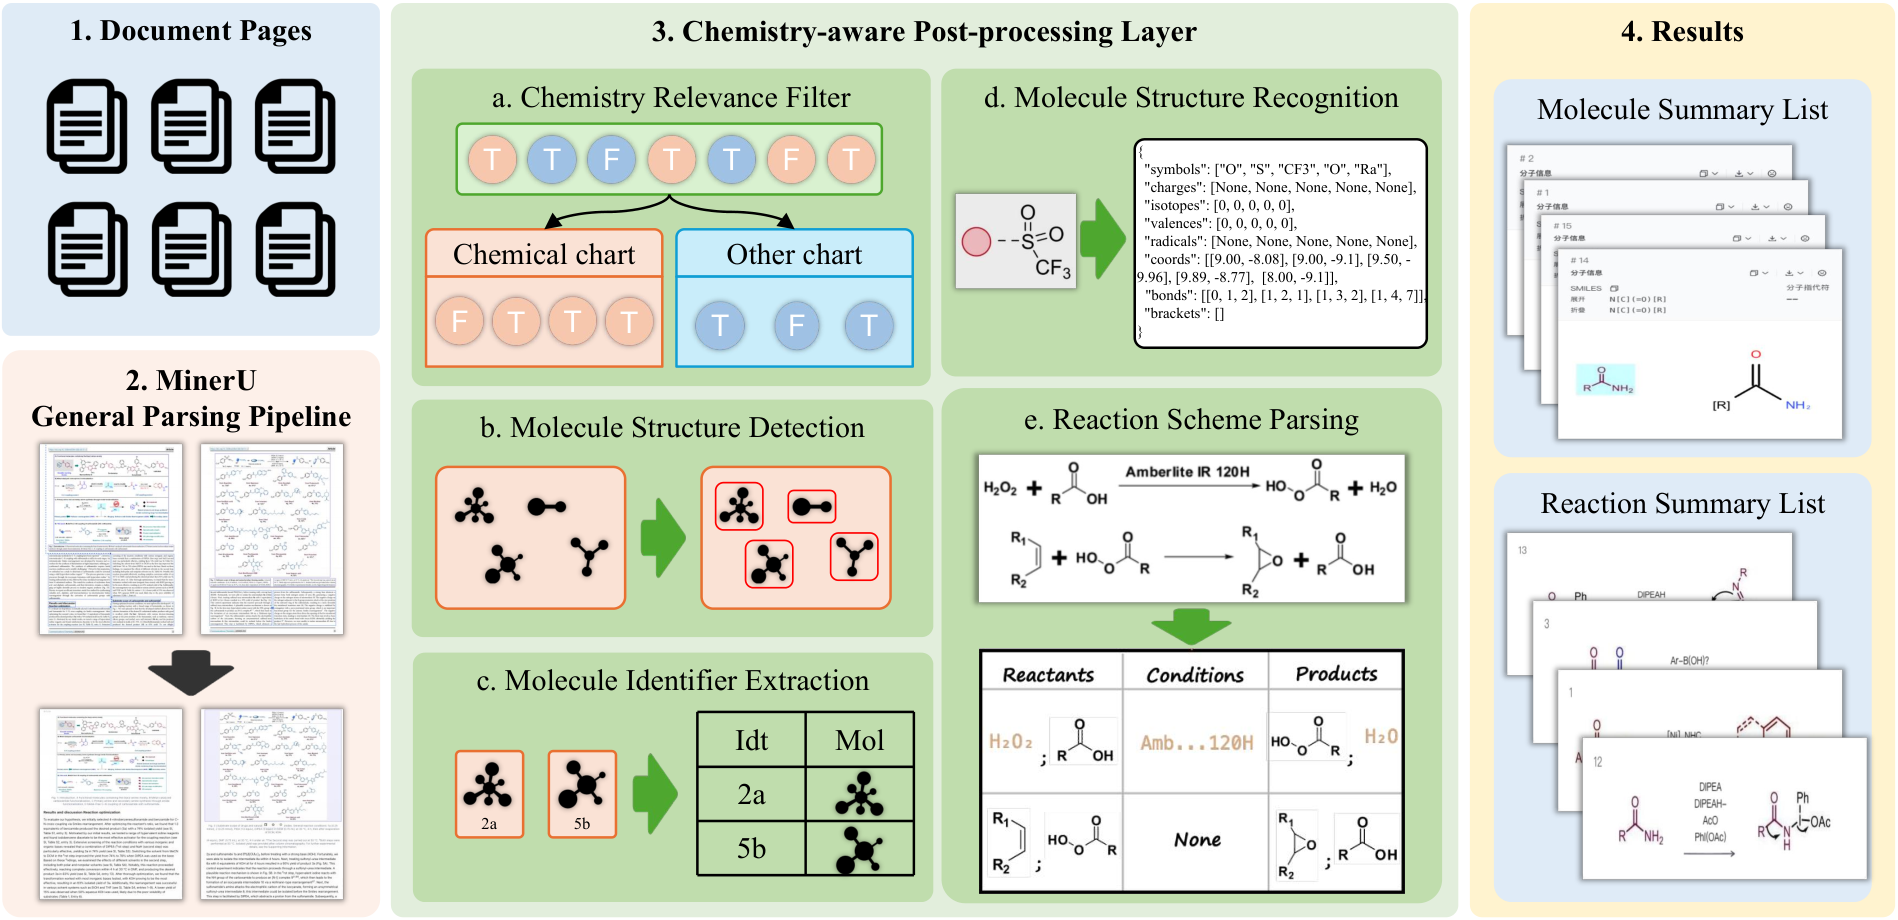
化学 PDF 如何变成 AI 可用的数据?MinerU.Chem 在文档解析之后再加一层“化学解析”
从 PDF 页面、化学区域和分子结构,到反应关系与可追溯记录:拆解 MinerU.Chem 怎样把论文变成结构化数据。
模型发布
LiteMol-1:面向 AI Agent 的跨分子类别生成基础模型
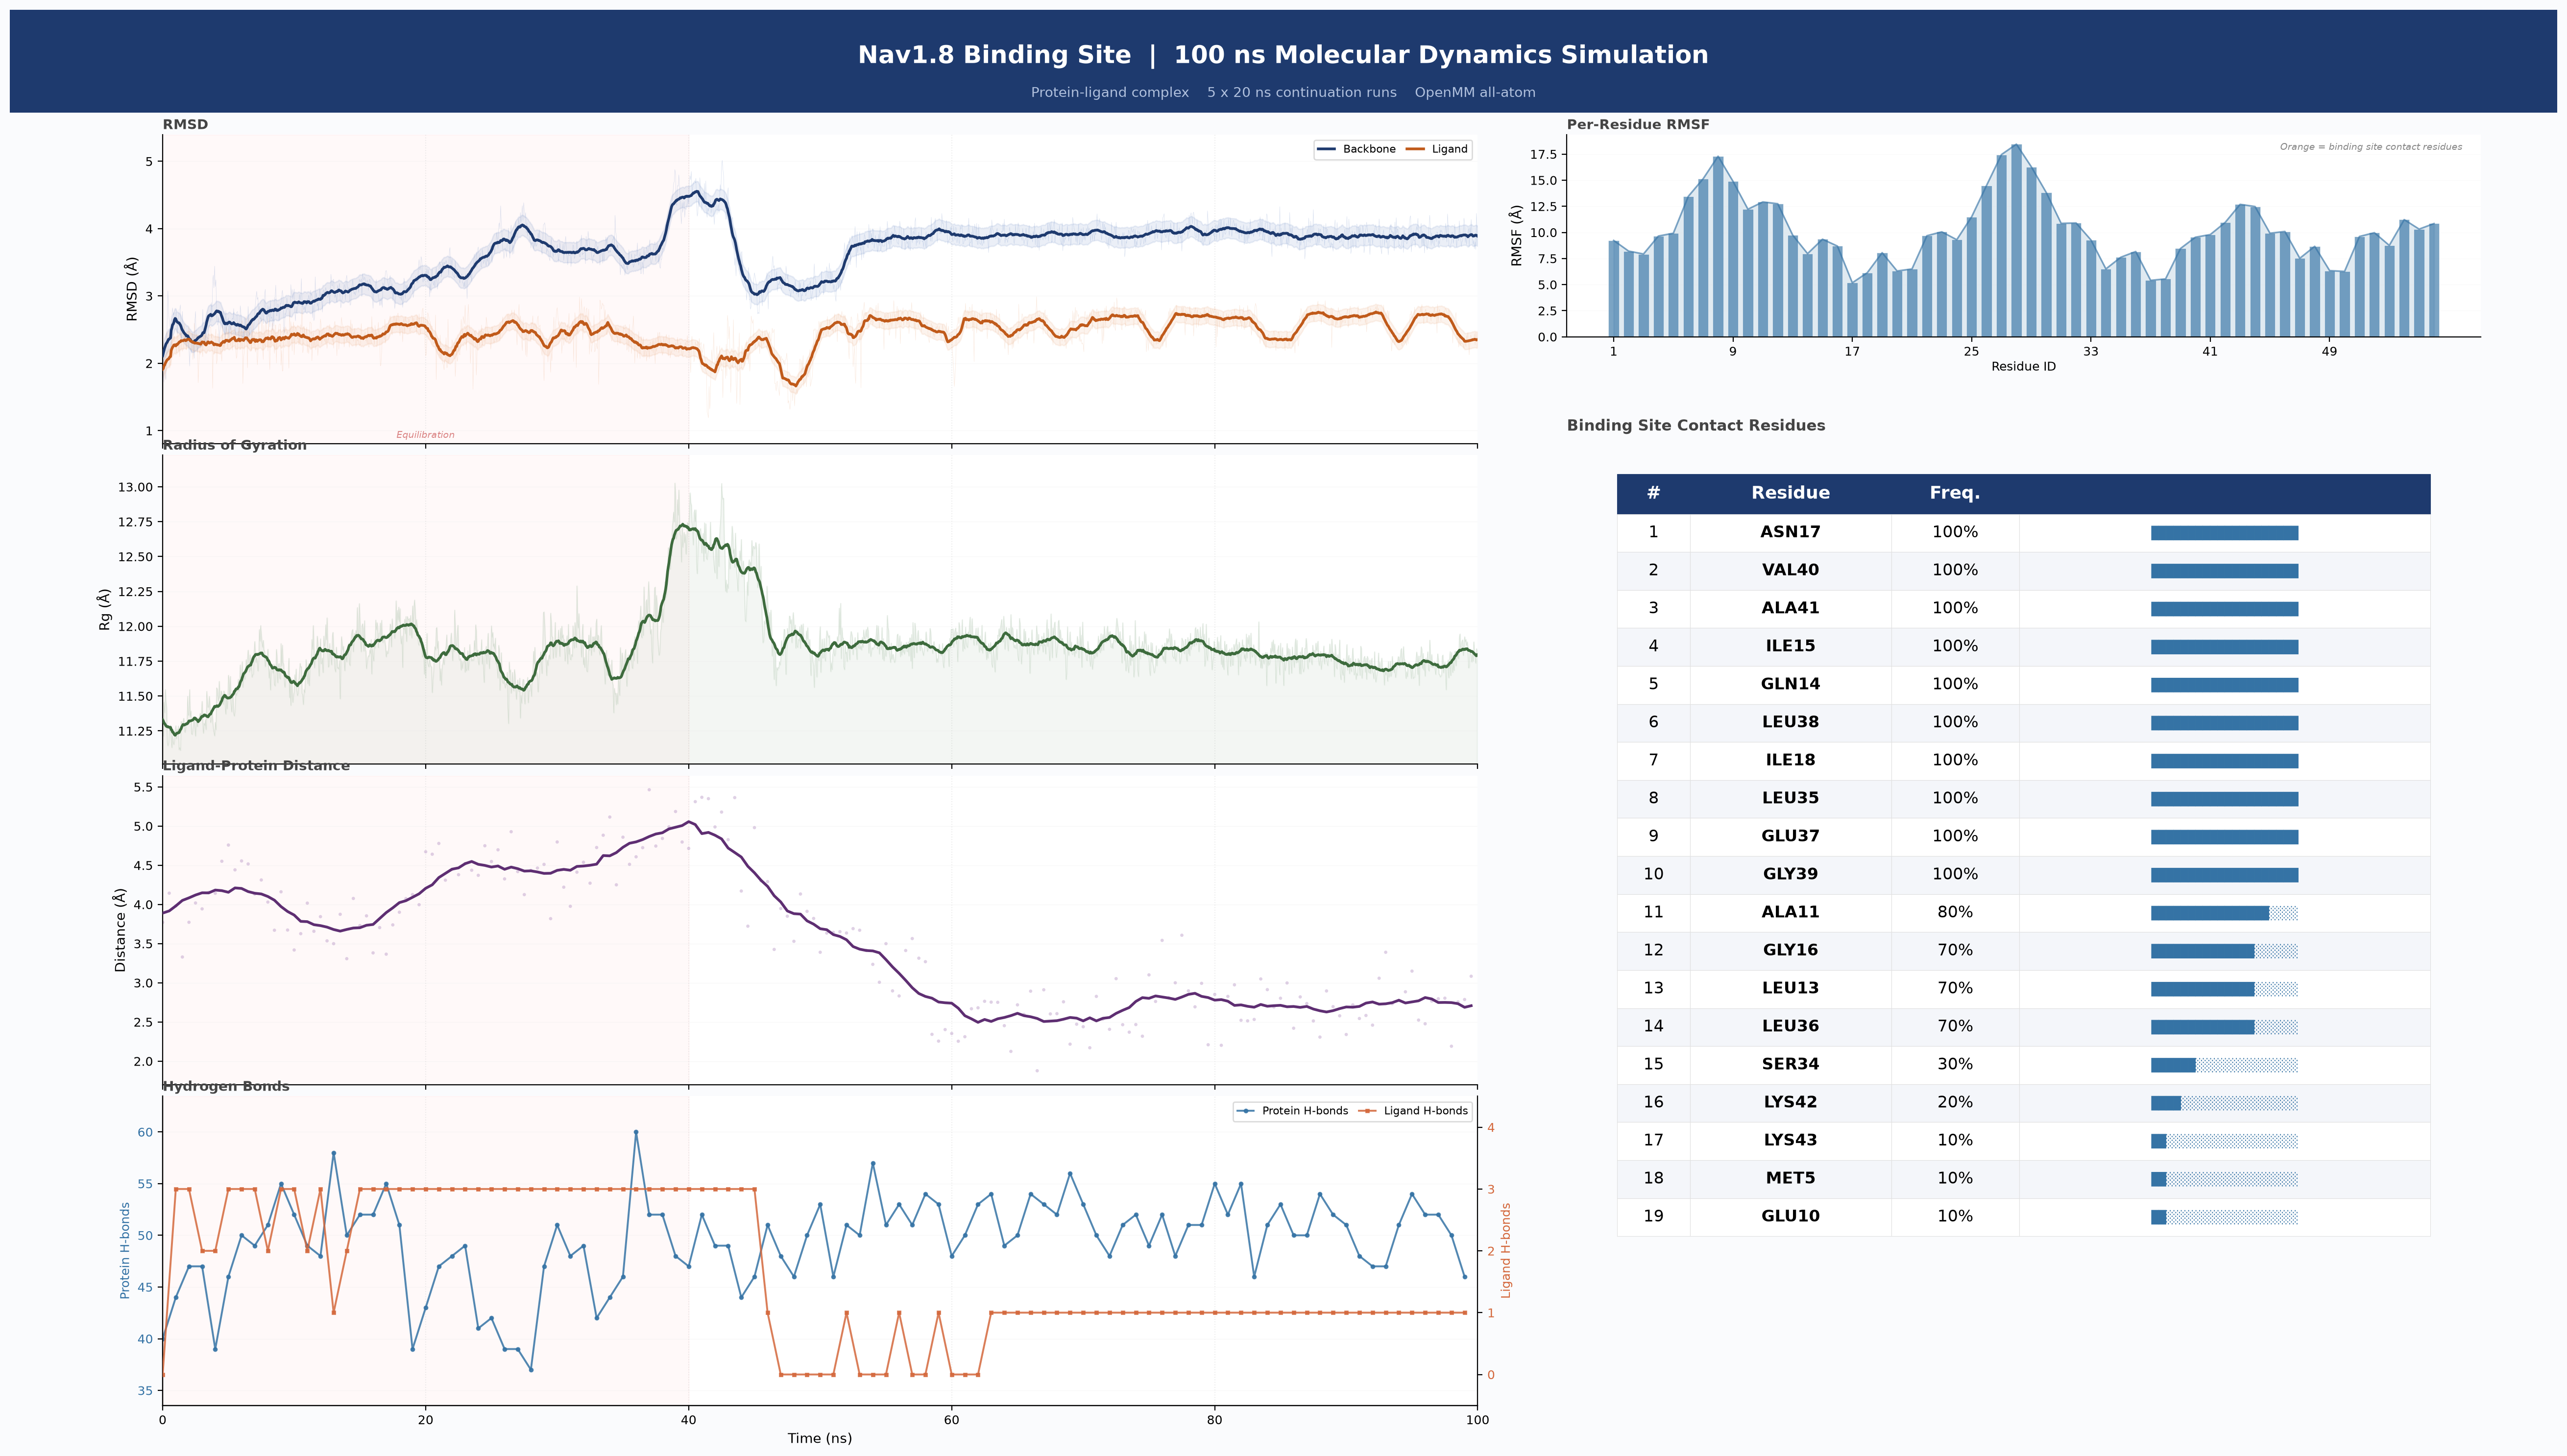
LiteMol-1 用序列掩码扩散生成和编辑多类分子,再把结构预测、分子对接与动力学模拟留给下游验证。它提出了一种面向 Agent 的分子设计流程,但目前证据仍以计算指标为主。
模型与数据发布
OpenBind-0:多四年的 PDB 数据,为什么没有让模型全面变强?
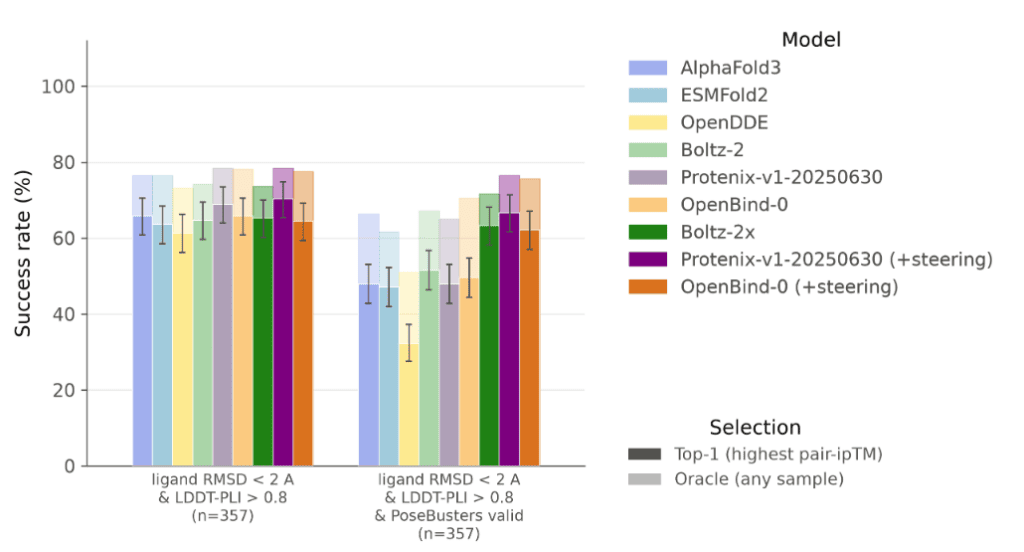
OpenBind-0 同时发布模型、训练方法和 717 个新实验结构,再用真实项目说明:数据的价值取决于它补上了哪些结构和化学空白。
论文笔记
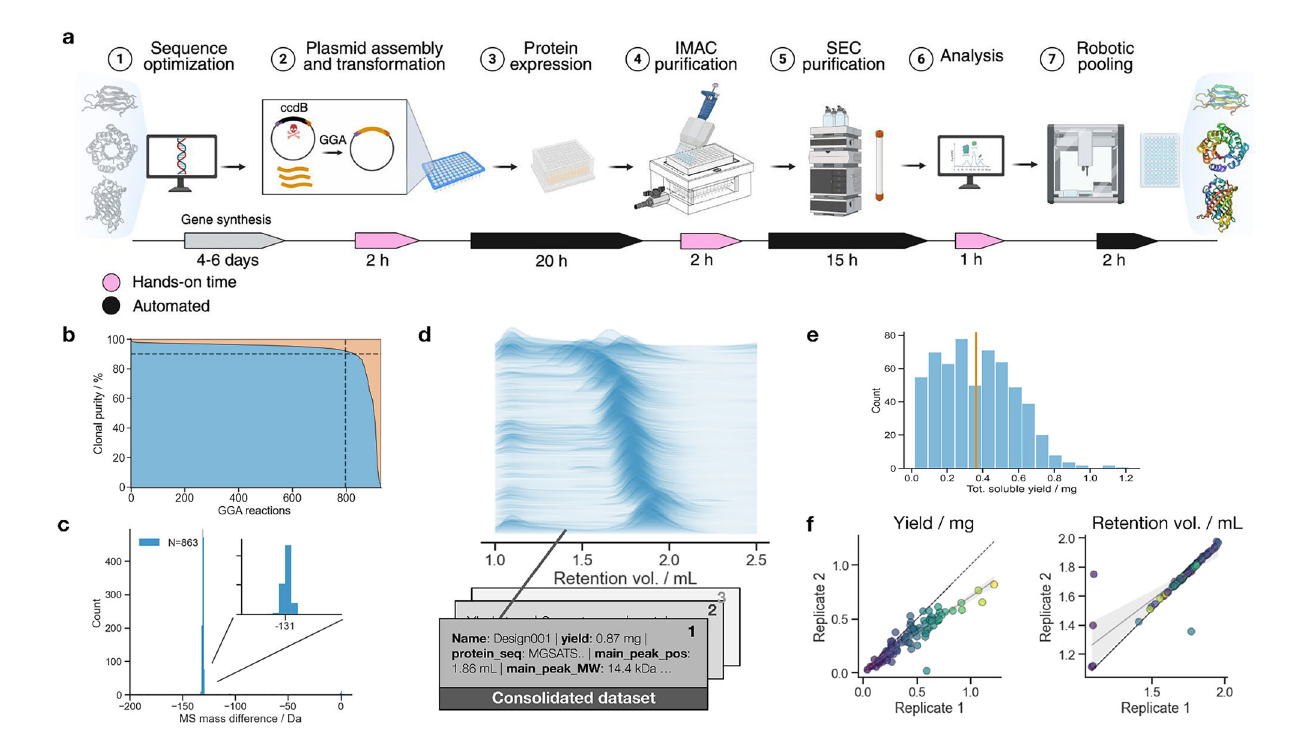
AI 已经能快速设计上万种蛋白,实验室怎么跟上?
David Baker 团队用 SAPP 和 DMX 重做蛋白质的实验验证流程:先把数百个设计的生产和标准化表征压进 48 小时,再把千级规模的 DNA 成本降下来。
项目组合观察 · 01 · Genesis Mission 系列 · 01/03
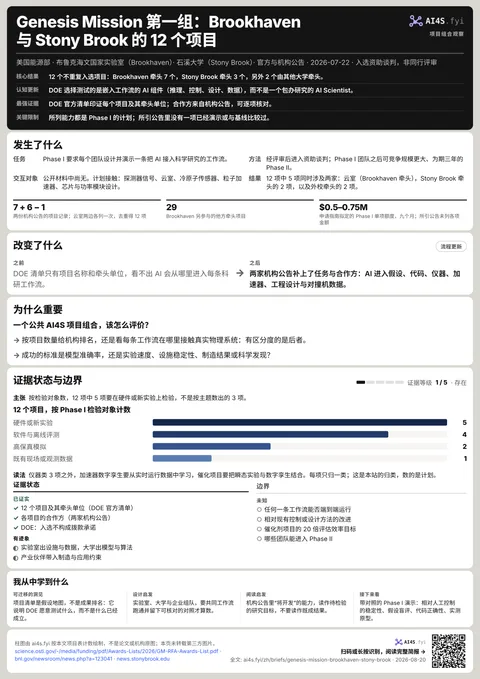
Genesis Mission 首批项目:AI 正在进入哪些科学工作流?
DOE Genesis Mission 首批项目组合观察:区分资助谈判、研究计划与技术演示,并追踪 Brookhaven 与 Stony Brook 项目的下一步公开证据。